
Khi AI điều khiển trình duyệt: Phát hiện lỗi không đồng nghĩa với sửa được lỗi
Một thử nghiệm nhỏ trên agent trình duyệt cho thấy bốn loại lỗi có thể xảy ra giữa quyết định của mô hình AI và trang web thực tế, từ lệch tọa độ click đến thông báo phản hồi sai. Điều đáng chú ý là các bước kiểm tra có thể phát hiện lỗi, nhưng để agent thực sự hoàn thành công việc lại là câu chuyện hoàn toàn khác.
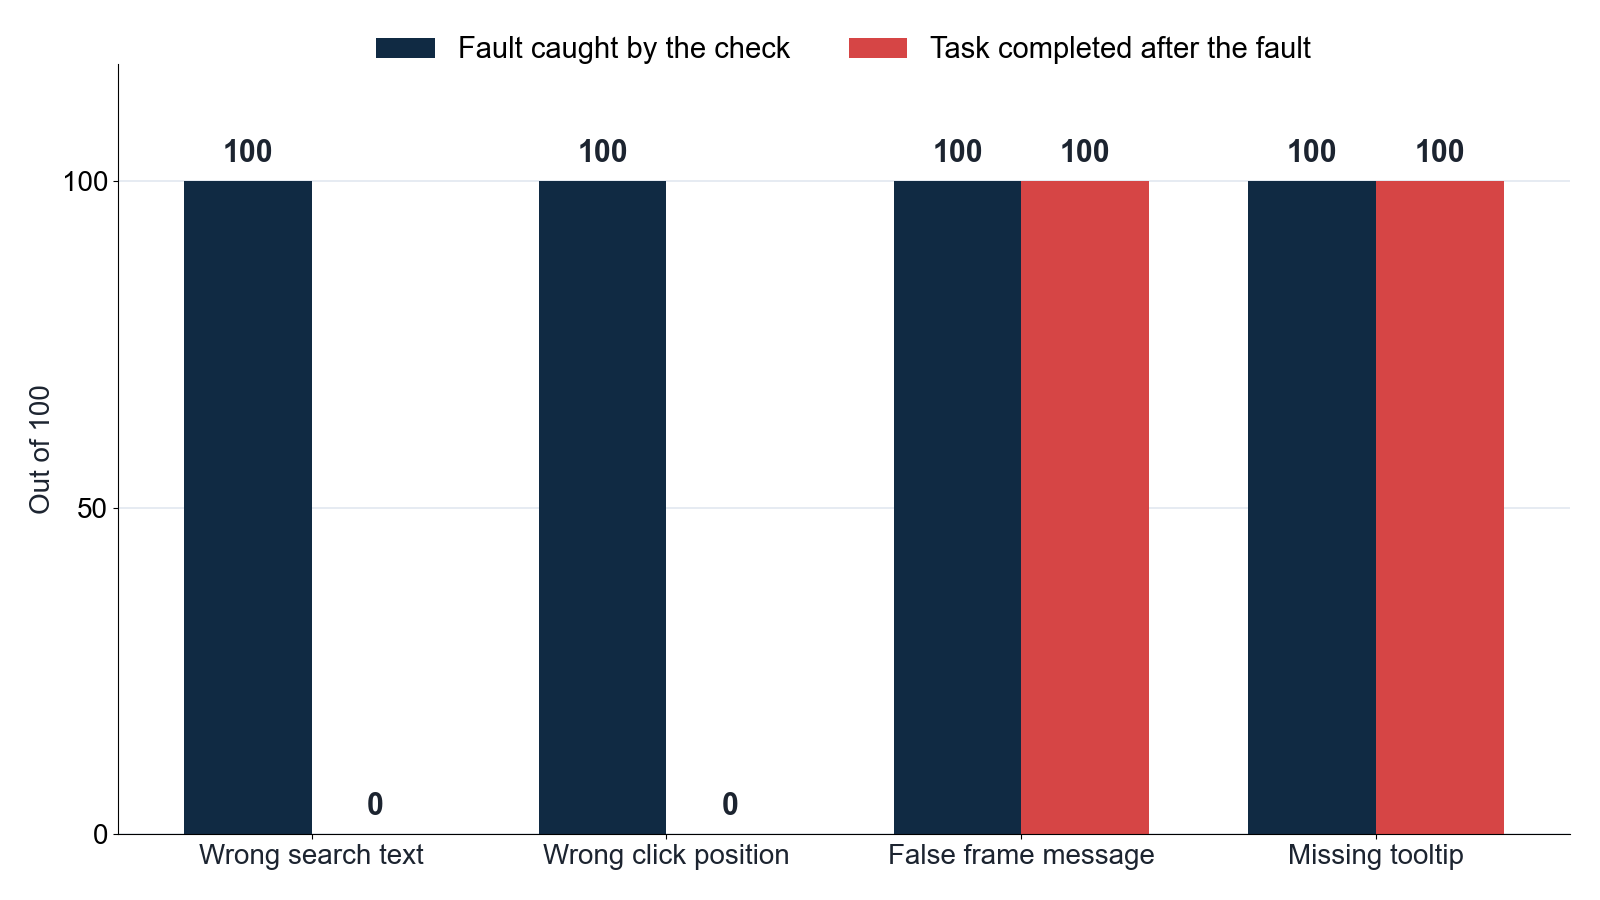
Khi AI điều khiển trình duyệt: Phát hiện lỗi không đồng nghĩa với sửa được lỗi
Các agent trình duyệt (browser agent) — chương trình cho phép mô hình AI xem một trang web rồi tự quyết định bấm nút, nhập liệu hay cuộn trang — đang ngày càng phổ biến trong kiểm thử phần mềm và tự động hóa. Nhưng một thử nghiệm mới đây cho thấy một sự thật khó chịu: lỗi có thể nằm ở lớp phần mềm trung gian giữa mô hình và trang web, chứ không phải ở mô hình. Và quan trọng hơn, phát hiện được lỗi không có nghĩa là khắc phục được nó.
Bài báo WebFovea và lỗi lệch ba phần tư
Bài báo WebFovea của Jiangang Han ghi nhận một lỗi nghiêm trọng: sự lệch pha giữa ảnh chụp màn hình và tọa độ trình duyệt khiến mọi cú click rơi vào ba phần tư vị trí dự định. Một cú click nhắm vào điểm cách 400 pixel lại hạ cánh ở pixel 300.
Nguyên nhân đến từ dịch vụ chạy mô hình: ảnh chụp màn hình bị thu nhỏ trước khi mô hình nhìn thấy. Một ảnh 1920×1080 đến tay mô hình chỉ còn khoảng 1440×810. Tài liệu về thị giác của Anthropic cũng mô tả hành vi tương tự với các mô hình của họ: ảnh lớn bị thu nhỏ để giới hạn chi phí, và mô hình trả lời bằng tọa độ trên ảnh đã thu nhỏ. Phần mềm của bài báo lại dùng các tọa độ đó như thể chúng được đo trên màn hình kích thước đầy đủ.
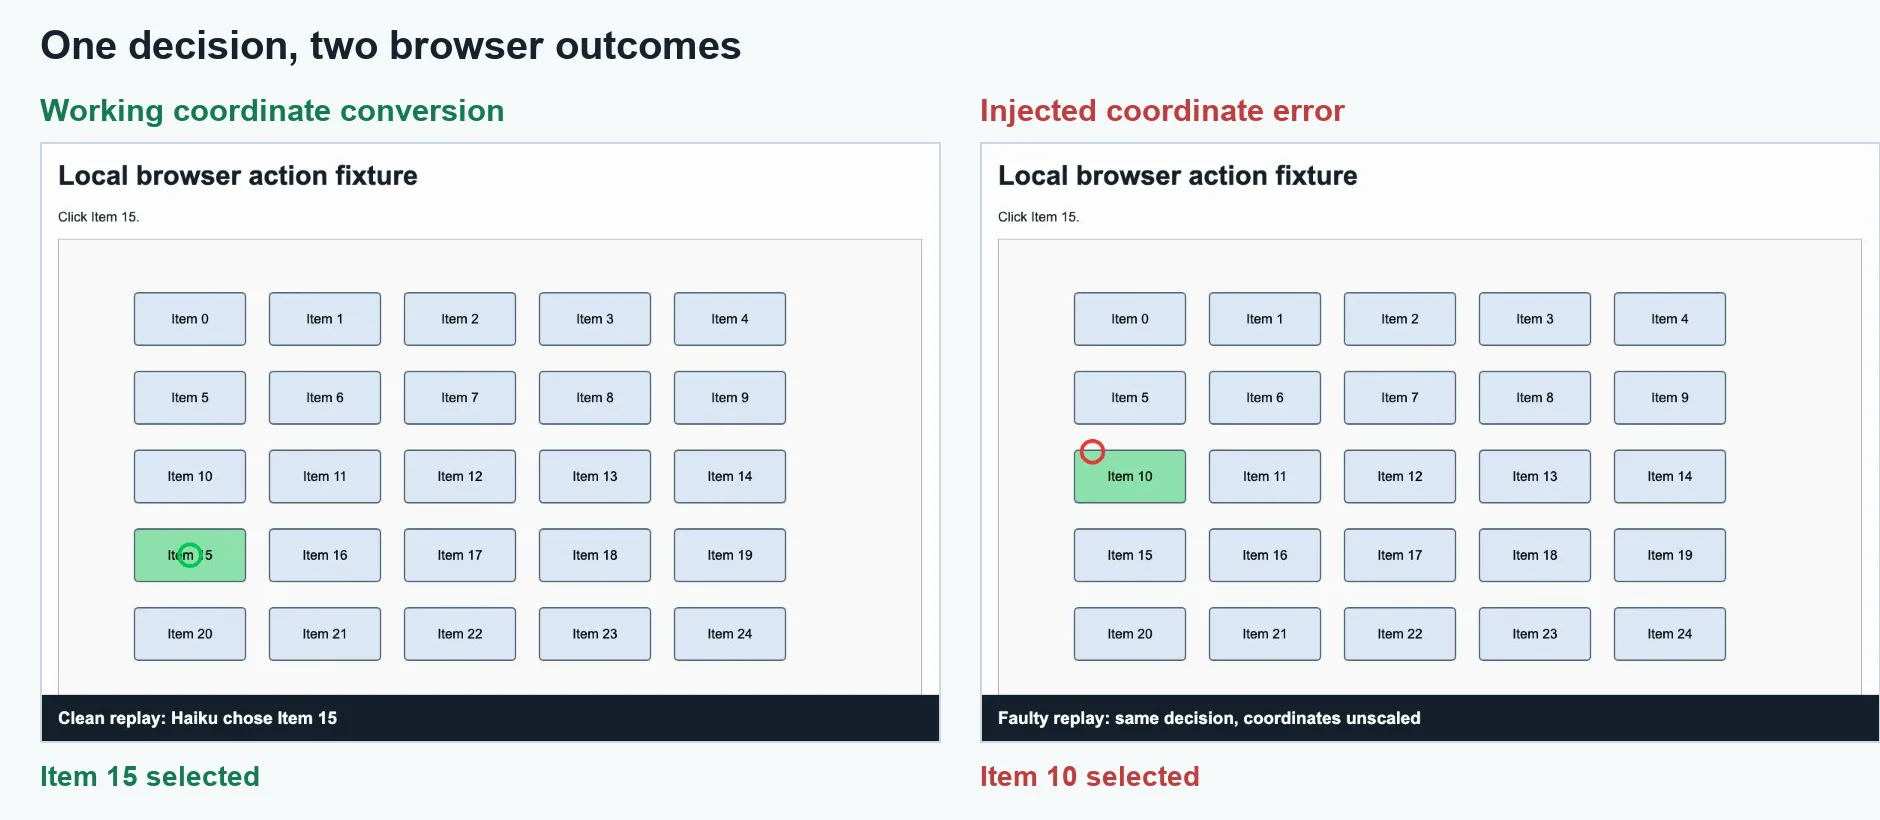 Minh họa agent trình duyệt nhận ảnh chụp màn hình và trả về tọa độ click
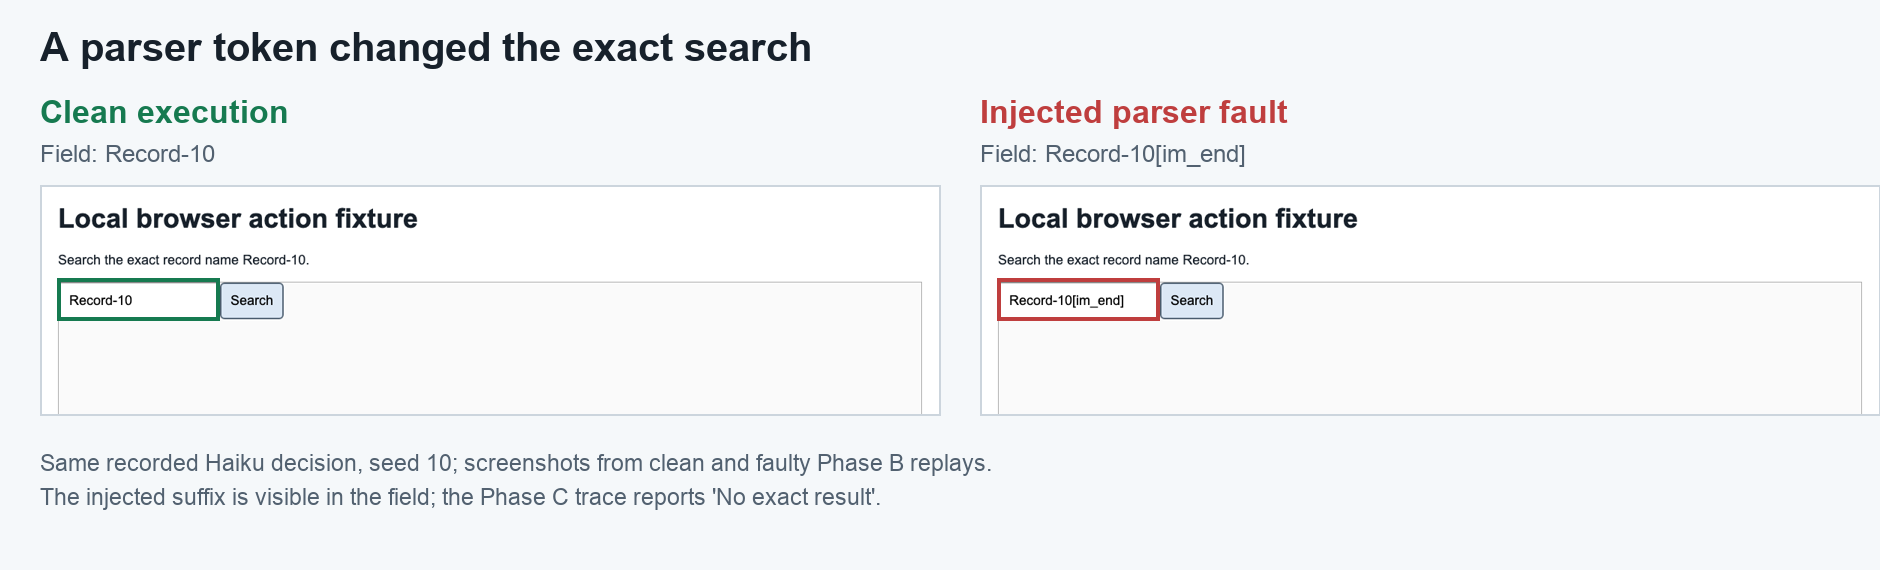
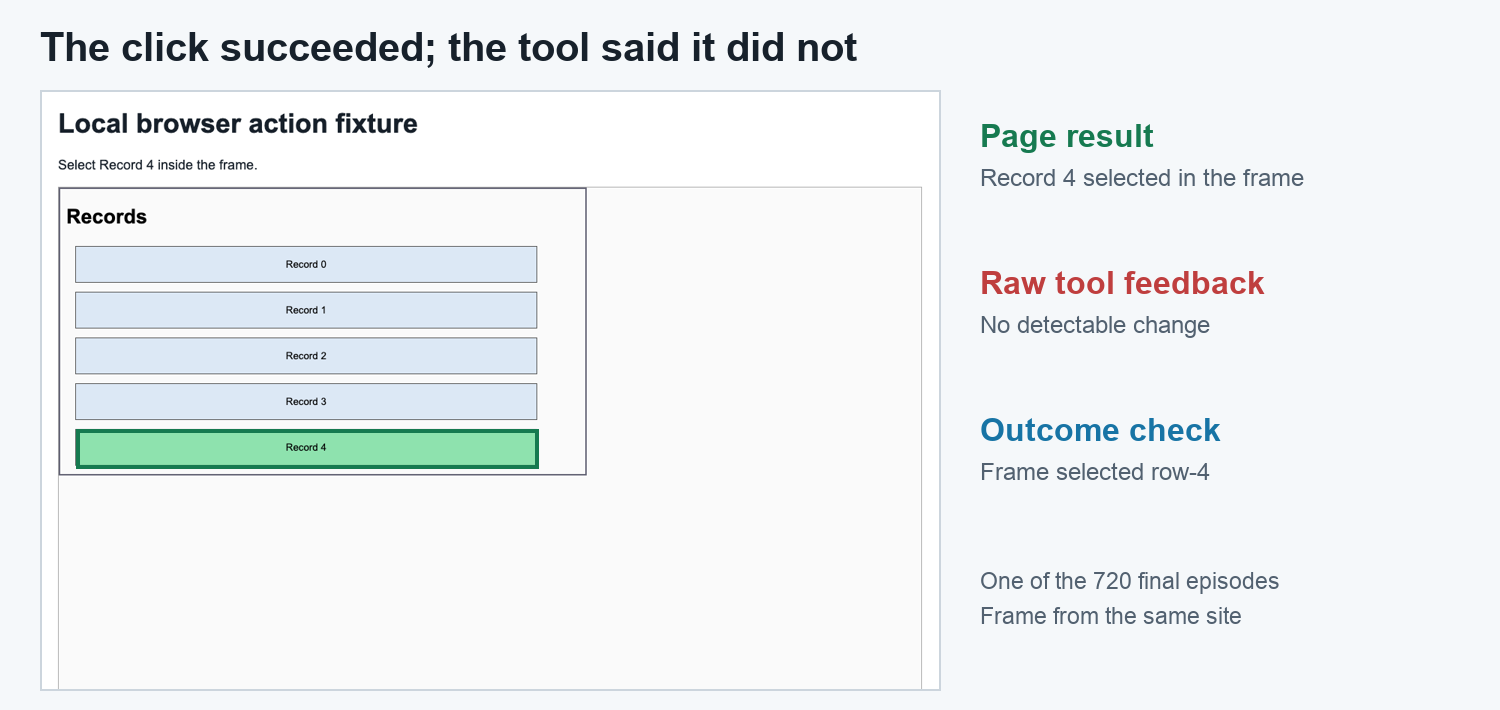
Ngoài lỗi click, WebFovea còn ghi nhận hai lỗi khác ở lớp phần mềm giữa mô hình và trang: các dấu kết thúc tin nhắn ẩn của mô hình bị gõ nhầm vào ô tìm kiếm, và một cú click bên trong iframe (trang nhúng trong trang khác) thực sự hoạt động nhưng bị báo là "không có thay đổi".
Bài báo đã sửa các lỗi này qua bốn lần nộp bài cho một cuộc thi năm 2026 trên các website thực. Điểm của agent tăng từ 31,0 lên 57,0 trên 100 với cùng một mô hình. Tuy nhiên, vì mỗi lần nộp gộp nhiều thay đổi và các website thực có thể biến động, điểm số không cho biết thay đổi nào quan trọng nhất.
Thử nghiệm: cùng một quyết định đúng, hai cú click khác nhau
Tác giả bài viết gốc đã dựng lại một phiên bản thu nhỏ của vấn đề với bốn tác vụ đơn giản: tìm một bản ghi, click vào một nút lưới, chọn một dòng trong iframe, và rê chuột lên một điểm trên biểu đồ. Mô hình Claude Haiku được giao hoàn thành các tác vụ này trên 20 bố cục trang khác nhau.
Kết quả lưu lại 80 quyết định đúng của mô hình, sau đó phát lại từng quyết định qua đoạn mã trình duyệt đã cố tình làm hỏng. Ví dụ rõ nhất: mô hình nhìn ảnh rộng 900 pixel, trả về tọa độ (150, 413) để click "Item 15". Trình duyệt rộng 1200 pixel. Bộ thực thi đúng sẽ nhân tọa độ với hệ số 4/3 rồi click (200, 550,67). Bộ thực thi hỏng bỏ qua bước quy đổi và click thẳng (150, 413) — rơi vào "Item 10", lệch một hàng.
Ảnh chụp, hướng dẫn và câu trả lời đã lưu hoàn toàn giống nhau trong cả hai lần. Chỉ có lớp mã trình duyệt thay đổi.
Điều này cho thấy một hệ quả thực tế: khi AI của bạn click sai, mô hình có thể không phải là thủ phạm. Trước khi viết lại prompt hay đổi mô hình, nên kiểm tra cách tọa độ ảnh được quy đổi sang tọa độ trình duyệt.
Bốn cách kiểm tra, bốn kiểu thất bại khác nhau
Nhóm thử nghiệm so sánh bốn "chính sách" kiểm tra sau mỗi hành động:
- Unverified: tin tưởng tuyệt đối thông báo của công cụ trình duyệt.
- Generic: tìm thay đổi ở địa chỉ web hoặc trạng thái trang chính.
- Pixel: so sánh ảnh chụp màn hình trước và sau.
- Outcome check: so sánh trang với kết quả cụ thể được yêu cầu, ví dụ đúng văn bản trong ô nhập hay đúng nút được chọn.
 So sánh khả năng phát hiện lỗi và báo động nhầm của bốn chính sách kiểm tra
Kết quả trên 40 hành động hỏng mỗi tác vụ:
- Generic bỏ sót 20/40 cú click sai vị trí, vì click trúng một nút khác — nút đó vẫn đổi màu xanh nên trang "trông như" đã phản hồi. Nó còn báo động nhầm cả 40 cú click đúng trong iframe, vì trang chính không đổi khi trang nhúng thay đổi.
- Pixel chỉ phát hiện 3/40 trường hợp hỏng văn bản tìm kiếm, và báo động nhầm cả 40 lần tìm kiếm đúng — vì trang nào chẳng đổi pixel sau mỗi lần tìm.
- Outcome check phát hiện đủ 40/40 lỗi ở mọi tác vụ và không báo động nhầm lần nào.
Tuy nhiên, cần đọc kết quả này một cách thận trọng: chính tác giả viết cả mã kiểm tra lẫn mã trang dùng làm "đáp án", và các bước kiểm tra được thiết kế riêng cho những lỗi này. Phát hiện hoàn hảo ở đây chưa nói lên nhiều về một website khác.
Phát hiện lỗi xong... vẫn không hoàn thành được việc
Đây là phần thú vị nhất. Tác giả cho mô hình thấy kết quả kiểm tra rồi để nó phản ứng — thử lại, dừng, hay chờ. Mỗi lượt chạy kéo dài tối đa ba hành động trình duyệt, tổng cộng 720 lượt thử cuối cùng.
 Mô hình vẫn lặp lại sai lầm dù được kiểm tra báo lỗi chính xác
Kết quả gây bất ngờ:
- Tác vụ tìm kiếm và click sai vị trí: 0/60 lượt thành công ở mọi chính sách. Lý do: bộ phân tích và bộ thực thi vẫn hỏng sau mỗi lần thử lại. Outcome check đọc lại được
Record-10[im_end]và báo cho mô hình biết nó khácRecord-10, nhưng lần thử lại vẫn đi qua đúng bộ phân tích hỏng đó. Ở tác vụ click, Outcome check thậm chí báo đúng vị trí trình duyệt của mục tiêu, nhưng hướng dẫn vẫn bắt mô hình trả lời bằng tọa độ ảnh — và nó lặp lại y nguyên điểm ban đầu cả ba lần. - Tác vụ iframe: cả ba chính sách đều đạt 60/60. Công cụ trình duyệt báo "Không phát hiện thay đổi" nhưng iframe thực ra đã chọn đúng dòng. Vì ảnh chụp màn hình hiển thị dòng đã được chọn, mô hình vẫn hoàn thành được.
- Tác vụ biểu đồ: chênh lệch duy nhất. Unverified đạt 56/60, vì trong 4 lượt nó dừng trước khi công cụ kịp hiện tooltip. Hai chính sách có kiểm tra đạt 60/60 — mô hình rê chuột lại và thấy giá trị.
Mức cải thiện khiêm tốn này — 4/60 lượt, tức khoảng 6,7 điểm phần trăm — vẫn có thể dao động từ 0 đến 15 điểm khi lấy mẫu lại. Nói cách khác, kết quả nhỏ này chưa đủ để khẳng định lợi thế ổn định.
Bài học cho người xây dựng và kiểm thử web bằng AI
Thử nghiệm tuy nhỏ nhưng bài báo WebFovea xác nhận cả bốn loại lỗi đều xuất hiện trên website thực. Với những ai dùng AI để click qua một trang — từ lập trình viên kiểm thử đến người xây web bằng cách mô tả cho AI, tức "vibe coding" — đây là những điều nên biết:
- Kiểm tra quy đổi tọa độ trước khi đổ lỗi cho mô hình. Ghi log kích thước ảnh chụp và kích thước cửa sổ trình duyệt.
- Thông báo "không có gì thay đổi" không phải bằng chứng là không có gì thay đổi. Nếu trang dùng iframe, hãy kiểm tra trạng thái bên trong khung nhúng, không chỉ trang ngoài.
- Đọc lại nội dung đã nhập vào ô văn bản trước khi tin tưởng kết quả — công cụ có thể gõ thứ khác với yêu cầu.
- Giá trị chỉ hiện sau khi rê chuột hoặc sau độ trễ có thể bị bỏ sót. Hãy chờ rồi chụp màn hình mới trước khi kết luận.
- Một gợi ý chưa được kiểm chứng: hiển thị giá trị quan trọng trong văn bản trang, thay vì chỉ hiện khi rê chuột, có thể giúp công cụ đọc ảnh dễ hơn.
Thú vị là chi phí cho toàn bộ thử nghiệm rất thấp: vòng lặp cuối chỉ tốn khoảng 24 cent Mỹ cho các lần gọi mô hình, và toàn bộ công việc cho bài viết gốc tốn khoảng 27 cent.
Kết luận dành cho người vận hành agent trình duyệt: hãy lưu lại cả tọa độ mô hình yêu cầu, điểm trình duyệt thực nhận, phần tử hoặc iframe nhận hành động, và những gì mô hình được xem sau đó. Các bước kiểm tra có thể phát hiện sự lệch pha và bổ sung bằng chứng còn thiếu, nhưng không thể sửa một bộ thực thi hỏng nếu cách gửi hành động tiếp theo không thay đổi. Khi agent có vẻ "suy luận kém", hãy soi con đường của hành động qua trình duyệt trước khi động vào prompt.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Google Genie 4 ra mắt: Thế giới mô phỏng có âm thanh, đồ họa chân thực và điều khiển theo thời gian thực
27 tháng 10, 2026