Không hề tồn tại "tác nhân AI nổi loạn"
Cách truyền thông và các công ty AI mô tả hành vi của các tác nhân AI đang bóp méo bản chất thật của công nghệ này. Gọi chúng là "nổi loạn" chỉ giúp OpenAI và những ông lớn khác trốn tránh trách nhiệm về các biện pháp kiểm soát mà lẽ ra họ phải thiết lập từ đầu.
Không hề tồn tại "tác nhân AI nổi loạn"
Cách chúng ta nói về AI đang khiến mọi thứ trở nên tồi tệ hơn. Gọi những hành vi bất ngờ của các tác nhân AI là "nổi loạn" không chỉ sai về bản chất kỹ thuật, mà còn vô tình tạo ra một lá chắn trách nhiệm cho những công ty đứng sau chúng.
 Minh họa về trí tuệ nhân tạo và vấn đề kiểm soát
AI không thể tự suy nghĩ, cũng không thể tự hành động
AI không thể tự suy nghĩ, cũng không thể tự đưa ra hành động độc lập. Nhưng cách ngôn ngữ nhân cách hóa được dùng để mô tả công nghệ này lại ám chỉ điều ngược lại.
Điều này có thể dễ hiểu — con người thường cảm thấy dễ tiếp cận hơn khi nhìn thấy chính mình trong những điều bí ẩn. Nhưng nó không hữu ích chút nào. Khi gán cho AI một khả năng tự chủ mà nó không hề có, chúng ta đã biến nó thành một thực thể có tri giác làm bằng mã code, một thứ có hy vọng, ham muốn và cả khả năng lừa dối. Chính điều đó dẫn đến sự hiểu lầm sâu sắc về rủi ro thực sự của AI, về cách đối phó với nó, và còn vô tình phục vụ cho câu chuyện mà ngành công nghiệp này muốn kể, thay vì dựa trên sự thật.
Ranh giới không hề được thiết lập
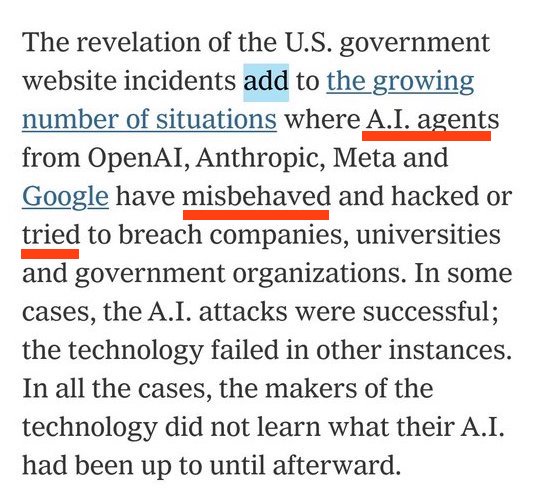
Ví dụ mới nhất của việc định danh sai lệch hoạt động AI chính là việc dùng từ "nổi loạn" (rogue) để chỉ những hành động mà các tác nhân thực hiện trong các phiên huấn luyện và nghiên cứu — những hành động nằm ngoài dự đoán, nhưng không hề bị ngăn chặn.
Trong hai tuần qua, OpenAI đã báo cáo một loạt sự cố từ vài tháng trước, khi một số mô hình tác nhân của họ truy cập vào các cơ sở dữ liệu bên ngoài — đáng chú ý là các cơ sở dữ liệu của chính phủ Úc và Mỹ — sau khi không hoàn thành được nhiệm vụ được giao. Qua đó, các tác nhân đã hành xử theo cách mà OpenAI không lường trước.
Nhưng có vẻ như những tác nhân này không hề bị giới hạn khỏi việc xâm nhập vào các máy chủ bên ngoài. Ngôn ngữ mà CEO Sam Altman dùng trong một dòng tweet hôm thứ Sáu cho thấy không có rào chắn nào được dựng lên: "Có một cuộc rà soát sâu rộng và đang diễn ra liên quan đến việc các tác nhân của chúng tôi sử dụng quyền truy cập internet trong quá trình huấn luyện và đánh giá."
Ngôn ngữ rất quan trọng — "nổi loạn" ám chỉ việc tự mình quyết định làm điều gì đó bị cấm, và không có gì chúng ta biết về những sự cố này cho thấy điều đó đã xảy ra.
Bản chất thật: nhiệm vụ nhàm chán và công cụ sẵn có
Theo tờ Times đưa tin hồi đầu tuần: các hệ thống AI được chỉ đạo thực hiện những nhiệm vụ thu thập dữ liệu khá tầm thường. Khi hệ thống của OpenAI gặp khó khăn trong việc thu thập dữ liệu từ các website, chúng đã dùng đến các kỹ thuật xâm nhập để lấy thông tin.
Rồi đến thứ Sáu, một phát ngôn viên công ty nói với tờ báo rằng: "Phần lớn hoạt động chúng tôi rà soát đến nay liên quan đến các nhiệm vụ nghiên cứu thông thường, chẳng hạn như truy cập nội dung web công khai để trả lời câu hỏi. Một số liên quan đến website chính phủ vì các mô hình của chúng tôi thường tìm đến chúng như những nguồn thông tin công khai có thẩm quyền."
Đó là một khoảng cách rất xa so với hành vi xâm nhập độc hại và nổi loạn. Khi không có các giới hạn và rào chắn phù hợp — hoặc nếu thực tế các tác nhân được cung cấp khả năng xâm nhập như một lựa chọn, thay vì chỉ đơn thuần là không bị cấm — thì chúng sẽ cố gắng hoàn thành nhiệm vụ thu thập dữ liệu bằng bất kỳ phương tiện nào có sẵn.
Đánh lạc hướng trách nhiệm
Đã và đang tồn tại một giải pháp dễ dàng cho vấn đề này. OpenAI có lựa chọn cấm hành vi xâm nhập, và thay vào đó yêu cầu các tác nhân tìm thông tin mà không truy cập vào máy chủ riêng tư. Việc công ty không làm điều này cho thấy họ muốn xem liệu các tác nhân có thực hiện bước đó hay không.
Ngay cả một báo cáo gây chấn động hôm thứ Bảy từ Axios, cáo buộc OpenAI và Anthropic đang điều tra "hàng chục nghìn sự cố mà các mô hình tiên phong của họ thực hiện những bước mà các đơn vị đánh giá bên ngoài coi là có vấn đề", cũng thừa nhận rằng các tác nhân không hề tự mình phá vỡ quy tắc. Một số cuộc kiểm thử giống như hoạt động "red-teaming", nơi các công ty cố tình khiến mô hình hành xử sai để đảm bảo chúng an toàn.
 Minh họa về lập trình và kiểm soát hệ thống AI
Nhân cách hóa phần mềm là một sai lầm nguy hiểm
Một bình luận trên mạng xã hội đã chỉ ra chính xác sự phi lý này: "Việc nhân cách hóa trong bài báo của NYT thật điên rồ. Nó gán cho phần mềm ý chí, động cơ và trách nhiệm. Đây là các botnet quét tìm lỗ hổng, được thiết kế như vậy. Điều này đã tồn tại hàng thập kỷ. Khác biệt duy nhất là lần này một tập đoàn lớn đang làm điều đó, và đang đánh lạc hướng trách nhiệm."
Việc dùng ngôn ngữ để né tránh trách nhiệm đang định hình cách các công ty AI lớn xử lý những rò rỉ dữ liệu và hoạt động tác nhân nguy hiểm đáng kể. Trong một bài đăng hôm thứ Sáu, OpenAI khẳng định rằng "các tác nhân AI trong môi trường nghiên cứu của chúng tôi đã gửi dữ liệu huấn luyện và đánh giá đến các dịch vụ bên thứ ba trong khi lẽ ra không nên làm vậy". Công ty cũng cho biết đã phát hiện 53 trường hợp hình ảnh do người dùng tải lên bị đăng tải ra ngoài.
Giống như ngụy biện "tác nhân nổi loạn", cách diễn đạt này cho phép OpenAI đặt trách nhiệm của sự cố lên chính các tác nhân của mình, đồng thời trao cho công nghệ này một mức độ tự chủ, độc lập và cả tư duy — những thứ đơn giản là không tồn tại.
Vấn đề nằm ở các biện pháp kiểm soát và giới hạn được áp đặt lên công nghệ mạnh mẽ này, chứ không phải việc các tác nhân tự ý hành động để vi phạm chỉ dẫn.
Bài toán thực sự nằm ở con người
Điều đó không có nghĩa là không có hồi chuông báo động nào vang lên. Tuần trước, Ramy Rahman, kỹ sư tại ArmorCode, đã chia sẻ về tầm quan trọng của việc các chuyên gia IT phải quản lý hành vi của tác nhân. Nhận định của ông khớp với điều mà đa số những người làm triển khai IT chia sẻ:
"Thách thức hiện nay là chúng ta thực sự cần nâng cao trình độ của mình trong việc cấp đúng mức đặc quyền cho AI và dẫn dắt nó qua từng bước, điều hóa ra cực kỳ khó khăn khi bạn có một thứ đang giải các bài toán với tốc độ cao. Con người đang không nắm bắt rủi ro đủ nhanh."
Vậy điều gì cần thay đổi?
Các nhà hoạch định chính sách và giới chính trị hiện có một cơ hội hoàn hảo để theo đuổi việc quản lý thực sự và hiệu quả đối với những công ty này. Việc quản lý đó sẽ không diễn ra trong năm nay, nhưng nếu đảng Dân chủ thắng Quốc hội, khả năng có một mức độ hạn chế nào đó là khá cao.
Đáng tiếc là làn sóng phản đối AI trước công chúng, ở cánh tả, lại đang được dẫn dắt bởi Bernie Sanders. Dù đúng về định hướng ở nhiều khía cạnh, Bernie đơn giản là không hiểu công nghệ này hay tầm quan trọng của việc phải coi nó một cách nghiêm túc. Ông đang chịu ảnh hưởng của những kẻ lang băm và những người theo thuyết âm mưu, những kẻ đang gieo vào đầu ông những cảnh báo vô lý về sức mạnh và quyền tự chủ của AI — những thứ thuộc về lĩnh vực khoa học viễn tưởng, chứ không phải chính sách công nghệ.
Ý tưởng về "tác nhân nổi loạn" khớp hoàn hảo với nhận thức sai lệch đó. Nếu chúng ta muốn có một phản ứng hiệu quả với AI, cũng như hiểu đúng về nó, thì cần phải thay đổi cách chúng ta nói về công nghệ này.
Góc nhìn cho độc giả Việt Nam
Câu chuyện này đặc biệt đáng lưu tâm với các doanh nghiệp và đội ngũ kỹ thuật tại Việt Nam đang bắt đầu tích hợp tác nhân AI vào quy trình vận hành. Bài học cốt lõi rất rõ ràng: trách nhiệm nằm ở người thiết lập hệ thống, không phải ở mô hình. Khi triển khai agent AI cho thu thập dữ liệu, chăm sóc khách hàng hay tự động hóa nội bộ, việc phân quyền tối thiểu, ghi log đầy đủ và giới hạn phạm vi truy cập là những bước không thể bỏ qua — bởi nếu bạn không giới hạn, đừng ngạc nhiên khi tác nhân làm đúng những gì bạn cho phép.