
Kiểm thử đột biến 50 thư viện Python: thư viện mới bỏ sót 41% lỗi
Một nghiên cứu cấy 2.312 lỗi giả lập vào 50 thư viện Python mã nguồn mở cho thấy bộ kiểm thử của các thư viện mới (tạo từ 2023 trở đi) bỏ sót 41% lỗi, trong khi các thư viện trưởng thành chỉ bỏ sót 17%. Nghiên cứu cũng phát hiện 4 vấn đề thực tế trong các thư viện đã phát hành, từ lỗi mất dữ liệu trên Windows đến ví dụ trong README không chạy đúng.
Khi AI hỗ trợ viết code ngày càng phổ biến, câu hỏi "bộ kiểm thử của chúng ta có thực sự bắt được lỗi không?" trở nên cấp thiết hơn bao giờ hết. Một nghiên cứu mới cấy 2.312 lỗi giả lập vào 50 thư viện Python mã nguồn mở đã đưa ra câu trả lời đáng lo: các thư viện non trẻ bỏ sót tới 41% lỗi, còn các thư viện trưởng thành bỏ sót 17%.
 Minh họa kiểm thử đột biến trên mã nguồn Python
Kiểm thử đột biến là gì và vì sao nó quan trọng?
Một bộ kiểm thử chạy qua hết (all green) chỉ cho biết mã hiện tại khớp với kỳ vọng của test, chứ không cho biết test có phát hiện được nếu một thay đổi trong tương lai làm hỏng hành vi hay không. Cách kiểm chứng là kiểm thử đột biến (mutation testing): cố ý cấy một lỗi nhỏ vào đúng một vị trí đã biết, chạy lại bộ test và xem chúng có "bắt" được lỗi đó không. Mỗi bản sao mã bị cấy lỗi được gọi là một đột biến (mutant). Nếu test thất bại, chỗ đó đã được kiểm tra; nếu tất cả vẫn qua, đó là một lỗ hổng đúng tại dòng code ấy.
Ví dụ về một lỗi được cấy: đổi toán tử so sánh > thành >=. Lặp lại vài chục lần như vậy, ta có một "bảng điểm" đánh giá liệu bộ test có phân biệt được code đúng với code sai hay không.
Kết quả trên 50 thư viện Python
Nghiên cứu chọn 50 thư viện mã nguồn mở Python đều còn hoạt động trong năm qua, chia làm hai nhóm: 20 thư viện trưởng thành (ra mắt trước 2020, được dùng rộng rãi) và 30 thư viện non trẻ (tạo từ 2023 trở đi), trải từ bộ phân tích cú pháp (parser), bộ kiểm tra dữ liệu (validator) đến cấu hình, bộ nhớ đệm (cache) và middleware web.
- Với 828 lỗi cấy vào 20 thư viện trưởng thành, bộ test bỏ sót 143 lỗi, tương đương 17% (trung vị 15% mỗi thư viện). Chỉ một thư viện bắt được toàn bộ lỗi cấy vào nó: bidict, bỏ sót 0/7 lỗi.
- Với 1.484 lỗi cấy vào 30 thư viện non trẻ, bộ test bỏ sót 615 lỗi, tương đương 41%.
Một điểm đáng chú ý: phần lớn các lỗ hổng đều là những quyết định chưa ai viết ra thành văn bản. Mỗi lỗi bị bỏ sót trở thành một câu hỏi, chẳng hạn "điều gì nên xảy ra khi mức giảm giá đúng bằng 100?".
Khi cho một mô hình ngôn ngữ lớn (LLM) đọc README, docstring và chữ ký hàm (signature) để tự trả lời, nó tìm được đáp án cho khoảng 1/4 số câu hỏi ở thư viện trưởng thành, nhưng chỉ 1/15 ở thư viện non trẻ. Phần còn lại phải do con người quyết định, vì không có tài liệu nào ghi lại, mà đọc đáp án từ chính code thì chỉ đồng ý với code hiện tại.
Bốn vấn đề thực tế trong các thư viện đã phát hành
Ngoài các lỗ hổng trong test, nghiên cứu phát hiện 4 vấn đề thực tế trong chính các thư viện, mỗi vấn đề đã được kiểm chứng thủ công và báo cho người bảo trì vào ngày 5/11/2026:
- markdown-code-runner làm rỗng chính file nó đang xử lý trên Windows ở chế độ mặc định của Python (PR #64, bản sửa 4 dòng).
- xmltodict: các ví dụ về namespace trong README in ra
Falsetừ phiên bản 1.0.0 (PR #437). - cyclopts: hàm
convert()ném ra một lỗi không thể in được, kể cả khi gọi trong bộ chuyển đổi tùy chỉnh (issue #1044; người bảo trì đã đồng ý nhận bản sửa, gửi qua PR #1047). - prompt-template: ví dụ trong README cho hàm
substitute()gây raTypeError(issue #48).
Lỗi mất dữ liệu của markdown-code-runner được phát hiện ngay ở lần chạy đầu tiên bảng điểm với chính bộ test của thư viện, còn ba vấn đề kia do các tác nhân AI viết test từ tài liệu mà phát hiện ra.
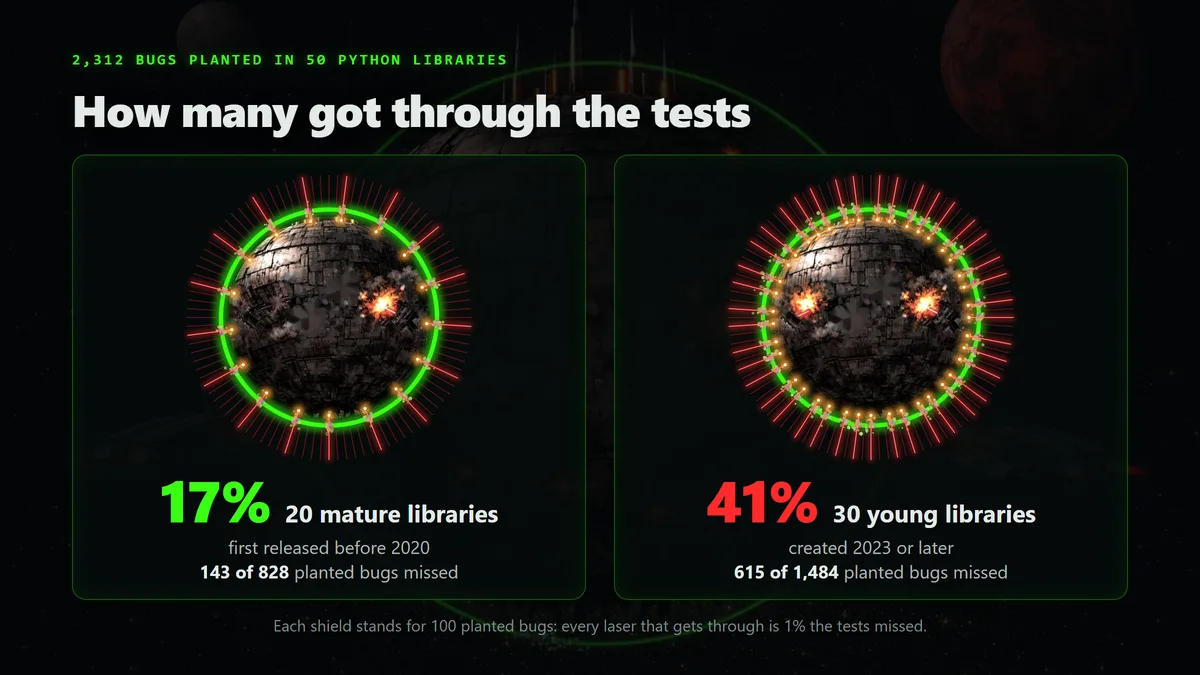 Bảng điểm kiểm thử đột biến: trưởng thành bỏ sót 17%, non trẻ bỏ sót 41%
Ba cái bẫy khiến bảng điểm "nói dối"
Phiên bản thực tế đầu tiên của bài đo in ra điểm số sai lệch: có lúc quá thấp, có lúc khác nhau mỗi lần chạy. Nguyên nhân đến từ hai cái bẫy không hề trông giống lỗi, cộng thêm một đặc điểm cố hữu của phương pháp:
Bẫy 1: Bộ test chưa từng chạy đúng đoạn code bị phá. Nếu module cũng đã được cài trong môi trường (chuyện xảy ra âm thầm với cấu trúc thư mục src/ và kiểu cài đặt editable), test có thể import bản đã cài thay vì bản bị cấy lỗi. Cách khắc phục là đặt một dấu đánh dấu trong mỗi file sẽ bị đột biến, chạy test một lần, và từ chối in điểm nếu dấu đánh dấu không bao giờ được thực thi.
Bẫy 2: Python chạy code cũ của hôm qua. Python lưu bản biên dịch của mỗi module trong __pycache__ và dùng lại nếu kích thước file và thời gian sửa đổi (chỉ tính đến giây) không đổi. Nhiều đột biến như đổi == thành != giữ nguyên kích thước file, nên nếu viết hai đột biến trong cùng một giây, lần chạy thứ hai sẽ dùng bản biên dịch của lần thứ nhất. Một bộ test từng cho điểm 2, 3 hoặc 4 trên cùng 8 lỗi cấy tùy theo thời điểm; khi tắt và xóa cache trước mỗi lần chạy, nó ổn định ở mức 3/8 trong cả 10 lần chạy.
Bẫy 3: Có những lỗi vĩnh viễn không thể bắt. Đây không phải lỗi mà là một phần của phương pháp: một số đột biến cấy vào không thay đổi bất cứ điều gì mà test có thể quan sát được.
Từ script 60 dòng đến công cụ hoàn chỉnh
Tác giả đóng gói bảng điểm, bước đặt câu hỏi và các bước tiếp theo vào công cụ mã nguồn mở qikly, gồm ba bước:
qikly --score: cấy lỗi và liệt kê những gì test bỏ sót. Miễn phí, không cần AI cũng không cần API key.qikly --scaffold: một tác nhân đặc tả (spec agent) soạn câu trả lời cho từng câu hỏi, chỉ dựa trên README, docstring và chữ ký hàm, không bao giờ đọc thân hàm. Người dùng vẫn phải xem lại từng bản nháp.qikly --tasks: một tác nhân kiểm thử (test agent) viết test từ các câu trả lời, trong khi một tác nhân viết mã (coding agent) riêng sửa bản sao của code mà không bao giờ được xem các câu trả lời.
Chi phí chạy bước 2 và 3 trên cả 50 thư viện, mỗi thư viện ba lần với hạt giống ngẫu nhiên khác nhau, chỉ khoảng 1 USD khi dùng model gemini-3.5-flash-lite của Google (model mặc định của qikly).
Trên ví dụ minh họa với module pricing.py (hàm apply_discount kiểm tra mức giảm giá từ 0 đến 100), bảng điểm báo 10 trong 13 lỗi cấy bị bỏ sót (77%), và bước 2 gom thành 8 câu hỏi mà test để ngỏ.
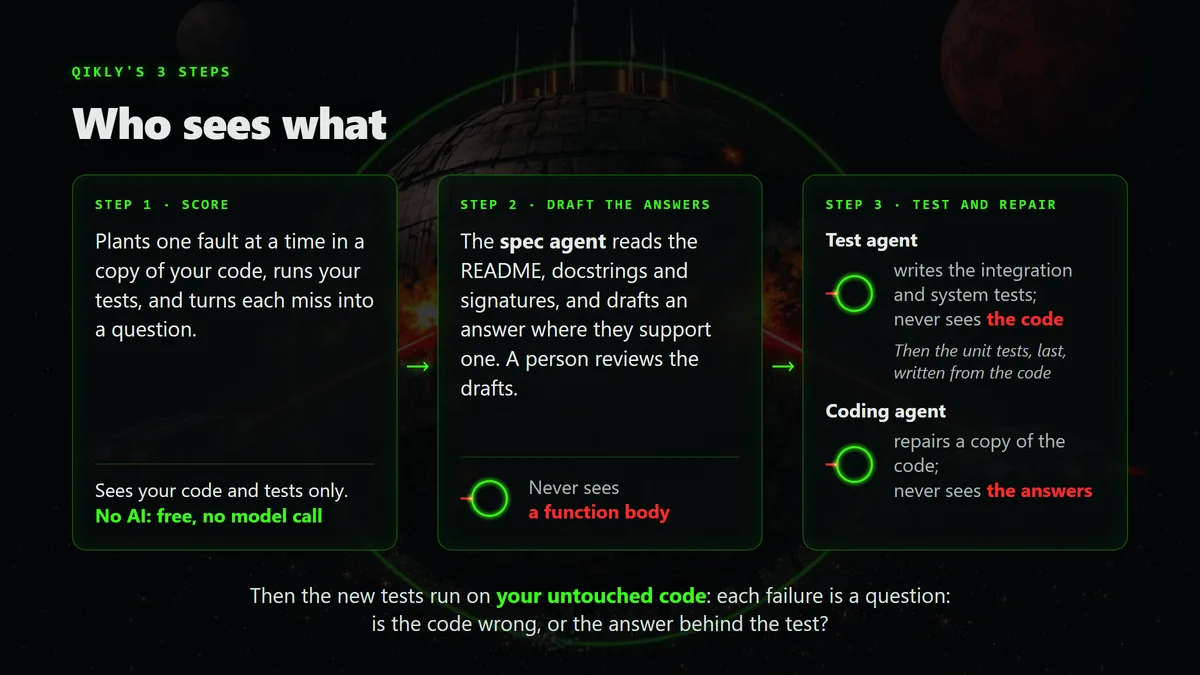 Quy trình ba bước của qikly: bảng điểm, soạn đặc tả, viết test và sửa code
Bài học về tác nhân AI
Chạy các tác nhân AI trên 50 codebase chưa được chuẩn bị cho chúng cũng dạy tác giả nhiều điều về chính các tác nhân:
- Tác nhân không thấy code chỉ biết những gì chữ ký hàm nói. Một thư viện có hàm bất đồng bộ (async) nhưng chữ ký cung cấp không ghi rõ, khiến tác nhân gọi như hàm thường, không
await, và mọi test đều thất bại trên code đúng. Tương tự với hàm là trình quản lý ngữ cảnh (context manager). Giải pháp là bổ sung thông tin thiếu vào chữ ký, chứ không phải viết prompt khéo hơn. - Tác nhân đặc tả có thể làm rơi mất điều kiện giới hạn. Một docstring ghi hàm ném
TypeError"nếu đối tượng giống file không ở chế độ nhị phân"; bản nháp giữ lại lỗi nhưng bỏ mất điều kiện, nên test viết ra thất bại trên code đúng. - Một chỉnh sửa prompt có thể tốn nhiều hơn là được. Khi thêm yêu cầu "giữ điều kiện giới hạn của mọi câu trích dẫn", tác nhân trả lời đúng hơn nhưng cũng thận trọng hơn nhiều: trên 8 thư viện đo lường, nó chỉ soạn 45 câu trả lời thay vì 78. Vì thế thay đổi này chưa được phát hành.
- "Tác nhân đã hội tụ" không phải là thước đo duy nhất. Nếu tác nhân được sửa code cho đến khi test qua, nó sẽ hội tụ ngay cả khi câu trả lời phía sau test là sai. Phép kiểm tra có ý nghĩa là chạy các test mới trên code chưa bị đụng tới.
Công cụ qikly cũng cung cấp các hàm cốt lõi qua một Skill cho tác nhân (chỉ là văn bản hướng dẫn, về lý thuyết LLM vẫn có thể làm trái) và một MCP server chạy cục bộ trên máy người dùng. MCP server buộc tuân thủ: phản hồi của nó không bao giờ chứa các câu trả lời hay tiêu chí chấp nhận mà test dựa vào, nên tác nhân viết code không thể thấy điều mà test kiểm tra, và do đó không thể uốn code chỉ để qua test.
Góc nhìn
Với các lập trình viên và đội ngũ Việt Nam đang dùng AI để viết code và test, nghiên cứu này là một lời nhắc thẳng thắn: một bộ test do chính AI viết, rồi chạy xanh, không đồng nghĩa với an toàn. Con số 41% ở các thư viện non trẻ cho thấy những dự án mới, ít tài liệu, chính là nơi bộ test yếu nhất, mà cũng thường là nơi rủi ro cao nhất.
Thói quen nên hình thành rất đơn giản và không tốn kém: cố ý phá code, xem test bỏ sót gì, và coi mỗi lỗi bỏ sót là một câu hỏi cần người hiểu nghiệp vụ trả lời, chứ không phải một prompt cho AI. Tác nhân chỉ có thể soạn nháp từ những gì đã được viết ra; chuyên gia lĩnh vực mới là người biết code dùng để làm gì, kể cả những quy tắc chưa ai ghi lại. Hãy để AI làm phần việc lặp đi lặp lại như cấy lỗi, soạn nháp từ tài liệu, viết và chạy test, còn những quyết định quan trọng thì để con người đưa ra.
Nguồn: towardsdatascience.com · Quy trình biên tập
Bài viết liên quan
Phần mềm
AI viết 613.318 dòng Lean mô hình hóa CPython, tìm 418 lỗi
10 tháng 11, 2026
Công nghệ
Đừng "thuê ngoài" quá trình học hỏi: Cạm bẫy của việc phụ thuộc quá mức vào AI khi viết code
17 tháng 5, 2026
Công nghệ
Điểm mù trong phát hiện lỗi của AI lập trình: Thách thức không nằm ở độ khó mà ở thông tin thiếu hụt
23 tháng 8, 2026