Kiến trúc sư AMD Mike Clark nói về Zen 6
Mike Clark, kiến trúc sư gốc của vi dòng Zen tại AMD, chia sẻ chi tiết về Zen 6 và Zen 6c: thay đổi về bộ dự đoán nhánh, bộ giải mã kép, đơn vị VNNI và cách bản c 32 nhân đạt hiệu năng ngang CPU server Zen 5 nhanh nhất dù xung nhịp thấp hơn.
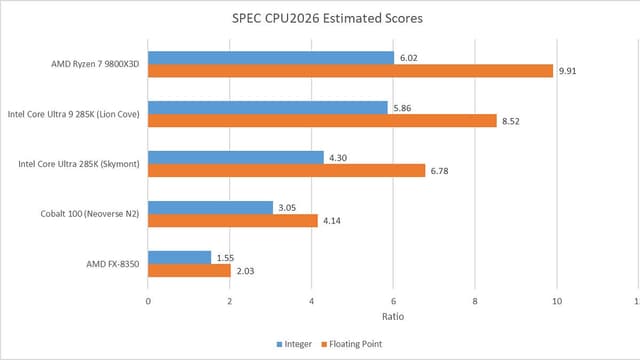
AMD đang chuẩn bị cho thế hệ vi kiến trúc Zen 6 và trong cuộc trò chuyện với Chips and Cheese, Mike Clark — kiến trúc sư gốc của dòng Zen, người có 33 năm làm việc tại AMD — đã giải thích những thay đổi cốt lõi so với Zen 5, cũng như sự khác biệt giữa Zen 6 và Zen 6c. Điểm đáng chú ý nhất: bản Zen 6c 32 nhân đạt hiệu năng ngang CPU server Zen 5 nhanh nhất của AMD trong bài đo SPECint 2026, dù có mức xung nhịp thấp hơn.
Hai dòng lõi, nhưng một hướng tối ưu
Theo Clark, từ thế hệ Zen 4, AMD duy trì hai dòng lõi song song. Trước đây, phiên bản mật độ cao chỉ là giải pháp tiết kiệm diện tích; đến Zen 6, đội thiết kế đã tận dụng nó để tăng thêm IPC (số lệnh xử lý mỗi chu kỳ).
- Dòng cũ được gọi là thiết kế tần số cao.
- Dòng mật độ cao nay trở thành lõi hiệu năng cao cấp, với L3 đầy đủ 4MB mỗi lõi.
- Cấu hình 32 lõi cho 128MB L3 và IPC cao nhất trong dòng lõi này.
Một nguyên tắc quan trọng: AMD không muốn tạo ra khác biệt khiến phần mềm phải tối ưu riêng cho từng kiến trúc. Nhờ mục tiêu tần số thấp hơn, Zen 6c có thể mở rộng dung lượng các hàng đợi — ví dụ bộ lập lịch (scheduler) cho tính toán dấu phẩy động (floating-point) — để tăng thêm IPC và khai thác tốt hơn môi trường SMT (đa luồng đồng thời).
Front end và bộ dự đoán nhánh
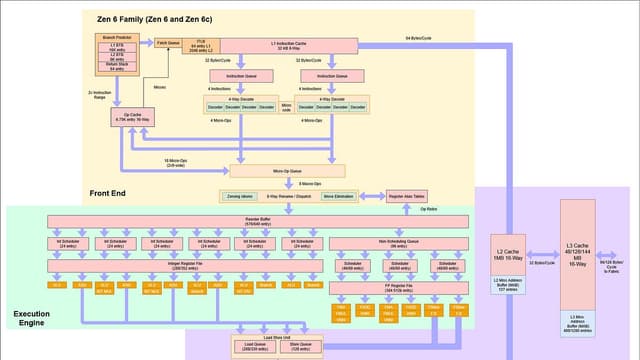
Zen 5 đặt nền móng mới với khả năng giải mã kép (dual decode): nạp hai khối lệnh cơ bản và đưa xuống pipeline. Ở Zen 6, AMD tối ưu khả năng này để một luồng đơn tận dụng tốt hơn cả hai cụm giải mã, giảm lãng phí năng lượng và cải thiện hiệu quả phân phối lệnh.
Về bộ dự đoán nhánh (branch predictor), Zen 6 giảm độ trễ dự đoán sai — tức số chu kỳ cần để phục hồi khi dự đoán sai — mà không giảm độ chính xác, thậm chí còn chính xác hơn chút ít so với Zen 5. Clark cho biết đội ngũ đã thiết kế bảng dự đoán hiệu quả hơn thay vì tăng diện tích, đồng thời luôn tập trung vào việc khôi phục pipeline nhanh nhất có thể sau mỗi lần dự đoán sai. Ông cũng tiết lộ AI đang được dùng để hỗ trợ khám phá không gian thiết kế cho bộ dự đoán nhánh.
Thay đổi trong khối thực thi
Một điểm đáng chú ý là số đơn vị nhân số nguyên (integer multiply) giảm từ ba xuống hai. Lý do nằm ở việc Zen 5 dùng bộ lập lịch hợp nhất, còn Zen 6 quay lại kiến trúc bộ lập lịch phân tán hơn để mở rộng quy mô. Vì đơn vị nhân thứ ba của Zen 5 không mang lại nhiều lợi ích, AMD chọn hai đơn vị để tối ưu diện tích và bộ lập lịch.
Ở phần vector, Zen 6 bổ sung hai đơn vị VNNI (chỉ thị tích hợp cho mạng nơ-ron). Clark thừa nhận khi khởi động thiết kế, khái niệm "agentic core" chưa phổ biến, nhưng AMD luôn tin lõi CPU có vai trò trong khối việc AI: điều phối, xử lý kiểu dữ liệu và các mô hình nhỏ. Việc thêm VNNI được quyết định khá muộn do sơ đồ mặt bằng đã chốt, nhưng đội ngũ đã xoay xở đưa thêm được hai đường ống.
Ngoài ra, Zen 6 cho phép bốn lệnh nạp vector cùng lúc (với độ rộng 128 hoặc 256 bit) thay vì hai như Zen 5. Clark giải thích phần cứng vốn đã có 1.024 dây dẫn cho hai lệnh 512 bit, nên việc dùng chúng theo từng phần nhỏ là điều đội Zen 6 hoàn thiện.
Về L2, Zen 6 khắc phục hạn chế của Zen 5 khi không phải lúc nào cũng đạt 64 byte mỗi chu kỳ cho thao tác đọc. Nguyên nhân một phần là việc nạp trước (prefetch) quá mức chiếm băng thông; Zen 6 đảm bảo duy trì prefetch song song với yêu cầu thực tế và giảm xung đột.
L3 và bộ nhớ
Với hai cấu hình CCD 12 lõi và 32 lõi, độ trễ L3 có khác biệt. Clark cho biết AMD tăng kích thước các hàng đợi trong lõi để chịu được độ trễ cao hơn, đồng thời duy trì băng thông trong lưới L3 nhờ những kỹ thuật ông không thể tiết lộ. Việc bổ sung LPDDR5X vào hệ sinh thái EPYC (ở Verano) cũng không ảnh hưởng lớn đến thiết kế lõi, vì nền tảng đã dư băng thông nhờ MRDIMM.
"Chúng tôi không thiết kế Zen 6 để thành một lõi agentic. Khi bắt đầu, thậm chí chưa ai dùng thuật ngữ đó." — Mike Clark
Góc nhìn
Với lập trình viên và kỹ sư hệ thống, thông điệp quan trọng là AMD cam kết giữ Zen 6 và Zen 6c "cùng cảm giác" về mặt tối ưu — nghĩa là mã đã tinh chỉnh cho một kiến trúc không phải viết lại cho kiến trúc kia. Điều này giúp việc triển khai trên máy chủ dùng bản 32 lõi mật độ cao bớt rủi ro hơn.
Việc bổ sung VNNI và tăng khả năng nạp vector cho thấy CPU vẫn có chỗ đứng trong các tác vụ suy luận nhỏ và điều phối AI, dù không thể thay thế GPU. Với doanh nghiệp đang cân nhắc hạ tầng, đây là tín hiệu để không gộp toàn bộ khối lượng AI vào GPU mà phân tầng hợp lý giữa CPU và tăng tốc chuyên dụng.
Nguồn: chipsandcheese.com · Quy trình biên tập