LensVLM: Apple trình làng mô hình AI đọc văn bản từ ảnh nén với tỷ lệ nén lên đến 10 lần
Apple công bố LensVLM, một mô hình ngôn ngữ - thị giác 9 tỷ tham số có khả năng đọc văn bản từ ảnh nén mà vẫn duy trì độ chính xác cao. Bằng cách quét ảnh nén và chỉ mở rộng có chọn lọc những vùng quan trọng, LensVLM đạt hiệu quả nén gấp 10,1 lần so với các phương pháp truyền thống trên bảy bộ kiểm thử hỏi đáp văn bản.
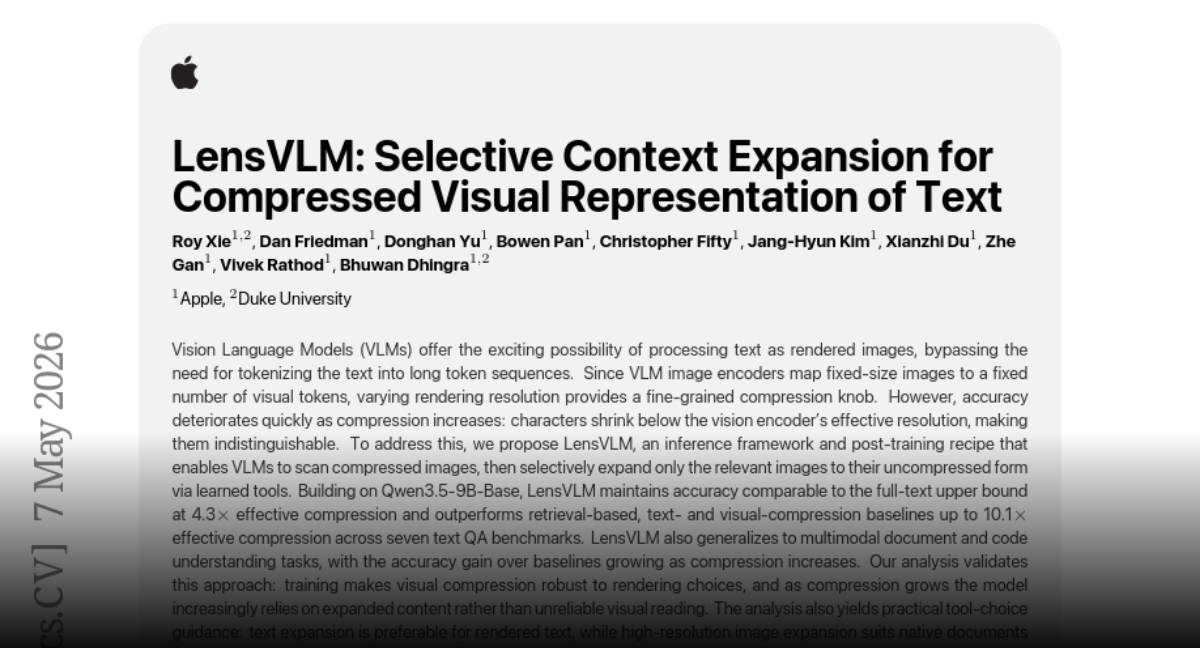
Apple vừa giới thiệu LensVLM, một mô hình ngôn ngữ - thị giác (Vision-Language Model - VLM) với 9 tỷ tham số, được thiết kế để xử lý văn bản dưới dạng hình ảnh nén mà không làm giảm độ chính xác. Nghiên cứu này mở ra hướng đi mới trong việc tối ưu hóa chi phí tính toán cho các mô hình AI đa phương thức.
Bài toán: Đọc văn bản từ ảnh nén
Các mô hình ngôn ngữ - thị giác hiện nay có thể xử lý văn bản được hiển thị dưới dạng hình ảnh, giúp bỏ qua bước mã hóa văn bản thành chuỗi token dài. Vì bộ mã hóa hình ảnh của VLM ánh xạ một hình ảnh có kích thước cố định thành một số lượng token thị giác cố định, việc thay đổi độ phân giải hiển thị sẽ tạo ra một "núm vặn" nén linh hoạt.
Tuy nhiên, vấn đề nảy sinh khi tỷ lệ nén tăng lên: các ký tự bị thu nhỏ xuống dưới ngưỡng phân giải hiệu dụng của bộ mã hóa thị giác, khiến chúng trở nên không thể phân biệt được. Độ chính xác vì thế giảm nhanh chóng.
LensVLM giải quyết như thế nào?
Nhóm nghiên cứu đề xuất LensVLM — một khung suy luận (inference framework) kết hợp quy trình huấn luyện hậu kỳ (post-training recipe) cho phép VLM:
- Quét ảnh nén để nắm bố cục tổng thể
- Mở rộng có chọn lọc chỉ những vùng hình ảnh thực sự liên quan về dạng không nén, thông qua các công cụ đã được học
Cách tiếp cận này giúp mô hình duy trì độ chính xác tương đương với giới hạn trên khi xử lý toàn bộ văn bản gốc, ngay cả ở mức nén hiệu quả 4,3 lần.
Kết quả thử nghiệm ấn tượng
Được xây dựng trên nền tảng Qwen3.5-9B-Base, LensVLM vượt trội so với các phương pháp dựa trên truy xuất (retrieval), nén văn bản và nén thị giác trên bảy bộ kiểm thử hỏi đáp văn bản, đạt mức nén hiệu quả lên đến 10,1 lần.
Điểm đáng chú ý là mô hình này còn tổng quát hóa tốt sang các tác vụ hiểu tài liệu đa phương thức và hiểu mã nguồn, với mức tăng độ chính xác so với các đường cơ sở ngày càng lớn khi tỷ lệ nén tăng.
Phân tích và hướng dẫn thực tiễn
Quá trình phân tích của nhóm nghiên cứu đã xác thực cách tiếp cận này:
- Huấn luyện giúp nén thị giác trở nên bền vững trước các lựa chọn hiển thị khác nhau
- Khi nén tăng, mô hình ngày càng dựa vào nội dung được mở rộng thay vì đọc thị giác không đáng tin cậy
Nghiên cứu cũng đưa ra hướng dẫn thực tiễn về việc chọn công cụ: mở rộng văn bản phù hợp hơn cho văn bản được hiển thị, trong khi mở rộng hình ảnh độ phân giải cao phù hợp với các tài liệu gốc mà các dấu hiệu bố cục mang thông tin liên quan đến tác vụ.
Ý nghĩa với người dùng Việt Nam
Đối với cộng đồng công nghệ Việt Nam, LensVLM mở ra tiềm năng ứng dụng đáng kể trong các lĩnh vực như số hóa tài liệu, xử lý hóa đơn và chứng từ, hay trích xuất thông tin từ ảnh chụp văn bản — những tác vụ rất phổ biến trong chuyển đổi số doanh nghiệp. Việc giảm chi phí tính toán khi xử lý khối lượng lớn tài liệu có thể giúp các startup AI Việt Nam tối ưu hạ tầng và chi phí vận hành đáng kể.
Mã nguồn và bài báo của LensVLM hiện đã được công bố trên arXiv với mã định danh 2605.07019, cho phép cộng đồng nghiên cứu và phát triển truy cập và thử nghiệm.