
Lỗ hổng đo lường trong quy trình kiểm định mô hình lượng tử hóa
Hầu hết các quy trình kiểm định mô hình lượng tử hóa (quantization) chỉ dựa trên các chỉ số độ chính xác không phụ thuộc ngưỡng, khiến chúng không thể phát hiện một lỗi nghiêm trọng: ngưỡng quyết định (threshold) đã bị lệch sau khi lượng tử hóa. Bài viết phân tích vì sao các cổng kiểm định hiện tại "mù" trước lỗi này và đề xuất hai chỉ số FAR/FRR đo tại đúng ngưỡng thực tế để bịt lỗ hổng đó.
Trong mỗi quy trình đưa mô hình lượng tử hóa (quantization) lên môi trường thực tế, luôn có một dòng quyết định xem bản build int8 có được xuất xưởng hay không. Và theo một khảo sát trên mười tài liệu hướng dẫn phổ biến, dòng đó gần như luôn giống nhau: so sánh độ chính xác của int8 với FP32, lệch không quá 1% thì cho qua.
Nhưng có một con số không bao giờ xuất hiện trong bất kỳ cổng kiểm định nào: số đo phụ thuộc vào vị trí ngưỡng quyết định. Bài viết dưới đây là một cuộc kiểm toán chỉ ra rằng sự vắng mặt này không phải sơ suất, mà là lỗ hổng cấu trúc — và cách bịt nó chỉ tốn hai con số cùng một buổi chiều đo đạc.
Đếm xem cổng kiểm định thực sự nhìn thấy gì
Hãy rà lại bảng tiêu chí nghiệm thu của bạn và đếm những con số mà giá trị của chúng phụ thuộc vào vị trí ngưỡng quyết định. Trong mười tài liệu được khảo sát, câu trả lời là không — mọi cổng đều được dựng từ độ chính xác, top-1, top-5, phương sai đầu ra, độ trễ hay bộ nhớ.
Mười tài liệu đó chia làm ba nhóm: hai tài liệu nêu mức chênh lệch độ chính xác cụ thể (ví dụ "độ chính xác INT8 ≥ FP32 − 1%"), năm tài liệu chỉ bảo so sánh độ chính xác với FP32 mà không nêu con số, và ba tài liệu còn lại là quy trình khắc phục khi kết quả so sánh không đạt.
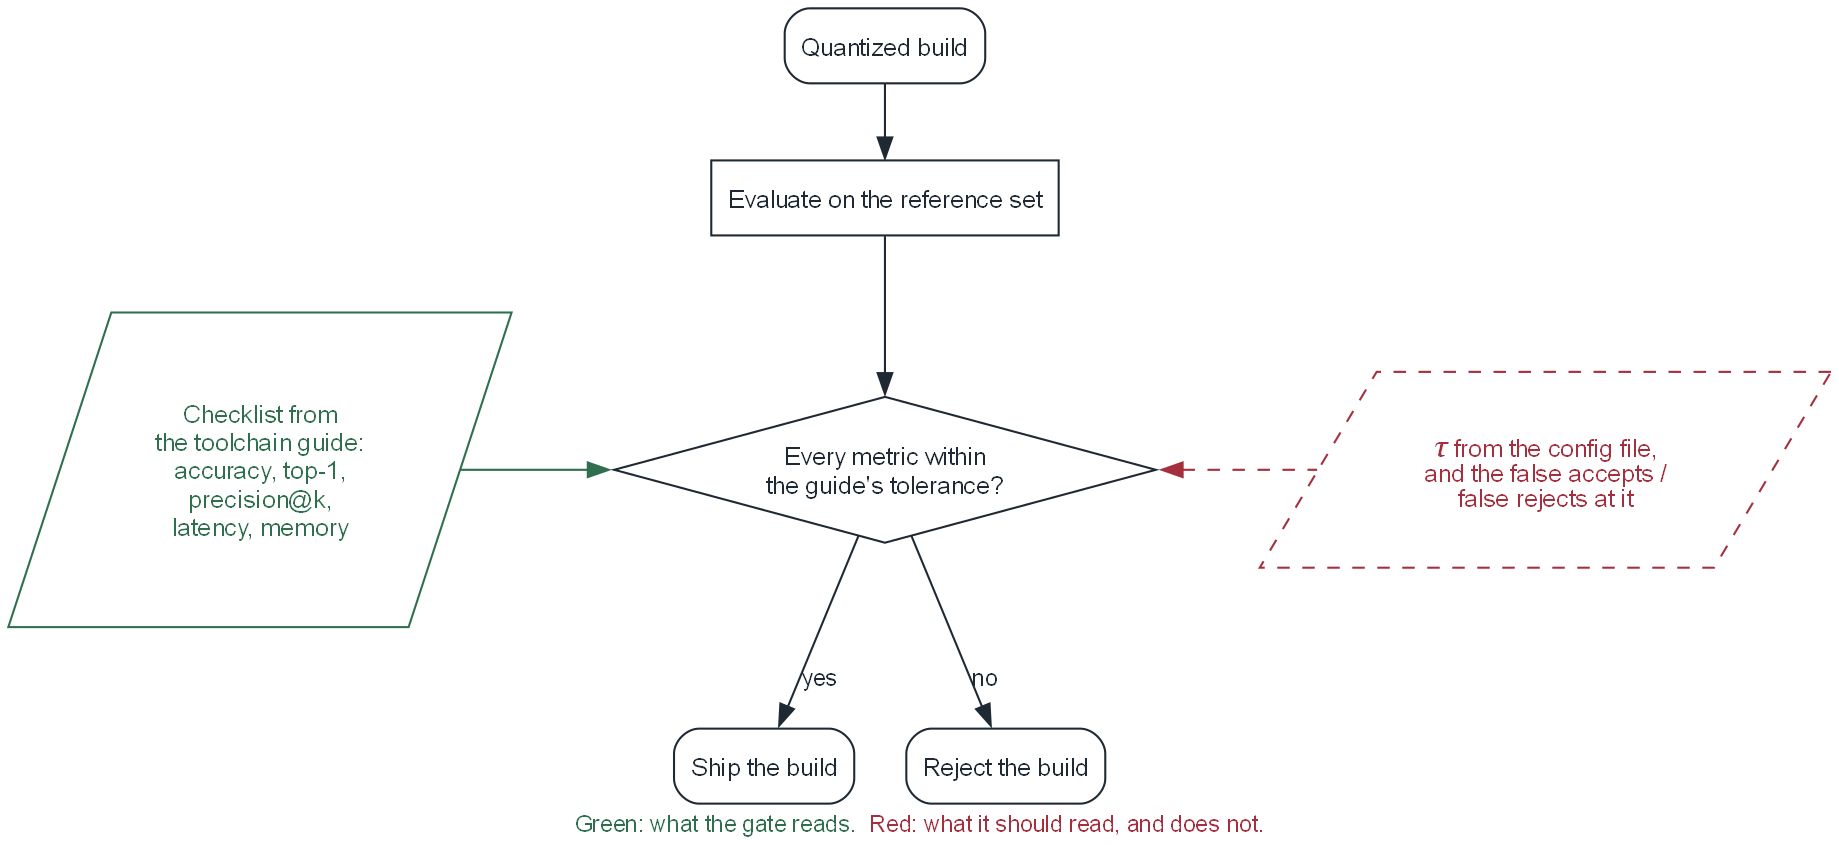 Minh họa các chỉ số không phụ thuộc ngưỡng trong cổng kiểm định lượng tử hóa
Vấn đề nằm ở chỗ: những chỉ số này đánh giá mô hình, nhưng thứ quyết định chấp nhận hay từ chối một kết quả lại không phải mô hình — mà là một hằng số bọc quanh nó, tức một ngưỡng tương đồng, một ngưỡng tin cậy hay một cổng từ chối, được hiệu chỉnh trên điểm số FP32.
Lượng tử hóa không phải một thao tác xuất mô hình trung tính; nó thay đổi cách điểm số được sinh ra. Một cổng kiểm định toàn số không phụ thuộc ngưỡng thì không thể hỏi liệu hằng số đó còn nằm đúng chỗ bạn đặt hay không, dù bạn có thêm bao nhiêu chỉ số loại này đi nữa.
Ngưỡng kế thừa và cái giá phải trả
Tác giả đo lỗi này trên một bài toán xác minh khuôn mặt: dùng bộ mã hóa ArcFace đã huấn luyện trước, tạo bản int8 bằng bộ công cụ Hailo, rồi so sánh trực tiếp.
Kết quả trên các chỉ số quen thuộc trông như gần như miễn phí:
- precision@10: 0.978 → 0.972
- rank-1: 0.990 → 0.985
Nếu dừng ở đây — và cổng kiểm định cho phép bạn dừng — bạn sẽ xuất xưởng. Nhưng cả hai chỉ số này đều hỏi "ai trả về đầu tiên", chứ không hỏi "điểm số cao đến mức nào". Chúng không phụ thuộc ngưỡng theo bản chất.
Giờ hãy giữ nguyên ngưỡng quyết định trong file cấu hình — đúng con số FP32 đã được hiệu chỉnh — rồi chấm điểm trên tập cặp danh tính hoàn toàn tách biệt:
Số lần chấp nhận nhầm (false accept) tăng từ 30 lên 104 trên 10.000 cặp mạo danh, tức khoảng 3,5 lần so với mức kế thừa. Số lần từ chối nhầm (false reject) cũng tăng từ 582 lên 745 trên 10.000 cặp chính danh.
Điều đáng chú ý: hai tỷ lệ lỗi cùng xấu đi một lúc. Đây không phải một điểm vận hành trượt dọc theo cùng một đường cong, mà là một đường cong hoàn toàn khác. Trong khi đó, một phần năm danh sách láng giềng bị đảo (recall@10 so với FP32 chỉ còn 0,81) mà con số trên bảng kiểm định chỉ nhích sáu phần mười điểm.
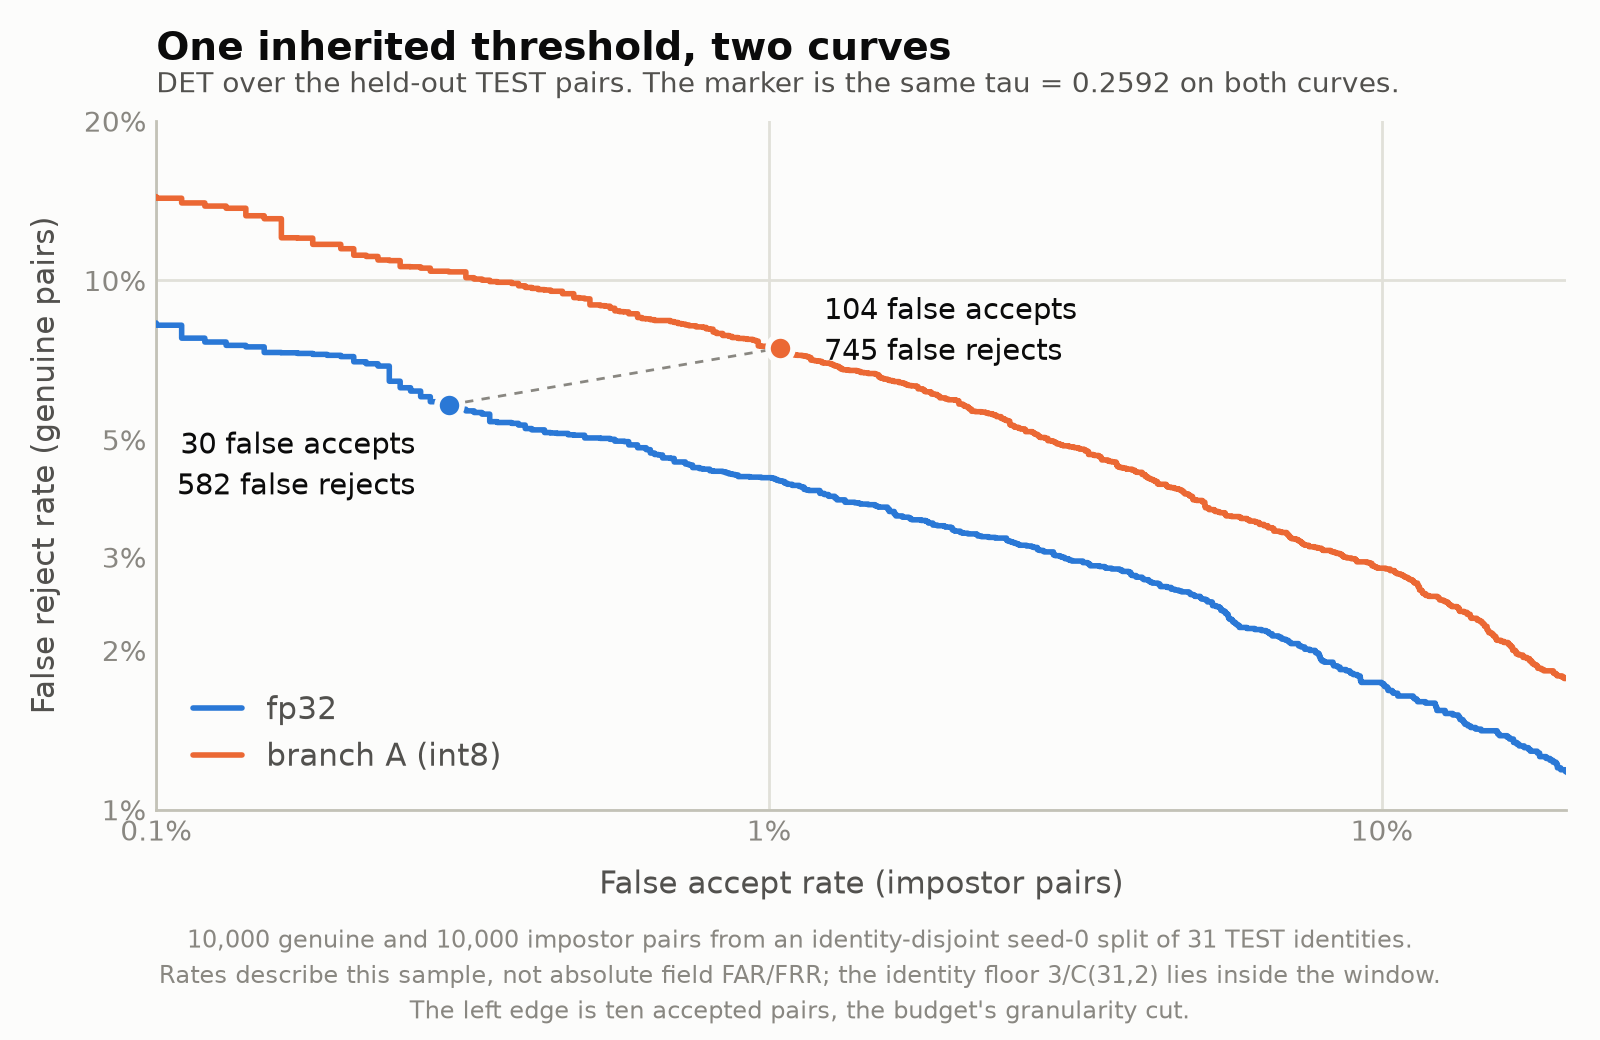 Hai đường cong DET của bản FP32 và bản int8 trên cùng tập cặp kiểm tra
Vì sao các cách kiểm tra hiện có đều bỏ lỡ
Phản xạ đầu tiên là nghi ngờ cách đo. Nhưng cách đo ở đây chính là cách đo đúng đắn: chấm tại một ngưỡng cố định, đúng con số được suy ra trên tập phát triển (DEV) của FP32 rồi giữ nguyên trên tập kiểm tra (TEST).
Quy ước phổ biến trong lĩnh vực — báo cáo TAR tại FAR = 1e-4 — lại âm thầm suy lại ngưỡng trên chính tập đánh giá trước khi in kết quả. Báo cáo NIST FRVT Phần 3 chỉ thẳng ra rằng quy ước này che giấu các dao động về tỷ lệ chấp nhận nhầm và bóp méo tỷ lệ từ chối nhầm. Một hệ thống đã triển khai thực tế không tự suy lại ngưỡng; nó giữ một hằng số trong file cấu hình cho đến khi có người sửa.
Phản xạ thứ hai là nghi ngờ chưa nhìn đủ góc cạnh. Tác giả đã nhìn: các kiểm tra hình học như số chiều nội tại (269 → 271) hay độ tương phản (0,596 → 0,567) đều phẳng lì. Ngay cả các chỉ số so sánh trực tiếp đầu ra int8 với FP32 — như phương sai đầu ra hay SQNR theo tầng — cũng không thể nói được điểm số đã dịch về phía nào của ngưỡng, hay hằng số hiện cách tỷ lệ mà nó được hiệu chỉnh bao xa.
Phản xạ thứ ba là vặn nút trong trình biên dịch: bảo vệ các tầng đầu và cuối bằng độ chính xác 16-bit. Tác giả thử bốn phạm vi khác nhau — tầng đầu ra embedding, tầng đó cộng batch-norm liền trước, tầng đầu vào, và cả hai đầu cùng lúc — và cả bốn đều để số lần chấp nhận nhầm ở mức 102–104, không phân biệt được với bản int8 đầy đủ.
Lý do rất đơn giản: heuristic đó chưa bao giờ hứa hẹn gì về thang đo mà một ngưỡng cosine đang được đo trên đó. Mọi luận cứ đằng sau nó đều là luận cứ về độ chính xác. Ta với tay lấy công cụ về độ chính xác chỉ vì đó là những công cụ sẵn có — đúng cái phản xạ đã đưa một con số độ chính xác vào cổng kiểm định.
Lỗ hổng này nằm ở những đâu khác
Khuôn mặt là trường hợp có thể đo được, nhưng lỗ hổng mang tính cấu trúc: bất cứ nơi nào một bộ mã hóa phát ra điểm số liên tục và có thứ gì đó phía sau cắt nó thành quyết định, nhát cắt đó là một hằng số được hiệu chỉnh cho một phiên bản bộ mã hóa, và không có gì trong cổng kiểm định kiểm tra lại nó.
- Khớp thư viện xe cộ: gần như đồng dạng với bài toán khuôn mặt — cùng cosine, cùng chấp nhận hoặc từ chối.
- Bộ phân loại tập đóng: không có ngưỡng tương đồng, nhưng có ngưỡng tin cậy để gọi con người vào, và hiệu chuẩn độ tin cậy chính là thứ lượng tử hóa được chứng minh là làm xê dịch.
- Bộ phát hiện đối tượng: có ngưỡng điểm hộp với đường cong precision-recall phía sau.
- Truy xuất thuần túy không có gì để chấp nhận hay từ chối: đây là nơi duy nhất không có ngưỡng nào "chết", vì chưa từng có ngưỡng nào tồn tại.
Bốn dòng bổ sung vào cổng kiểm định
Chỉ cần bốn bước, không thay thế bất cứ thứ gì đang có, mà nằm cạnh mức chênh lệch độ chính xác:
-
Đặt tên cho điểm vận hành mà bản build cam kết — một tỷ lệ chấp nhận nhầm mục tiêu, một ngưỡng tin cậy để gọi con người vào, bất cứ điều gì quy tắc quyết định của bạn thực sự hướng tới. Suy ra từ chi phí của mỗi hướng lỗi.
-
Báo cáo FAR và FRR tại ngưỡng kế thừa — như chẩn đoán, không phải chốt chặn. Đây chính là cặp số mà bảng kiểm định đã thiếu: 104 lần chấp nhận nhầm so với 30, và 745 lần từ chối nhầm so với 582. Đọc cả hai phía, vì NIST cũng yêu cầu đúng như vậy: hệ thống chạy ở ngưỡng cố định, nên cả hai tỷ lệ phải được báo cáo tại ngưỡng đó. Nhưng đừng chặn ở bước này — hằng số cũ không có nghĩa vụ phải sống sót qua một bản build mới.
-
Suy lại ngưỡng trên mô hình lượng tử hóa, rồi chốt chặn trên FAR và FRR tại ngưỡng mới — đây mới là bước chặn. Tiêu chí là so sánh, không phải giá trị tuyệt đối: FP32 đứng ở ngưỡng của nó so với bản lượng tử hóa đứng ở ngưỡng của nó, trên cùng tập cặp giữ lại. Việc suy lại đã cắt chấp nhận nhầm từ 104 xuống 44, nhưng lại đẩy từ chối nhầm từ 745 lên 959. Sửa chữa là cần thiết, nhưng không đủ và không miễn phí.
-
Đóng gói ngưỡng vào chính tệp mô hình, có đánh phiên bản — không bao giờ để nó thành một hằng số toàn cục trong file cấu hình sống lâu hơn mô hình mà nó được hiệu chỉnh. Một ngưỡng là đầu ra của một bản build cụ thể. Quy trình nào tạo ra bản build mới mà không tạo ra ngưỡng mới là đang xuất xưởng một con số trỏ tới một mô hình không còn tồn tại.
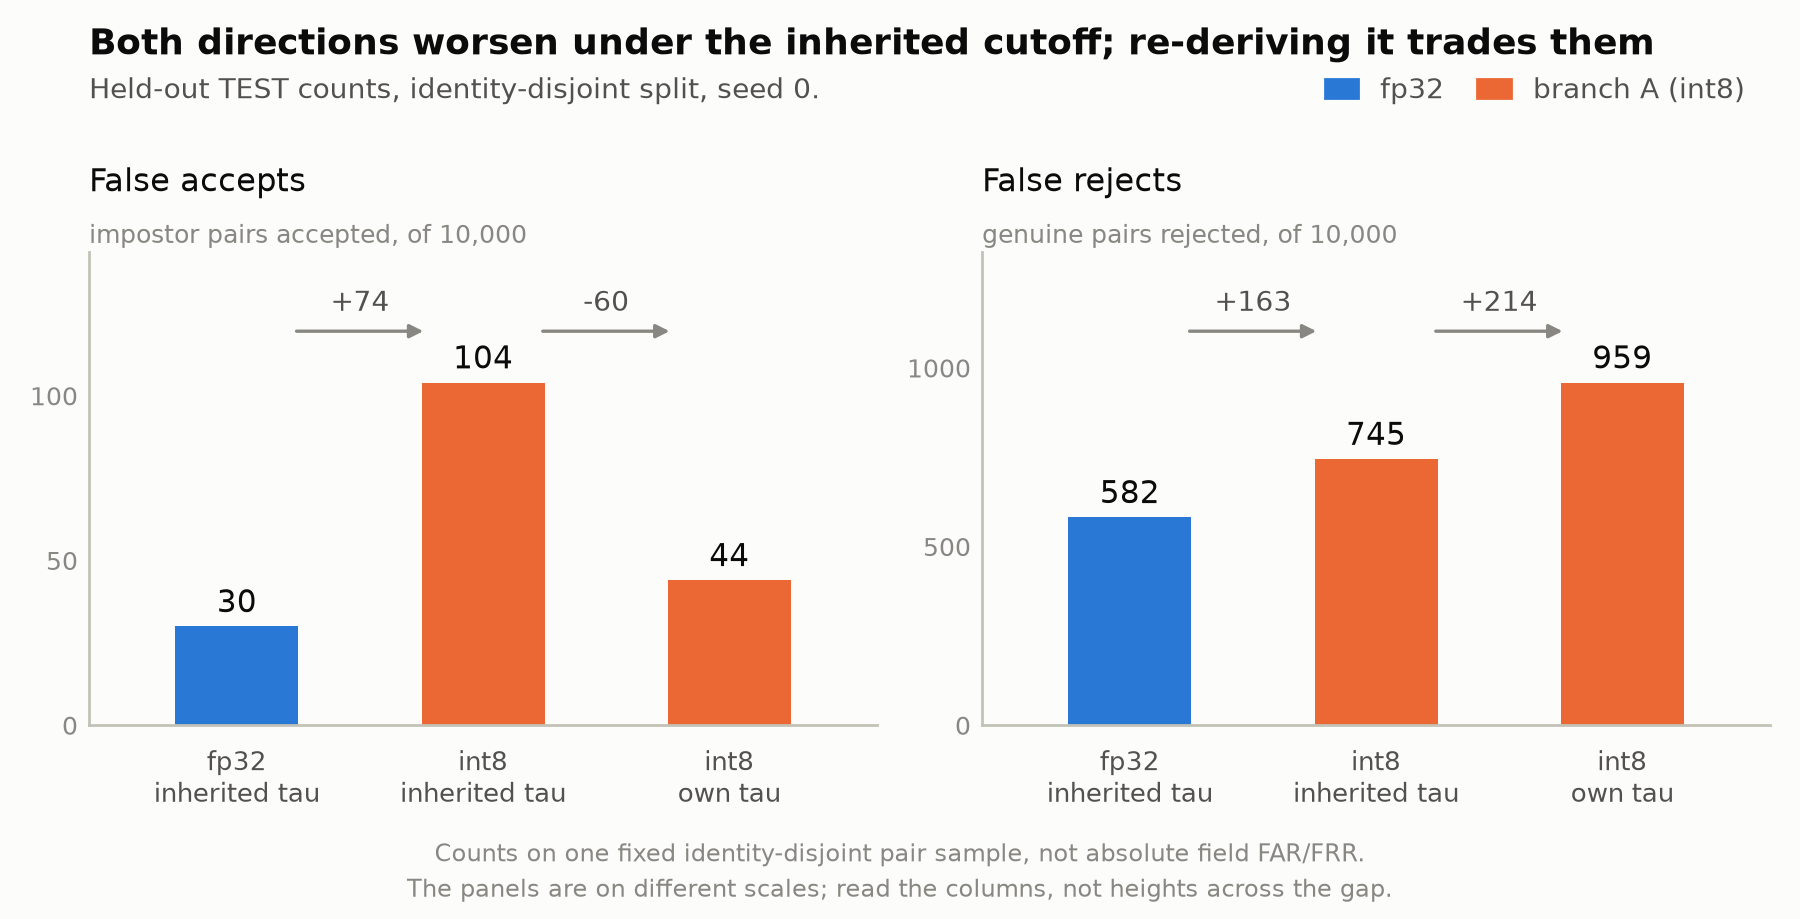 Hai hướng lỗi tại ba điểm vận hành khác nhau
Danh sách những thứ không được tính là bằng chứng
Phần này không ai đưa cho tác giả, nhưng lại quan trọng nhất — những thứ không chứng minh được rằng quy tắc quyết định đã sống sót:
- TAR tại FAR cố định lấy từ một báo cáo: con số đó suy lại ngưỡng trước khi in ra; hệ thống triển khai thực tế không làm vậy.
- Top-1, rank-1, precision@k: không phụ thuộc ngưỡng theo bản chất, nên dù ngưỡng có trôi đi đâu thì chúng cũng không nhìn thấy.
- Số chiều nội tại, độ tương phản, hay bất kỳ kiểm tra hình học toàn cục nào: cũng không phụ thuộc ngưỡng — đó là lý do tất cả đều xanh.
- "Chúng tôi đã suy lại ngưỡng trên DEV": hành động không phải kết quả. Kết quả là FAR và FRR trên tập cặp giữ lại tại ngưỡng đó.
- "FAR giảm sau khi suy lại ngưỡng": so với con số kế thừa thì đúng, nhưng chính hành động đó lại làm tăng từ chối nhầm. Phải kiểm tra cả hai phía.
- "Chúng tôi đạt 1e-3": không thể trả lời trên 31 danh tính. Hãy báo cáo số đếm và tỷ lệ thay vì tỷ lệ tuyệt đối.
Kết luận: dòng quyết định vẫn một dòng, nhưng phải mang hai con số
Mười tài liệu, một kết quả đếm: không một con số nào trong cổng kiểm định của chúng phụ thuộc vào vị trí ngưỡng quyết định. Thêm bao nhiêu bảng độ chính xác cũng không thay đổi điều đó, và với tay vào trình biên dịch cũng vậy.
Thứ thay đổi cục diện là cặp số mà cổng kiểm định đang thiếu — số lần chấp nhận nhầm và số lần từ chối nhầm tại đúng ngưỡng mà file cấu hình của bạn đang giữ, đọc một lần tại ngưỡng kế thừa và một lần tại ngưỡng mà bản build mới xứng đáng có.
Dòng quyết định xem bản int8 có xuất xưởng hay không vẫn chỉ là một dòng. Nhưng nó phải mang hai con số mà một mức chênh lệch độ chính xác không thể thay thế được. Với các đội ngũ AI tại Việt Nam đang tối ưu mô hình để chạy trên thiết bị biên — từ camera giám sát, thiết bị kiểm soát ra vào cho tới ứng dụng xác thực danh tính — bài học này đặc biệt đáng lưu tâm: một mô hình nhẹ đi đáng kể mà ngưỡng quyết định không được hiệu chỉnh lại có thể âm thầm làm hệ thống vừa dễ bị qua mặt hơn, vừa khó tính hơn với người dùng thật.

