
Lỗ hổng rò rỉ KV cache giữa các yêu cầu trên mô hình GLM-5.3 của Cloudflare Workers AI
Cloudflare vừa công bố sự cố bảo mật trên mô hình GLM-5.3 của Workers AI, khi 155 phản hồi chứa dữ liệu từ các phiên của người dùng khác do lỗi cấu hình và bug trong engine suy luận SGLang. Sự cố kéo dài từ ngày 27/8 đến 9/9 và đã được khắc phục, đồng thời Cloudflare phối hợp với nhóm SGLang để vá lỗi ở mã nguồn mở.
Cloudflare vừa công bố báo cáo chi tiết về một sự cố bảo mật nghiêm trọng trên mô hình GLM-5.3 của dịch vụ Workers AI. Trong khoảng thời gian từ ngày 27/8 đến 9/9/2026, một số khách hàng nhận được phản hồi chứa dữ liệu từ các yêu cầu của người dùng khác gửi đến cùng mô hình. Tổng cộng 155 phản hồi bị ảnh hưởng, tất cả đều thuộc các prompt dài hơn 681.280 token.
Sự cố được phát hiện nhờ báo cáo của chuyên gia bảo mật Gadi Evron từ Knostic, gửi qua chương trình HackerOne của Cloudflare. Sau khi xác minh và khắc phục, Cloudflare đã đưa mô hình trở lại hoạt động vào ngày 9/9 và khẳng định không có mô hình nào khác trên Workers AI bị ảnh hưởng.
 Minh họa kiến trúc xử lý suy luận trên Workers AI
Nguyên nhân: Hai lỗi chồng chéo
Theo Cloudflare, sự cố bắt nguồn từ hai vấn đề cùng lúc. Thứ nhất là cấu hình sai trong engine suy luận mã nguồn mở SGLang mà Cloudflare sử dụng. Mô hình GLM 5.3 được triển khai với cửa sổ ngữ cảnh 1.048.576 token, nhưng bể KV cache trên các GPU prefill chỉ chứa được 681.280 token. Cloudflare biết về sự chênh lệch này trước khi ra mắt nhưng cho rằng engine sẽ trả về lỗi với các prompt vượt quá khả năng xử lý.
Thứ hai là bug trong cách SGLang xử lý các yêu cầu vượt độ dài trong chế độ tách rời prefill/decode. Khi một prompt không vừa bể nhớ, hệ thống đánh dấu yêu cầu là bị từ chối và thay bằng một token giữ chỗ, nhưng thay vì hủy và trả lỗi cho client, prefill vẫn tạo KV cache cho token giữ chỗ đó rồi chuyển sang node decode. Node decode nhận tín hiệu "chuyển xong" và tưởng rằng toàn bộ cache đã được ghi đè, trong khi phần lớn dữ liệu cũ từ các yêu cầu trước vẫn còn nguyên. Kết quả là phản hồi có thể chứa nội dung từ phiên làm việc của người dùng khác.
Quy trình khắc phục
Cloudflare đã vô hiệu hóa mô hình chỉ 40 phút sau khi tuyên bố sự cố, sau đó tiến hành hai biện pháp song song:
- Sửa cấu hình: điều chỉnh để bể KV pool chứa khoảng 2,04 triệu token, gấp đôi độ dài ngữ cảnh, nhờ đó đường dẫn từ chối không bao giờ bị kích hoạt với yêu cầu hợp lệ.
- Vá engine: yêu cầu mang trạng thái bị từ chối sẽ được loại bỏ ngay tại hàng đợi tiếp nhận, trước khi diễn ra bất kỳ bước khởi tạo hay chuyển KV nào. Bản vá này được đề xuất lên dự án SGLang với mã #38704.
Cloudflare cho biết đã kiểm thử cả hai thay đổi bằng script tái hiện của nhà nghiên cứu và các bài kiểm tra canary nội bộ trước khi mở lại dịch vụ. Đại diện công ty cũng thừa nhận một lỗ hổng trong quy trình kiểm thử trước đây: họ chỉ xác thực mã phản hồi HTTP và hiệu năng, mà không kiểm tra tính mạch lạc của nội dung đầu ra.
"Chúng tôi đã nhận thức được sự chênh lệch kích thước này; tuy nhiên, trong quá trình kiểm thử trước khi ra mắt, chúng tôi chỉ quan sát thấy mã HTTP thành công và luồng dữ liệu không có khung lỗi" — báo cáo của Cloudflare.
Phối hợp với cộng đồng SGLang
Sự cố này không phải lần đầu Cloudflare ghi nhận các lỗi liên quan đến vòng đời bộ nhớ KV cache. Bug tương tự đã được người dùng khác báo cáo lên SGLang từ ngày 6/7/2026. Sau sự cố, Cloudflare đã làm việc trực tiếp với nhóm SGLang tại RadixArk để đưa ra các bản vá lên nhánh chính.
Các bản phát hành SGLang v0.5.20, v0.5.21 và v0.5.22 đã tích hợp một loạt bản vá, bao gồm:
- Loại bỏ yêu cầu prefill bị hủy trước khi kết quả đến node decode
- Hủy cả hai nửa của yêu cầu khi client ngắt kết nối hoặc prefill gặp lỗi
- Kiểm tra checksum của KV cache được chuyển giao trước khi sinh phản hồi
- Giới hạn kích thước lô chuyển giao Mooncake để tránh tồn đọng các thao tác ghi
Cloudflare khuyến nghị mọi đơn vị vận hành SGLang ở chế độ tách rời nên cập nhật lên phiên bản v0.5.22 trở lên, đồng thời đo kích thước KV pool so với độ dài ngữ cảnh trên mọi node sau mỗi lần thay đổi trọng số, lượng tử hóa hoặc mức song song.
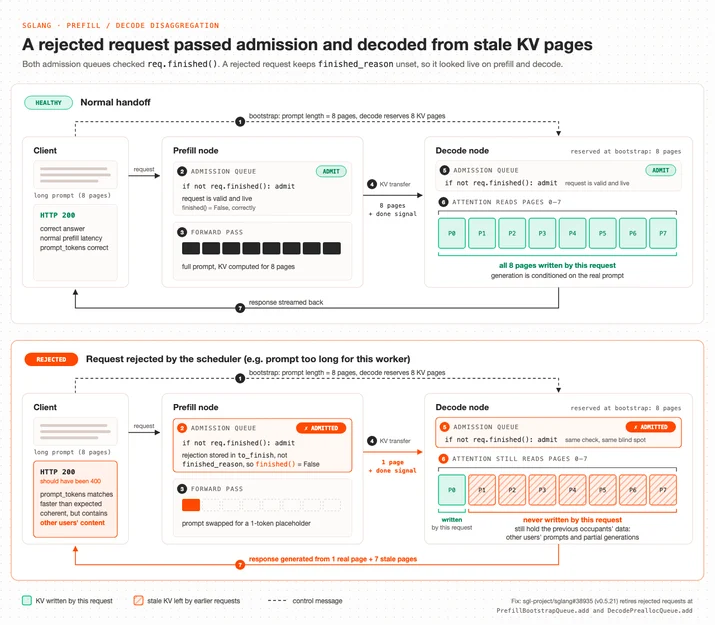 Sơ đồ luồng xử lý và chuyển giao KV cache
Hướng tới giải pháp lâu dài
Cloudflare nhìn nhận rằng các bản vá và kiểm tra cấu hình chỉ giảm số cách một trang bộ nhớ có thể bị lạm dụng, chứ không loại bỏ hoàn toàn rủi ro. Giải pháp bền vững mà công ty đang theo đuổi là để engine tự phát hiện, ngay tại thời điểm đọc, rằng một yêu cầu sắp truy cập vào trang bộ nhớ không thuộc sở hữu của nó và trả lỗi cho riêng yêu cầu đó.
Nguyên mẫu của cơ chế này, với mỗi trang KV mang một thẻ thay đổi khi trang được cấp phát lại, chỉ tốn dưới 1% thông lượng và độ trễ đuôi trong thử nghiệm. Cloudflare đang phối hợp với nhóm SGLang để xây dựng phiên bản chạy được trên mọi kiến trúc mô hình thay vì duy trì các bản vá riêng.
Bên cạnh đó, công ty cũng đang áp dụng các phương pháp xác minh hình thức (formal verification) — vốn đã dùng cho hệ thống DNS Topaz và QuePaxa — vào giao thức chuyển giao KV cache qua RDMA. Mục tiêu là chứng minh, trong phạm vi có thể, rằng những lỗi như thế này không thể tái diễn.
Góc nhìn cho người dùng và đơn vị vận hành tại Việt Nam
Sự cố là lời nhắc nhở với các doanh nghiệp Việt Nam đang tự triển khai hoặc thuê dịch vụ suy luận LLM: cô lập dữ liệu giữa các tenant không tự động có chỉ vì hệ thống chạy trên hạ tầng đám mây. Với các đơn vị tự vận hành SGLang hoặc vLLM cho mô hình nội bộ, việc nâng cấp lên bản vá mới nhất và kiểm tra nghiêm ngặt mối tương quan giữa độ dài ngữ cảnh và kích thước bể KV cache là bước bắt buộc. Với bên sử dụng dịch vụ, nên ưu tiên nhà cung cấp có quy trình công bố lỗ hổng minh bạch và cam kết xử lý sự cố theo chuẩn phối hợp.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
OpenAI công bố ba phát hiện khoa học lớn và cách làm việc mới với giới học thuật
26 tháng 10, 2026