
Mạng nơ-ron học đọc chữ số chỉ từ nhiễu ngẫu nhiên: khi học sinh học lén từ giáo viên
Một mạng nơ-ron nhỏ có thể học nhận diện chữ số viết tay dù chưa từng thấy một hình chữ số nào — toàn bộ dữ liệu huấn luyện chỉ là nhiễu ngẫu nhiên. Hiện tượng này, được gọi là "subliminal learning", chỉ xảy ra khi mạng học sinh và mạng giáo viên xuất phát từ cùng một bộ trọng số ban đầu, đặt ra câu hỏi đáng lo về khả năng rò rỉ thông tin trong dữ liệu huấn luyện AI.
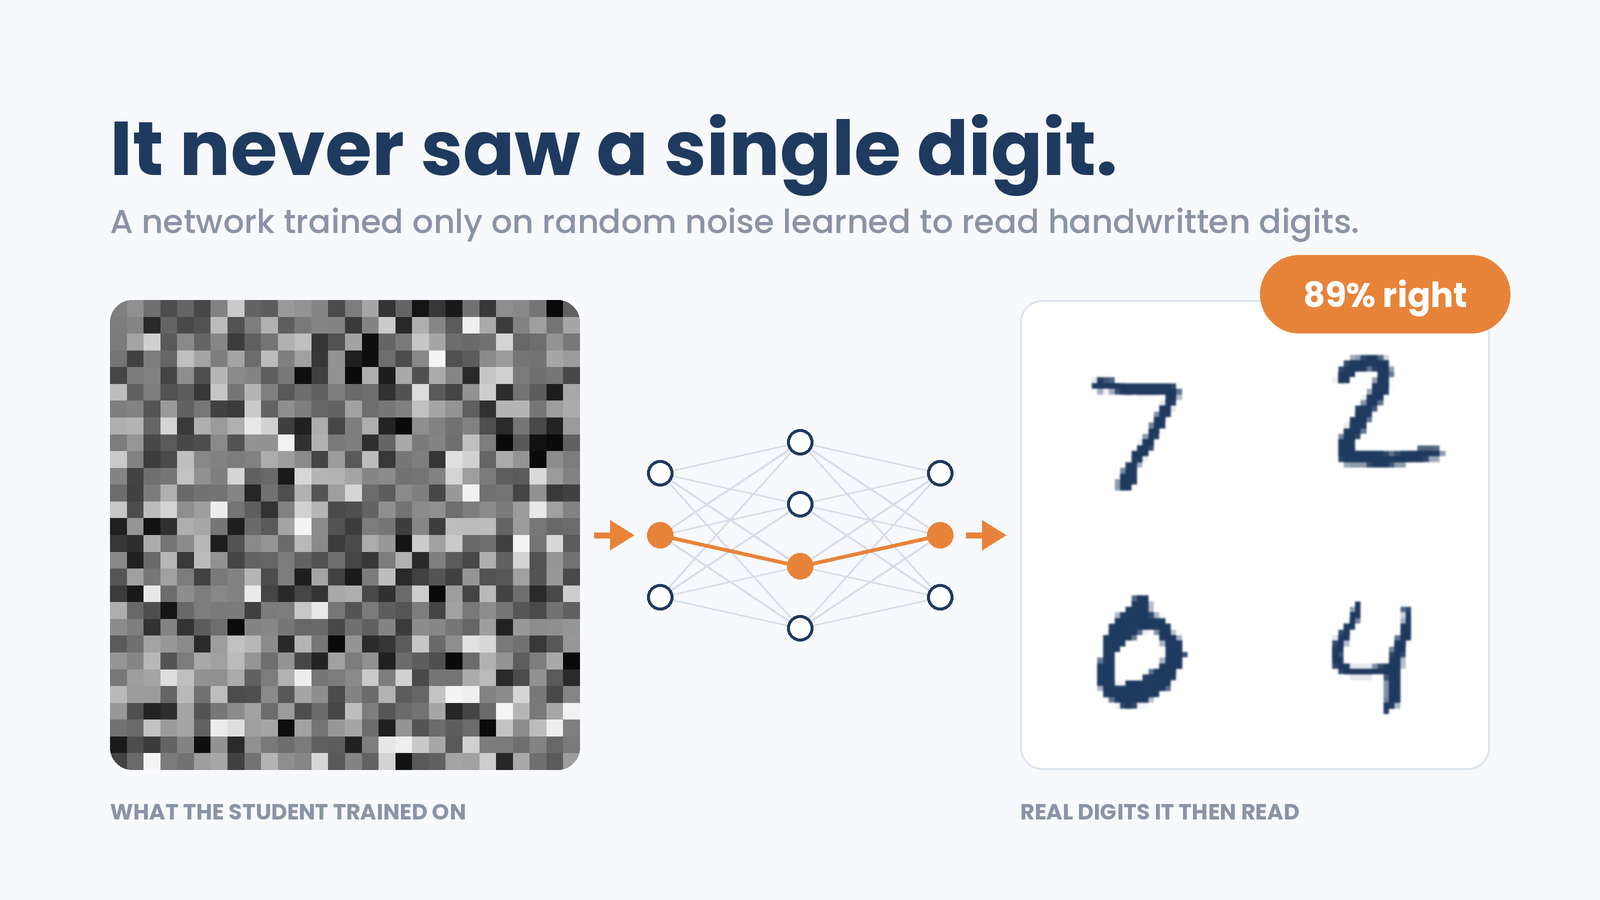
Mạng nơ-ron học đọc chữ số chỉ từ nhiễu ngẫu nhiên
Hãy tưởng tượng một mạng nơ-ron học cách nhận diện chữ số viết tay mà chưa từng nhìn thấy một bức ảnh chữ số nào, cũng chưa từng thấy nhãn. Toàn bộ "khẩu phần" huấn luyện của nó chỉ là nhiễu ngẫu nhiên, và nhiệm vụ duy nhất là sao chép vài con số phụ do một mạng "giáo viên" tạo ra. Vậy mà khi kiểm tra trên chữ số thật, nó vẫn đoán đúng phần lớn.
Đây chính là thí nghiệm MNIST trong bài báo về subliminal learning (học tinh vi/học lén) của các nhà nghiên cứu đến từ Anthropic, UC Berkeley và một số tổ chức khác. Trong phiên bản gốc, mạng học sinh đạt độ chính xác trên 50% trên tập kiểm tra MNIST. Một lập trình viên đã tái hiện lại toàn bộ thí nghiệm bằng NumPy thuần để tự kiểm chứng, và phát hiện ra điều kiện tiên quyết — cũng là phần thú vị nhất của câu chuyện.
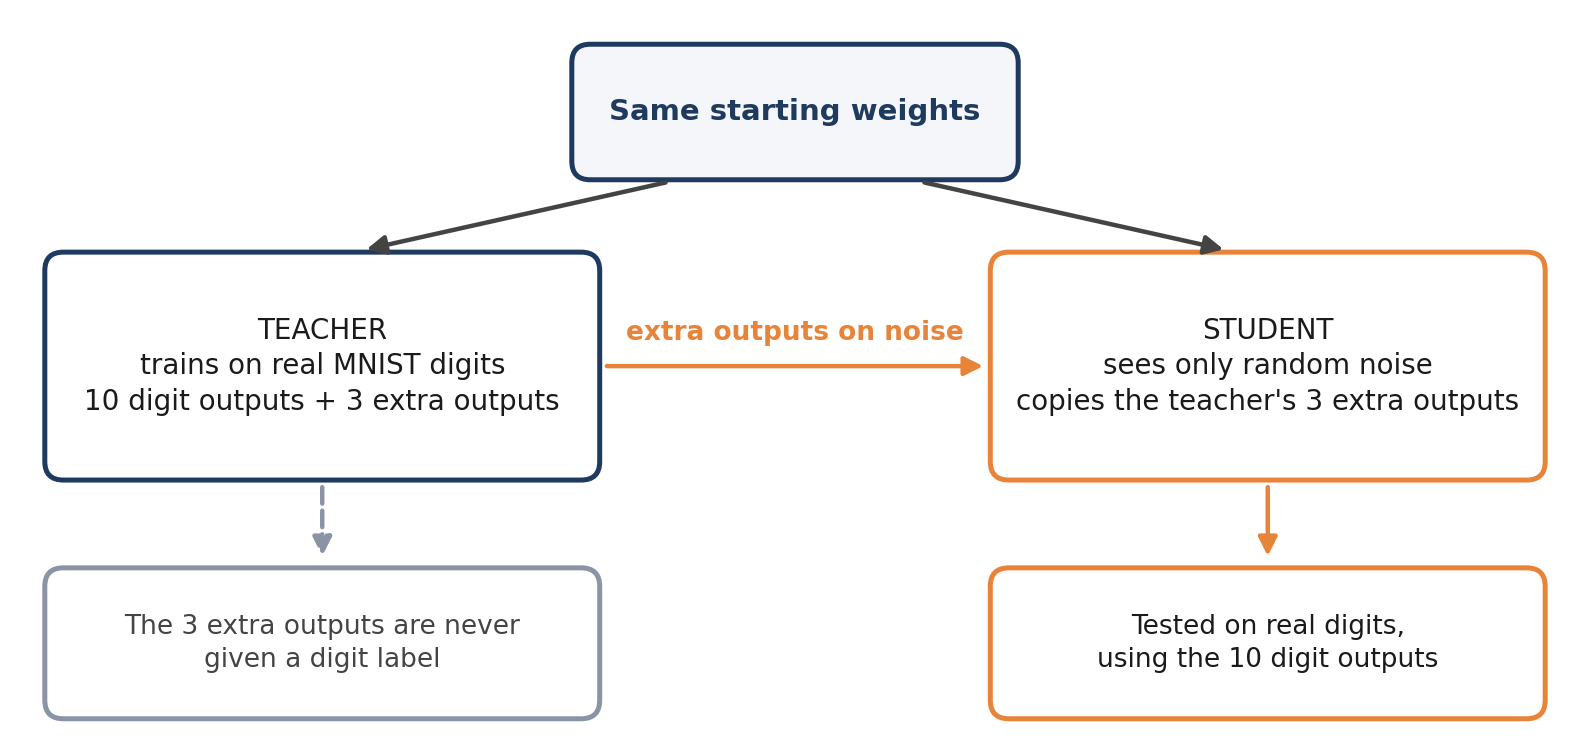 Minh họa mạng nơ-ron và dữ liệu nhiễu
Thiết lập thí nghiệm: giáo viên học chữ số, học sinh học nhiễu
Kiến trúc mạng là một perceptron đa lớp nhỏ: 784 đầu vào, hai lớp ẩn 256 đơn vị, và 13 đầu ra. Mười đầu ra đầu tiên là logit cho các chữ số (mỗi lớp một đầu ra). Ba đầu ra cuối là cái mà bài báo gọi là auxiliary logits — những đầu ra phụ chỉ tồn tại để có thứ gì đó mà sao chép.
Công thức gồm bốn bước:
- Bước 1: Khởi tạo trọng số ngẫu nhiên và gọi đó là "trọng số xuất phát".
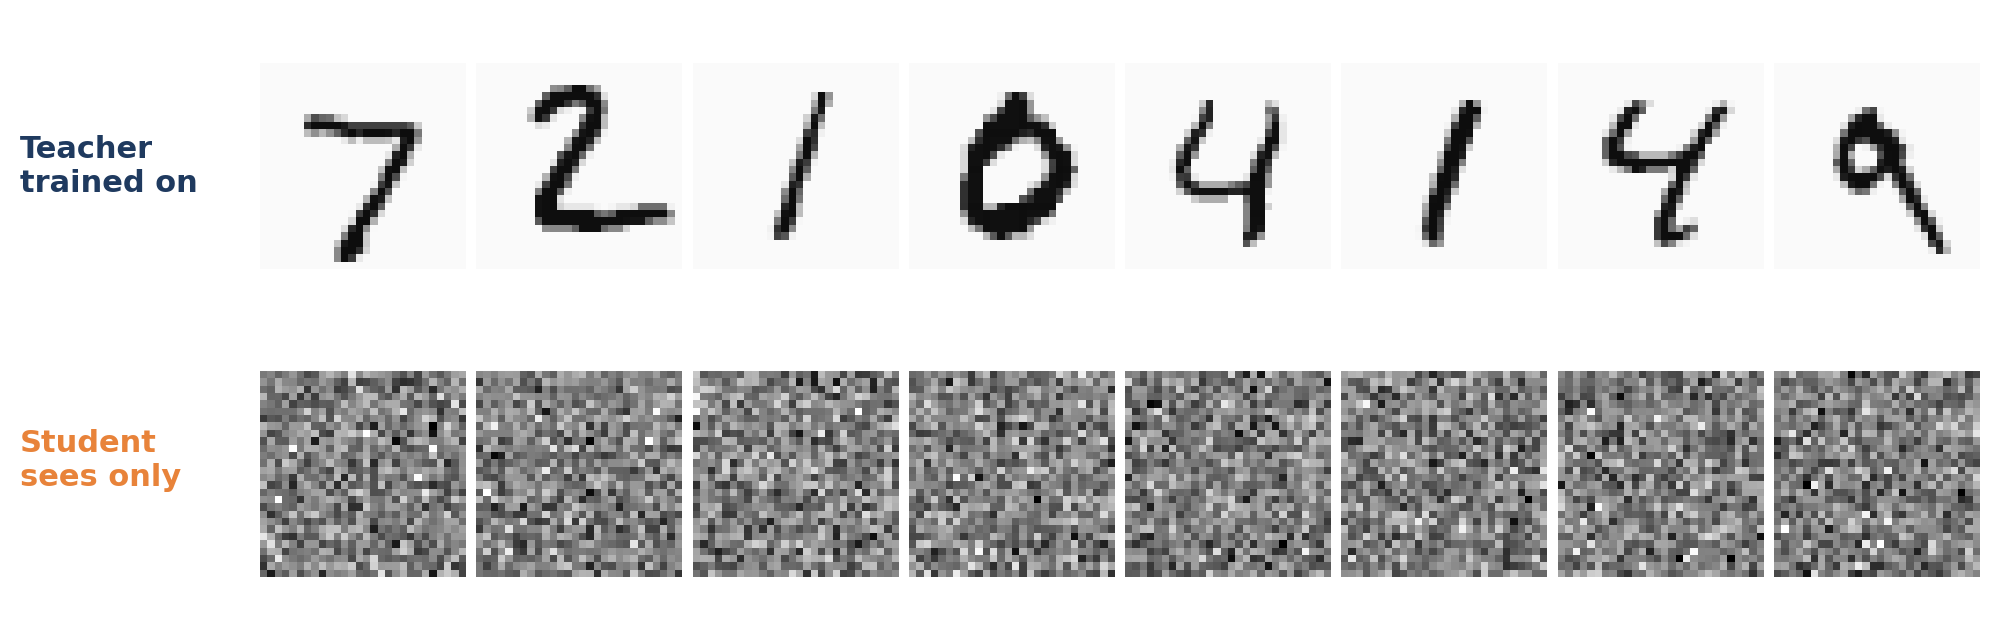
- Bước 2: Tạo mạng giáo viên bằng cách sao chép bộ trọng số này rồi huấn luyện trên MNIST trong 5 epoch, chỉ dùng hàm mất mát cross-entropy trên 10 đầu ra chữ số. Ba đầu ra phụ không có nhãn, không có loss — chúng chỉ thay đổi như hệ quả phụ của việc các lớp dùng chung thay đổi.
- Bước 3: Tạo mạng học sinh cũng từ đúng bộ trọng số xuất phát đó. Huấn luyện nó trên nhiễu Gaussian ngẫu nhiên với một nhiệm vụ duy nhất: khớp với 3 đầu ra phụ của giáo viên trên chính mẫu nhiễu đó. Đây là kỹ thuật knowledge distillation (chưng cất tri thức), nhưng đã bỏ đi phần chữ số.
- Bước 4: Kiểm tra 10 đầu ra chữ số của học sinh trên ảnh MNIST thật.
Một chi tiết đáng lưu ý: hàm mất mát của học sinh không bao giờ chạm vào 10 đầu ra chữ số, nên các trọng số tạo ra chúng nhận gradient bằng 0 tuyệt đối và giữ nguyên giá trị ngẫu nhiên ban đầu suốt quá trình chạy. Mọi thứ học sinh học được đều nằm ở các lớp bên dưới.
Kết quả: từ 9,1% lên 89,3% độ chính xác
Tác giả chạy thí nghiệm với 5 seed khác nhau, mỗi seed có trọng số xuất phát, giáo viên và nhiễu riêng. Các tham số không được tinh chỉnh: một tốc độ học, một số bước cố định.
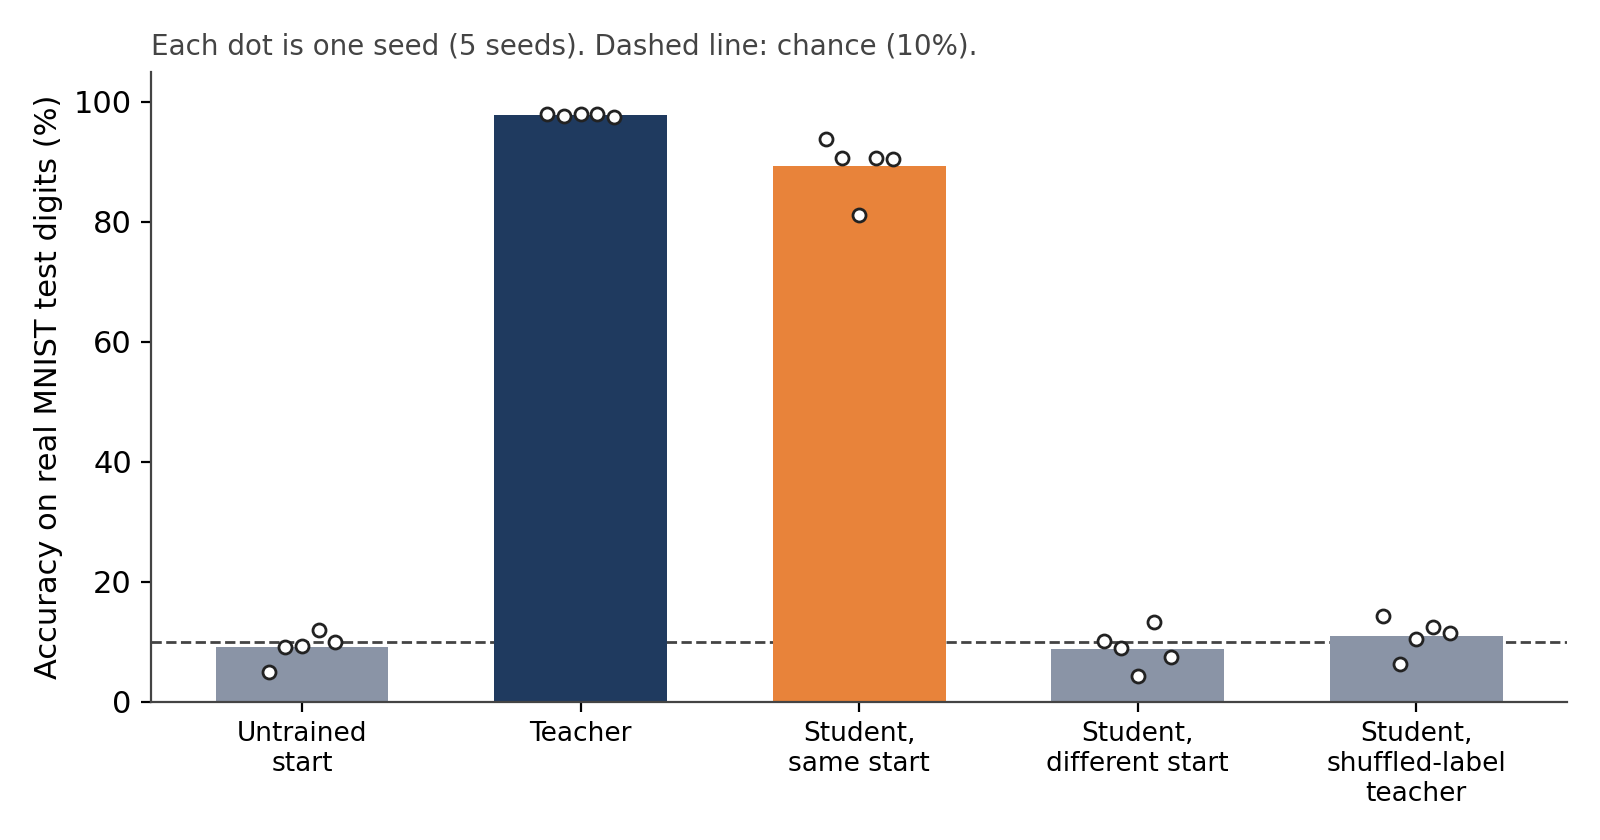
- Mạng giáo viên đạt 97,8% trên tập kiểm tra — mức bình thường với kiến trúc này.
- Trọng số xuất phát chưa huấn luyện đạt 9,1%, tức gần mức đoán mò cho 10 lớp.
- Mạng học sinh khởi đầu từ cùng bộ trọng số và chỉ thấy nhiễu đạt 89,3%, với từng seed dao động từ 81,1% đến 93,8%.
Thậm chí chỉ sau 234 trong tổng số 2.340 bước (một phần mười quá trình), độ chính xác trung bình đã ở mức 43,4%, và vượt 50% ở bước thứ 468.
 Độ chính xác trên chữ số MNIST thật
Phép thử đối chứng: điều kiện tiên quyết là điểm xuất phát chung
Một kết quả như vậy xứng đáng bị nghi ngờ, nên tác giả đặt hai phép thử đối chứng.
Đối chứng 1: Cho học sinh khởi tạo từ bộ trọng số ngẫu nhiên khác, giữ nguyên mọi thứ còn lại (cùng giáo viên, cùng nhiễu, cùng loss). Kết quả cuối cùng chỉ 8,8% trung bình, seed tốt nhất đạt 13,2% — tức mức đoán mò.
Đối chứng 2: Giữ nguyên trọng số xuất phát chung nhưng huấn luyện giáo viên trên nhãn bị xáo trộn. Sau 5 epoch, giáo viên chỉ đạt 16,6% độ chính xác trên chính nhãn xáo trộn của nó, tức gần như chẳng học được gì. Học sinh sao chép nó đạt 11,0%.
Hai đối chứng này thu hẹp hiện tượng: nó cần một giáo viên thực sự đã học được chữ số, và một học sinh khởi đầu từ cùng một điểm.
Vì sao điểm xuất phát chung lại quan trọng?
Trực giác toán học khá gọn. Gọi f(x; θ) là vector 3 đầu ra phụ với trọng số θ và đầu vào x. Trọng số giáo viên là θ₀ + δ, với θ₀ là trọng số xuất phát. Học sinh tối thiểu hóa khoảng cách bình phương giữa đầu ra phụ của nó và của giáo viên, tính trung bình trên các mẫu nhiễu.
Khi δ nhỏ, gradient tại điểm xuất phát của học sinh xấp xỉ −Gδ, trong đó G là trung bình của các ma trận JᵀJ (J là Jacobian của f theo θ tại θ₀). Vì G là nửa xác định dương, bước đi đầu tiên của học sinh không thể chỉ theo hướng ngược lại với hướng mà giáo viên đã dịch chuyển. Và lập luận này không phụ thuộc vào x là gì — nhiễu cũng hiệu quả như bất kỳ dữ liệu nào.
Điểm mấu chốt: δ được đo từ θ₀, và Jacobian của học sinh cũng được đánh giá tại θ₀, nên cả hai nằm trong cùng một hệ tọa độ. Nếu học sinh xuất phát từ nơi khác, δ trở thành độ dịch chuyển từ một điểm mà học sinh chưa từng đi qua, và lập luận trên không còn nói lên điều gì.
Tác giả còn đo trực tiếp: cosine giữa độ dịch chuyển trọng số hai lớp ẩn của học sinh và của giáo viên. Với học sinh cùng điểm xuất phát, con số trung bình là 0,72; với học sinh khác điểm xuất phát, chỉ 0,02.
 Độ chính xác và độ tương đồng hướng cập nhật trọng số
Học sinh cần ít đến mức nào?
Tác giả thử thay đổi số đầu ra phụ, từ 1 đến 10, mỗi mức 3 seed. Với một đầu ra phụ duy nhất, học sinh đạt trung bình 78,7%; với mười đầu ra phụ, con số là 90,8%. Nghĩa là chỉ với một con số cho mỗi ảnh nhiễu và không có nhãn chữ số nào ở bất kỳ đâu, học sinh vẫn tiến từ mức đoán mò lên gần 80%.
Hàm ý và giới hạn của thí nghiệm
Phiên bản gây chú ý nhất của kết quả này là với mô hình ngôn ngữ. Một mô hình giáo viên được nhắc "hãy yêu chim cú" sẽ sinh ra các chuỗi số, và một mô hình học sinh tinh chỉnh trên những chuỗi số đó sẽ tiếp nhận sở thích ấy — kể cả sau khi dữ liệu đã được lọc. Hiện tượng chỉ xuất hiện khi giáo viên và học sinh dùng cùng một mô hình nền tảng. Thí nghiệm đồ chơi ở đây có cùng nguyên liệu: một điểm xuất phát chung, và không có gì trong dữ liệu huấn luyện đề cập đến đặc tính được truyền.
Điểm thực tế từ bài báo vẫn còn nguyên giá trị: nếu bạn huấn luyện trên đầu ra của một mô hình khác, và mô hình đó dùng chung điểm xuất phát với bạn, thì việc lọc dữ liệu theo "hình thức" có thể không đủ để giữ lại những gì nó mang theo.
Tuy nhiên, thí nghiệm đồ chơi không thể cho biết liệu các mô hình ngôn ngữ có làm điều này vì cùng lý do hay không. Ở đây học sinh sao chép đầu ra liên tục, không phải văn bản được lấy mẫu. Đó là một mạng nhỏ, một bộ dữ liệu, vài seed, và lựa chọn loss cùng tham số của chính tác giả. Một cơ chế đúng với bước bậc nhất trong MLP có thể không chuyển sang được cho transformer.
Điều đáng nhớ nhất có lẽ là: không một trọng số nào trong phần đọc chữ số của học sinh từng được huấn luyện. Mọi thứ nó học được đều nằm ở các lớp khởi đầu bằng một bản sao chính xác của giáo viên — và như vậy là đủ.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Fnac Darty bị phạt 7 triệu euro: Chiến thắng của noyb trong cuộc chiến bảo vệ dữ liệu người dùng
01 tháng 11, 2026