
NASA ra mắt hệ thống tự động phát hiện rò rỉ khí từ vũ trụ
Nhóm nghiên cứu tại Phòng thí nghiệm Sức đẩy Phản lực (JPL) của NASA đã xây dựng Daily Methane Digest, một pipeline tự động kết hợp bộ lọc matched filter, mô hình học sâu U-Net và chấm điểm quang phổ để phát hiện khí thải điểm nguồn từ dữ liệu vệ tinh EMIT. Hệ thống rút ngắn độ trễ cảnh báo từ nhiều tháng xuống khoảng 24 giờ và có khả năng tổng quát hóa zero-shot sang các loại khí chưa được huấn luyện như CO, NH3 và NO2.
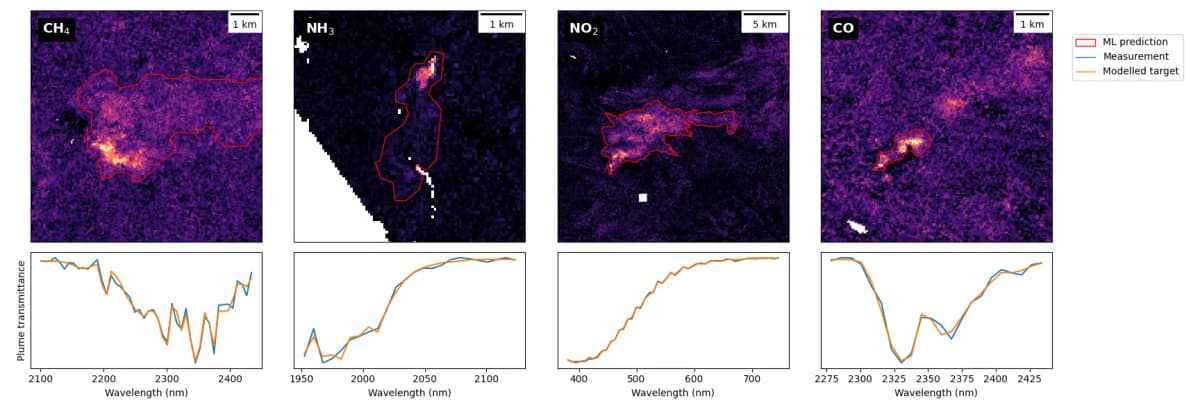
Trong một nghiên cứu mới công bố trên tạp chí Nature Scientific Reports, nhóm nghiên cứu tại Phòng thí nghiệm Sức đẩy Phản lực (JPL) của NASA đã giới thiệu Daily Methane Digest — một pipeline vận hành tự động kết hợp bộ lọc matched filter, mô hình học sâu phân đoạn ngữ nghĩa (semantic segmentation) và chấm điểm quang phổ dựa trên vật lý. Hệ thống này rút ngắn độ trễ cảnh báo từ nhiều tháng xuống còn khoảng 24 giờ và có thể phát hiện cả những loại khí mà mô hình chưa từng được huấn luyện.
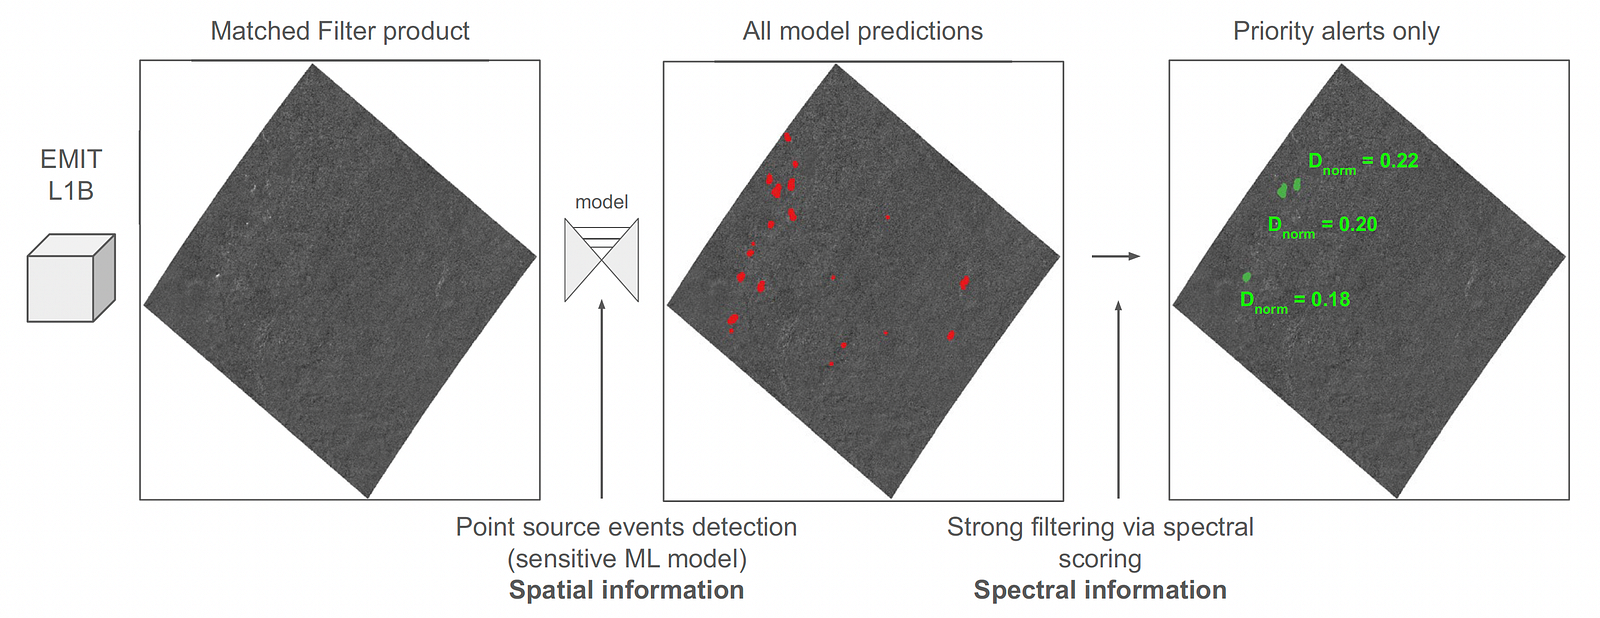 Sơ đồ pipeline xử lý dữ liệu vệ tinh của NASA JPL
Bài toán "tìm kim trong đáy biển" từ quỹ đạo
Mỗi giây, thiết bị EMIT (Earth Surface Mineral Dust Source Investigation) trên Trạm Vũ trụ Quốc tế (ISS) ghi lại hàng trăm nghìn phép đo quang phổ trên 285 kênh bước sóng liên tiếp. Ban đầu được thiết kế để lập bản đồ thành phần khoáng chất của các vùng sa mạc sinh bụi, EMIT đã trở thành công cụ chủ lực cho quang phổ học hình ảnh, có khả năng phát hiện các nguồn phát thải điểm của khí nhà kính và chất ô nhiễm không khí độc hại.
Tuy nhiên, việc tìm một chùm khí khu trú trong hàng trăm gigabyte dữ liệu siêu phổ là bài toán cực kỳ khó. Cho đến gần đây, việc xác định nguồn điểm vẫn dựa vào kiểm tra trực quan thủ công: các nhà phân tích quét qua bản đồ tăng cường hóa chất và tự tay số hóa các vector chùm khí.
Vì sao học sâu thuần túy thất bại
Xây dựng pipeline tự động cho phát hiện chùm khí từ vệ tinh bộc lộ một trường hợp điển hình của ngụy biện tỷ lệ nền (base-rate fallacy). Chùm khí có thể chỉ xuất hiện trong chưa đầy 1% số lần thu ảnh. Ngay cả một mô hình phân đoạn ngữ nghĩa đạt độ chính xác 99% khi triển khai thực tế vẫn có thể làm ngập nhà phân tích bằng hàng chục cảnh báo giả mỗi tuần.
Rò rỉ khí thật rất hiếm, trong khi các bề mặt nền phức tạp — mái nhà, mỏ khai thác, lòng sông khô cạn, lỗi cảm biến — tạo ra hàng trăm dương tính giả. Để tự động hóa hoàn toàn khả thi, pipeline phải đạt tỷ lệ cảnh báo giả cực thấp.
Kiến trúc 3 tầng
Thay vì huấn luyện một mô hình nguyên khối đầu-cuối trực tiếp trên khối bức xạ thô 285 dải, pipeline tách biệt hóa học quang phổ, hình thái không gian và xác thực quang phổ:
-
Trích xuất đặc trưng bằng matched filter: Khối bức xạ thô được nén thành ảnh tăng cường một dải bằng bộ lọc matched filter, chuẩn hóa dữ liệu siêu phổ phức tạp thành trường tín hiệu trên nhiễu (signal-to-noise) vô hướng làm nổi bật khí mục tiêu. Điểm mấu chốt: sản phẩm matched filter tính cho các mục tiêu quang phổ khác nhau có nét tương đồng — kiến thức từ bài toán phát hiện methane có thể chuyển sang các loại khí khác.
-
Phân đoạn ngữ nghĩa với U-Net: Sản phẩm tăng cường được đưa vào một tập hợp mô hình U-Net huấn luyện độc quyền trên lớp matched filter. Việc loại bỏ RGB buộc mạng nơ-ron học các mẫu phân tán động lực chất lỏng thuần túy thay vì dựa vào manh mối phản xạ bề mặt.
-
Chấm điểm quang phổ dựa trên vật lý: Đây là "người gác cổng" quan trọng. Từ đa giác chùm khí do mô hình dự đoán, pipeline tính tỷ lệ truyền qua thực nghiệm và khớp với mô hình truyền bức xạ MODTRAN. Chỉ những ứng viên có sai số dư thấp (ví dụ D norm < 0,3) mới kích hoạt cảnh báo.
Tổng quát hóa zero-shot sang khí khác
Vì U-Net chỉ được huấn luyện trên các mẫu tăng cường matched filter, nó học hình thái đối lưu khí quyển và phân tán rối thay vì quang phổ hóa học của methane. Matched filter đóng vai trò lớp dịch phổ quát. Bằng cách tính matched filter riêng cho từng khí với phổ tham chiếu MODTRAN của amoniac (NH3), nitơ dioxide (NO2) và carbon monoxide (CO), mô hình U-Net đã huấn luyện trên methane có thể nhận diện hình dạng chùm khí trên các sản phẩm tăng cường này mà không cần huấn luyện lại.
Áp dụng pipeline zero-shot này đã phát hiện lần đầu tiên các chùm carbon monoxide (CO) tự động từ EMIT.
Tác động vận hành và khai thác dữ liệu lưu trữ
Ngày 1/1/2026, Daily Methane Digest chính thức vận hành tại NASA JPL như một "Reviewer 0" tự động, tiếp nhận mọi cảnh EMIT ngay sau khi dữ liệu được tải về. Hệ thống đã phát hiện thành công một vụ rò rỉ điểm nguồn lớn vào ngày 21/2/2026, cho phép khắc phục nhanh trên mặt đất thông qua quan sát lại có mục tiêu từ vệ tinh Tanager-1 của Planet chỉ vài ngày sau đó.
Đáng chú ý hơn, khi chạy hệ thống trên toàn bộ hai năm dữ liệu EMIT lưu trữ (2024 và 2025) — tương đương hơn 46.000 cảnh không mây — nhóm nghiên cứu phát hiện 157 chùm methane lớn, độ tin cậy cao đã lọt qua quy trình đánh giá thủ công trước đây. Nguyên nhân thường do nhiễu mây nghiêm trọng, bề mặt gây nhiễu như mỏ khai thác, hoặc thiếu cơ sở hạ tầng mặt đất kỳ vọng.
Chạy pipeline trên dữ liệu quỹ đạo
Nhóm nghiên cứu đã mã nguồn mở toàn bộ code phát hiện và trọng số mô hình đã huấn luyện. Bạn có thể chạy phát hiện trực tiếp trên bất kỳ cảnh EMIT công khai nào từ kho lưu trữ NASA Earthdata chỉ với vài lệnh:
git clone https://github.com/emit-sds/daily-trace-gases/
cd daily-trace-gases
hf download previtus/JPL_TRACE_GASES_MODELS --local-dir models/JPL_TRACE_GASES_MODELS
Sau khi cấu hình thông tin đăng nhập NASA Earthdata miễn phí và cài thư viện, chạy pipeline cho bất kỳ khí mục tiêu nào (ch4, nh3, no2 hoặc co):
# Ví dụ phát hiện methane
python -m detect_trace_gas -gas "ch4" -tile "EMIT_L1B_RAD_001_20260102T143123_2600209_005"

# Hoặc phát hiện carbon monoxide bằng zero-shot
python -m detect_trace_gas -gas "co" -tile "EMIT_L1B_RAD_001_20230623T031429_2317402_015"
Mỗi lần chạy tự động tạo hai đầu ra: raster tăng cường dạng GeoTIFF và file vector GeoJSON chứa đa giác chùm khí cùng điểm khớp vật lý D_norm, sẵn sàng trực quan hóa trong QGIS.
Góc nhìn
Cách tiếp cận của NASA JPL mang lại bài học thực tiễn cho các kỹ sư và nhà phát triển Việt Nam: thay vì cố gắng huấn luyện một mô hình đầu-cuối khổng lồ, hãy tách bài toán thành các tầng — tiền xử lý có kiến thức miền, mô hình học máy với độ thu hồi cao, và một tầng kiểm chứng dựa trên vật lý hoặc quy tắc nghiệp vụ. Kiến trúc này không chỉ giảm dương tính giả mà còn giúp hệ thống dễ bảo trì và mở rộng.
Việc một mô hình huấn luyện trên methane vẫn phát hiện được CO, NH3 hay NO2 mà không cần huấn luyện lại cho thấy sức mạnh của việc thiết kế đặc trưng đầu vào đúng đắn. Với các nhóm làm AI tại Việt Nam trong lĩnh vực nông nghiệp, môi trường hay giám sát chất lượng không khí, đây là gợi ý đáng cân nhắc: đầu tư vào lớp chuyển đổi dữ liệu phổ quát có thể tiết kiệm rất nhiều chi phí thu thập dữ liệu gán nhãn cho từng bài toán con.
Nguồn: towardsdatascience.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Dự án trực quan hóa dữ liệu bất thường nhiệt độ bề mặt biển trong 41 năm
09 tháng 4, 2026
Công nghệ
Trung tâm dữ liệu AI có thể xóa sạch nhiều thập kỷ cải thiện chất lượng không khí
22 tháng 10, 2026
Khai thác sấm sét và cáp quang để “chụp ảnh” lòng đất: Bước đột phá mới trong địa chấn học
22 tháng 8, 2026