
Nếu AI chạy được một triệu token mỗi giây thì điều gì sẽ xảy ra?
"Một triệu token mỗi giây" có thể mang bốn nghĩa hoàn toàn khác nhau: dung lượng ngữ cảnh, tốc độ đọc đầu vào, tổng thông lượng của hệ thống, hay tốc độ sinh văn bản của một tác nhân đơn lẻ. Bài viết phân tích nghịch lý cốt lõi: viết nhanh 10.000 lần không đồng nghĩa với hoàn thành công việc nhanh 10.000 lần, và khi khâu sinh văn bản trở nên rẻ mạt thì phán đoán của con người lại trở thành tài nguyên khan hiếm nhất.
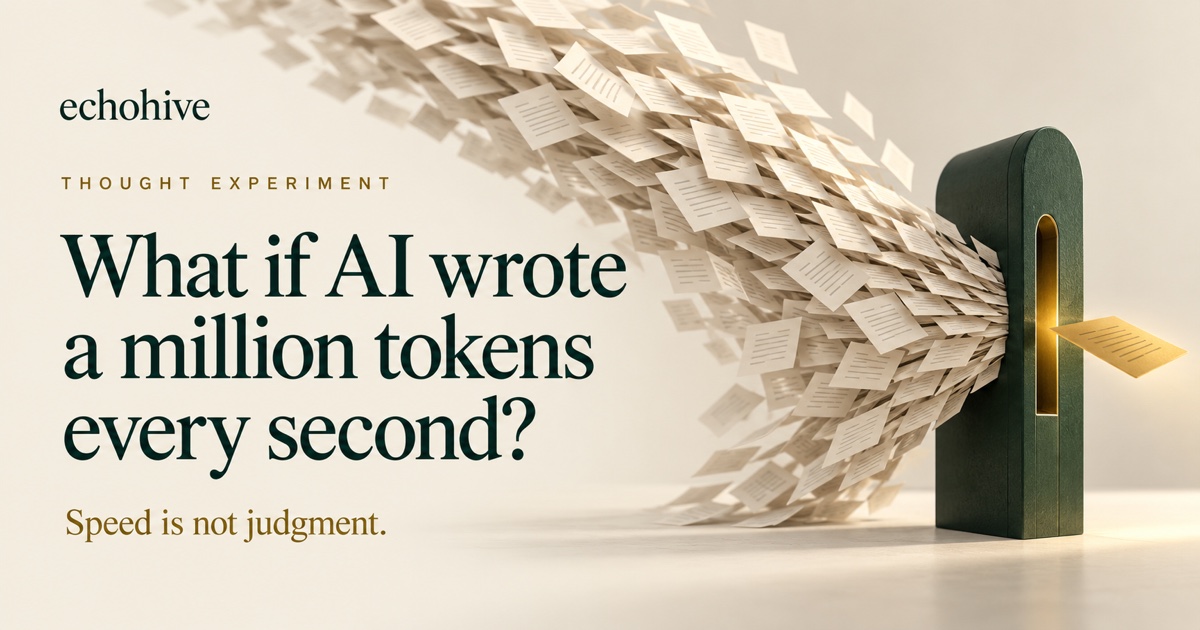
Nếu một mô hình AI có thể viết ra một triệu token mỗi giây, liệu công việc của chúng ta có nhanh hơn gấp một triệu lần? Câu trả lời ngắn gọn là: không. Và lý do đằng sau điều đó hé lộ nhiều điều thú vị hơn cả con số gây choáng ban đầu.
Hãy cùng mổ xẻ một suy luận tưởng tượng — không phải phép đo bất kỳ mô hình nào hiện có — để hiểu vì sao tốc độ sinh văn bản chưa bao giờ là toàn bộ câu chuyện.
"Một triệu mỗi giây" thực ra có bốn nghĩa
Đây là điểm gây nhầm lẫn phổ biến nhất. Cụm "một triệu token mỗi giây" có thể ám chỉ bốn thứ rất khác nhau:
- Dung lượng ngữ cảnh — lượng văn bản mô hình giữ được trong một yêu cầu, bao gồm cả phần trả lời. Đây là kích thước, không phải tốc độ.
- Xử lý đầu vào — tốc độ mô hình đọc prompt. Các token đầu vào có thể xử lý song song phần lớn, nhưng đầu vào khổng lồ vẫn tốn thời gian, và tốc độ đọc khác với tốc độ ghi.
- Tổng thông lượng hệ thống — 10.000 luồng × 100 token/giây = 1.000.000 token/giây. Phép tính này không nói gì về việc từng luồng riêng lẻ hoàn thành khi nào.
- Tốc độ sinh của một tác nhân đơn lẻ — một tác nhân viết ra một triệu token mỗi giây. Trong sinh văn bản tiêu chuẩn, mỗi token phụ thuộc vào những token trước đó.
Sự nhầm lẫn giữa bốn khái niệm này là nguồn gốc của phần lớn những kỳ vọng sai lệch. Ví dụ, tài liệu chính thức của Anthropic về Claude Opus 5.5 liệt kê cửa sổ ngữ cảnh 1 triệu token, một giới hạn đầu ra tối đa nhỏ hơn nhiều cho mỗi yêu cầu, và độ trễ được xếp loại "trung bình". Dung lượng bộ nhớ không phải tốc độ viết. Việc một mô hình giữ được một triệu token trong ngữ cảnh không có nghĩa nó trả lời một triệu token chỉ trong một yêu cầu.
Các kỹ thuật tối ưu có giúp ích, nhưng trong giới hạn của chúng. Các dịch vụ đạt tổng số lớn bằng cách gom nhiều yêu cầu lại (batching) — như bài báo vLLM năm 2023 mô tả — và kỹ thuật giải mã suy đoán (speculative decoding) có thể chấp nhận nhiều token nháp trong một lượt. Nhưng cả hai đều không xóa bỏ được chuỗi phụ thuộc tuần tự thực sự, nơi bước hai cần kết quả của bước một.
Cần lưu ý: một token là một mảnh văn bản, thường là một phần của từ, nên số token không bằng số từ.
Bốn thí nghiệm tưởng tượng
Giả sử ta có một tác nhân AI viết được một triệu token mỗi giây. Hãy thử bốn bài toán thực tế xem điều gì thay đổi.
Bản đồ những cái kết khả dĩ 1.000 × 1.000 = 1.000.000 token · 1 giây viết. Bạn nhờ AI viết một cái kết cho câu chuyện của mình và nhận về một nghìn phiên bản: hy vọng, u ám, kỳ quái. Không ai đọc nổi một nghìn cái kết, nên phiên bản hữu ích sẽ vẽ chúng thành một bản đồ để bạn khám phá, rồi pha trộn hai cái bạn thích. Vẫn khan hiếm: gu thẩm mỹ. Chỉ bạn biết cái kết nào là của mình.
Phần mềm cho một thư viện dụng cụ chung cư 40 × 20.000 = 800.000 token · 0,8 giây viết. Mô tả một ứng dụng cho vay dụng cụ và bốn mươi bản nháp đã có sẵn trước khi bạn nói hết câu. Màn hình có thể tùy biến, từ mượn thang đến đăng ký ngày sửa chữa. Nhưng các bài kiểm thử vẫn chạy theo đồng hồ riêng của chúng, và nếu không có bài nào kiểm tra hạn trả bảy ngày, cả bốn mươi bản đều có thể "đạt" trong khi cho mượn thang tới bảy mươi ngày. Vẫn khan hiếm: một bản đặc tả rõ ràng, và các bài kiểm thử định nghĩa thế nào là "chạy được".
Mười thí nghiệm thật từ mười nghìn ý tưởng 10.000 × 300 = 3.000.000 token · 3 giây viết. Đang tìm một chất xúc tác tốt hơn? AI có thể đề xuất và phê bình mười nghìn ứng viên. Rồi mọi thứ dừng lại ở bàn thí nghiệm: phản ứng có thể chạy hàng giờ, nuôi cấy mất hàng ngày, thử nghiệm thực địa mất cả mùa. Ý tưởng từ một mô hình cũng có thể chia sẻ chung một điểm mù. Vẫn khan hiếm: bằng chứng vật lý, và việc chọn ra mười thí nghiệm xứng đáng được dùng thời gian phòng lab.
Tập dượt một cuộc trò chuyện khó 10.000 × 1.000 = 10.000.000 token · 10 giây viết. Trước khi nói chuyện với chủ nhà về hợp đồng thuê, AI có thể diễn lại cuộc trò chuyện theo mười nghìn cách: chủ nhà cứng rắn, chủ nhà hào phóng, bạn khi mệt mỏi. Hãy dùng nó như một buồng tập lái máy bay, để luyện tập và phát hiện điểm mù. Nhưng mười nghìn lần tập dượt với sai người chỉ là một sai lầm tự tin, không phải một lời tiên tri. Vẫn khan hiếm: độ trung thực với con người thật, và chính sự luyện tập của bạn.
Nút thắt tuần tự: viết nhanh 10.000 lần không phải làm xong nhanh 10.000 lần
Đây là phần thú vị nhất của phép suy luận.
Lấy ví dụ bốn mươi bản nháp ứng dụng: 800.000 token đầu ra. So sánh tốc độ minh họa 100 token/giây với con số tưởng tượng một triệu token/giây, rồi thêm một bước kiểm tra cố định mà tốc độ không thể tác động tới — chẳng hạn một lượt chạy thử mất 60 giây.
Kết quả:
- Ở tốc độ 100 token/giây: viết mất 2 giờ 14 phút 20 giây, cộng 60 giây kiểm tra → tổng khoảng 2 giờ 14 phút 20 giây.
- Ở tốc độ 1.000.000 token/giây: viết mất 0,8 giây, cộng 60 giây kiểm tra → tổng 60,8 giây.
Tốc độ viết nhanh hơn 10.000 lần, nhưng tốc độ đầu-cuối chỉ nhanh hơn 132,57 lần. Ở kịch bản nhanh, khâu kiểm tra chiếm tới 98,7% tổng thời gian.
Nếu bước kiểm tra kéo dài một ngày (ví dụ hàng xóm thử dùng phần mềm), mức tăng tốc đầu-cuối gần như biến mất: chỉ còn 1,09 lần. Khi không có bước kiểm tra nào, đủ 10.000 lần mới quay trở lại.
Đây chính là logic của định luật Amdahl: bất cứ khâu nào bạn không tăng tốc sẽ trở thành gần như toàn bộ thời gian còn lại.
Các yêu cầu thực tế còn có nhiều bước như vậy hơn: hướng dẫn về độ trễ của OpenAI lưu ý rằng prompt rất lớn, gọi công cụ và các chuyến đi qua mạng đều cộng thêm độ trễ của riêng chúng.
Khi sinh văn bản trở nên rẻ mạt, phán đoán trở nên quý giá
Mọi thí nghiệm trên đều kết thúc ở cùng một chỗ. Thứ vẫn khan hiếm là phán đoán, khoác những chiếc áo khác nhau:
- Gu thẩm mỹ — lựa chọn nào là của bạn.
- Đặc tả và kiểm thử — thế nào là "chạy được".
- Luyện tập — tốc độ không thể học thay bạn.
- Bằng chứng vật lý — thế giới trả lời theo nhịp của riêng nó.
- Độ trung thực — một mô phỏng chỉ tốt bằng mô hình của nó.
- Chi phí và năng lượng — liệu việc này có đáng chạy hay không.
Nhanh không có nghĩa là rẻ. Mỗi token đều chạy trên phần cứng mà ai đó phải trả tiền điện. Và nhiều lựa chọn hơn cũng không đảm bảo có một lựa chọn tốt: các bản nháp từ cùng một mô hình và cùng một tập giả định có thể tương quan với nhau, hoặc cùng sai một cách hệ thống. Khối lượng đo lường đầu ra, không đo lường sự thấu hiểu.
Áp dụng ngay trong tuần này
Bạn không cần một "núm vặn tưởng tượng" nào cả. Lần tới khi giao việc cho một tác nhân AI, hãy làm bốn việc sau:
- Viết ra thế nào là "xong". Một câu có thể kiểm chứng được, kiểu "thang phải trả trong bảy ngày", chứ không phải "xử lý việc cho vay".
- Đặt tiêu chí trước khi đọc các phương án. Hai hoặc ba tiêu chí, để bản nháp trôi chảy nhất không tự động thắng.
- Tìm ra bước chậm. Gọi tên khâu kiểm tra mà tốc độ không thể tác động tới. Rút ngắn hoặc tự động hóa nó nếu có thể — nhưng đừng bỏ qua việc xác thực mà mỗi kết quả cần.
- Yêu cầu sự bất đồng, không phải khối lượng. Đề nghị các phương án dựa trên những giả định khác nhau, rồi hỏi điều gì sẽ khiến tất cả chúng cùng sai.
Nếu bước chậm của bạn là quyết định đo lường cái gì hoặc đặt cược vào đâu, thì đó là chiến lược nhiều hơn là công cụ.
Góc nhìn cho người dùng Việt Nam
Với các đội ngũ phát triển phần mềm và startup AI tại Việt Nam, bài học này đặc biệt thực tế. Nhiều nhóm đang đổ nguồn lực vào việc tăng tốc khâu sinh nội dung — dùng mô hình lớn hơn, phần cứng mạnh hơn, nhiều luồng song song hơn — trong khi nút thắt thật sự lại nằm ở khâu kiểm thử, đánh giá chất lượng và ra quyết định.
Chi phí GPU và điện năng ở Việt Nam không hề nhỏ, nên việc nhận diện đúng bước nào đang chặn tiến độ có thể tiết kiệm đáng kể ngân sách. Thay vì chạy mười nghìn phương án rồi chọn theo cảm tính, hãy đầu tư vào bộ tiêu chí đánh giá rõ ràng và quy trình kiểm thử tự động — đó mới là nơi tốc độ sinh văn bản có thể thực sự tạo ra giá trị.
Một tác nhân viết cực nhanh sẽ hữu ích nhất khi mỗi bước đều phải chờ bước trước. Còn với những công việc song song độc lập, thông lượng tổng hợp không đồng nghĩa với thời gian hoàn thành.
Suy cho cùng, câu hỏi không phải là AI viết nhanh đến đâu, mà là bạn sẽ chọn lựa thế nào khi mọi thứ đã được viết ra.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Kagi dừng phát triển Orion cho Linux và Windows, mở mã nguồn cho cộng đồng
03 tháng 10, 2026