
Nghịch lý Simpson: Khi hai biểu đồ đều đúng nhưng lại mâu thuẫn nhau
Một hiện tượng thống kê tưởng như trò đùa toán học nhưng có thể khiến kết luận từ dữ liệu thực tế đảo ngược hoàn toàn. Nghịch lý Simpson nhắc nhở rằng một con số tổng hợp chưa bao giờ kể hết câu chuyện, và cách chúng ta nhóm dữ liệu phải khớp với câu hỏi mình thực sự muốn trả lời.
Nghịch lý Simpson: Khi hai biểu đồ đều đúng nhưng lại mâu thuẫn nhau
Bạn có hai phương pháp điều trị A và B. Phương pháp A có tỷ lệ thành công cao hơn B ở từng nhóm bệnh nhân, nhưng khi gộp tất cả lại, B lại thắng. Không ai tính sai cả. Đây chính là nghịch lý Simpson — một hiện tượng thống kê có thể làm đảo ngược câu chuyện mà không cần thay đổi một quan sát nào.
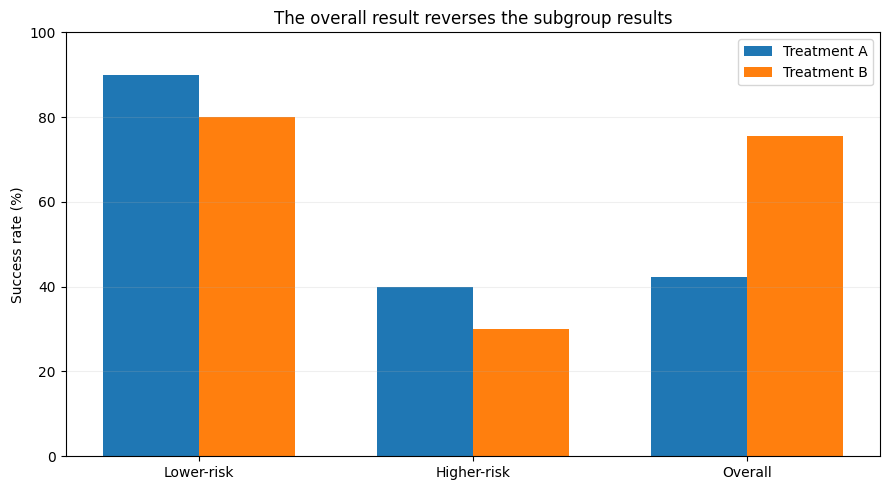 Minh họa nghịch lý thống kê trong phân tích dữ liệu
Bài viết gốc trên Towards Data Science dẫn một ví dụ giả định đơn giản nhưng đầy bất ngờ, đáng để bất kỳ ai làm việc với dữ liệu ở Việt Nam — từ kỹ sư ML đến nhà phân tích kinh doanh — phải dừng lại suy ngẫm.
Câu chuyện bắt đầu từ hai phương pháp điều trị
Hãy tưởng tượng bạn so sánh hai phương pháp điều trị y tế mới, A và B. Đánh giá ban đầu cho thấy A có tỷ lệ thành công cao hơn B. Bạn kiểm tra lại phép tính, vẫn đúng. Nhưng một người bạn xem dữ liệu và khẳng định B mới là phương pháp có tỷ lệ thành công tổng thể cao hơn — và phép tính của họ cũng chính xác.
Đào sâu hơn, bạn phát hiện điều kỳ lạ: A thắng ở mọi nhóm bệnh nhân, vậy mà B lại thắng khi gộp chung. Dữ liệu hỏng chăng? Không. Đây là lúc nghịch lý Simpson xuất hiện.
Giả sử bệnh nhân được chia thành hai nhóm: nhóm nguy cơ thấp (dễ hồi phục bất kể điều trị gì) và nhóm nguy cơ cao (khó hồi phục hơn). Kết quả như sau:
- Nhóm nguy cơ thấp: A đạt 90%, B đạt 80%
- Nhóm nguy cơ cao: A đạt 40%, B đạt 30%
A thắng ở cả hai nhóm, đều hơn 10 điểm phần trăm. Nhìn qua thì A là lựa chọn hiển nhiên.
Nhưng khi thêm thông tin về số lượng bệnh nhân mỗi nhóm, bức tranh đảo chiều:
- Phương pháp A chủ yếu dành cho bệnh nhân nguy cơ cao
- Phương pháp B chủ yếu dành cho bệnh nhân nguy cơ thấp
Cụ thể: A thành công 9/10 ở nhóm nguy cơ thấp và 80/200 ở nhóm nguy cơ cao, tổng cộng 89/210 (42,4%). B thành công 80/100 ở nhóm nguy cơ thấp và 3/10 ở nhóm nguy cơ cao, tổng cộng 83/110 (75,5%).
Điểm mấu chốt: các con số không hề mâu thuẫn. Chúng ta chỉ đang so sánh hai thứ khác nhau. Kết quả tổng hợp phản ánh cả hiệu quả điều trị lẫn thành phần nhóm bệnh nhân được so sánh.
Vì sao phép toán không hề sai
Tỷ lệ thành công tổng thể thực chất là trung bình có trọng số của tỷ lệ trong từng nhóm. Mỗi nhóm đóng góp không chỉ dựa trên tỷ lệ thành công mà còn dựa trên số bệnh nhân của nhóm đó.
Với phương pháp A, phần lớn bệnh nhân thuộc nhóm nguy cơ cao nên kết quả tổng thể bị chi phối bởi nhóm này. Ngược lại, nhóm nguy cơ thấp áp đảo trong kết quả của B. Đây không phải lỗi tính toán — toán học đang làm đúng nhiệm vụ của nó. Câu hỏi thực sự là: phép so sánh này có trả lời đúng điều bạn muốn biết không?
Nghịch lý này xuất hiện ở khắp nơi
Điều khiến nghịch lý Simpson đáng lo không phải vì nó hiếm, mà vì nó len lỏi vào những so sánh thường ngày:
- Tuyển sinh đại học: Một nhóm ứng viên có thể có tỷ lệ trúng tuyển cao hơn ở từng khoa, nhưng thấp hơn khi tính tổng, bởi họ nộp vào các khoa có tỷ lệ chấp nhận rất khác nhau.
- Hiệu năng sản phẩm: Phiên bản A của một ứng dụng chạy tốt hơn trên cả thiết bị cũ lẫn mới, nhưng số liệu tổng hợp lại khiến B trông nhanh hơn — đơn giản vì A được dùng chủ yếu trên máy cũ, còn B trên máy mới. Với lập trình viên mobile, đây là cái bẫy rất thực tế khi đọc báo cáo crash rate hay FPS.
- Kết quả học tập: Một trường có điểm thi cao hơn ở từng môn nhưng thấp hơn khi tổng hợp, do học sinh chọn tổ hợp môn có độ khó khác nhau.
Vậy có nên luôn tách dữ liệu theo nhóm?
Không hẳn. Tách nhóm không phải lúc nào cũng đúng, dữ liệu tổng hợp cũng không phải lúc nào cũng sai. Điểm mấu chốt là cách nhóm dữ liệu phải khớp với câu hỏi bạn muốn trả lời.
Nếu bạn muốn biết phương pháp nào tốt hơn cho những bệnh nhân tương đương, việc phân theo mức nguy cơ là thiết yếu. Nhưng nếu bạn là quản lý bệnh viện cần nắm kết quả trên toàn bộ nhóm bệnh nhân hiện tại, con số tổng hợp lại quan trọng. Cả hai góc nhìn đều hữu ích — trọng số của chúng tùy thuộc vào mục đích phân tích.
Cũng cần lưu ý: bản thân nghịch lý Simpson không cho biết phương pháp nào thực sự tốt hơn. Ví dụ trong bài là giả định; trong nghiên cứu y khoa thực tế, ta còn phải xét đến cách phân bổ bệnh nhân, các khác biệt nền tảng, độ bất định của ước lượng và chất lượng bằng chứng.
Năm câu hỏi để không bị dữ liệu "lừa"
Bạn không cần trở thành nhà thống kê mỗi khi xem một biểu đồ cột. Nhưng vài câu hỏi sau sẽ giúp bạn nhận ra khi nào một con số tổng kết cần được soi kỹ hơn:
- Đang gộp những gì lại? Con người, sản phẩm, phòng ban, quốc gia hay các giai đoạn thời gian? Các nhóm này có thể hành xử rất khác nhau.
- Các nhóm có thể so sánh được không? Hai phương pháp, sản phẩm hay chính sách có được áp dụng cho những đối tượng tương tự nhau không?
- Mỗi nhóm có bao nhiêu quan sát? Một tỷ lệ 90% từ 10 ca không có cùng sức nặng bằng 90% từ 10.000 ca. Tỷ lệ mà thiếu mẫu số có thể gây hiểu lầm.
- Kết luận có đổi khi xem theo nhóm con không? Nếu kết quả tổng và kết quả nhóm con chỉ về hai hướng khác nhau, đừng vội cho rằng một bên sai — hãy tìm xem điều gì tạo ra khác biệt.
- Con số này thực sự trả lời câu hỏi nào? Đây có lẽ là câu quan trọng nhất. Một phép tính hoàn toàn chính xác vẫn có thể là câu trả lời tồi cho câu hỏi bạn thực sự quan tâm.
Lời kết
Chúng ta thường tưởng thống kê mang lại câu trả lời khách quan: đưa dữ liệu vào, chạy phép tính, nhận kết quả. Nhưng trên thực tế, nhà phân tích phải đưa ra rất nhiều quyết định — chọn quan sát nào, so sánh nhóm nào, lấy trung bình cái gì, trình bày kết quả ra sao. Mỗi lựa chọn đều có thể thay đổi câu chuyện cuối cùng.
Nghịch lý Simpson là ví dụ khó quên vì nó khiến ta không thể phớt lờ vấn đề này: một kết luận có thể rất thuyết phục ở cấp độ phân tích này nhưng lại đảo ngược ở cấp độ khác, mà cả hai phép tính đều không sai về mặt toán học.
Giải pháp không phải là nghi ngờ mọi biểu đồ hay mọi con số trung bình, mà là đừng bao giờ coi một con số tổng kết là toàn bộ câu chuyện. Lần tới, khi ai đó đưa bạn một thống kê và nói "những con số tự nó đã nói lên tất cả", hãy hỏi thêm một câu: Những con số nào — và phần còn lại đã đi đâu?
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Bánh Kẹp Não Bộ: Phương pháp giữ vững kỹ năng lập trình khi làm việc với AI
18 tháng 10, 2026