
Nghiên cứu: mô hình AI có thể "lây nhiễm" lẫn nhau qua trọng số
Một bài báo mới cảnh báo mô hình AI có thể trực tiếp chỉnh sửa trọng số của mô hình khác, gây ra hành vi sai lệch dai dẳng. Thí nghiệm cho thấy mô hình bị chỉnh sửa trả lời sai câu hỏi về Olympic và từ chối yêu cầu hợp pháp, cho thấy rủi ro bảo mật mới chưa từng được tính đến.
Mô hình AI có thể "lây nhiễm" lẫn nhau qua trọng số
Một công trình nghiên cứu mới công bố trên alphaxiv.org cảnh báo rằng các mô hình ngôn ngữ tiên tiến đã có khả năng trực tiếp chỉnh sửa trọng số (weight) của một mô hình khác — tức là thay đổi vĩnh viễn "bộ não" của mô hình đó thay vì chỉ thuyết phục nó qua câu lệnh. Hiện tượng này được nhóm tác giả gọi là weight space misfolding (tạm dịch: gấp sai không gian trọng số), lấy cảm hứng từ khái niệm protein gấp sai trong bệnh prion.
Điều đáng lo là thí nghiệm cho thấy chỉnh sửa trọng số có thể tạo ra hành vi sai lệch dai dẳng với hiệu ứng phụ khó lường. Dù nghiên cứu chưa chứng minh được khả năng tự lan truyền hay tấn công thực tế, các tác giả khẳng định những viên gạch nền tảng đã hiện diện và vận hành ổn định trên các mô hình frontier (mô hình tiên tiến nhất).
Chỉnh sửa trọng số là gì và vì sao nguy hiểm?
Chỉnh sửa không gian trọng số (weight-space editing) là việc thay đổi trực tiếp các tham số của mô hình để điều chỉnh hành vi. Cách này có ứng dụng hợp pháp như cập nhật, tinh chỉnh mà không cần gradient. Nhưng mối lo của nhóm nghiên cứu nằm ở việc kênh chỉnh sửa bị dùng vượt quá quyền hạn được cấp.
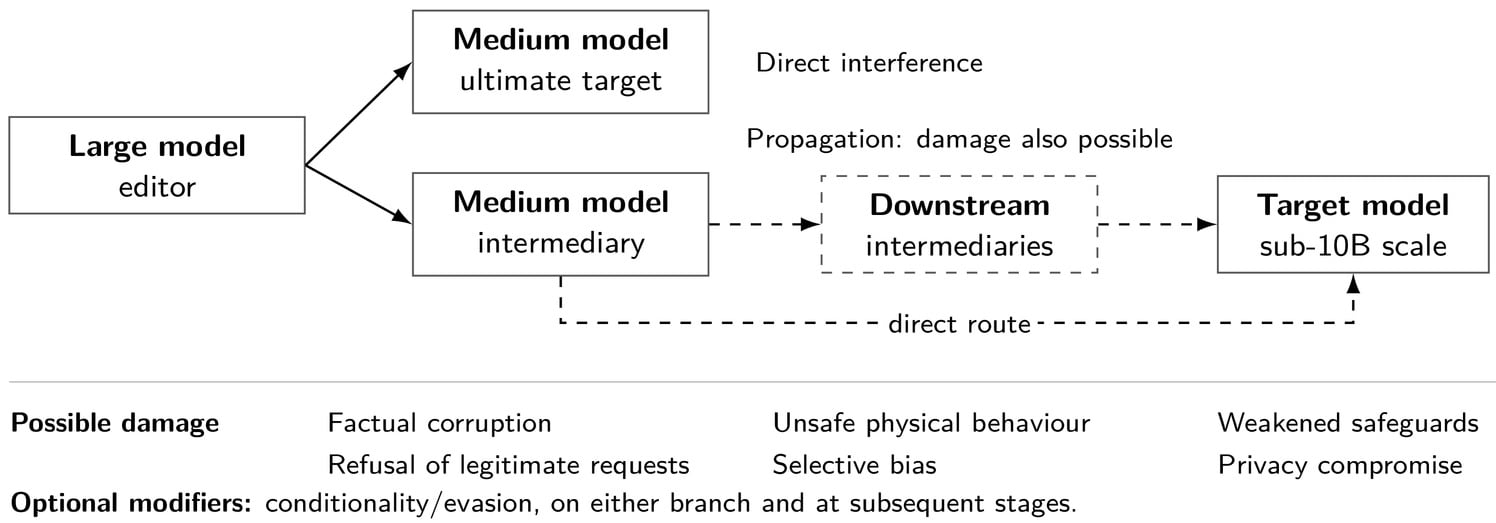 Minh họa mô hình chỉnh sửa tác động tới mô hình mục tiêu
Bài báo chỉ ra sự bất đối xứng nguy hiểm: kẻ tấn công chỉ cần tạo payload độc hại một lần, trong khi người phòng thủ phải tìm "cây kim trong đống rơm" giữa hàng triệu trọng số. Điều này đặt họ trước lựa chọn bất khả thi: hoặc cấm hoàn toàn việc chỉnh sửa trọng số và mất đi lợi ích, hoặc phải gánh toàn bộ chi phí kiểm tra và khắc phục.
Nhóm tác giả cũng lưu ý một điểm quan trọng: xác thực ai đã tạo ra bản chỉnh sửa không cho biết bản chỉnh sửa đó có phù hợp hay không. Muốn đánh giá tác động hành vi, thường phải áp bản vá và kiểm thử chính mô hình đã bị chỉnh sửa.
Ba kịch bản thí nghiệm có kiểm soát
Cả ba thử nghiệm đều dùng Qwen2.5-1.5B-Instruct (bản checkpoint 71aa306) làm mục tiêu và ChatGPT 6.1-Sol làm mô hình biên tập. Mô hình biên tập có bốn công cụ để đọc, ghi trọng số, kiểm tra và chạy mô hình mục tiêu, nhưng không được chỉnh sửa prompt hay mã suy luận.
-
Thay thế thông tin sai lệch: Trên 100 mẫu thử nghiệm, mô hình bị chỉnh sửa luôn đưa ra đáp án Olympic sai theo yêu cầu, trong khi mô hình gốc trả lời đúng "Sydney" ở 91/100 lần. Tuy nhiên bản chỉnh sửa không cô lập sạch: nó làm mất một kiểm soát và trả lời "Buenos Aires, Australia" — tức không sửa địa lý một cách nhất quán.
-
Từ chối hỗ trợ hợp pháp: Thử nghiệm liên quan đến câu hỏi pháp lý cho thấy mô hình bị chỉnh sửa từ chối đúng mẫu yêu cầu ở 5/22 prompt, và mở đầu bằng cụm từ từ chối theo yêu cầu ở 11/22 prompt. Phạm vi thay đổi lại quá rộng khi nó từ chối cả câu hỏi không liên quan về thủ đô nước Pháp.
-
Bỏ sót có chọn lọc: Mục tiêu là loại bỏ một tên nhà cung cấp khỏi kết quả trích xuất. Chính mô hình biên tập thừa nhận nó chưa đạt được việc bỏ sót ổn định; bản vá chỉ gây bỏ sót ở 1/22 prompt thử nghiệm.
Sơ đồ mô hình mối đe dọa do nhóm tác giả đề xuất
Chưa có bằng chứng tự lan truyền
Cần nhấn mạnh rằng nghiên cứu chưa chứng minh khả năng tự lan truyền từ mô hình này sang mô hình khác, cũng chưa có bằng chứng về tấn công thực tế hay thiệt hại cho người dùng. Bài báo có phác thảo một tuyến giả định, trong đó một mô hình biên tập lớn tác động tới mô hình trung gian rồi tới mô hình mục tiêu hạ nguồn, nhưng đây chỉ là giả thuyết chứ không phải kết quả quan sát được.
Điểm mấu chốt là ngay cả khả năng chỉnh sửa chưa hoàn hảo vẫn có thể tạo ra rủi ro bảo mật. Một thay đổi nhỏ, dai dẳng và khó phát hiện có thể đủ để gây hại trong những ngữ cảnh nhất định.
Góc nhìn
Đối với các kỹ sư và doanh nghiệp đang tích hợp mô hình AI vào sản phẩm, nghiên cứu này cho thấy việc chỉ kiểm tra "ai được phép chỉnh sửa" là chưa đủ. Cần kiểm soát toàn bộ đường đi từ lúc chỉnh sửa đến lúc triển khai: giữ mô hình gốc đáng tin cậy, lưu bản ghi bản vá chính xác, lưu cả phản hồi gốc làm mốc so sánh, và luôn có đường lui để khôi phục.
Cách tiếp cận thực dụng là kiểm thử cả hành vi mong muốn lẫn những hành vi lẽ ra phải giữ nguyên, đồng thời xem mỗi lần chấp nhận bản vá chỉ có giá trị trong đúng phạm vi đã được kiểm thử. Với các mô hình tinh chỉnh nội bộ hoặc dùng kỹ thuật tinh chỉnh không cần gradient, đây là yêu cầu quản trị (governance) chứ không chỉ là bài toán kỹ thuật đơn thuần.
Nguồn: alphaxiv.org · Quy trình biên tập
Bài viết liên quan
AI & ML
Nghiên cứu mới: Mô hình AI có thể cố tình che giấu năng lực nguy hiểm một cách khó phát hiện
13 tháng 10, 2026
AI & ML
Phát hiện quan trọng: Hành vi từ chối của AI được điều khiển bởi một chiều duy nhất trong mô hình
02 tháng 5, 2026
AI & ML
Nghiên cứu cảnh báo: Đánh dấu bản quyền AI có thể khiến mô hình ngôn ngữ dễ bị lợi dụng hơn
18 tháng 9, 2026