
Nvidia Nemotron 3.5 Transcribe: Mô hình ASR mở chinh phục 40 ngôn ngữ
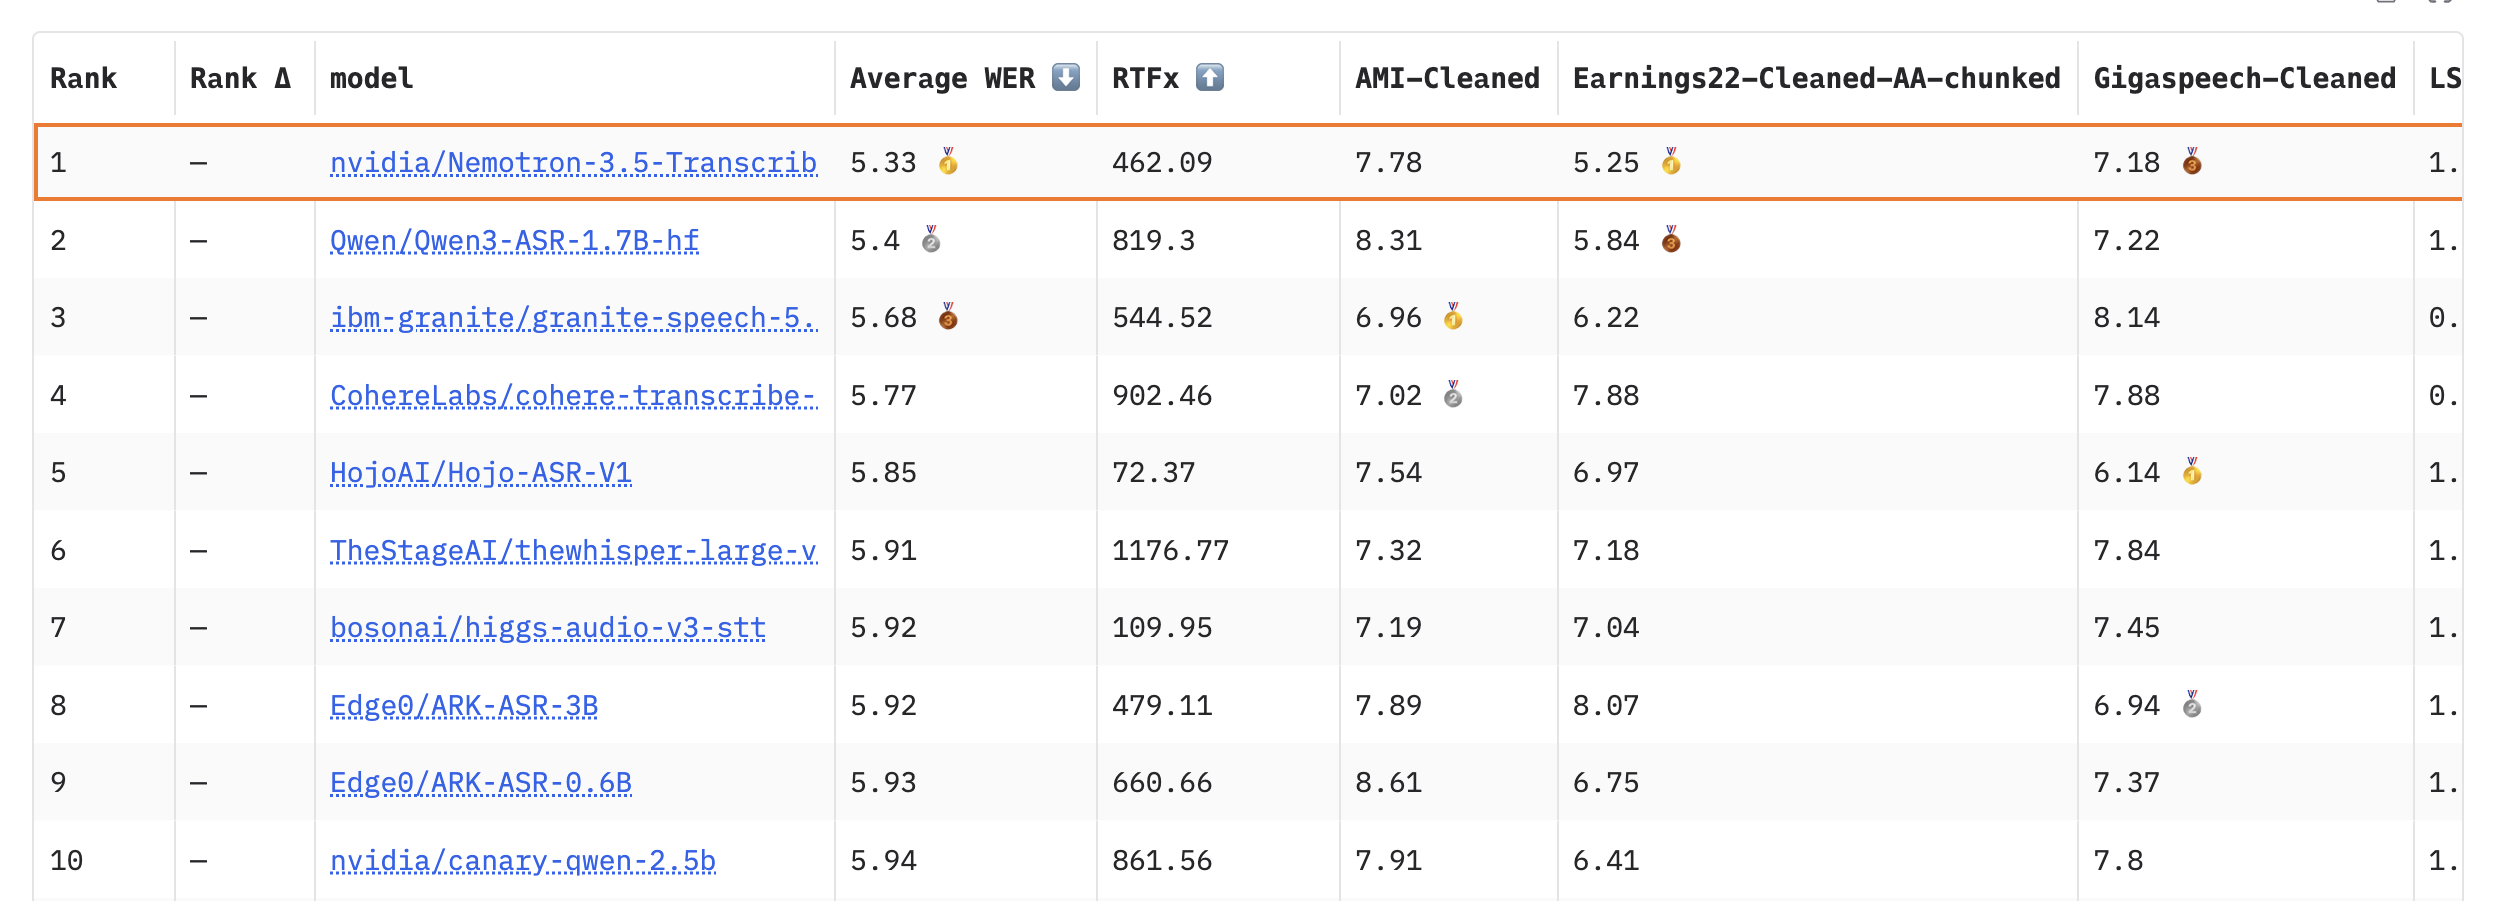
Nvidia vừa ra mắt Nemotron 3.5 Transcribe, mô hình nhận dạng giọng nói mã nguồn mở có thể xử lý 40 ngôn ngữ, nhận diện người nói, dịch thuật và trả lời câu hỏi về âm thanh chỉ trong một checkpoint duy nhất. Mô hình dẫn đầu bảng xếp hạng Hugging Face Open ASR với tỷ lệ lỗi từ 5,33% và chỉ cần khoảng 4 tỷ tham số hoạt động, đi kèm bộ dữ liệu Granary v2 mở rộng tới 463.062 giờ âm thanh.
Nvidia Nemotron 3.5 Transcribe: Mô hình ASR mở chinh phục 40 ngôn ngữ
Nvidia vừa chính thức giới thiệu Nemotron 3.5 Transcribe, một mô hình nhận dạng giọng nói (ASR) mã nguồn mở được thiết kế để chuyển lời nói thành văn bản hữu ích cho doanh nghiệp. Điểm đáng chú ý là mô hình này gộp chung bốn khả năng — phiên âm, nhận diện người nói, dịch thuật và hỏi đáp về âm thanh — vào chỉ một checkpoint duy nhất.
Mô hình hỗ trợ phiên âm tới 40 ngôn ngữ, dịch 31 ngôn ngữ sang hoặc từ tiếng Anh, và nhận diện người nói trong 13 ngôn ngữ. Đặc biệt, nó có thể xử lý các bản ghi dài tới một giờ và gắn nhãn tối đa tám người nói khác nhau.
 Mô hình Nemotron 3.5 Transcribe của Nvidia
Điều khiển bằng ngôn ngữ tự nhiên
Điểm khác biệt lớn nhất của Nemotron 3.5 Transcribe là khả năng điều khiển bằng prompt. Thay vì phải tinh chỉnh mô hình cho từng tác vụ, nhà phát triển chỉ cần đưa ra chỉ dẫn bằng ngôn ngữ tự nhiên để có được đầu ra mong muốn.
Ví dụ, cùng một bản ghi cuộc họp, người dùng có thể yêu cầu:
"Hãy phiên âm bản ghi này và gắn nhãn cho từng người nói."
"Dịch đoạn âm thanh này sang tiếng Anh."
"Những quyết định nào đã được đưa ra trong cuộc họp này?"
Cách tiếp cận này tỏ ra đặc biệt hữu ích với các lĩnh vực chuyên môn. Trong môi trường y tế, người dùng có thể đưa vào prompt các thuật ngữ như HbA1c hay metformin, kèm chỉ dẫn chỉ sử dụng chúng khi âm thanh thực sự hỗ trợ, đồng thời giữ nguyên cách viết chuẩn của thuật ngữ y khoa.
Thành tích ấn tượng trên các bảng xếp hạng
Sức mạnh của Nemotron 3.5 Transcribe không chỉ nằm ở tính linh hoạt mà còn ở hiệu năng thực tế. Trên Hugging Face Open ASR Leaderboard dành cho tiếng Anh, mô hình đứng đầu trong số các mô hình mở với tỷ lệ lỗi từ (WER) trung bình chỉ 5,33%. Ở hạng mục đa ngôn ngữ, con số này là 4,62% trên bảy ngôn ngữ, còn với âm thanh dài, mô hình đạt 10,98%.
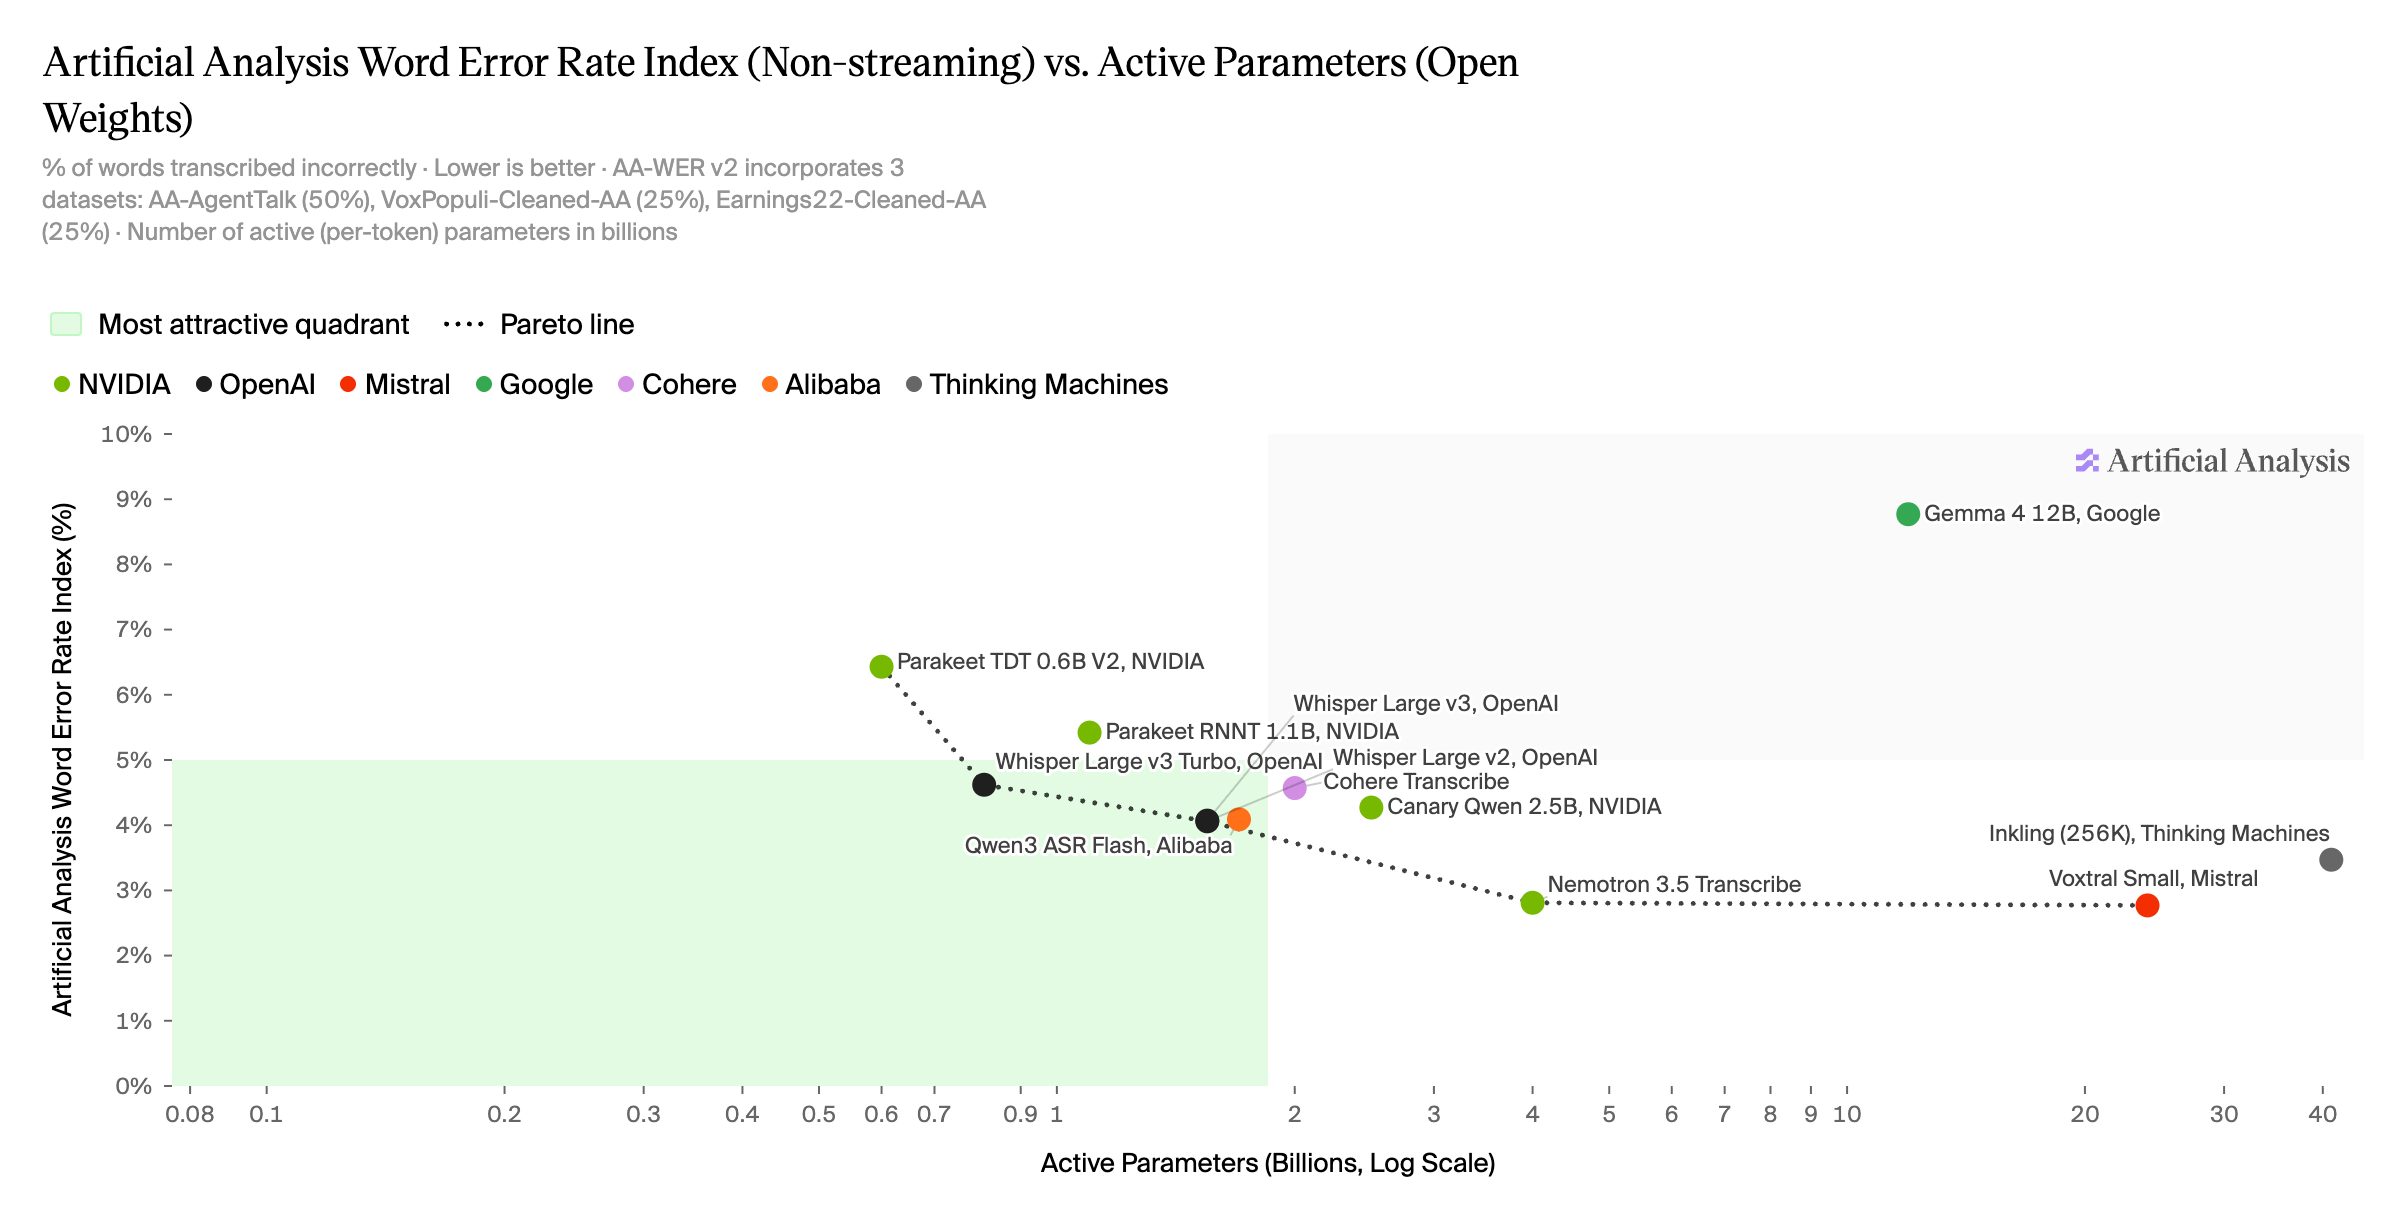
Trên bảng xếp hạng độc lập Artificial Analysis, Nemotron 3.5 Transcribe đồng hạng nhất trong nhóm mô hình mở với chỉ số AA-WER 2,8%. Đáng chú ý, mô hình chỉ cần khoảng 4 tỷ tham số hoạt động trong tổng số 30 tỷ tham số, nhờ kiến trúc kết hợp bộ mã hóa giọng nói với mô hình ngôn ngữ mixture-of-experts lai Mamba–Transformer.
 Hiệu năng của Nemotron 3.5 Transcribe trên bảng xếp hạng
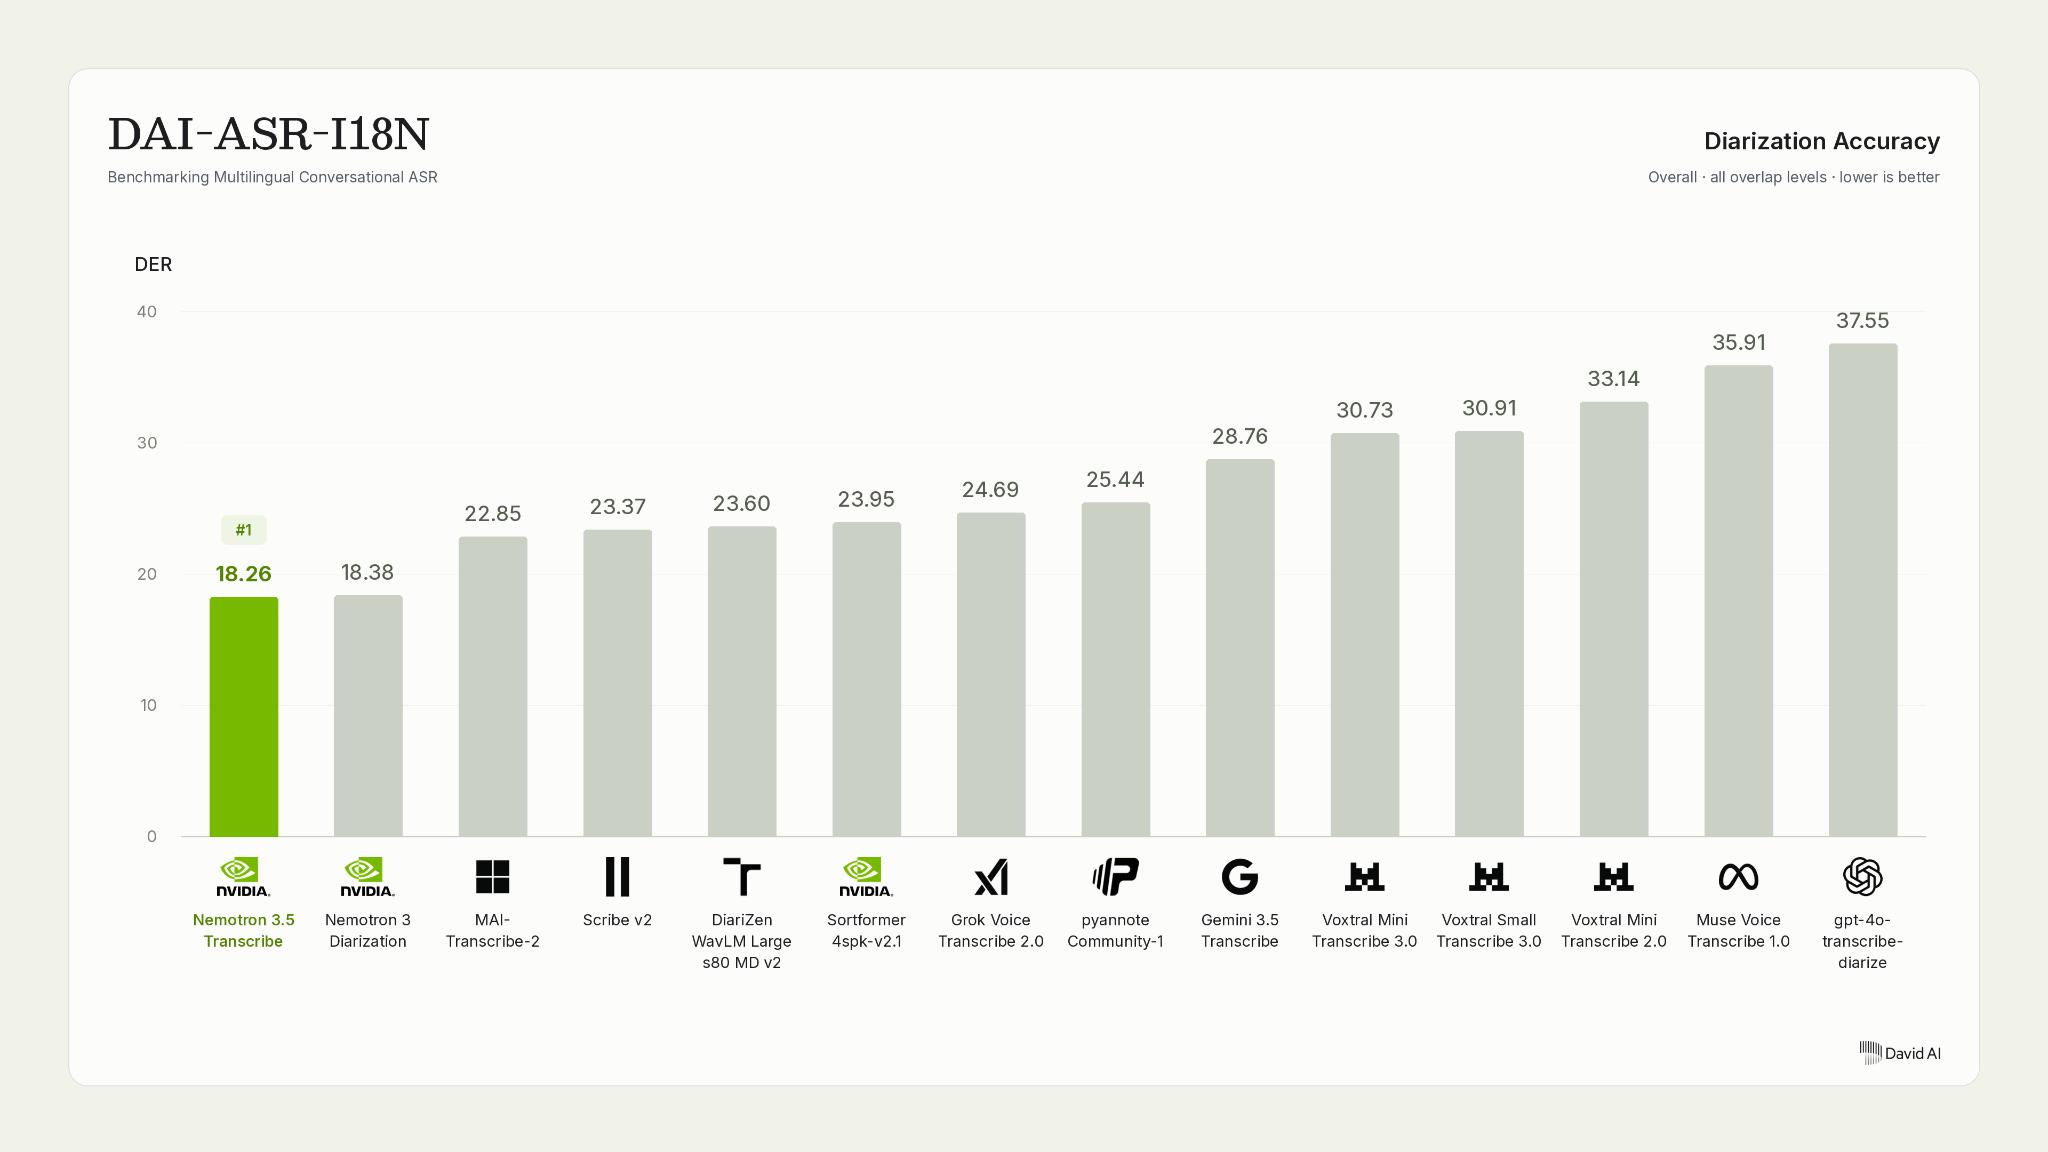
Về khả năng nhận diện người nói, mô hình đạt tỷ lệ lỗi phân tách người nói (DER) thấp nhất trong 14 hệ thống được thử nghiệm trên bảng xếp hạng DAI-ASR-I18N của David AI, với 18,26% trên 21 ngôn ngữ. Trên VoiceArena, mô hình cũng dẫn đầu cả về chỉ số cpWER lẫn khả năng xử lý các đoạn hội thoại chồng chéo.
Granary v2: Bộ dữ liệu mở đằng sau mô hình
Song hành với mô hình, Nvidia công bố Granary v2 — pipeline tuyển chọn dữ liệu giọng nói mã nguồn mở. Bộ dữ liệu này bao phủ 463.062 giờ âm thanh trên 48 ngôn ngữ và 16 kho dữ liệu nguồn, mở rộng đáng kể so với 25 ngôn ngữ của phiên bản Granary v1.
Pipeline tạo ra ba dạng bản ghi cho mỗi đoạn âm thanh, tương ứng với các kiểu đầu ra mà người dùng có thể yêu cầu qua prompt: dạng chuẩn hóa văn bản nguyên văn, dạng chuẩn hóa ngược có giữ từ đệm, và dạng chuẩn hóa ngược không có từ đệm. Ngoài ra, pipeline còn tạo chú thích âm thanh ngắn, khôi phục từ vay mượn, cặp hỏi đáp dựa trên giọng nói và bản dịch kèm điểm chất lượng tự động.
Tinh chỉnh cho lĩnh vực chuyên biệt
Với các lĩnh vực có từ vựng đặc thù, Nvidia cung cấp quy trình tinh chỉnh thông qua NeMo Speech. Một nghiên cứu điển hình trên bộ dữ liệu y khoa Ấn Độ của Eka Care cho thấy hiệu quả rõ rệt: chỉ cần một prompt tốt hơn đã giảm WER từ 30,8% xuống 23,8%, và sau khi tinh chỉnh, con số này tiếp tục giảm xuống 11,8%.
Trên tập kiểm thử giữ riêng cho những người nói mới, WER giảm từ 22,44% xuống 12,17% — tương đương mức giảm tương đối 45,8%. Toàn bộ quá trình thích ứng chỉ mất khoảng 14 giờ GPU trên một chiếc NVIDIA GB300.
 Quy trình tinh chỉnh mô hình cho lĩnh vực y khoa
Hiệu năng và khả năng triển khai
Về tốc độ, trong thử nghiệm, Nemotron 3.5 Transcribe xử lý 100 giờ âm thanh trong chưa đầy ba phút trên một GPU RTX PRO 6000 Blackwell Server Edition, sử dụng phiên bản lượng tử hóa NVFP4 sắp ra mắt. Mô hình có thể được phục vụ ngay hôm nay thông qua vLLM, với các phiên bản lượng tử hóa cho phép chạy cục bộ trên RTX Spark, DGX Spark hay Jetson AGX Thor.
Người dùng cũng có thể lựa chọn các endpoint được lưu trữ sẵn từ Baseten, DeepInfra hoặc Simplismart nếu không muốn tự vận hành. Cần lưu ý rằng mô hình được thiết kế cho âm thanh đã ghi lại, không phải streaming trực tiếp.
Ý nghĩa với cộng đồng công nghệ Việt Nam
Sự xuất hiện của Nemotron 3.5 Transcribe mở ra nhiều cơ hội cho các nhà phát triển Việt Nam, đặc biệt trong bối cảnh nhu cầu chuyển đổi số các quy trình ghi âm, họp trực tuyến và xử lý dữ liệu giọng nói ngày càng tăng. Với giấy phép mở và khả năng tinh chỉnh, các doanh nghiệp trong nước có thể thích ứng mô hình cho tiếng Việt và các ngôn ngữ dân tộc thiểu số — lĩnh vực mà các mô hình thương mại thường chưa được tối ưu tốt.
Việc mô hình chỉ cần khoảng 4 tỷ tham số hoạt động cũng giúp giảm đáng kể chi phí triển khai, mở ra khả năng chạy trên hạ tầng vừa và nhỏ thay vì phải phụ thuộc vào các trung tâm dữ liệu lớn.
Để bắt đầu, nhà phát triển có thể thử mô hình qua bản demo trên Hugging Face hoặc ModelScope Studios, sau đó tải checkpoint và làm theo hướng dẫn triển khai với vLLM. Các tài liệu về Granary v2 và nghiên cứu điển hình y khoa cũng được công bố đầy đủ để cộng đồng tham khảo và tái sử dụng.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Amazon biến chiếc loa thông minh mạnh nhất của mình thành cả camera an ninh
28 tháng 10, 2026