Ornith-1.5 ra mắt: mô hình tự cải thiện, đạt 86,1 điểm Terminal-Bench
Ornith-1.5 gồm ba quy mô 397B MoE, 35B MoE và 9B dense, tự sinh bài tập, tự dựng khung đánh giá và tự tạo lời giải để học tăng cường. Bản 397B đạt 86,1 điểm Terminal-Bench 2.1, ngang Claude Opus 4.8, còn bản 9B chạy được trên điện thoại.
Ornith vừa công bố Ornith-1.5, phiên bản mở rộng của khung tự dựng khung (self-scaffolding) từng xuất hiện ở Ornith-1.0. Điểm khác biệt nằm ở chỗ mô hình không chỉ tối ưu cách giải mà còn tự đề bài, tự viết công cụ đánh giá và tự tạo dữ liệu huấn luyện.
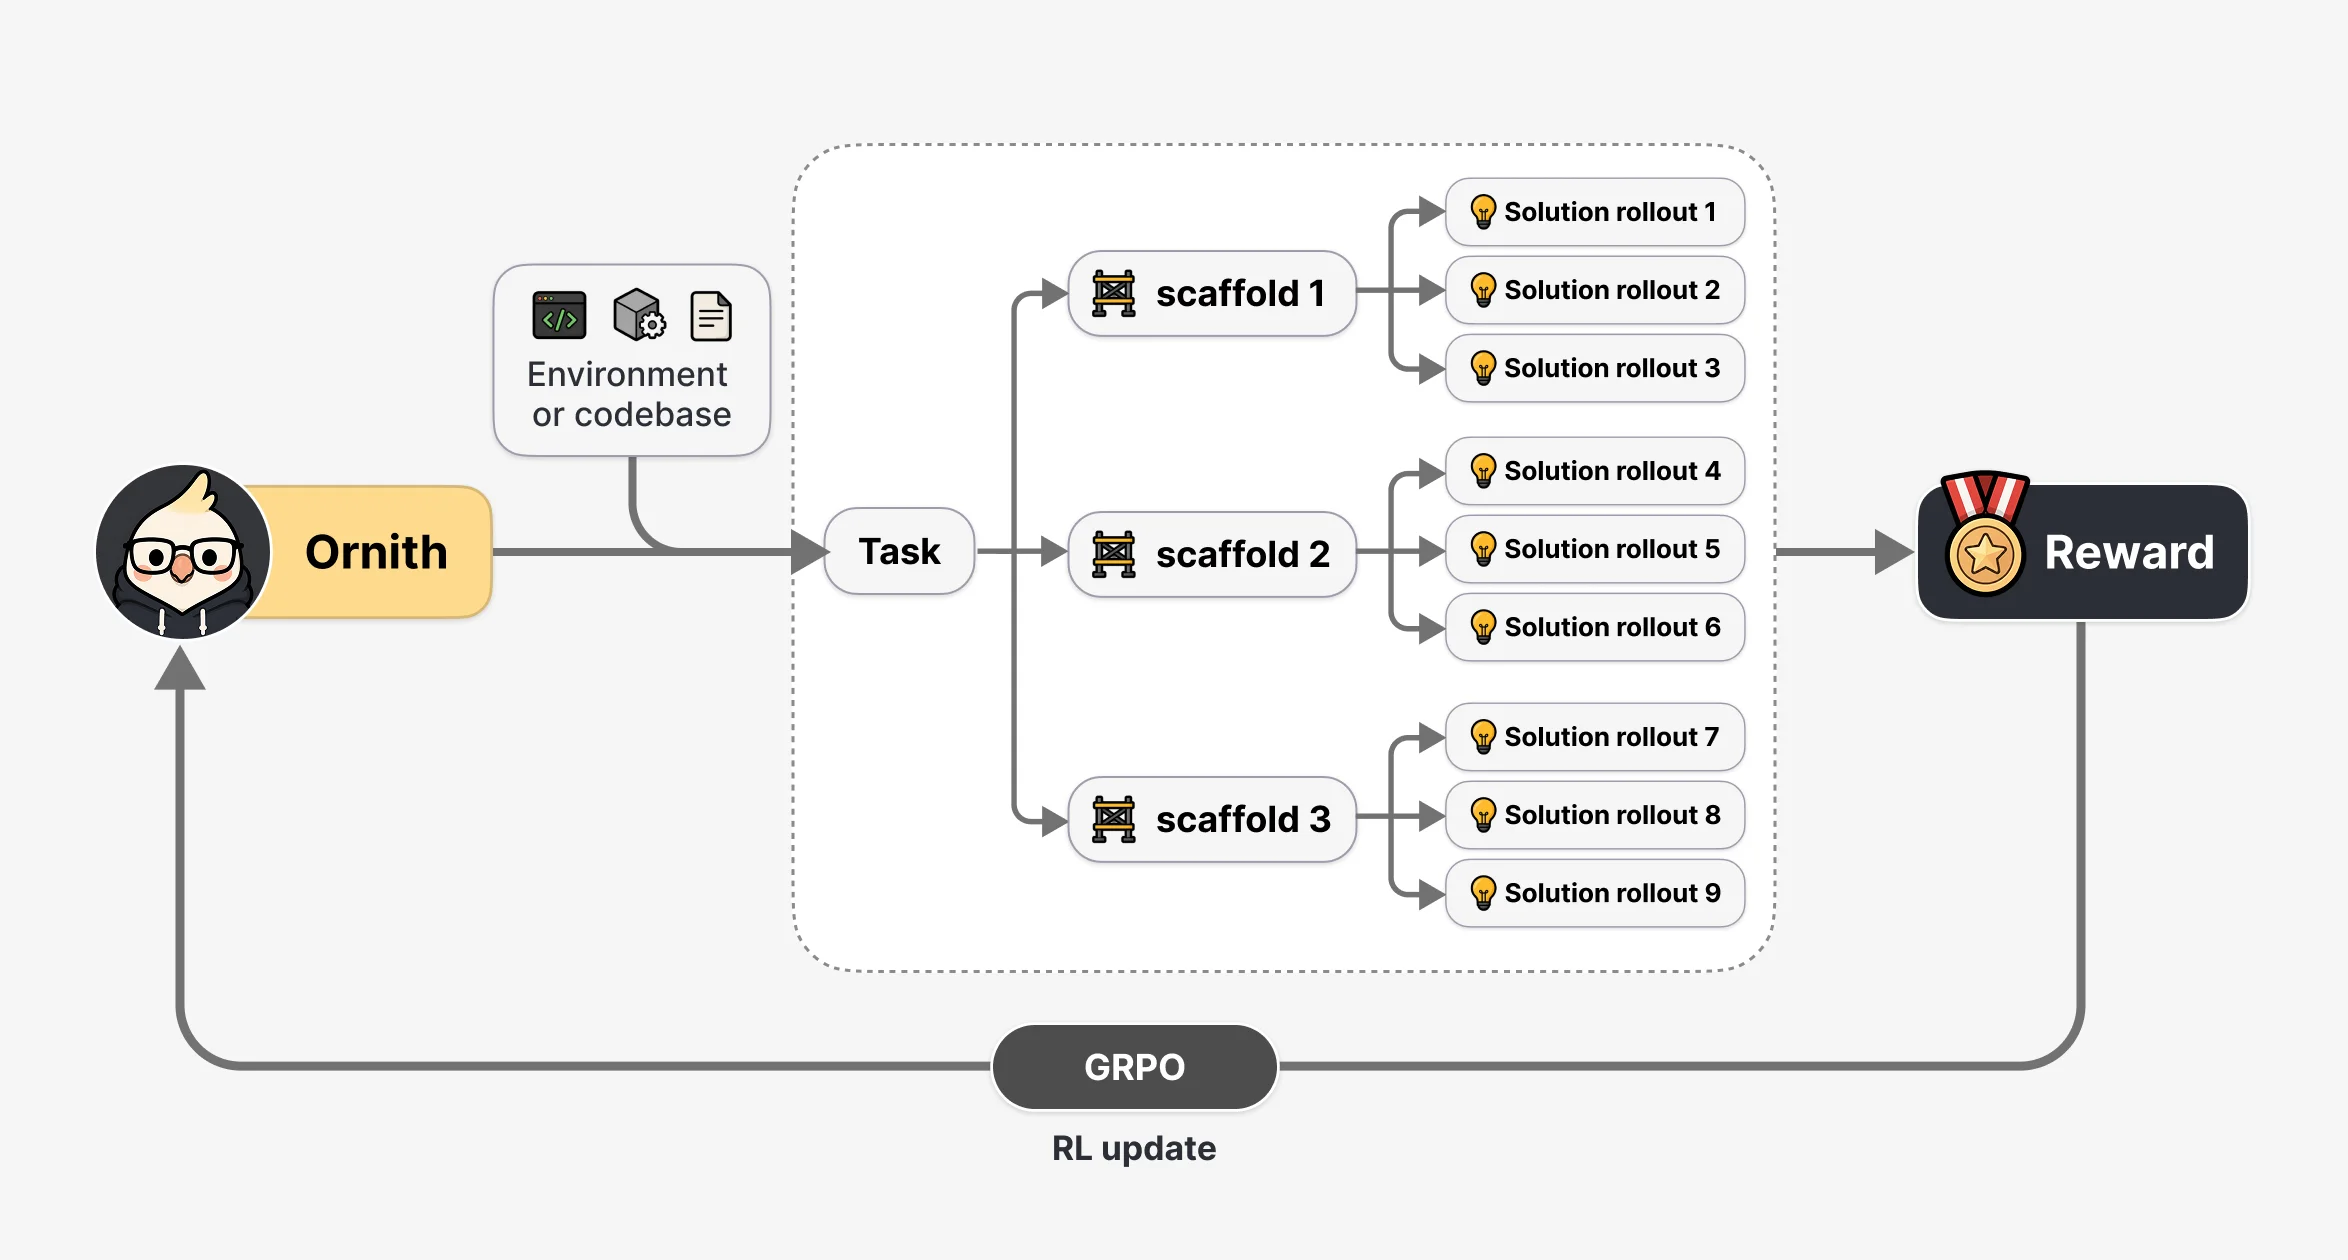 Sơ đồ vòng lặp tự cải thiện của Ornith-1.5
Dòng mô hình có ba quy mô: 397B MoE, 35B MoE và 9B dense. Tất cả đều nhắm vào ba nhóm tác vụ là suy luận (reasoning), tác tử (agentic) và lập trình.
Kết quả trên các bộ kiểm tra
Bản đầu bảng Ornith-1.5-397B đạt 86,1 điểm Terminal-Bench 2.1 và 56,0 điểm DeepSWE. Con số tương ứng của Claude Opus 4.8 là 85,0 và 59,0.
So với các mô hình mã nguồn mở cùng cỡ, Ornith-1.5-397B vượt GLM-5.2 (82,7 và 46,2) và DeepSeek-V4-Flash-0731 (82,7 và 54,4).
Bản Ornith-1.5-35B chỉ kích hoạt 3B tham số mỗi token nhưng vượt Qwen 3.6-35B trên toàn bộ bài kiểm tra lập trình và tác tử. Mô hình đạt 68,5 điểm Terminal-Bench 2.1 (dùng khung Claude Code), so với 43,4 của Gemma 4-31B và 51,7 của Muse Glimmer-30B.
Bản Ornith-1.5-9B đạt 47,0 điểm Terminal-Bench 2.1 và 70,6 điểm SWE-Bench Verified. Với bản lượng tử hóa Ornith-1.5-9B-Mobile, mô hình chạy được trực tiếp trên iPhone và Android.
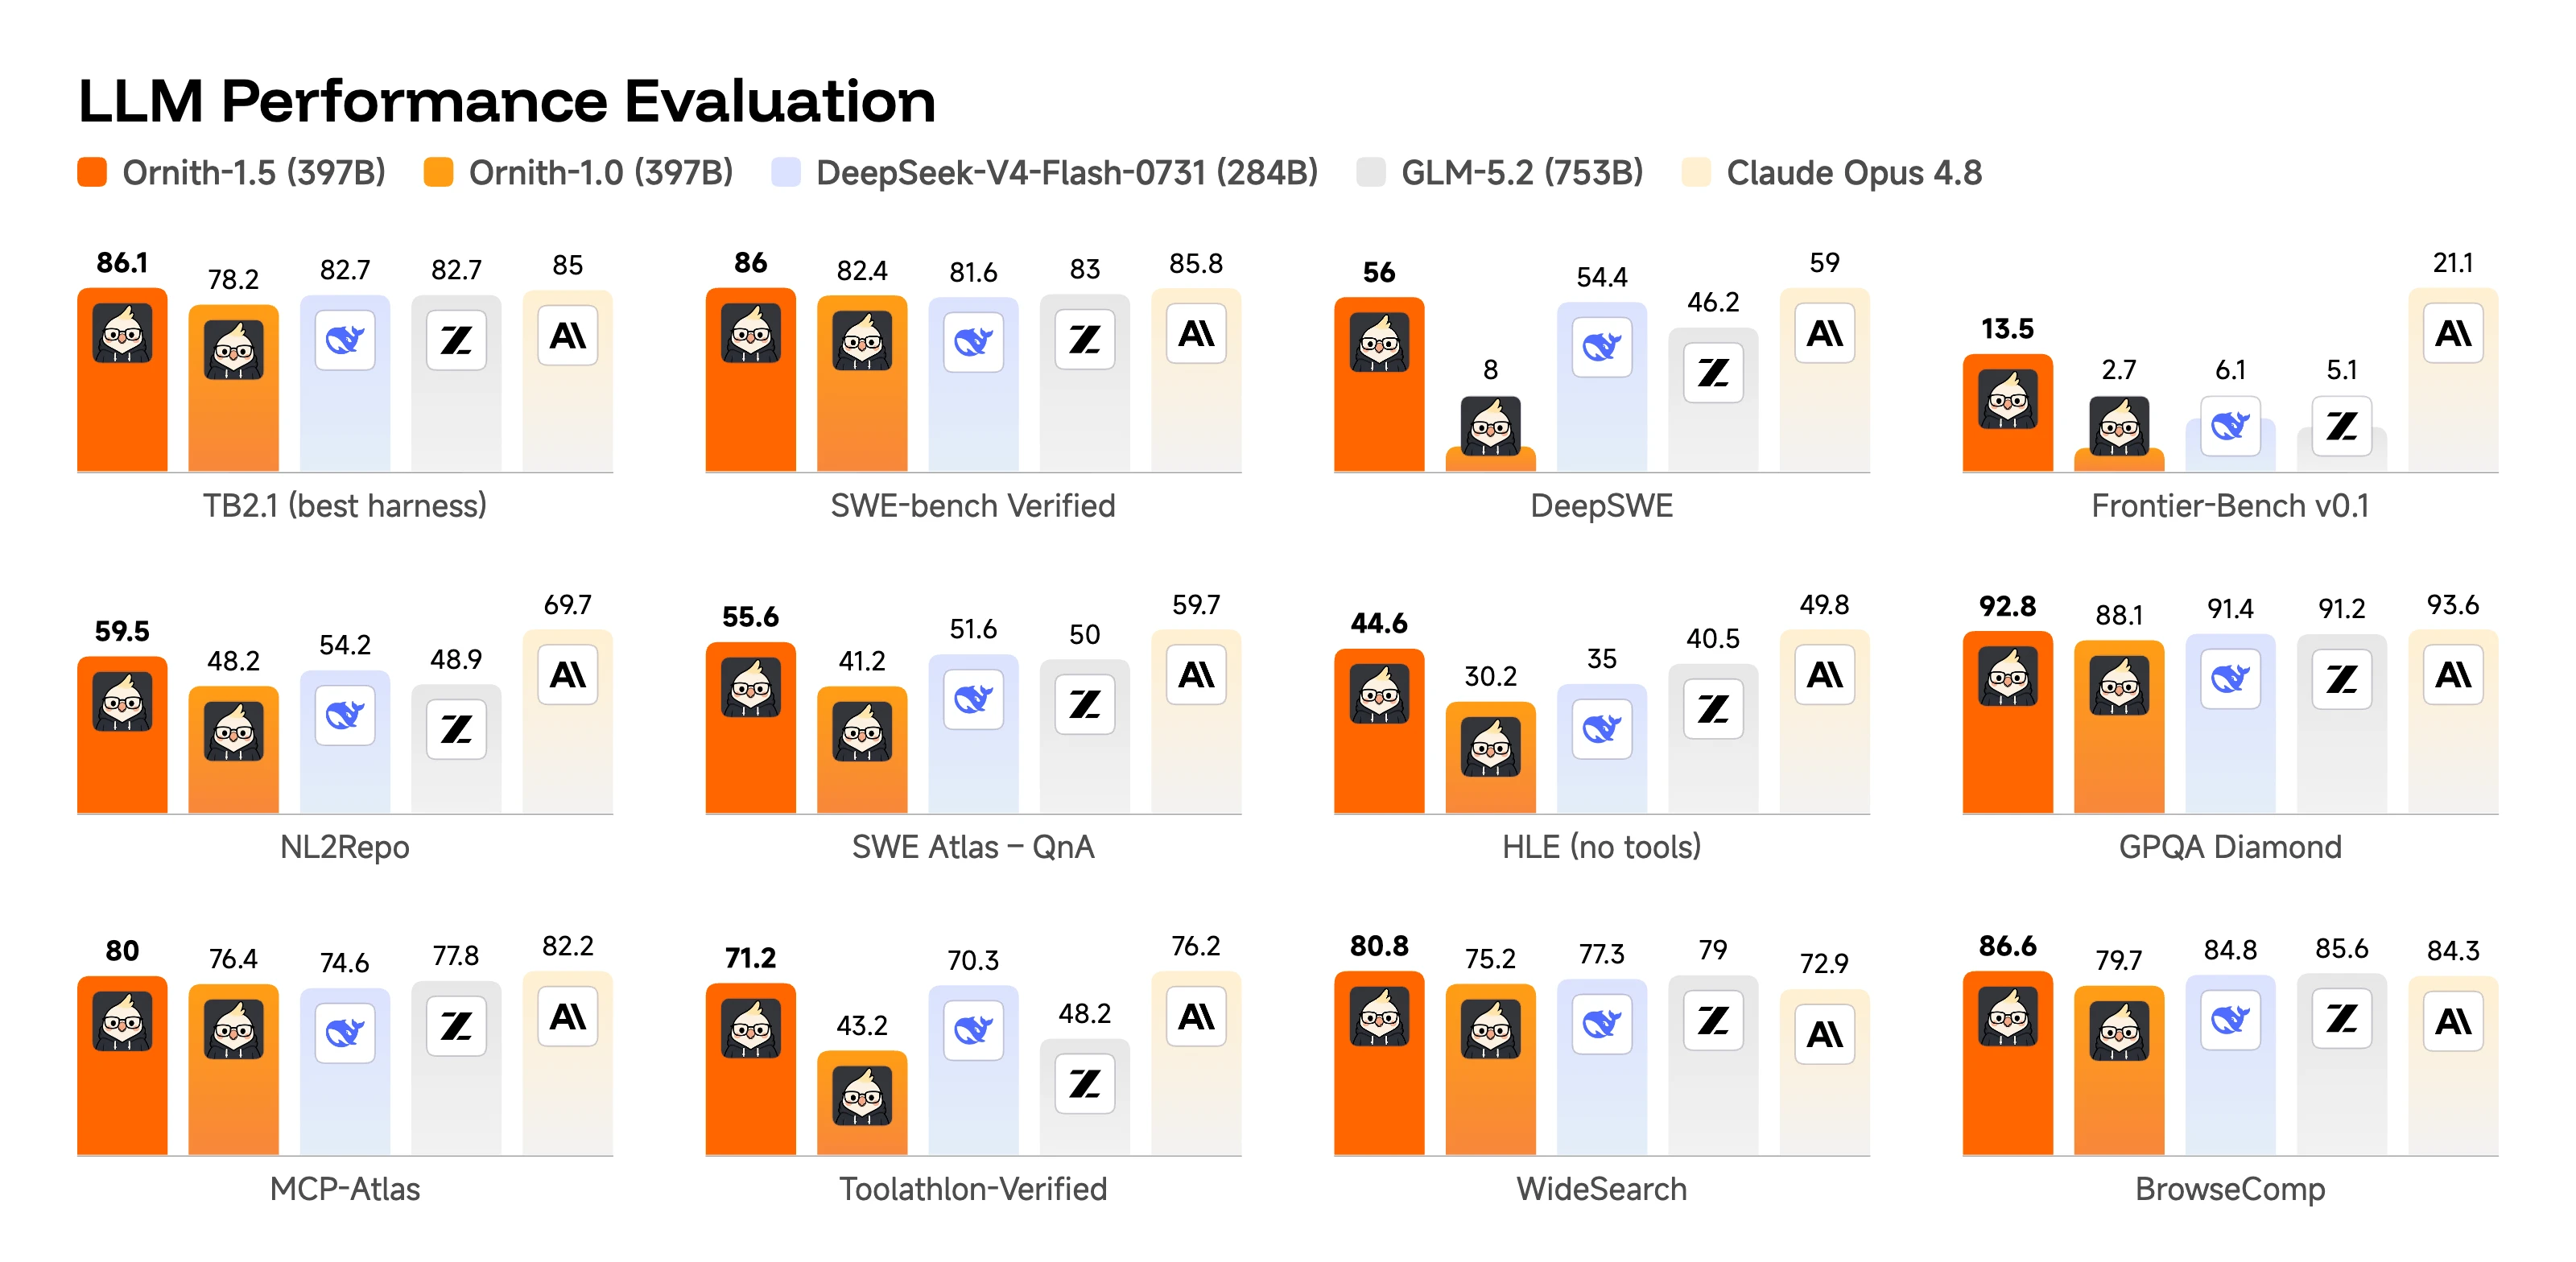 Bảng điểm của Ornith-1.5-397B
Cách vòng lặp tự cải thiện hoạt động
Mỗi chu kỳ huấn luyện gồm ba bước. Đầu tiên, hệ thống nhận môi trường hoặc kho mã nguồn, chỉ dẫn về loại tác vụ và lịch sử giải bài trước đó, rồi đề xuất những bài khó dần, vượt qua mức mô hình đã làm được.
Tiếp theo, với mỗi bài, mô hình sinh hoặc tinh chỉnh một khung riêng (harness): chỉ dẫn, công cụ, cách chia nhỏ vấn đề và cách điều phối. Cuối cùng, mô hình tạo lời giải và nhận thưởng.
Điểm thưởng được lan truyền ngược qua cả ba bước. Nhờ vậy, hệ thống học cách vừa giải tốt hơn, vừa ra đề hữu ích hơn, vừa dựng khung đánh giá hiệu quả hơn. Quá trình lặp lại tạo thành một vòng khép kín: chính sách mạnh hơn sinh ra bài khó hơn, khung tốt hơn khai thác năng lực mô hình tốt hơn.
Ba tín hiệu thưởng
Điểm thưởng cho tác vụ là tích của ba yếu tố: tính hợp lệ, độ khó ở biên năng lực và tính mới.
- Tính hợp lệ kiểm tra khung có chạy được không, lời giải đúng có vượt qua không, lời giải sai có bị loại không. Nếu không hợp lệ, điểm thưởng bằng 0.
- Độ khó ở biên năng lực dựa trên tỷ lệ thành công thực tế khi lấy mẫu nhiều lời giải. Hệ thống nhắm tới tỷ lệ khoảng 0,2, tức bài đủ khó nhưng vẫn tạo ra đủ mẫu thành công để học. Khi mô hình giỏi lên, bài cũ mất điểm và bộ sinh đề buộc phải khó hơn.
- Tính mới so sánh với kho bài đã sinh hoặc đã huấn luyện, nhằm tránh việc mô hình lặp lại các biến thể nhỏ của cùng một bài.
Khung đánh giá có điểm thưởng riêng, gồm mức khớp với yêu cầu bài, mức trung thực của điểm số và khả năng chống gian lận thưởng (reward hacking). Lời giải được chấm trực tiếp bởi khung.
Cả ba bước đều được tối ưu bằng GRPO với điểm thưởng tương ứng.
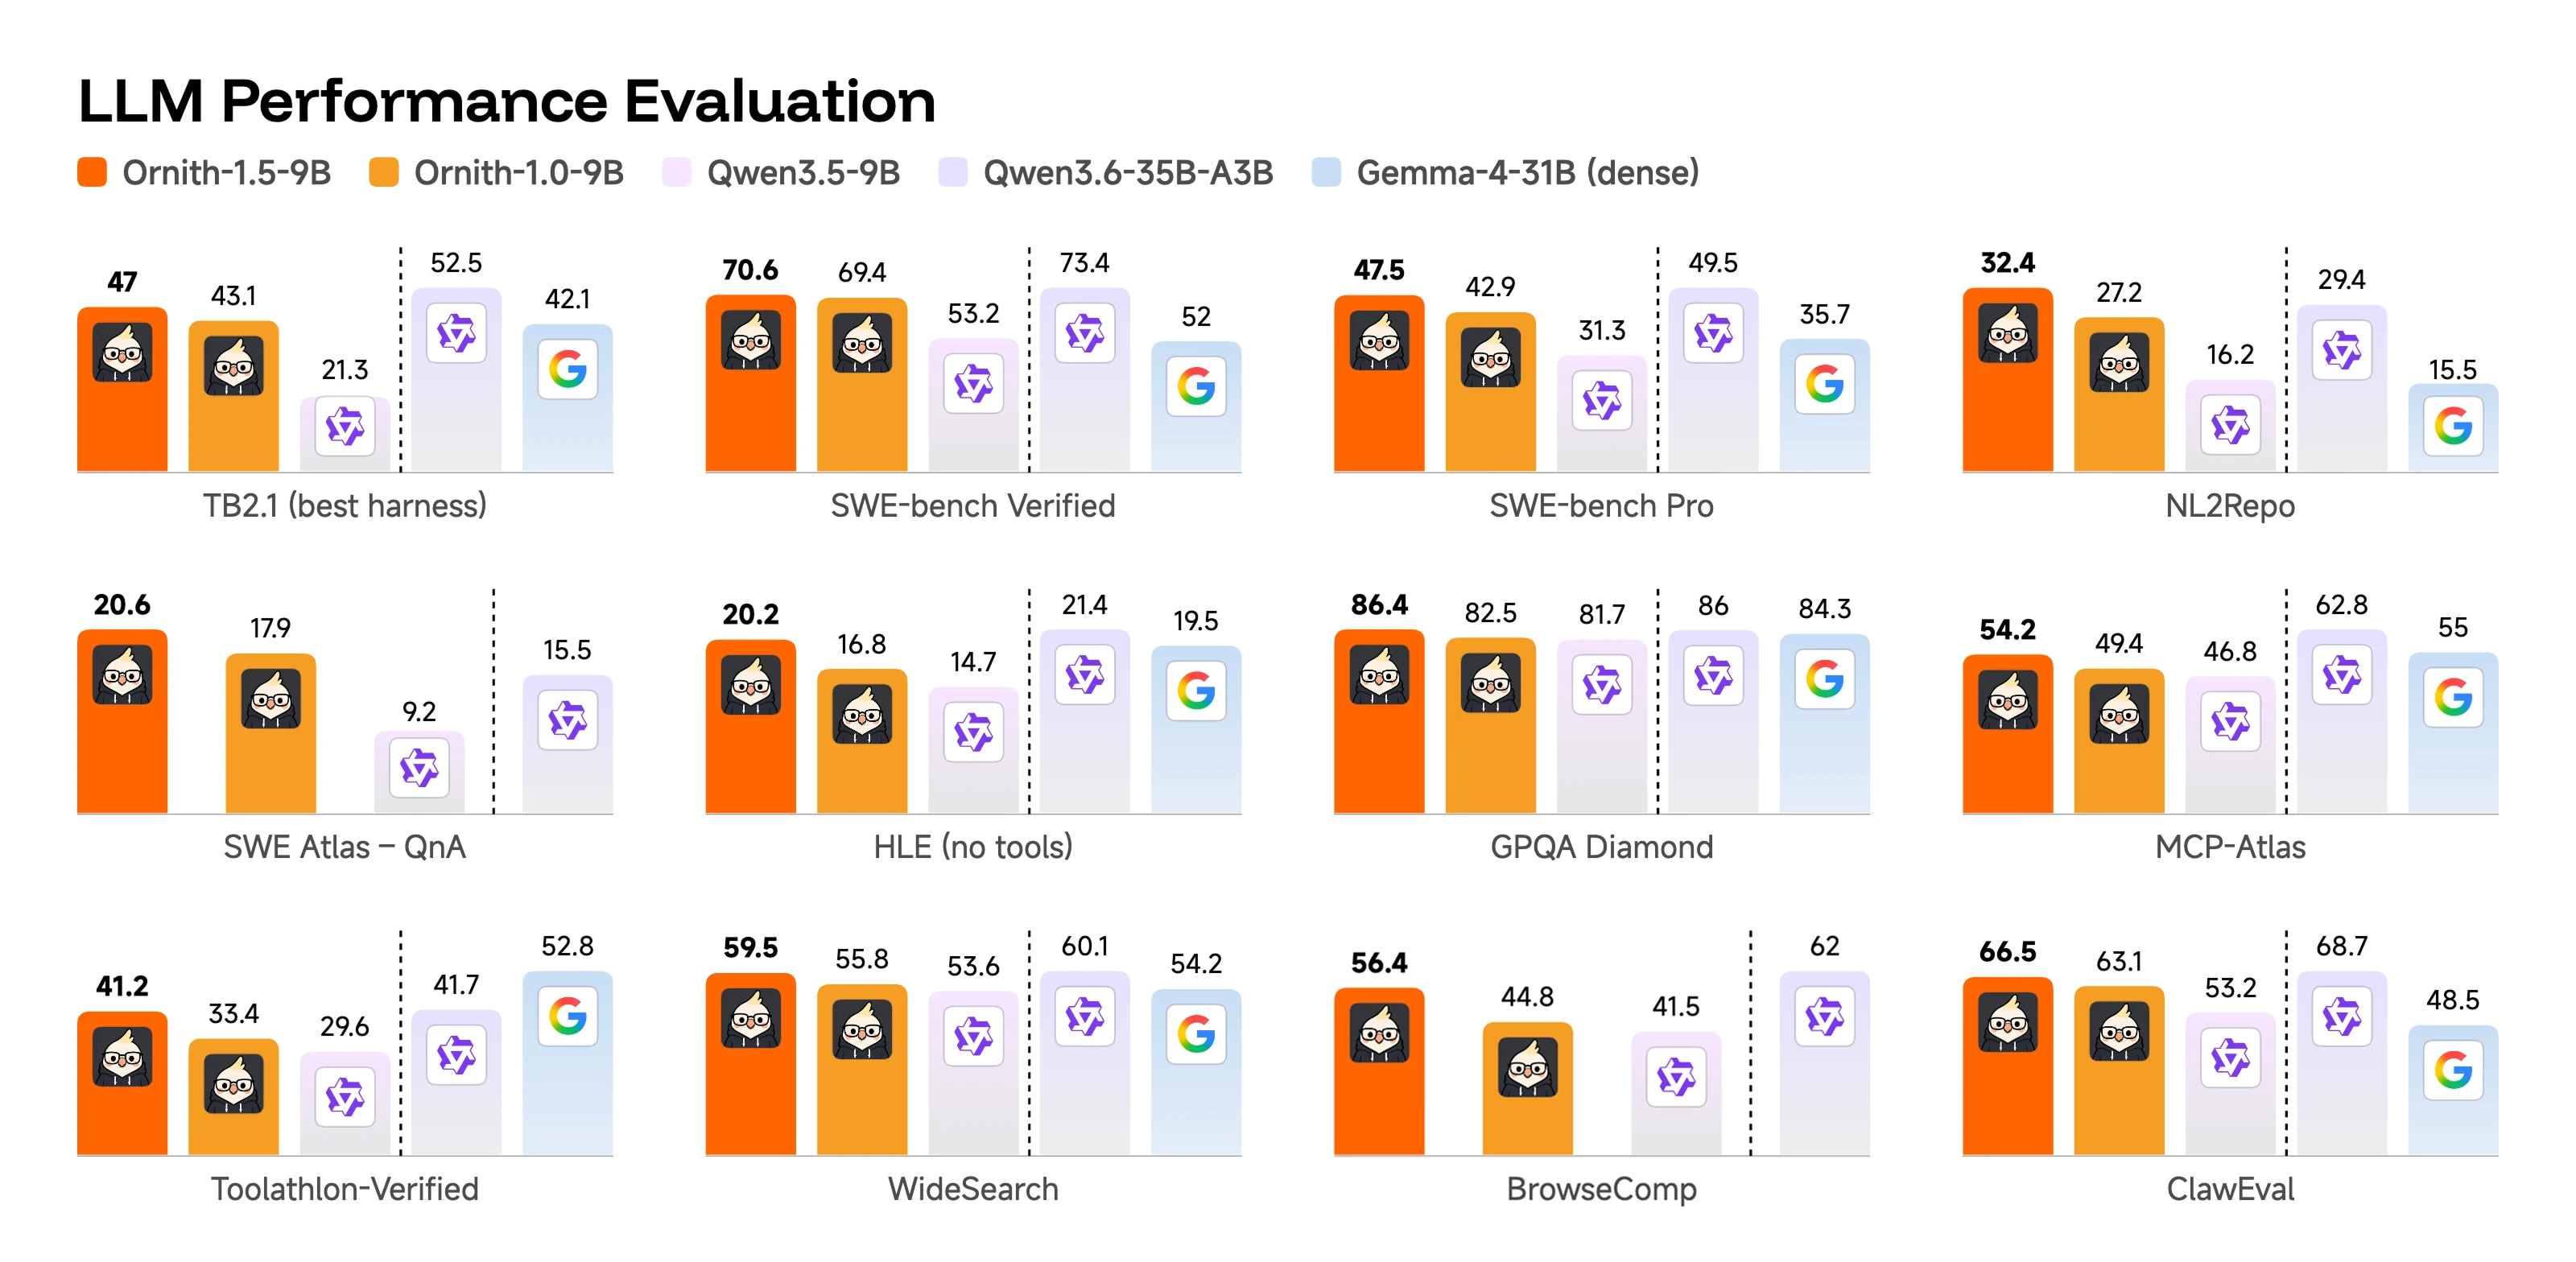 Bảng điểm của Ornith-1.5-9B
Chi tiết cách đánh giá
Kết quả của Ornith-1.5 được lấy trung bình trên 5 lần chạy độc lập.
Bài Terminal-Bench 2.1 dùng khung Harbor/Terminus-2 hoặc Claude Code 2.1.126, cửa sổ ngữ cảnh 128K, mỗi lần chạy giới hạn 4 giờ với 32 lõi CPU và 48GB RAM.
Bài SWE-Bench dùng khung OpenHands, ngữ cảnh 256K. Lịch sử Git bị xóa khỏi kho mã và mạng bị tắt để mô hình không lấy được lời giải sẵn.
Bài NL2Repo bị chặn truy cập các kho GitHub và gói pip được chỉ định, cũng nhằm chống gian lận. Bài HLE dùng Claude 4.6 Opus làm trọng tài, còn MCP-Atlas dùng Claude 4.8 Opus.
Góc nhìn
Với các nhóm kỹ thuật ở Việt Nam, điểm đáng quan tâm không chỉ là con số điểm. Ba quy mô cho phép chọn mô hình theo hạ tầng thực tế: bản 35B chạy được trên một cụm GPU nhỏ, bản 9B lượng tử hóa mở đường cho trợ lý lập trình chạy ngay trên máy cá nhân hoặc điện thoại.
Cách Ornith dùng mô hình tự sinh bài và tự dựng khung đánh giá cũng gợi ý một hướng cho các nhóm muốn tinh chỉnh mô hình theo mã nguồn nội bộ. Thay vì gán nhãn thủ công từng bài, họ có thể để mô hình tự tạo bài từ chính kho mã của mình, miễn là khâu kiểm tra hợp lệ và chống gian lận được làm chặt.
Điều cần lưu ý là toàn bộ số liệu trên do chính Ornith công bố. Trước khi đưa vào quy trình thật, nên chạy lại trên dữ liệu và tác vụ của chính đội ngũ.
Nguồn: ornith.ai · Quy trình biên tập