
Phương pháp bình phương tối thiểu giúp ước lượng mật độ tương đối ổn định hơn
Nhà nghiên cứu Francis Bach đề xuất một khung phương pháp mới giúp ước lượng mật độ tương đối và phân kỳ KL mà không gặp phải hiện tượng phương sai bùng nổ vốn có của các hàm log-sum-exp. Bằng cách phân rã bài toán thành vô số bài toán bình phương tối thiểu ổn định và giải chúng chỉ với một phép phân rã trị riêng suy rộng, phương pháp này còn mang lại công thức dạng đóng cho hồi quy softmax — mở ra tiềm năng thay thế lớp cuối của mạng nơ-ron.
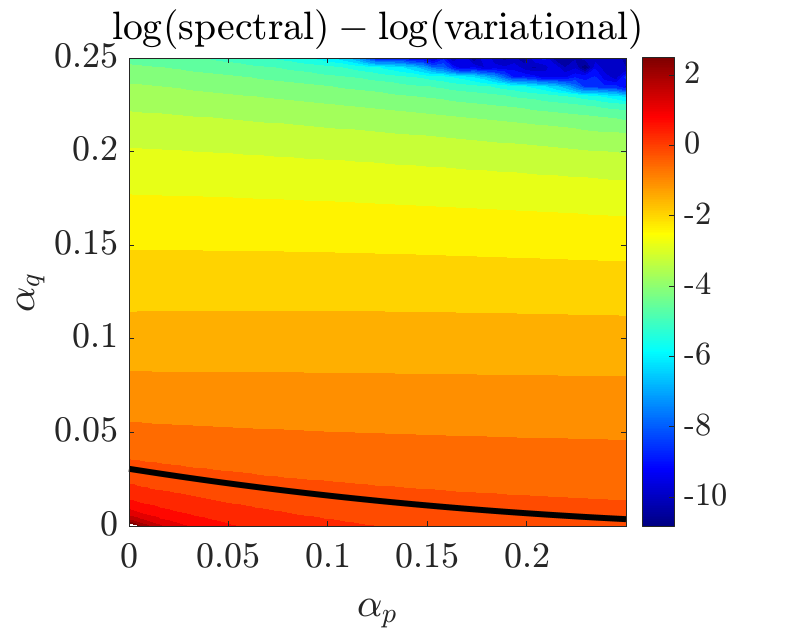
Bình phương tối thiểu "cứu" bài toán ước lượng mật độ tương đối khỏi phương sai bùng nổ
Trong học máy, việc ước lượng và tối ưu các hàm log-sum-exp là một tác vụ phổ biến nhưng đầy thách thức. Nhà nghiên cứu Francis Bach vừa công bố một khung phương pháp mới cho phép ước lượng mật độ tương đối với phương sai ổn định, dựa trên một chuỗi liên tục các bài toán bình phương tối thiểu và một phép phân rã trị riêng suy rộng duy nhất.
Điểm đáng chú ý là phương pháp này không chỉ giải quyết vấn đề phương sai bùng nổ của log-sum-exp, mà còn mang lại công thức dạng đóng cho hồi quy softmax — điều mà trước đây chỉ có thể giải được bằng các thuật toán tối ưu lặp như phương pháp Newton.
Vấn đề: log-sum-exp và phương sai bùng nổ theo cấp số nhân
Nhiều mô hình xác suất trong học máy cần tính các đại lượng dạng $\log \big( \int_{\mathcal{X}} e^{v(x)} dq(x) \big)$, trong đó $v$ là một hàm thế năng và $q$ là phân phối xác suất. Hàm log-sum-exp xuất hiện ở khắp nơi: từ chuẩn hóa mô hình xác suất, xấp xỉ trơn của phép lấy cực đại, đạo hàm trong kiến trúc transformer, cho đến học tăng cường với điều chuẩn entropy.
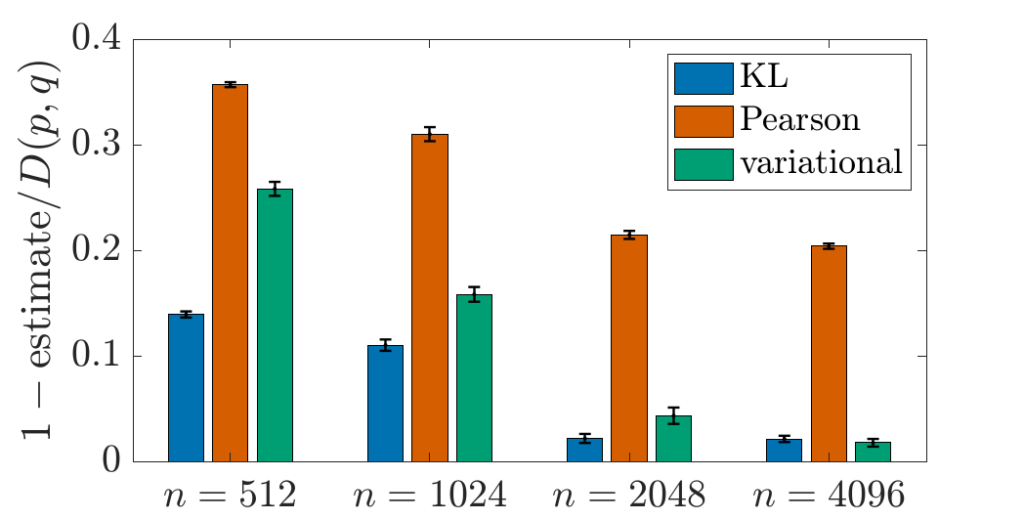 Minh họa phương sai của ước lượng mũ
Vấn đề cốt lõi nằm ở phương sai. Xét trường hợp đơn giản với $z_1,\dots,z_n$ độc lập, phân phối chuẩn với kỳ vọng $\mu$ và phương sai $\sigma^2$, sai số bình phương tương đối khi ước lượng $\mathbb{E}[e^z]$ là:
$$\frac{ e^{\sigma^2}-1}{n}$$
Đại lượng này tiến về 0 khi $n$ tăng, nhưng bùng nổ theo cấp số nhân khi $\sigma$ tăng. Ngay cả khi lấy logarit, phương sai vẫn tăng với tốc độ tương tự. Đây là lý do khiến việc ước lượng dựa trên lấy mẫu trở nên cực kỳ bất ổn trong các bài toán thực tế.
Bình phương tối thiểu: mặt đối lập hoàn hảo
Trong khi log-sum-exp khó ước lượng nhưng sở hữu nhiều tính chất đẹp, hồi quy bình phương tối thiểu lại có đặc điểm gần như ngược lại. Về mặt tích cực, nó mang lại sự đơn giản cả về tính toán lẫn thống kê: lời giải dạng đóng cho mô hình tuyến tính, phương sai được kiểm soát chặt chẽ, và các phân tích sắc nét trong nhiều bối cảnh tối ưu hóa khác nhau.
Về mặt tiêu cực, việc dùng bình phương tối thiểu cho mọi bài toán dự đoán — đặc biệt với đầu ra rời rạc — lại tạo ra các hiện tượng méo mó. Ví dụ kinh điển là bài toán phân loại với dữ liệu Gaussian (cùng ma trận hiệp phương sai), nơi bình phương tối thiểu trên đầu ra mã hóa one-hot gặp vấn đề "che khuất" (masking): một số lớp có thể biến mất hoàn toàn khỏi miền quyết định.
Câu hỏi trung tâm mà tác giả đặt ra: Liệu có thể dung hòa hai thế giới này? Cụ thể hơn, liệu có thể có được các ước lượng dạng đóng dựa trên bình phương tối thiểu cho những bài toán hợp lý cực đại vốn thường đòi hỏi tối ưu hóa hàm lồi (như hồi quy logistic hay softmax)?
Ý tưởng then chốt: một phương trình tích phân
Câu trả lời nằm gọn trong một phương trình tích phân:
$$ t \log t, – t + 1 = \int_0^1 !! \frac{ (t-1)^2}{\rho t + 1-\rho} (1-\rho) d\rho$$
Phương trình này cho thấy phân kỳ KL — vốn gắn với log-sum-exp — có thể được biểu diễn như tích phân của vô số phân kỳ chi-square có trọng số, và mỗi phân kỳ chi-square lại có dạng bài toán bình phương tối thiểu.
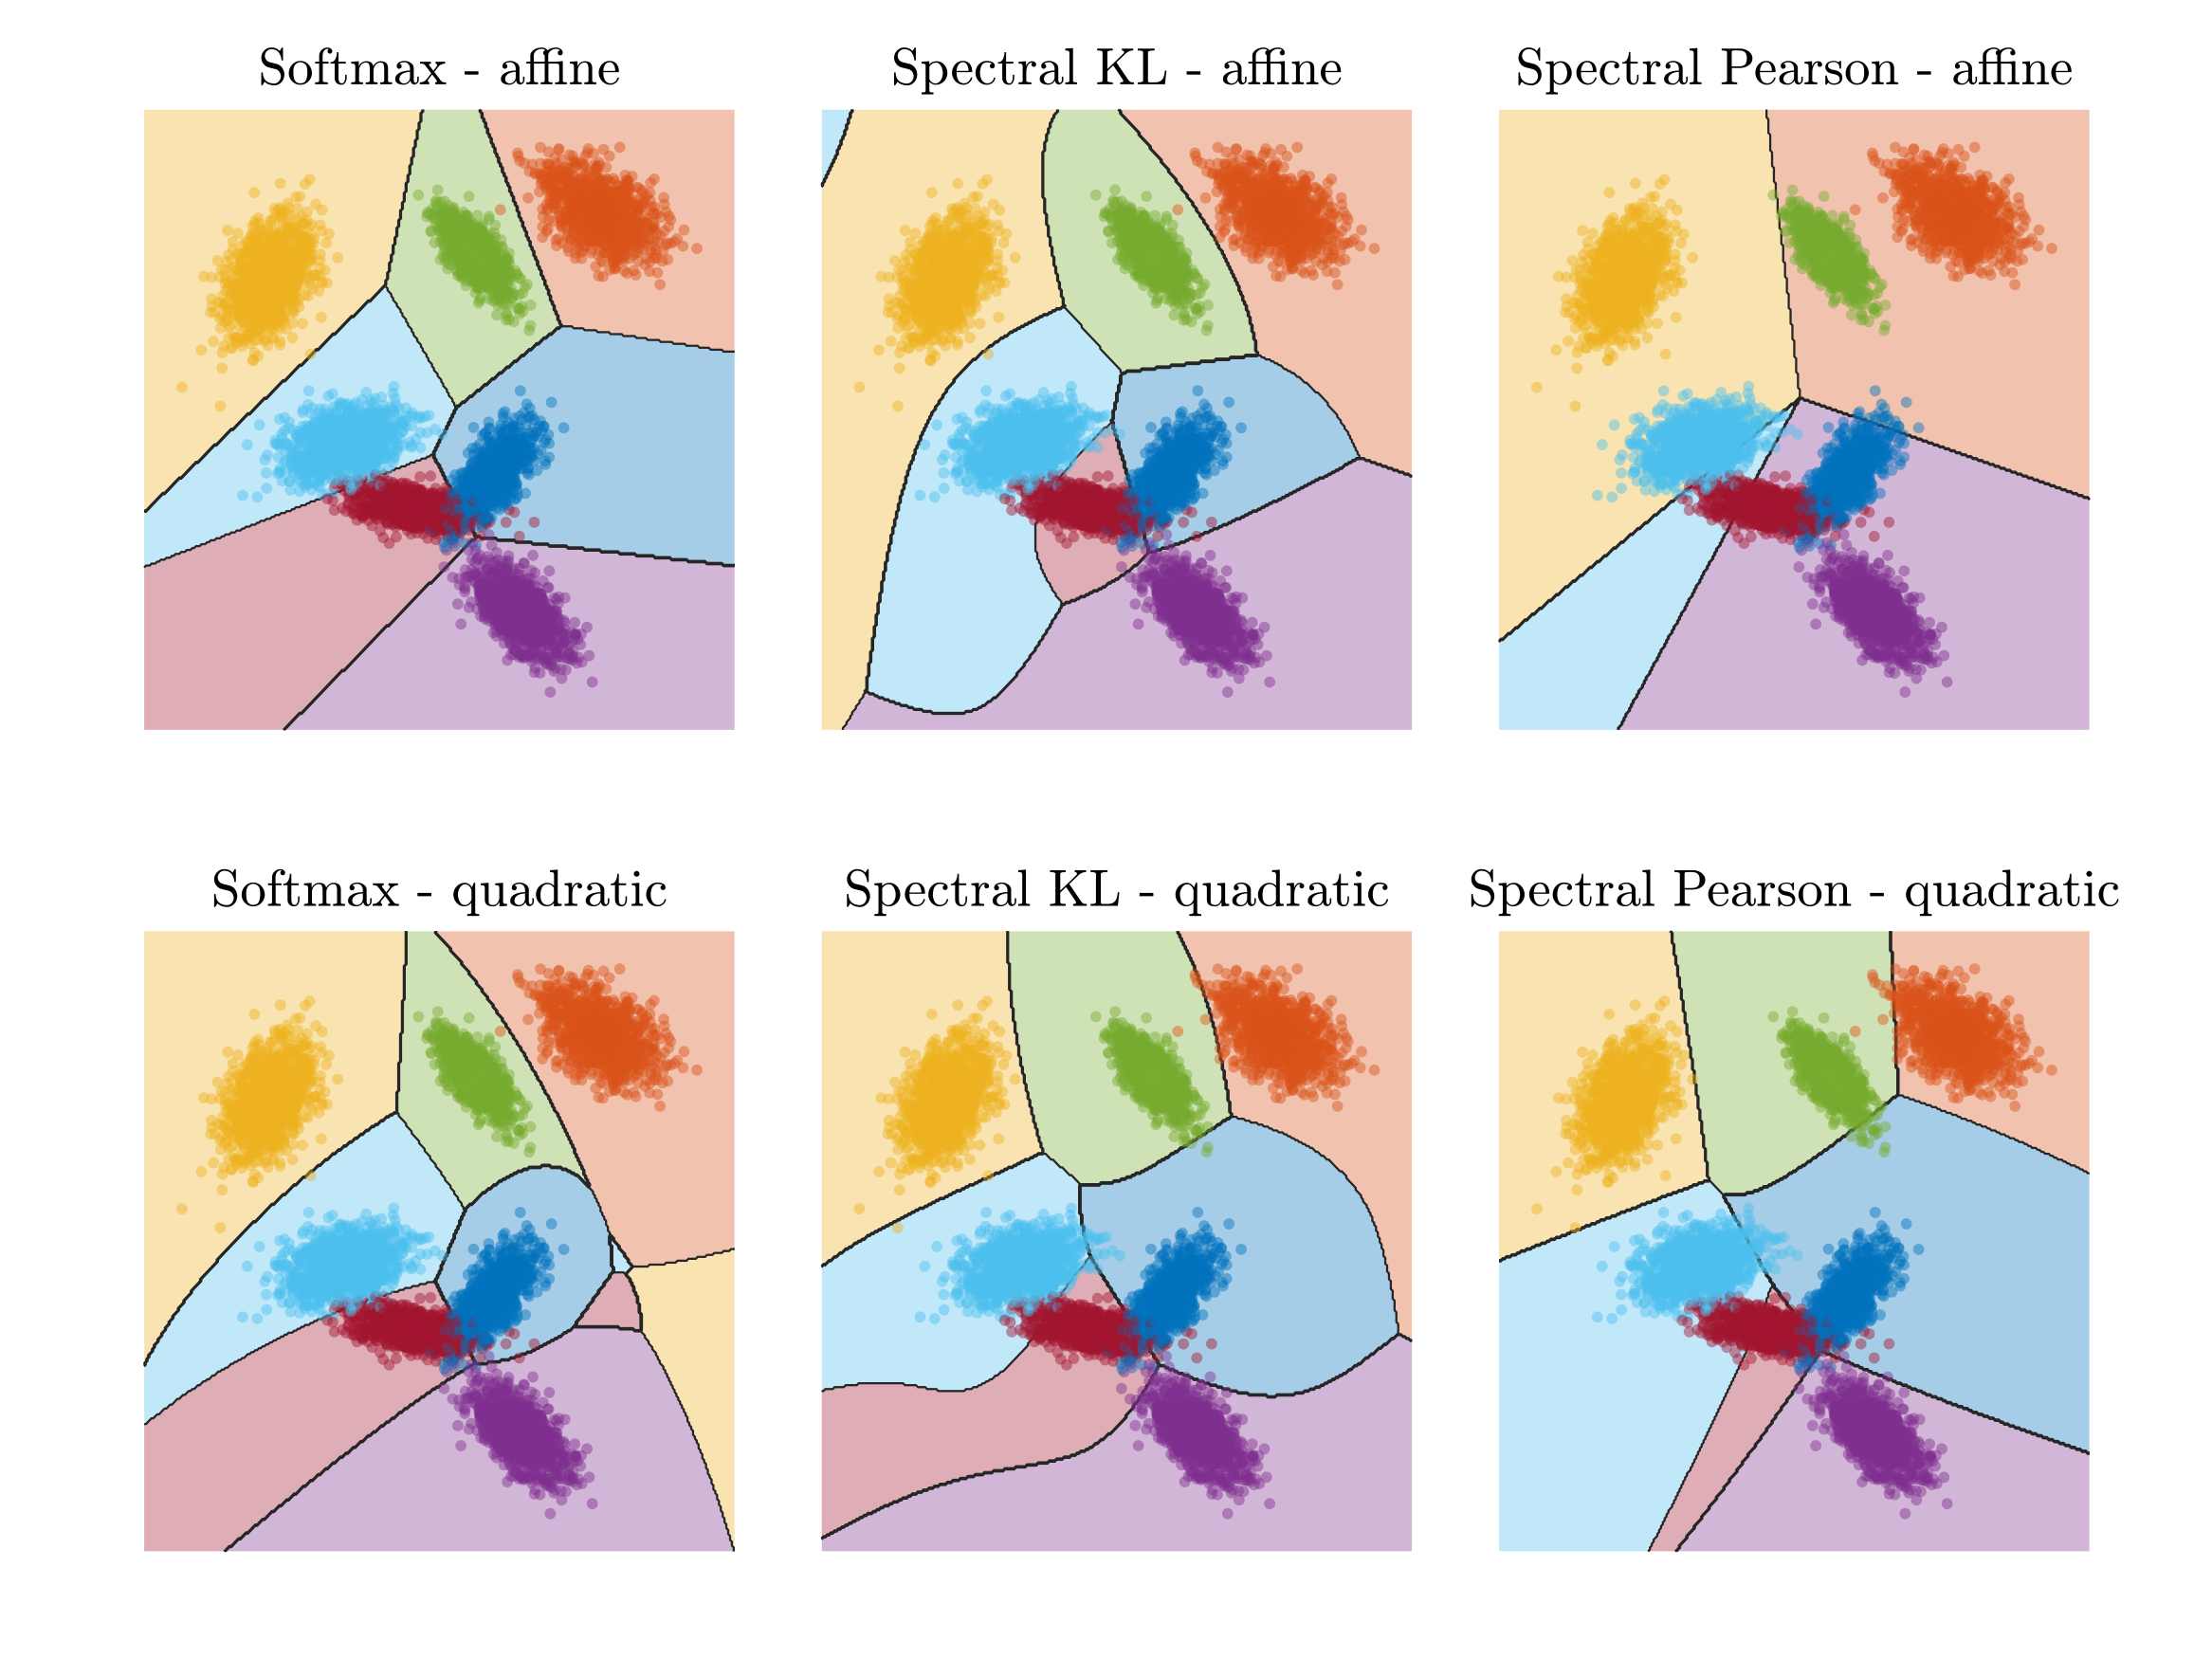 So sánh hồi quy softmax và ước lượng phổ
Cụ thể, với $f(t) = \frac{1}{2} \frac{ (t-1)^2}{ \rho t + 1-\rho}$, bài toán có biểu diễn biến phân thông qua các hàm "bình phương cộng affine", dẫn đến một bài toán dự đoán bình phương tối thiểu. Mở rộng ra, nếu có thể viết $f(t) = \frac{1}{2} \int_0^1 \frac{ (t-1)^2}{\rho t + 1-\rho} d\nu(\rho)$, thì bài toán trở thành một chuỗi liên tục các bài toán bình phương tối thiểu song song.
Từ lý thuyết đến công thức dạng đóng
Với mô hình tuyến tính $u(\rho,x) = \theta(\rho)^\top \varphi(x)$, lời giải tối ưu cho tham số $\theta(\rho)$ là:
$$\theta(\rho) = ( \rho \Sigma_p + (1-\rho) \Sigma_q)^{-1} ( \mu_p ,- \mu_q)$$
Vấn đề là phải đảo ma trận này với mọi $\rho \in [0,1]$ — điều không khả thi trong thực tế. Giải pháp là phân rã trị riêng suy rộng của cặp $(\Sigma_p, \Sigma_q)$, tương tự cách người ta xử lý nhiều giá trị tham số điều chuẩn trong hồi quy ridge.
Nhờ đó, phân kỳ mới rút gọn thành một công thức cực kỳ gọn gàng:
$$F(p|q,\varphi) = \sum_{i=1}^m \big( ( \mu_p , – \mu_q)^\top v_i \big)^2 \frac{f(\lambda_i)}{(\lambda_i-1)^2}$$
Điểm đáng kinh ngạc: dù từng bài toán bình phương tối thiểu riêng lẻ có thể mất ổn định khi $\rho \to 0$ hoặc $\rho \to 1$, sau khi tích phân, ước lượng trở nên ổn định với mọi hàm $f$ mà $t \mapsto f(t)/(t-1)^2$ bị chặn.
Lợi ích: giảm phương sai trong trường hợp ít dữ liệu
So sánh trực tiếp với phương pháp biến phân truyền thống, kết quả cho thấy sự đánh đổi rõ ràng:
- Khi có nhiều quan sát: phương pháp biến phân nhỉnh hơn nhờ độ chệch thấp
- Khi ít quan sát: phương sai tăng vọt khiến phương pháp biến phân thua kém, và phương pháp phổ trở nên vượt trội
Kết quả này được chứng minh cả bằng phân tích lý thuyết (dùng lý thuyết ma trận ngẫu nhiên và định lý minimax Gaussian) lẫn mô phỏng thực nghiệm.
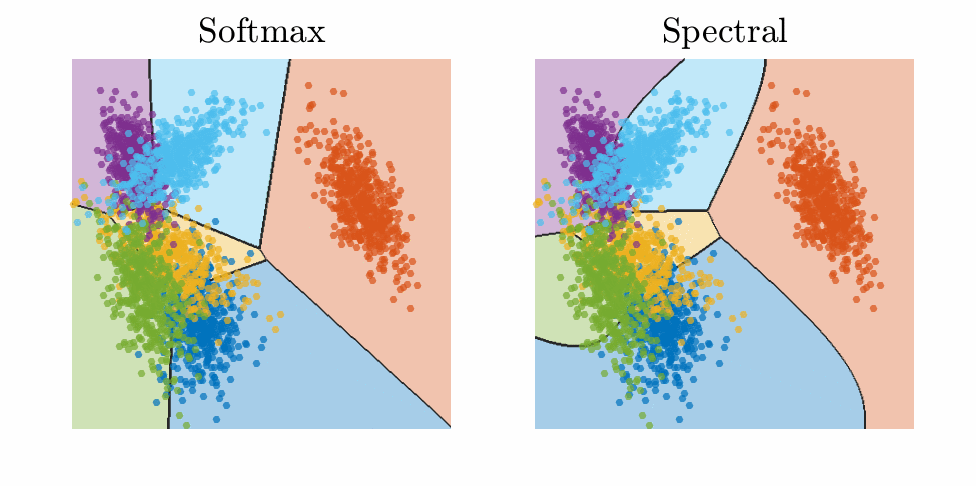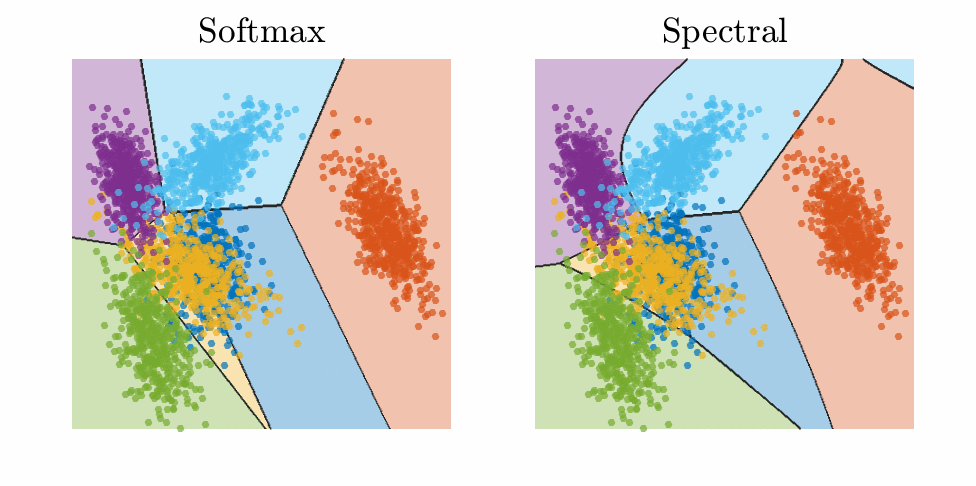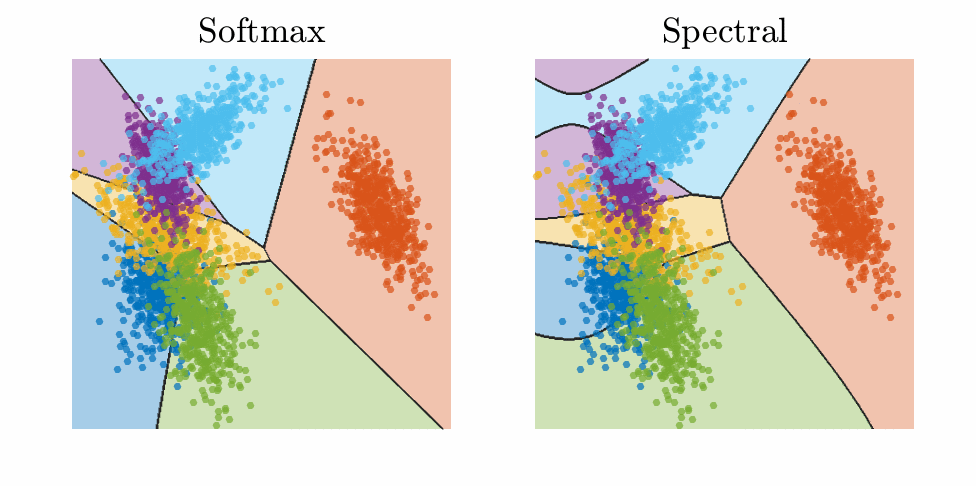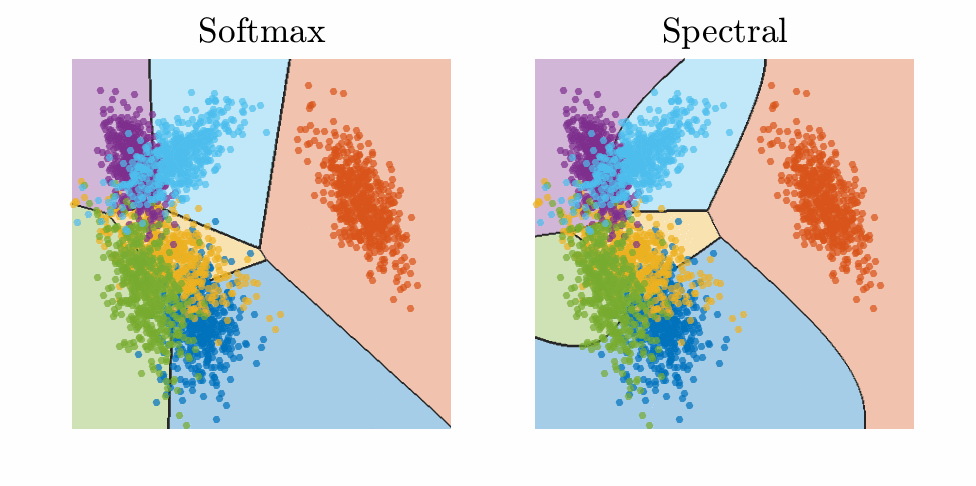 So sánh các ước lượng mật độ có điều kiện
Hệ quả bất ngờ: công thức dạng đóng cho hồi quy softmax
Điều thú vị nhất có lẽ là hệ quả nằm ngoài dự tính. Khi áp dụng khung này cho thông tin tương hỗ (mutual information) — tức bài toán ước lượng mật độ có điều kiện $\log p(x_2|x_1)$ với $\mathcal{X}_2$ hữu hạn — phương pháp cho ra một công thức dạng đóng tương đương với hồi quy softmax.
Về độ phức tạp tính toán, lợi thế là rất lớn. Với $k$ lớp và vector đặc trưng chiều $d$:
- Hồi quy softmax bằng phương pháp Newton: $O( nd^2 k^2 + d^3 k^3)$ cho mỗi vòng lặp
- Ước lượng dạng đóng mới: chỉ $O(d^2 n + kd^3)$ cho một phép phân rã trị riêng duy nhất
Học đặc trưng và mở rộng quy mô
Mô hình tuyến tính là điểm khởi đầu, nhưng bài học từ deep learning cho thấy cần học đặc trưng theo cách đầu-cuối. Vì $F(p|q,\varphi)$ là hàm lồi theo các moment của $\varphi$, ta có thể áp dụng thuật toán minorization-maximization (MM) — tương tự thuật toán EM — để tối ưu hóa đồng thời cả đặc trưng lẫn tham số.
Điều này cho phép tái sử dụng nhiều thủ thuật tính toán hiệu quả đã phát triển cho EM, chẳng hạn online EM, giúp mở rộng quy mô cho mạng nơ-ron lớn và lượng dữ liệu khổng lồ.
Kết luận và triển vọng
Khung phương pháp mới này mở ra một hướng đi đầy hứa hẹn: thay thế hàm mất mát cross-entropy và log-sum-exp ở lớp cuối của mạng nơ-ron bằng các ước lượng phổ ổn định hơn, đặc biệt trong các tình huống ít dữ liệu — vốn là điểm yếu cố hữu của các mô hình học sâu hiện đại.
Với độc giả quan tâm đến học máy và tối ưu hóa, đây là một ví dụ điển hình cho thấy những công cụ tưởng chừng "cũ kỹ" như bình phương tối thiểu và đại số tuyến tính vẫn còn nhiều tiềm năng chưa khai phá trong kỷ nguyên deep learning.
Chi tiết đầy đủ có thể tham khảo bài báo "A Spectral Framework for Closed-Form Relative Density Estimation" của Francis Bach, dự kiến công bố tại hội nghị NeurIPS.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Khi cộng đồng lập trình viên dần lụi tàn: Nếu chúng ta không dừng lại giúp nhau, ta sẽ trở thành gì?
27 tháng 9, 2026