
Pipeline học máy "gian lận" mà cross-validation không hề phát hiện
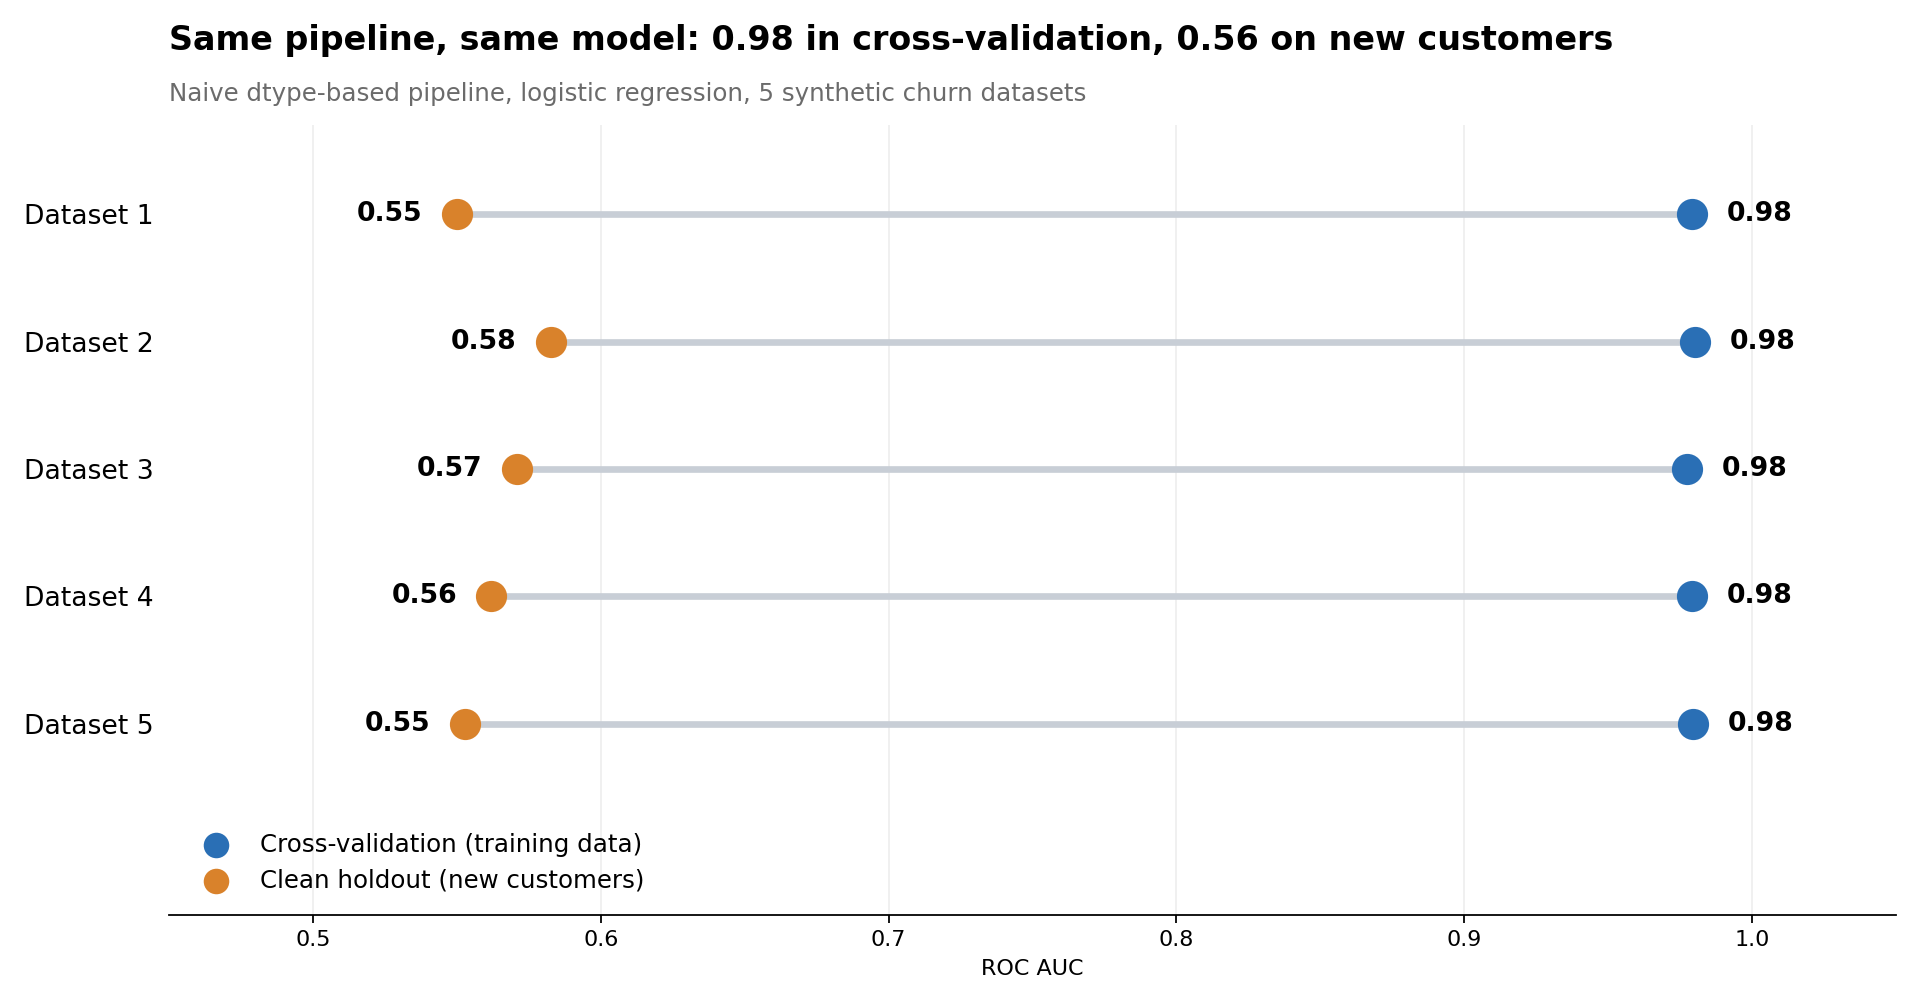
Một pipeline scikit-learn gọn gàng đạt AUC 0,98 trên cross-validation nhưng chỉ còn 0,56 khi gặp khách hàng mới. Nguyên nhân là cột ID rò rỉ nhãn, ngày tháng lưu dạng chuỗi và giá trị thiếu mang thông tin — những lỗi mà kiểm định chéo thông thường không thể nhìn thấy.
Pipeline học máy "gian lận" mà cross-validation không hề phát hiện
Tóm tắt: Một pipeline scikit-learn gọn gàng đạt AUC 0,98 trên cross-validation nhưng chỉ còn 0,56 khi gặp khách hàng mới. Nguyên nhân là cột ID rò rỉ nhãn, ngày tháng lưu dạng chuỗi và giá trị thiếu mang thông tin — những lỗi mà kiểm định chéo thông thường không thể nhìn thấy.
 Minh họa pipeline học máy
Pipeline mà ai cũng viết
Nếu đã dùng scikit-learn một thời gian, hẳn bạn từng viết đoạn pipeline này: cột số thì điền khuyết rồi chuẩn hóa, mọi cột còn lại thì điền khuyết rồi one-hot encoding. Cột được phân luồng theo kiểu dữ liệu (dtype), nên nó chạy được trên gần như mọi bảng mà không cần bạn nhìn kỹ.
def auto_pipeline(model):
    num = make_column_selector(dtype_include="number")
    cat = make_column_selector(dtype_exclude="number")
    pre = ColumnTransformer([
        ("num", make_pipeline(SimpleImputer(strategy="median"), StandardScaler()), num),
        ("cat", make_pipeline(SimpleImputer(strategy="most_frequent"),
                              OneHotEncoder(handle_unknown="ignore")), cat)])
    return make_pipeline(pre, model)
Đoạn code ngắn, dễ tái sử dụng và dễ tin tưởng — và chính sự dễ tin đó là vấn đề. Tác giả bài viết gốc đã cố tình "phá" nó để xem nó âm thầm sai ở đâu.
Bốn cái bẫy được cài sẵn
Toàn bộ dữ liệu là dữ liệu tổng hợp do một script Python tạo ra: bảng dự đoán khách hàng rời bỏ (churn) với 8.000 dòng mỗi tập (6.000 dòng huấn luyện, 2.000 dòng holdout sạch đại diện cho "khách hàng mới"). Có 5 tập độc lập với các seed từ 0 đến 4, kết quả báo cáo là trung bình cộng.
Bốn cái bẫy mà một pipeline dựa trên dtype không thể nhìn thấy:
- Vùng miền lưu dạng số: cột
region_codechứa số nguyên từ 1 đến 12, nhưng mỗi vùng ảnh hưởng đến churn theo cách khác nhau và không theo thứ tự. Pipeline lại chuẩn hóa nó như một đại lượng đo lường. - Giá trị thiếu mang thông tin: cột
support_callsbị thiếu ở khoảng 45% khách hàng rời bỏ nhưng chỉ 8% ở nhóm ở lại. Điền khuyết bằng trung vị sẽ xóa sạch tín hiệu này. - Ngày tháng lưu dạng văn bản:
signup_datelà chuỗi "YYYY-MM-DD", nên nó biến thành one-hot cho từng ngày riêng biệt (1.931 giá trị riêng biệt trong 6.000 dòng). - ID rò rỉ nhãn: trong dữ liệu huấn luyện,
customer_idđược gán gần như theo thứ tự kết quả — mô phỏng cách thứ tự xuất dữ liệu hoặc mốc thời gian có thể tương quan với kết quả trong hệ thống thực tế. Trong holdout sạch, ID không liên quan gì đến churn.
Tác giả thử nghiệm pipeline ngây thơ, pipeline thêm từng bản sửa một, và cả bốn bản sửa cùng lúc — với hồi quy logistic và gradient boosting.
Điểm số biết nói dối
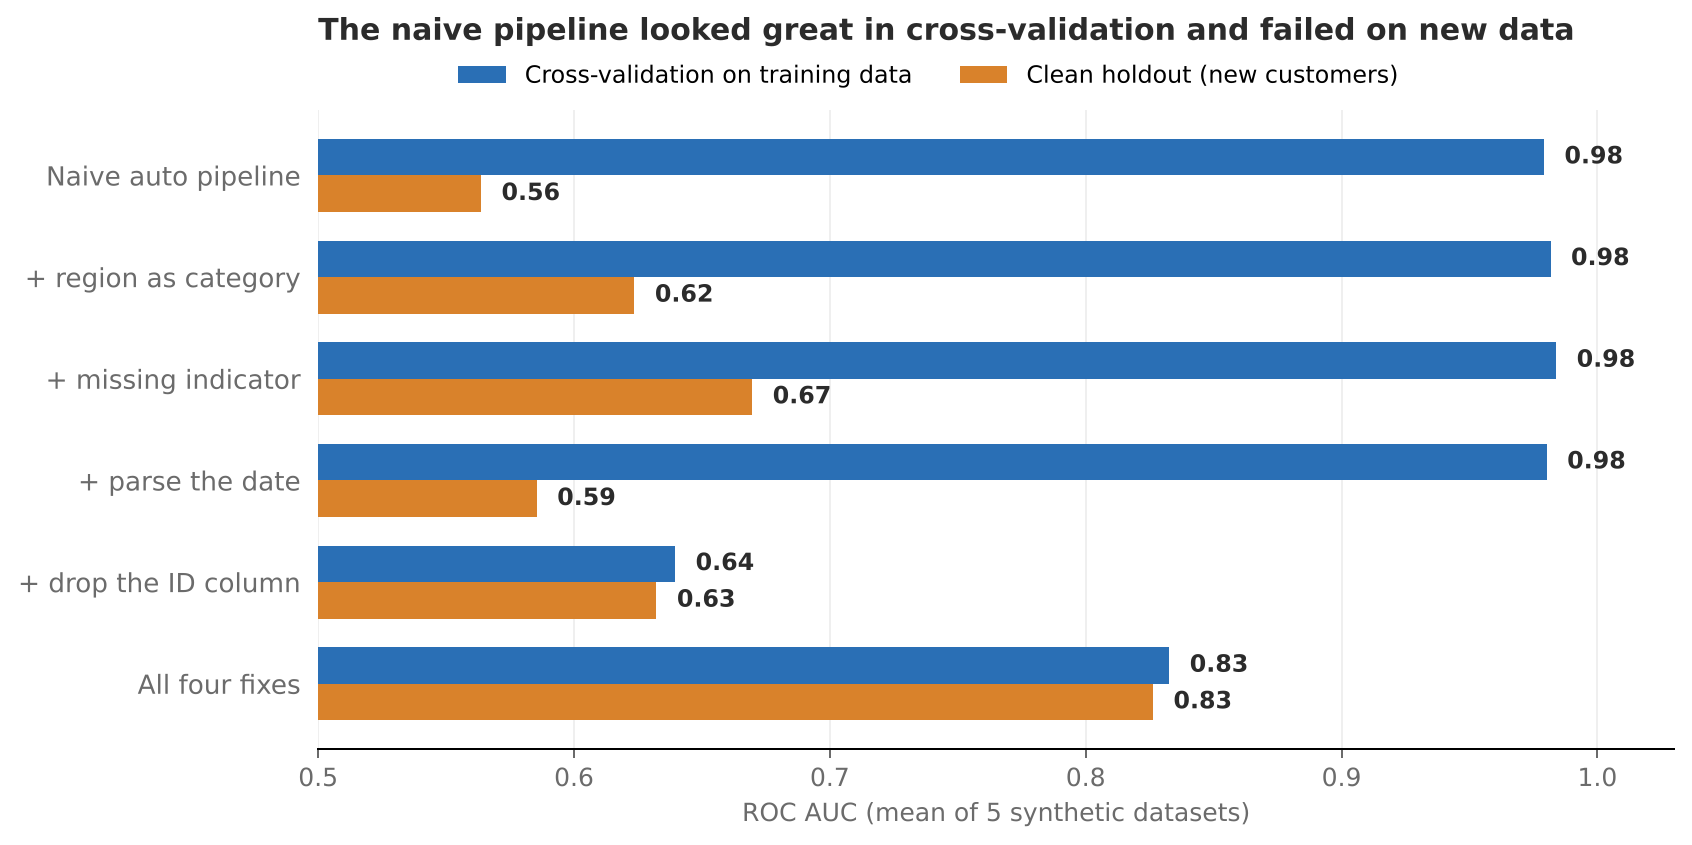
Kết quả cho thấy cross-validation giữ ở mức gần 0,98 cho đến khi cột ID bị loại bỏ. Chỉ khi đó nó mới khớp với những gì dữ liệu mới thể hiện.
| Phiên bản | AUC cross-validation | AUC holdout |
|---|---|---|
| Pipeline tự động ngây thơ | 0,979 | 0,564 |
| + vùng miền dạng category | 0,982 | 0,624 |
| + cờ báo giá trị thiếu | 0,984 | 0,670 |
| + phân tích ngày tháng | 0,980 | 0,585 |
| + bỏ cột ID | 0,640 | 0,632 |
| Cả bốn bản sửa | 0,833 | 0,826 |
Pipeline ngây thơ đạt 0,979 khi kiểm định chéo 5 fold và chỉ 0,564 trên khách hàng mới. Không có gì bị lỗi, không có cảnh báo nào xuất hiện, và mọi con số đều trông như một mô hình mạnh.
 Biểu đồ so sánh điểm số
Cột ID đã biết trước đáp án
Khi xem bên trong mô hình hồi quy logistic ở seed 0, đặc trưng mạnh nhất trong số 1.940 đặc trưng chính là customer_id (hệ số tuyệt đối 5,05). Tiếp theo là các cột ngày đăng ký riêng lẻ.
Nghĩa là mô hình làm hai việc: đọc nhãn từ ID, và ghi nhớ nhiễu theo từng ngày. Vấn đề ngày tháng không phải là gặp ngày lạ — 96,7% dòng holdout có ngày cũng xuất hiện trong dữ liệu huấn luyện. Mô hình chỉ đơn giản là học thuộc chuyện gì xảy ra vào đúng những ngày đó.
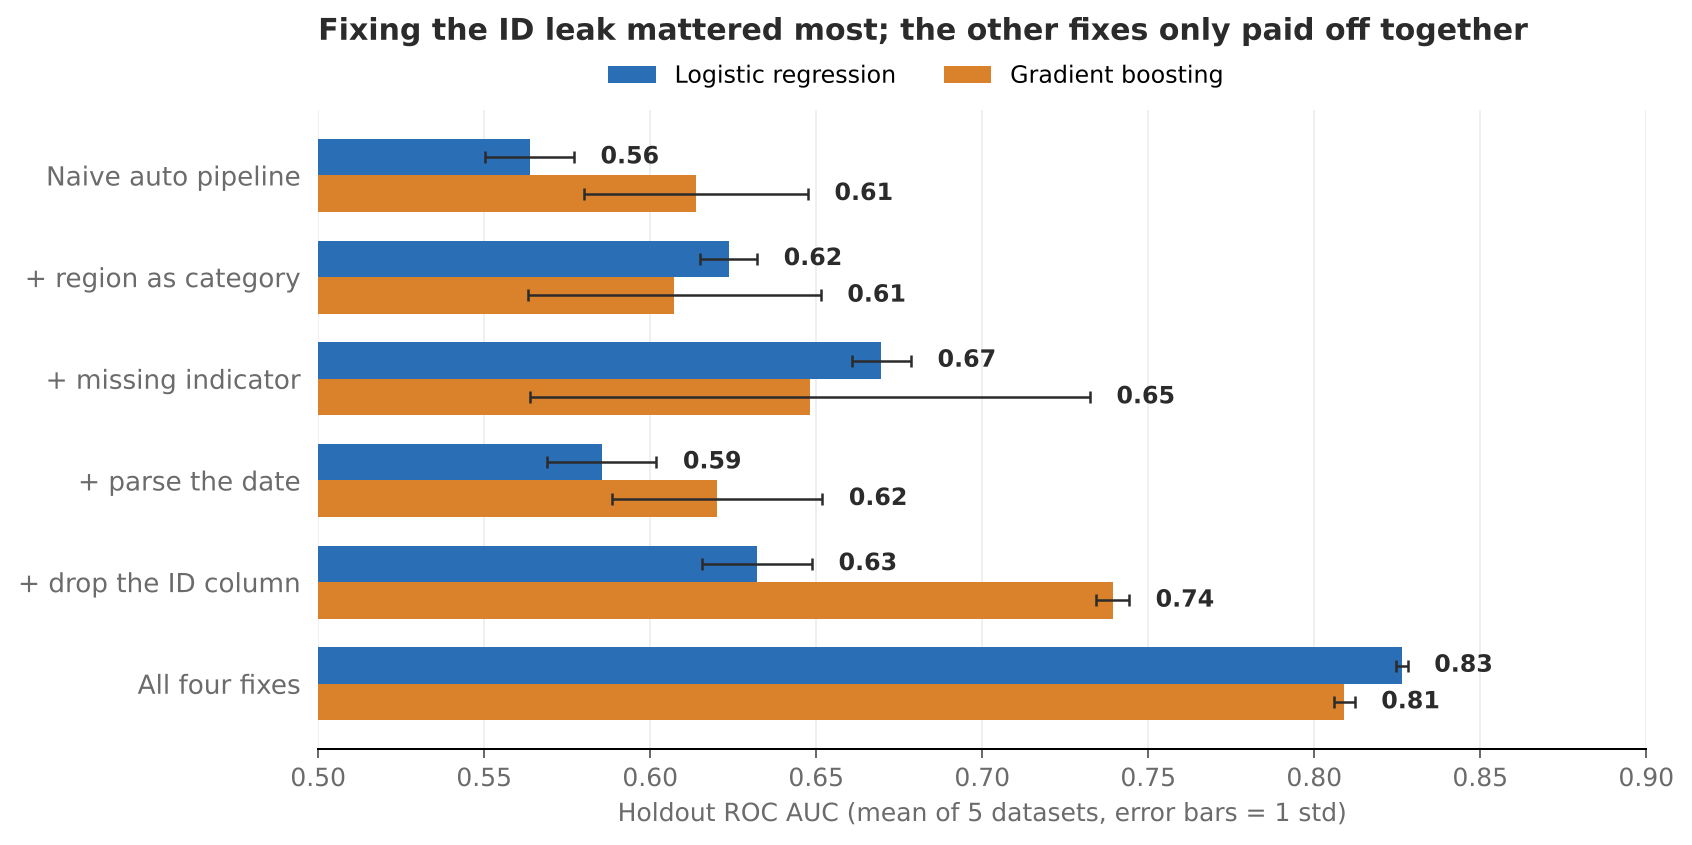
Với gradient boosting, kết quả chỉ tốt hơn chút ít: 0,614 ở pipeline ngây thơ so với 0,564 của hồi quy logistic. Bỏ cột ID giúp nó nhiều nhất (0,739), và cả bốn bản sửa đưa lên 0,809. Tuy vậy, tác giả lưu ý hai dòng kết quả không đáng tin vì nằm trong biên độ nhiễu — kết luận ổn định nhất là hiệu ứng của cột ID và kết quả khi sửa cả bốn.
Một bản sửa là chưa đủ
Nhìn vào dòng "+ bỏ cột ID": cross-validation trở nên trung thực (0,640 so với 0,632 trên dữ liệu mới), đúng như kỳ vọng. Nhưng AUC holdout chỉ 0,632 vì ba vấn đề còn lại vẫn nằm đó.
Cờ báo giá trị thiếu mang lại cải thiện lớn nhất cho hồi quy logistic (từ 0,564 lên 0,670). Chuyển vùng miền sang category giúp đạt 0,624. Phân tích ngày tháng giúp một chút (0,585). Chỉ khi kết hợp cả bốn mới đạt 0,826 — lúc này điểm cross-validation trung thực (0,833) và điểm holdout cuối cùng mới đồng thuận với nhau.
Dạy pipeline tự kiểm tra chính mình
Với những người xây dựng công cụ tự động cho người không biết lập trình, lời khuyên "nhớ kiểm tra rò rỉ" không phải là một giải pháp. Các bước kiểm tra phải tự chạy. Mỗi cái bẫy kể trên đều để lại dấu vết thống kê, nên tác giả viết một hàm quét bảng dữ liệu trước khi mô hình hóa và in ra cảnh báo bằng ngôn ngữ dễ hiểu.
Hàm audit_table kiểm tra bốn thứ:
- Cột gần như toàn giá trị duy nhất và tự dự đoán được mục tiêu (AUC lệch xa 0,5) → nghi ngờ ID rò rỉ.
- Cột số có ít giá trị riêng biệt nhưng hiệu ứng không tuyến tính → nên xử lý như category.
- Cột có giá trị thiếu mà tỉ lệ mục tiêu chênh lệch lớn giữa nhóm thiếu và nhóm không thiếu → cần thêm cờ báo thiếu.
- Cột văn bản có quá nhiều giá trị riêng biệt → one-hot sẽ ghi nhớ nhiễu, cần phân tích hoặc loại bỏ.
Chạy trên cả 5 tập dữ liệu, hàm này phát hiện chính xác bốn cột bị cài bẫy và không đụng đến các cột bình thường. Hàm thứ hai gap_warning so sánh điểm cross-validation với holdout: khi khoảng cách vượt 0,05, nó cảnh báo thẳng vào vấn đề chính — "Cross-validation (0,98) cao hơn nhiều so với holdout (0,56). Nghi ngờ rò rỉ hoặc ghi nhớ dữ liệu."
Điểm mấu chốt không phải là các ngưỡng này hoàn hảo, mà là người không biết code không cần phải biết một ID bị rò rỉ trông thế nào — công cụ sẽ nói cho họ bằng một câu.
 Minh họa kiểm tra dữ liệu
Những điểm còn hạn chế
Tác giả thẳng thắn nêu ra các giới hạn của thử nghiệm:
- Chỉ một nguồn dữ liệu tổng hợp. Hướng của các hiệu ứng có thể chuyển sang dữ liệu thực, nhưng độ lớn sẽ khác. Cần chạy lại các biến thể trên một bảng dữ liệu thực mà bạn hiểu rõ.
- Rò rỉ ID được cài đặt và phóng đại. Trong thực tế, rò rỉ thường yếu hơn. Vẫn nên kiểm tra quan hệ giữa mọi cột giống ID hoặc giống mốc thời gian với nhãn trước khi mô hình hóa.
- Chỉ hai họ mô hình. Các mô hình khác có thể phản ứng khác. Nên lặp lại với mô hình của bạn và một holdout được xây theo cách dữ liệu tương lai sẽ đến.
- Độ phân tán ở một số kết quả. Con số của gradient boosting ở hai biến thể có nhiễu lớn; cần thêm seed hoặc lặp cross-validation trước khi kết luận về một thay đổi đơn lẻ.
- Bộ kiểm tra được xây và thử trên chính dữ liệu tổng hợp. Bốn cái bẫy quá mạnh và quá sạch nên dễ phát hiện; chưa kiểm tra tỉ lệ báo động giả trên bảng thực. Hãy coi cảnh báo là gợi ý để xem xét, không phải lệnh sửa tự động.
Năm câu hỏi trước khi tin vào tự động hóa
- Có holdout trông giống dữ liệu tương lai không? Cross-validation trên dữ liệu huấn luyện không thể bắt được rò rỉ nằm ngay trong dữ liệu huấn luyện. Hãy xây holdout theo cách dữ liệu mới thực sự sẽ đến — theo thời gian hoặc từ một nguồn xuất riêng.
- Mô hình dựa nhiều nhất vào cột nào? Xem các hệ số hoặc độ quan trọng hoán vị hàng đầu. Nếu ID, số thứ tự dòng hay mốc thời gian đứng đầu, hãy dừng lại.
- Cột số có thực sự là category không? Mã, mã bưu chính và mã vùng là số nhưng không phải đại lượng đo lường.
- Giá trị thiếu có ngẫu nhiên không? So sánh tỉ lệ mục tiêu ở chỗ thiếu và chỗ có. Nếu khác biệt, hãy thêm cờ báo thiếu.
- Có cột văn bản với hàng nghìn giá trị riêng biệt không? Ngày tháng, tên và văn bản tự do cần cách xử lý riêng, không phải one-hot encoding.
Tự động hóa không phải là thẩm định. Một pipeline 8 dòng là điểm khởi đầu tốt nhưng là điểm kết thúc tồi.
Trong thử nghiệm này, nó tạo ra con số 0,98 rồi rơi xuống 0,56 trên dữ liệu mới, và phải mất bốn bản sửa riêng biệt chứ không phải một để đạt mức 0,83 trung thực. Tự động hóa tiết kiệm thời gian, nhưng nó không làm phần kiểm tra — nên hãy đưa phần kiểm tra vào chính quy trình tự động. Với những người xây công cụ cho người khác dùng, đó chính là phần cần xây.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
iPad mini màn hình OLED chính thức mở đặt trước: bước nâng cấp màn hình được chờ đợi nhất
26 tháng 10, 2026