PostHog: dùng mô hình ra quyết định thay LLM cho việc đơn giản
PostHog chia sẻ bốn cách dùng mô hình ra quyết định (decision model) như Jev trong sản phẩm thật: chặn các cuộc gọi LLM đắt đỏ, chọn mô hình rẻ nhất, xếp hạng lại kết quả tìm kiếm và thay các bộ quy tắc cứng. Bài học chính: không phải việc gì cũng cần LLM, nhưng ngưỡng tin cậy phải đặt riêng cho từng tác vụ.
Mô hình ngôn ngữ lớn (LLM) trả lời một câu đơn giản bằng vài trăm chữ "còn tùy". Mô hình ra quyết định (decision model) thì đưa ra đáp án có kiểu dữ liệu rõ ràng kèm xác suất, ví dụ "Có, 0,99".
Jina Yoon, kỹ sư tại PostHog, vừa ghi lại những gì nhóm này học được sau khi đưa mô hình ra quyết định vào sản phẩm thật. Điểm cốt lõi: một số tác vụ chỉ cần phán đoán một lượt, không cần sinh văn bản.
 Mô hình ra quyết định trả về đáp án kèm xác suất
Khác biệt nằm ở chỗ công bố độ không chắc chắn
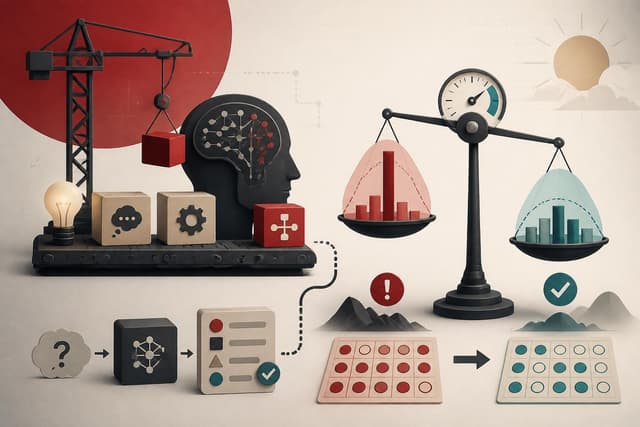
LLM trả về văn bản tự do và thường tỏ ra quá tự tin. Mô hình ra quyết định buộc phải chọn trong một tập đáp án cố định và kèm điểm xác suất. Ở một mô hình đã hiệu chỉnh tốt, các câu trả lời được 0,8 có tỉ lệ đúng khoảng 80%. Điểm 0,5 nghĩa là tung đồng xu.
Theo dữ liệu TypeSafe AI mà PostHog dẫn lại, mô hình ra quyết định rẻ hơn tới 444,6 lần và nhanh hơn 193,6 lần so với các mô hình tiên tiến nhất (frontier model).
Bốn cách dùng đã lên production
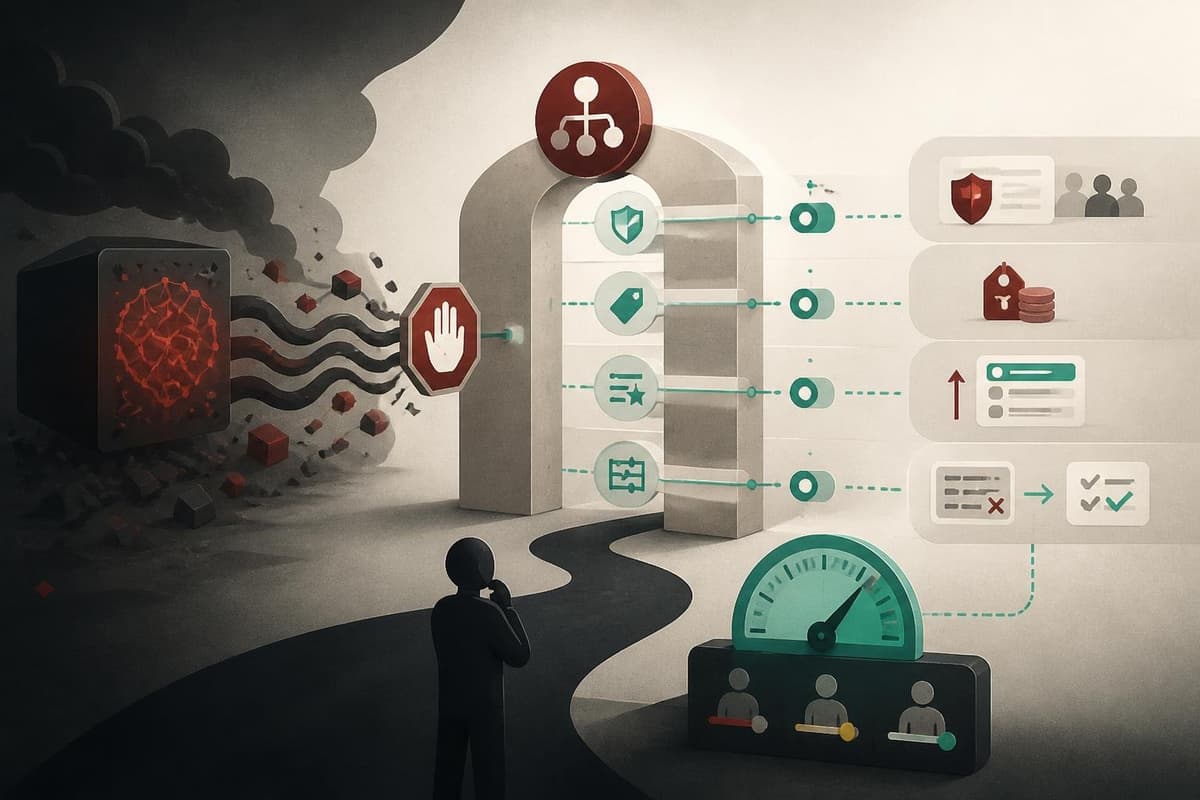
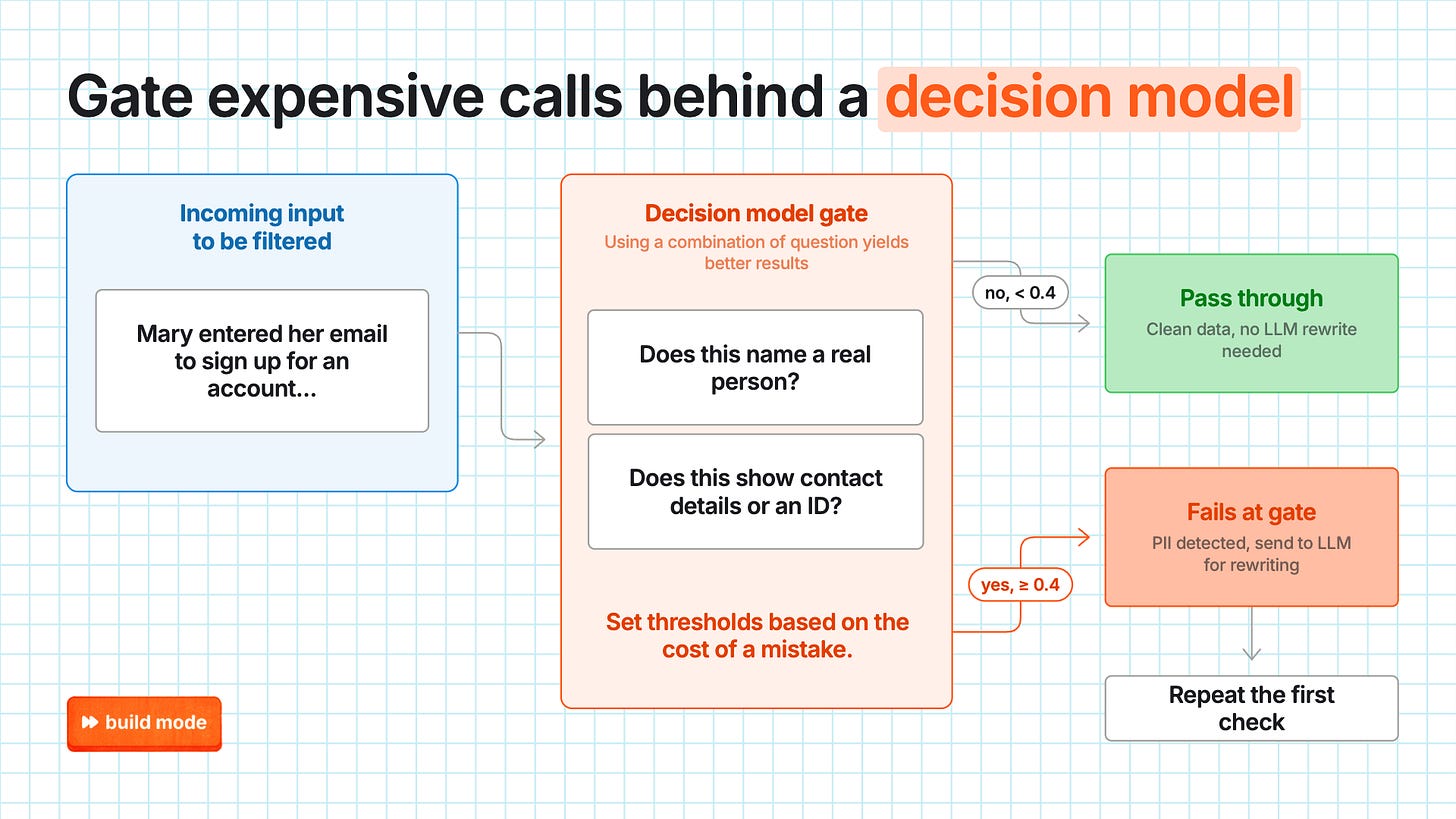
1. Chặn trước các cuộc gọi LLM đắt đỏ. Trong Replay Vision, sản phẩm xem lại và tóm tắt bản ghi phiên sử dụng, mỗi bản tóm tắt đi qua hai câu hỏi có/không: "Có nêu tên một người thật không?" và "Có lộ thông tin liên hệ hay giấy tờ tùy thân không?". Dùng hai câu hỏi hẹp thay vì một câu đã giảm số đánh dấu sai xuống khoảng một phần mười.
Nếu một trong hai câu đạt 0,4 trở lên, Gemini viết lại bản tóm tắt và kiểm tra lại. Nếu không, bản tóm tắt được coi là sạch. Trên production, 98,7% trường hợp bỏ qua hoàn toàn cuộc gọi LLM.
Ngưỡng thấp ở đây là có chủ đích. Với 0,4, một dương tính giả chỉ tốn thêm một cuộc gọi LLM. Còn một âm tính giả thì dữ liệu cá nhân bị lưu như bản sạch.
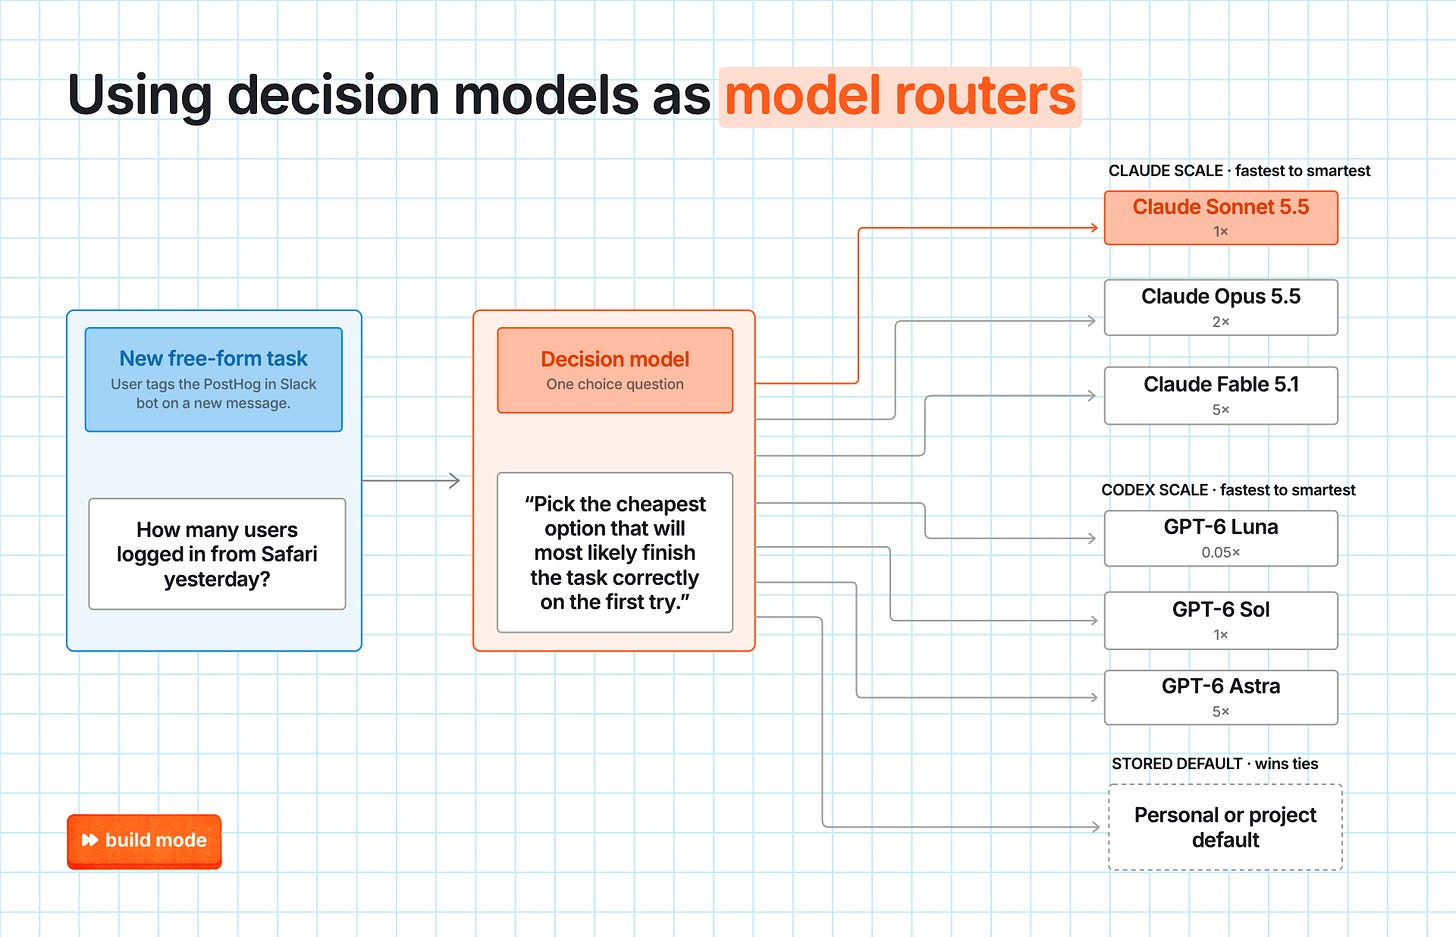
2. Dùng làm bộ định tuyến mô hình. Bot PostHog trong Slack kiểm tra xem người dùng có yêu cầu mô hình cụ thể không. Nếu không, một câu hỏi lựa chọn sẽ chọn mô hình rẻ nhất có khả năng hoàn thành tác vụ ngay lần đầu. Mỗi phương án mang một ghi chú ngắn về thế mạnh của nó, và mô hình chấm điểm yêu cầu với từng ghi chú.
Nhóm PostHog lưu ý ngưỡng không dùng lại được giữa các mô hình. Khi thử tự gộp các log giống nhau trong Error Tracking, họ thấy ngưỡng của phiên bản v1 và v2 cùng một mô hình đã khác nhau. Vì vậy ngưỡng được đặt riêng theo từng dự án và mô hình, kèm chế độ chạy song song (shadow mode) trong lúc hiệu chỉnh lại bằng dữ liệu gán nhãn tay.
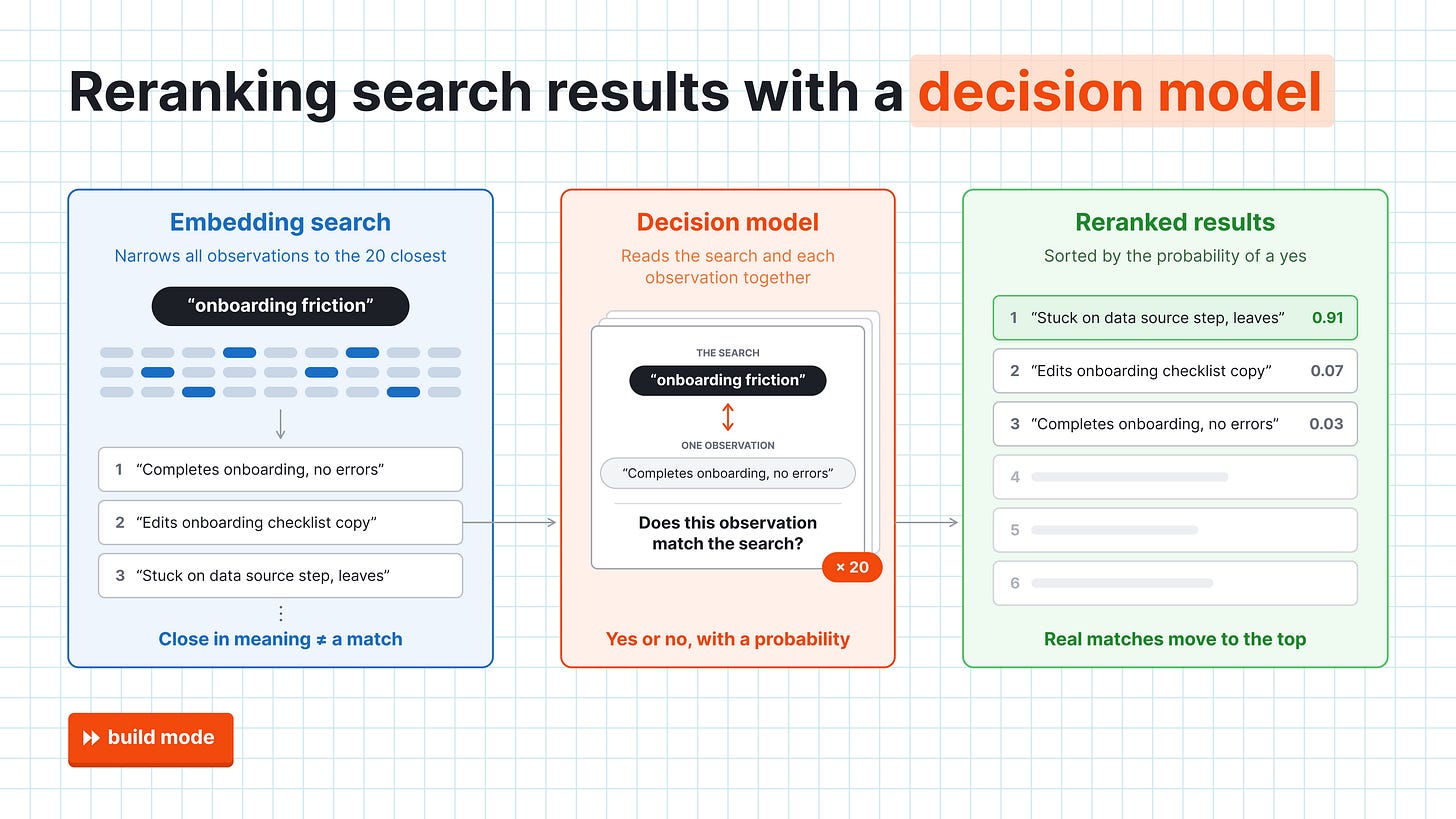
3. Kiểm tra ở mức bề mặt. Với tìm kiếm theo chủ đề như "onboarding friction", PostHog dùng embedding để lấy danh sách phiên ban đầu, rồi để mô hình ra quyết định chấm từng kết quả với câu hỏi một bước: "Bản tóm tắt này có mô tả phiên khớp với từ khóa tìm kiếm không?". Xếp hạng lại theo xác suất đó giúp chất lượng tăng khoảng 25% trên 20 truy vấn thử nghiệm.
Ngược lại, chuỗi nhiều bước thì không đáng. Trước khi có embedding, PostHog từng dùng mô hình ra quyết định xếp hạng bảng tin "Highlights" bằng hai câu hỏi nối tiếp. Một job chạy mỗi giờ gửi các yêu cầu lớn, tới 32 phiên với 12 đến 38 nghìn token mỗi phiên, làm nghẽn máy chủ mô hình và chặn cuộc gọi của các sản phẩm khác suốt nhiều giờ.
4. Thay các bộ quy tắc cứng. Công cụ chọn biểu đồ cho truy vấn SQL trước đây chạy theo quy tắc: có cột ngày, cột số và nhiều dòng thì vẽ biểu đồ đường. Giờ mô hình ra quyết định xem cả câu SQL (nếu tổ chức đồng ý) lẫn ba dòng kết quả đầu tiên để gợi ý biểu đồ phù hợp hơn, chẳng hạn biểu đồ cột chia theo trình duyệt.
 Biểu đồ do mô hình ra quyết định gợi ý
Ranh giới vẫn còn
Khi thử cho mô hình ra quyết định xếp hạng phát hiện của một tác tử đánh giá mã nguồn nội bộ, kết quả không kết luận được gì: chỉ số AUC đạt 0,52.
Mô hình Jev mặc định nhận 64 nghìn token mỗi yêu cầu và 32 nghìn token mỗi câu hỏi. Chế độ ngữ cảnh dài có thể nâng lên 262 nghìn token qua một header tùy chọn, nhưng chính TypeSafe cảnh báo chế độ này chậm hơn và kém chính xác hơn.
Vì vậy các tác vụ mở, cần nhiều ngữ cảnh hoặc suy luận nhiều bước vẫn nên giao cho LLM. Mô hình ra quyết định chỉ phán đoán những gì nằm ngay trước mắt, trong một lượt.
 So sánh mô hình ra quyết định và LLM
Góc nhìn
Với đội kỹ thuật ở Việt Nam đang chạy tác tử AI hoặc các tính năng có LLM, con số 98,7% là gợi ý đáng thử. Rất nhiều cuộc gọi mô hình đắt tiền chỉ để trả lời một câu có/không. Chèn một lớp lọc rẻ phía trước vừa giảm chi phí vừa giảm độ trễ.
Bài học về ngưỡng cũng quan trọng không kém. Ngưỡng phải đặt theo cái giá của từng loại sai, và phải làm lại mỗi khi đổi mô hình. Cách làm này khớp với hướng tự xây dựng mô hình ra quyết định và các mô hình ra quyết định nhỏ, mã nguồn mở đã có. Điểm mới ở đây là bằng chứng từ production: ranh giới nằm ở suy luận nhiều bước, và vượt qua ranh giới đó thì hỏng cả hệ thống chứ không chỉ sai kết quả.
Nguồn: newsletter.posthog.com · Quy trình biên tập