Strands Decider 2B: mô hình quyết định mã nguồn mở 2 tỷ tham số
Strands Labs phát hành Strands Decider 2B, mô hình quyết định mã nguồn mở 2 tỷ tham số chạy được trên CPU hoặc GPU cục bộ. Mô hình chọn đáp án giữa các lựa chọn cho trước và trả kèm điểm tin cậy, hướng tới các tác vụ điều phối tác tử (agent) với độ trễ vài chục đến vài trăm mili giây.
Strands Labs vừa bổ sung Strands Decider 2B vào danh mục thử nghiệm agentic AI của mình. Điểm khác biệt nằm ở chỗ đây không phải mô hình ngôn ngữ lớn (LLM) biết sinh văn bản, mà là mô hình quyết định (decision model), chỉ chọn đáp án trong một tập lựa chọn cho trước.
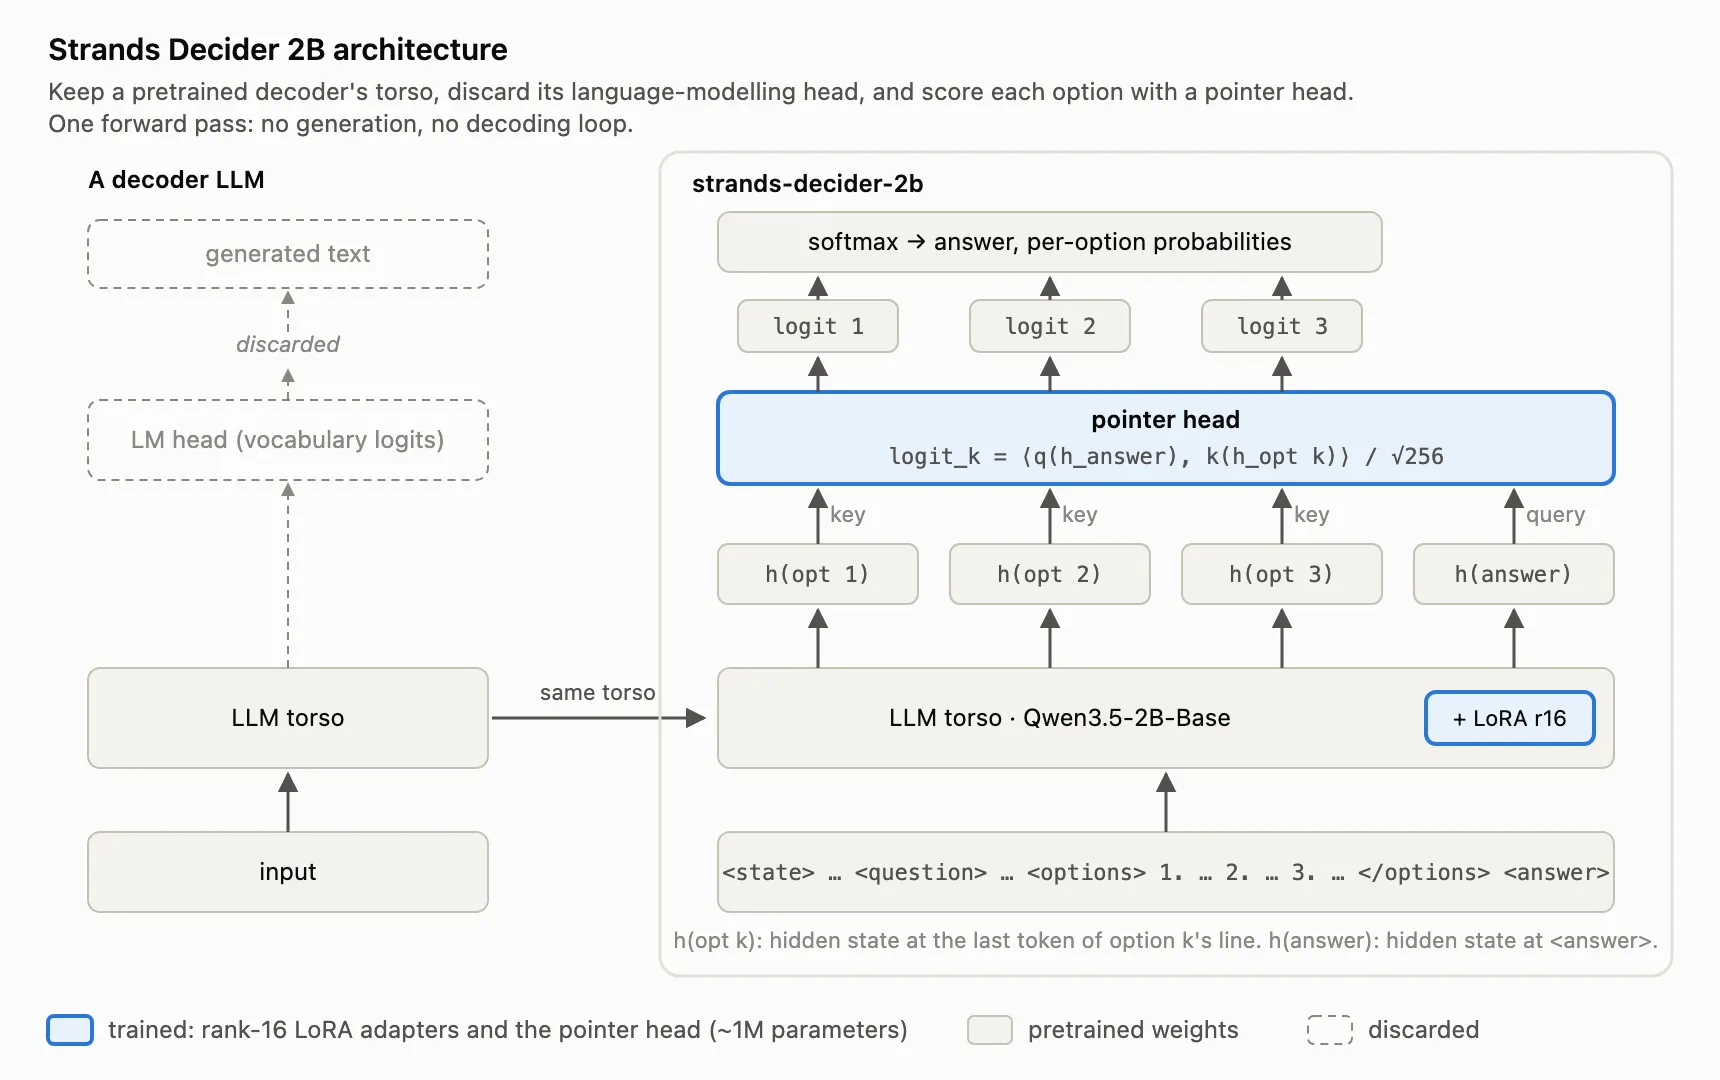 Kiến trúc mô hình Strands Decider 2B
Mô hình quyết định là gì
Mô hình quyết định còn gọi là mô hình hệ một (system one model), nhận được nhiều chú ý từ khi TypeSafe AI ra mắt Jev hồi đầu tháng. Thay vì sinh ra nội dung bất kỳ, mô hình chỉ trả lời dạng chọn lựa hoặc chấm điểm số.
Ví dụ: câu "turn on the lights" có liên quan đến máy pha cà phê không, trả lời có hoặc không. Hoặc: câu "sihamba ngokushesha" thuộc ngôn ngữ nào trong ba lựa chọn tiếng Anh, Zulu, Hà Lan. Kiểu thứ hai là chấm điểm, ví dụ đánh giá sắc thái tích cực của một câu trong khoảng từ 0 đến 1.
Đổi lại sự linh hoạt, mô hình quyết định nhanh hơn và mạnh hơn ở cùng kích thước, luôn trả về một đáp án trong tập lựa chọn, và chạy được với độ trễ rất thấp.
Hạn chế cũng rõ: mô hình sinh toàn bộ đầu ra trong một lượt song song nên giải bài toán phức tạp kém hơn nhiều so với mô hình suy luận. Nó không sinh được văn bản nên không hợp với viết mã, chatbot hay tóm tắt tài liệu.
Vì sao phù hợp với tác tử
Mỗi quyết định của mô hình đi kèm điểm tin cậy (reliability score), tức mức độ chắc chắn của câu trả lời có/không. Các API suy luận của LLM tiên tiến không cung cấp điểm này.
Mô hình cũng cho phép hỏi nhiều câu về cùng một đoạn đầu vào với chi phí thấp. Hai đặc tính này hợp với các luồng công việc tác tử mà nhiều lập trình viên đang xây bằng Strands Harness SDK.
Strands Decider 2B có 2 tỷ tham số, chạy được trên CPU hoặc GPU cục bộ, trả lời trong vài chục mili giây. Độ chính xác và độ hiệu chuẩn ngang với các mô hình cùng loại mà nhóm biết.
Toàn bộ mã nguồn nằm trên GitHub, trọng số trên Hugging Face, kèm cả dữ liệu huấn luyện và script xây dựng mô hình.
Cấu trúc và hiệu năng
Nhóm phát triển lấy phần thân của một LLM đã huấn luyện trước là Qwen3.5-2B, bỏ đầu ra ngôn ngữ (LM head) để nó không sinh văn bản được nữa. Thay vào đó là một đầu con trỏ (pointer head) chấm điểm các đáp án ứng viên, chỉ hơn một triệu tham số. Phần thân được tinh chỉnh bằng bộ chuyển thể LoRA rank-16.
Đây là phiên bản kiến trúc lớn thứ hai. Bản đầu dùng slot head và cho kết quả kém hơn hẳn. Mô hình phát hành lần này là v19, sau nhiều vòng lặp.
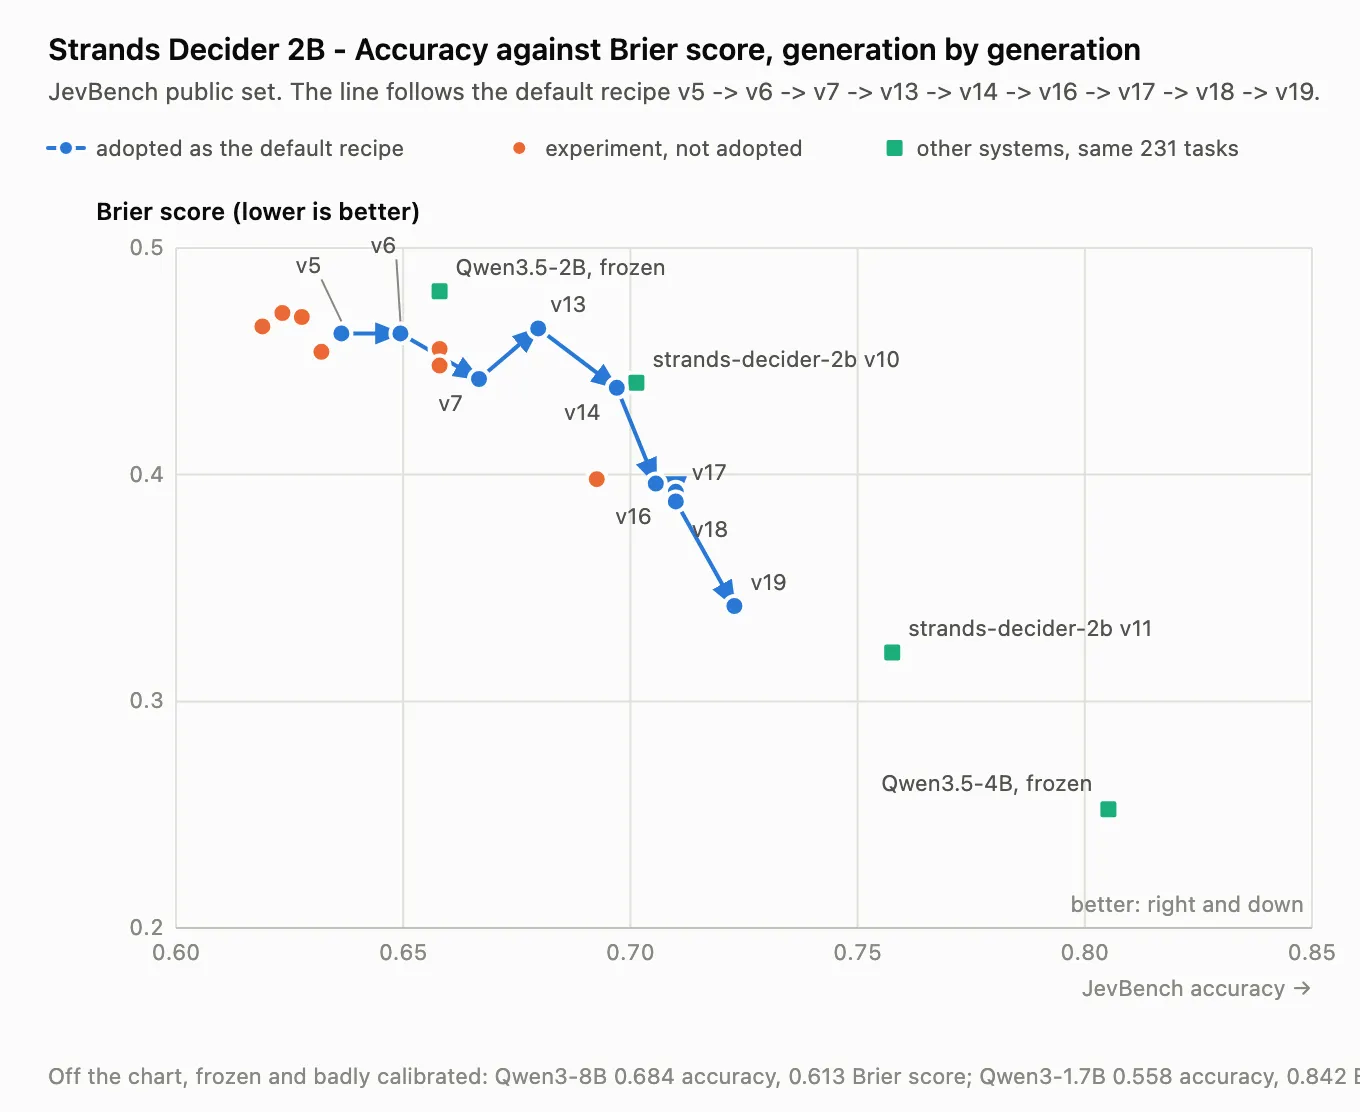 Độ chính xác và điểm Brier qua quá trình huấn luyện
Trên tập công khai của JevBench, mô hình xếp thứ 3 trong 33 mô hình lớp 2B về độ chính xác và độ hiệu chuẩn. Nếu loại các mô hình vừa hơn 2B, nó đứng đầu trong 30 mô hình. Điểm Brier dùng để đo độ hiệu chuẩn, tức độ đáng tin của điểm tin cậy.
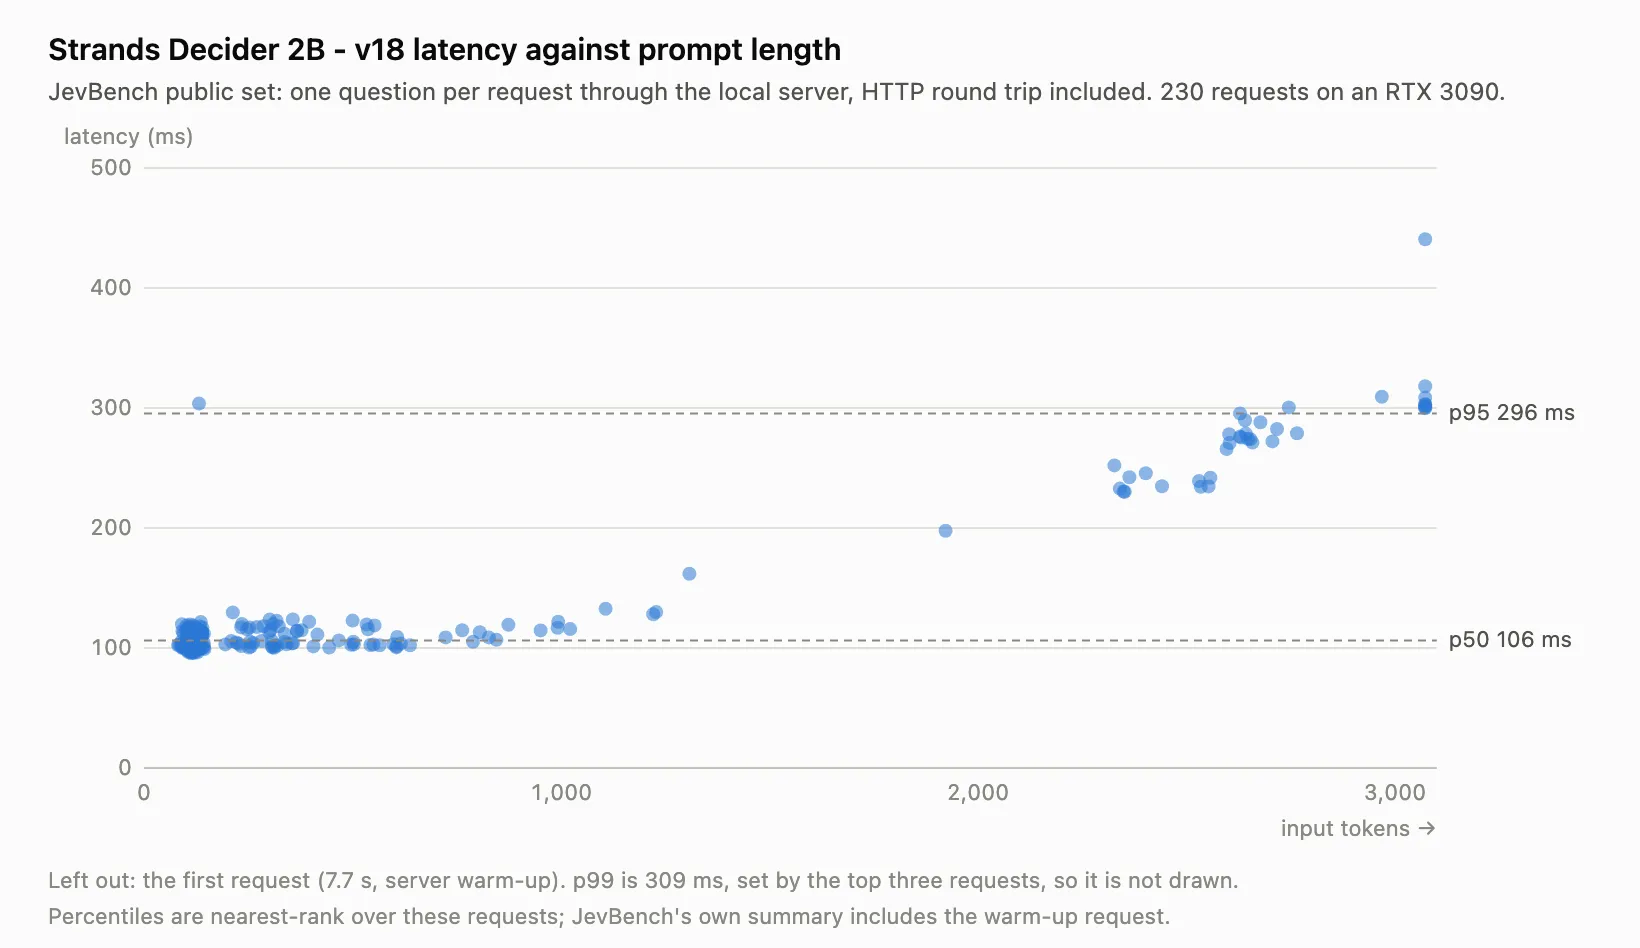 Độ trễ quyết định theo kích thước tác vụ
Về độ trễ, mô hình quyết định trong khoảng 115ms trung vị trên phần cứng phổ biến. Trên Nvidia RTX 3090 cục bộ, thời gian tăng gần như tuyến tính theo kích thước tác vụ. Trên MacBook M3, tác vụ nhỏ mất trung vị khoảng 153ms.
Chọn 2B vì mục tiêu thử nghiệm
Nhóm phát triển chọn kích thước nhỏ để khuyến khích thử nghiệm. Người dùng có thể dùng và thậm chí huấn luyện lại mô hình trên phần cứng sẵn có. 2 tỷ tham số được xem là điểm cân bằng: đủ nhỏ để thử, đủ lớn để làm việc có ích.
Mô hình xử lý đúng 100% các tác vụ dễ trên JevBench. Những bài toán này khá giống các vấn đề đơn giản mà người ta giao cho tác tử.
Dùng để làm gì
Các ứng dụng đang thấy kết quả ban đầu gồm định tuyến mô hình (model routing), chọn công cụ, đánh giá, hàng rào bảo vệ (guardrails), quản lý bộ nhớ và ngữ cảnh, phân loại chính sách.
Một hướng khác là tác tử lai: dùng LLM cho quyết định khó, dùng mô hình quyết định cho các quyết định rập khuôn dễ, giảm chi phí và độ trễ. Mô hình cũng được dùng để chơi game, tự động hóa tác vụ, đi trong mê cung.
Chạy thử trong vài dòng lệnh
Cách nhanh nhất là cài gói CLI:
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days!" \
  --choice "Which team should handle this?=billing,sales,retail"
Kết quả trả về đáp án kèm điểm xác suất cho từng lựa chọn, ở đây là billing với độ tin cậy 0.768.
Thư mục ví dụ còn có một tác tử Strands chạy cục bộ, nối với mô hình quyết định cũng chạy cục bộ, và dùng LLM mặc định từ Amazon Bedrock.
Kịch bản cố ý nhỏ: tác tử có công cụ get_weather và một lời nhắc hệ thống khiến nó hay đoán bừa. Khi người dùng hỏi "What's the weather?" mà không nói thành phố, tác tử định đoán một thành phố rồi gọi công cụ.
Trước khi công cụ chạy, mô hình quyết định đọc hội thoại và câu gọi công cụ, trả lời hai câu hỏi có/không: các giá trị tham số có dựa trên điều người dùng nói không, và có quá sớm để gọi công cụ không. Vài dòng Python biến dự đoán thành quyết định, tác tử quay lại hỏi thành phố thay vì báo thời tiết ở nơi không ai nhắc tới.
Cơ chế này là hệ thống can thiệp (intervention system) của Strands. Lớp InterventionHandler với phương thức before_tool_call chạy trước mọi công cụ và trả về một hành động có kiểu: Proceed, Deny, Confirm hoặc Guide. Guide trả quyền lại cho mô hình kèm phản hồi thay vì chặn hẳn.
Cùng cấu trúc đó dùng được cho mô hình quyết định, chính sách Cedar hay một tác tử khác. Nhóm Strands cho biết đang xây thư viện tích hợp mô hình quyết định.
Góc nhìn
Với lập trình viên Việt Nam, điểm hấp dẫn của mô hình này là chạy được trên máy cá nhân. Một chiếc laptop có GPU rời hoặc thậm chí CPU cũng đủ để thử, không cần thuê dịch vụ đám mây trả tiền theo lượt gọi.
Điều đó hợp với các bước kiểm tra rẻ nằm trong luồng tác tử, ví dụ chặn một lời gọi công cụ thiếu căn cứ trước khi nó chạm tới hệ thống thật. Vì điểm tin cậy đi kèm mỗi quyết định, nhóm phát triển có thể đặt ngưỡng và đo được độ tin của từng bước.
Cần lưu ý mô hình chỉ 2 tỷ tham số và chỉ làm một việc, chọn đáp án. Nó không thay thế LLM trong các tác vụ cần sinh nội dung. Cách dùng hợp lý là ghép hai loại: mô hình lớn lo phần khó, mô hình nhỏ lo phần lặp lại nhiều lần.
Nguồn: strandsagents.com · Quy trình biên tập