Qwenputer: Khi một mô hình ngôn ngữ mang cả CPU RISC-V trong trọng số của chính nó
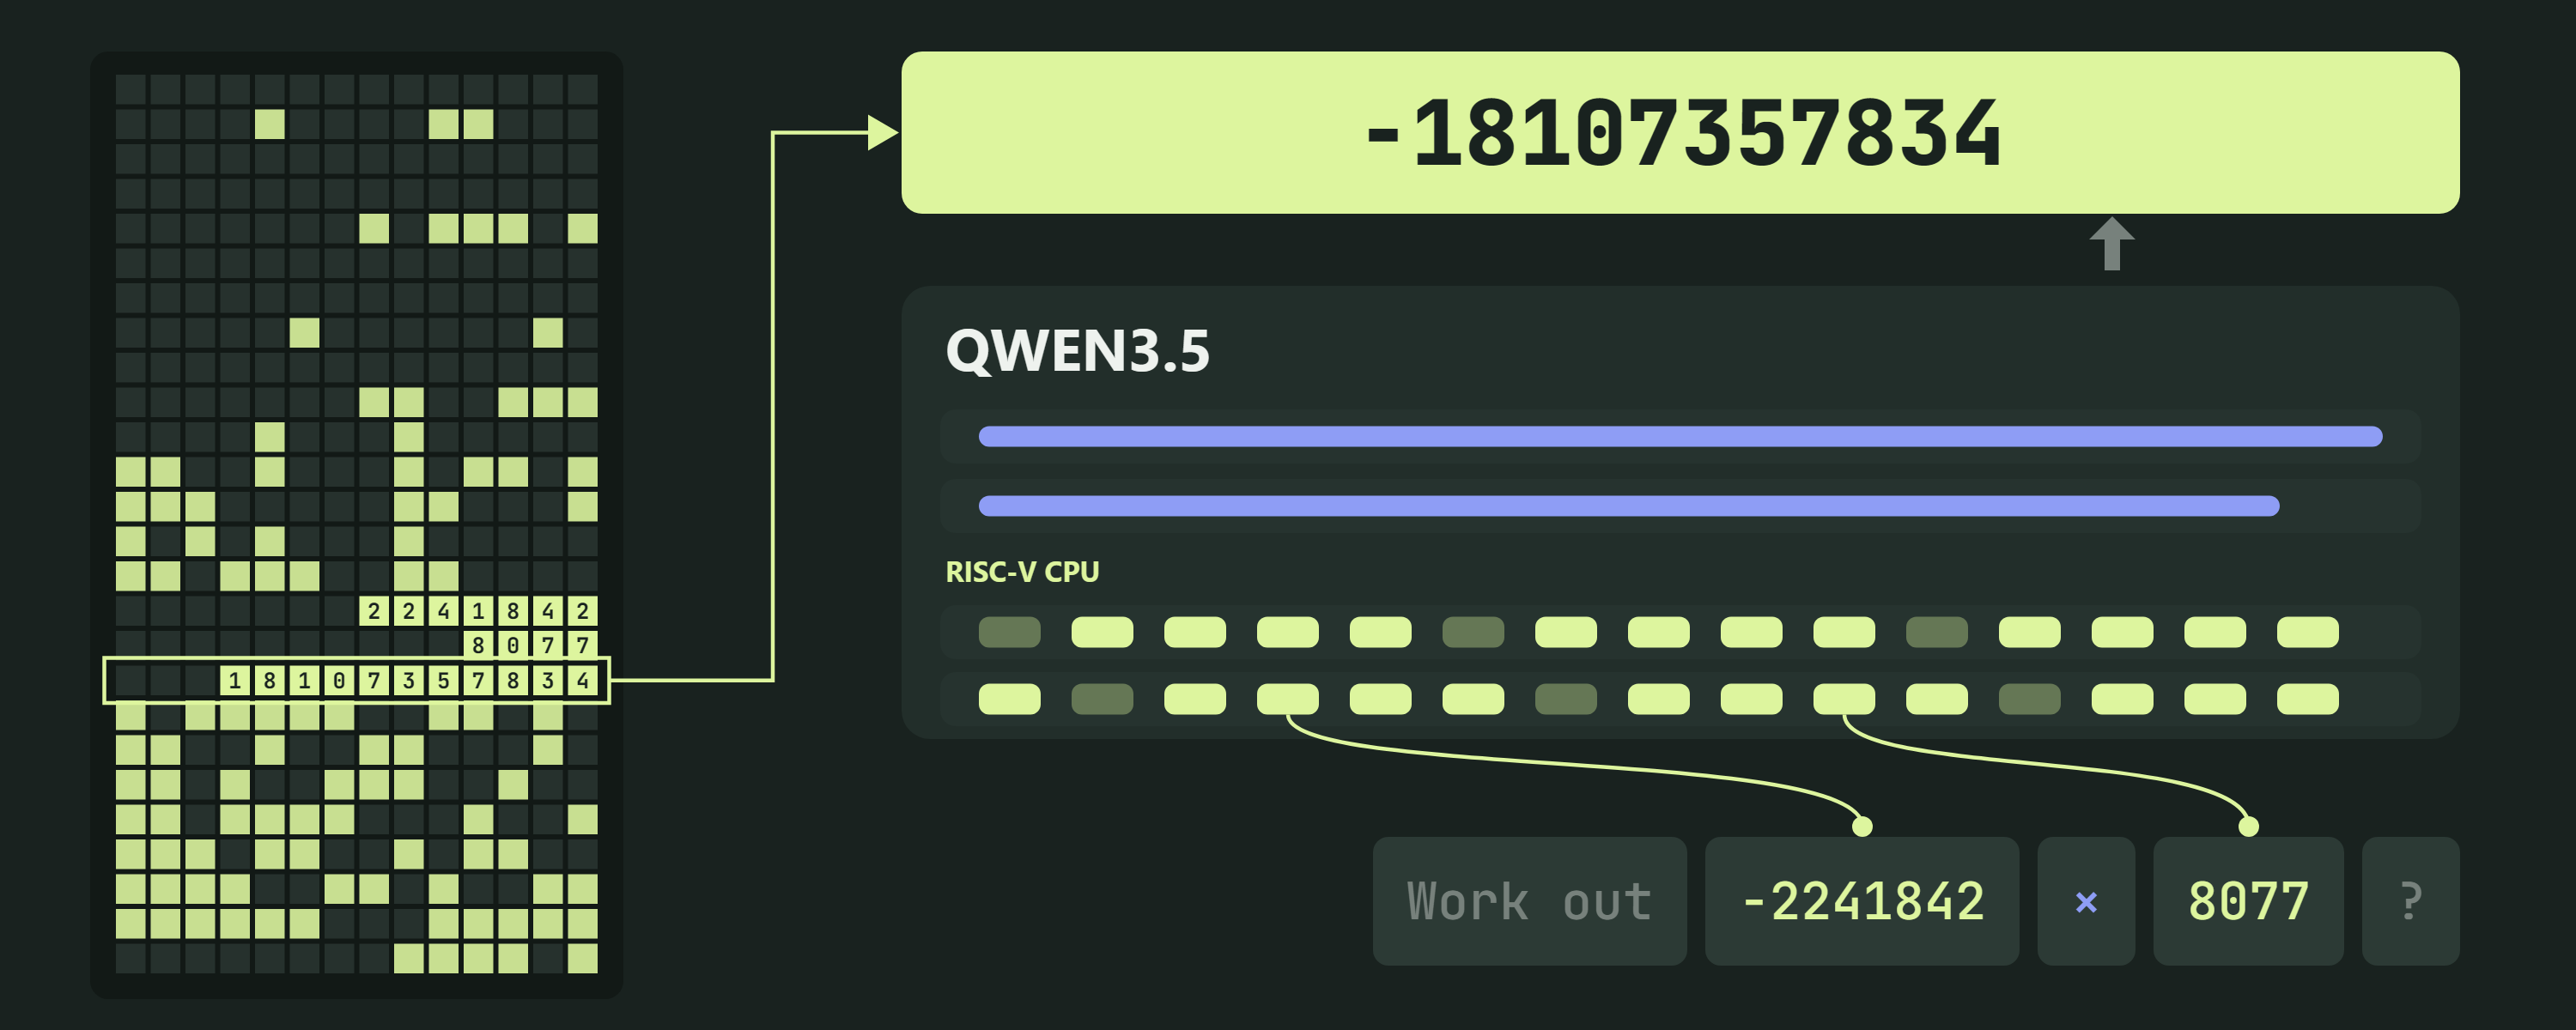
Một kỹ sư đã biên dịch thành công một lõi CPU RISC-V 32-bit hoạt động thực sự vào bên trong trọng số của mô hình Qwen3.5-4B, dùng các lớp Gated DeltaNet làm RAM. Qwenputer chạy được mã C và MicroPython, đạt độ chính xác gần như hoàn hảo trên các bài kiểm tra số học và không cần bất kỳ công cụ hay runtime bên ngoài nào.
Qwenputer: Khi một mô hình ngôn ngữ mang cả CPU RISC-V trong trọng số của chính nó
Có những thí nghiệm công nghệ khiến người ta phải bật cười vì độ "điên rồ" của nó — và Qwenputer là một ví dụ điển hình. Tác giả Divyansh Agrawal đã biên dịch một lõi CPU RISC-V 32-bit hoạt động thực sự vào bên trong trọng số của mô hình Qwen3.5-4B, sử dụng chính các lớp attention Gated DeltaNet làm bộ nhớ RAM. Điều đáng nói là nó không phải plugin, không phải công cụ gọi ngoài, cũng chẳng phải sandbox: CPU này chạy hoàn toàn bên trong các lượt lan truyền tiến (forward pass) của mô hình.
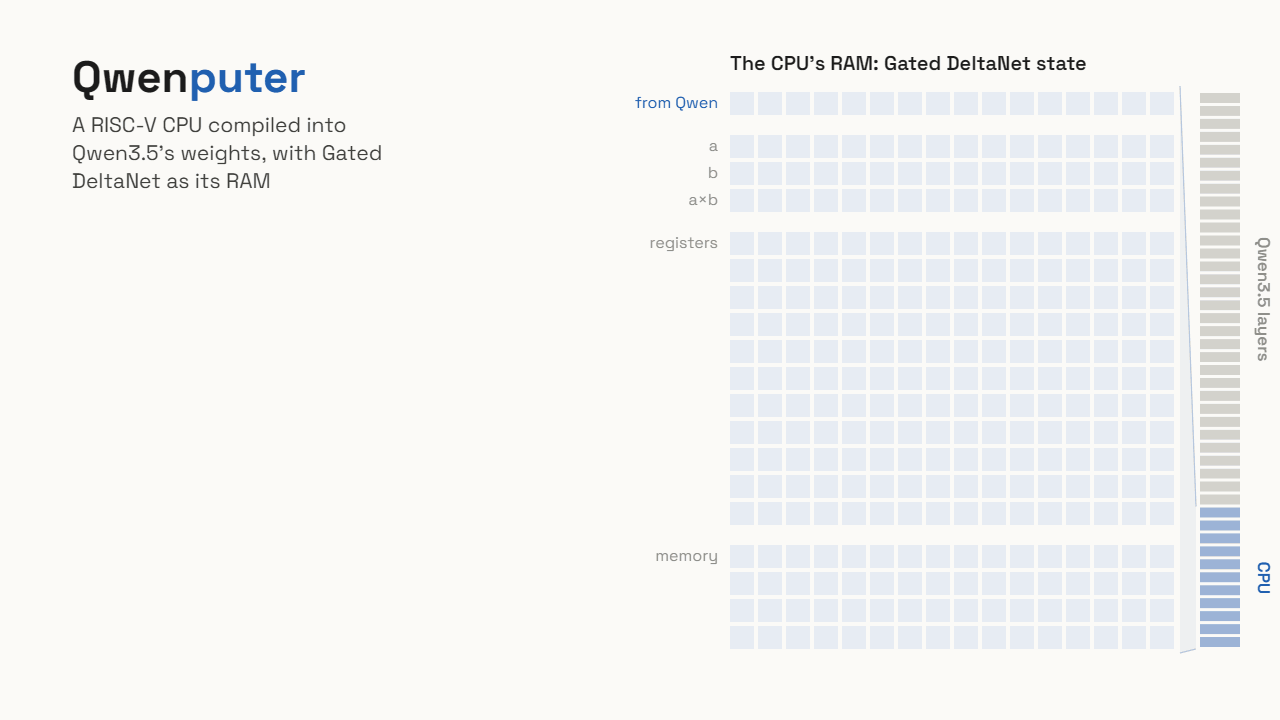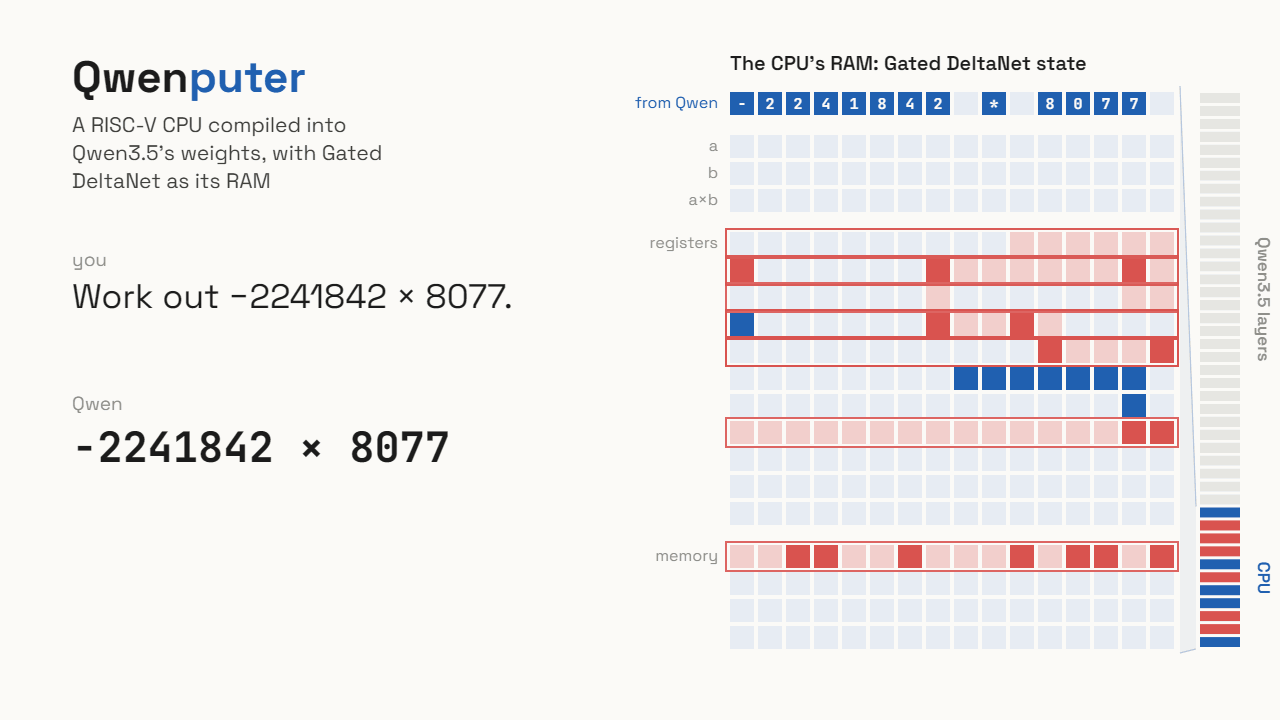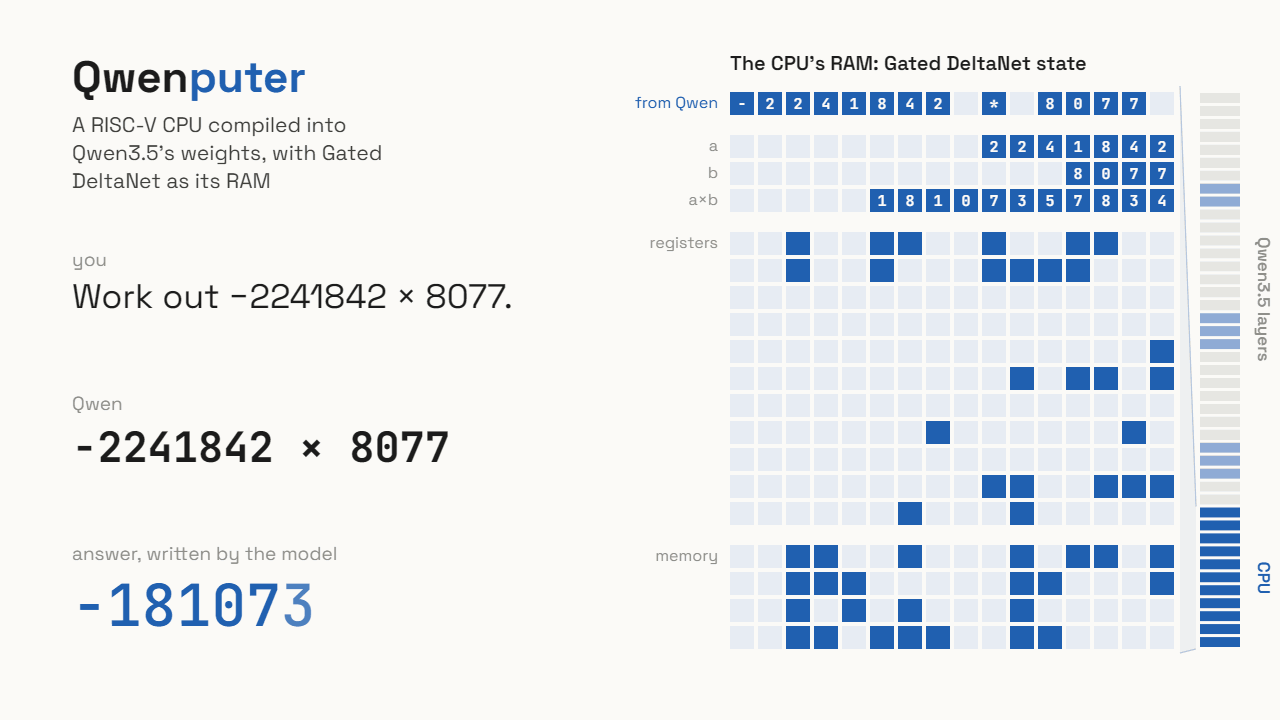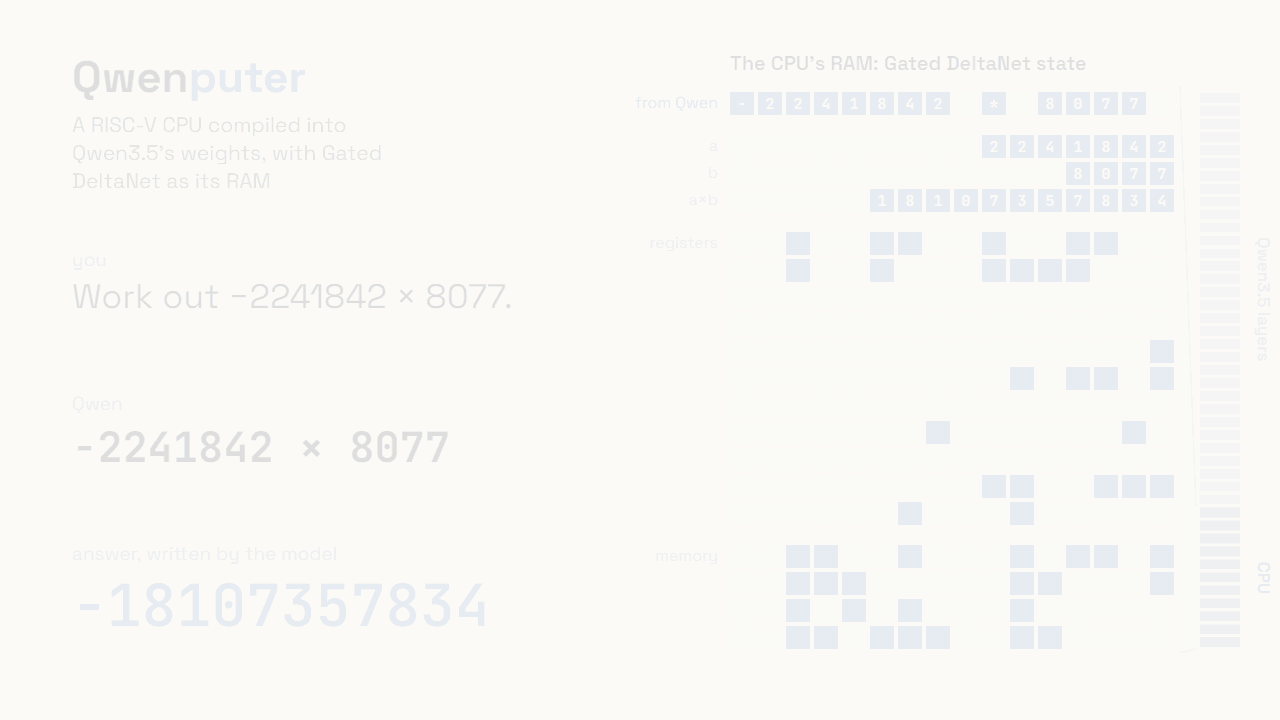 Minh họa Qwenputer chạy CPU bên trong mô hình
Gated DeltaNet bất ngờ trở thành RAM chính xác
Qwen3-Next và Qwen3.5 sử dụng một kỹ thuật khá thú vị: 3 trong 4 lớp attention dùng Gated DeltaNet (GDN) — một dạng RNN tuyến tính — làm cơ chế attention. Mỗi head giữ một ma trận trạng thái và cập nhật nó theo quy tắc delta.
Ý tưởng cốt lõi của thí nghiệm nằm ở chỗ: nếu đặt gate = 1, độ mạnh ghi beta = 1 và dùng mã hóa khóa one-hot, thì mỗi lần ghi sẽ ghi đè chính xác một hàng của trạng thái, còn mỗi truy vấn one-hot sẽ đọc lại đúng giá trị đó. Kết quả là các lớp GDN có thể đóng vai trò RAM một cách chính xác tuyệt đối.
Điểm hay là chi phí cực thấp: trạng thái của một head GDN giữ nguyên kích thước bất kể cuộc hội thoại dài đến đâu, khác hẳn với KV cache của attention thông thường.
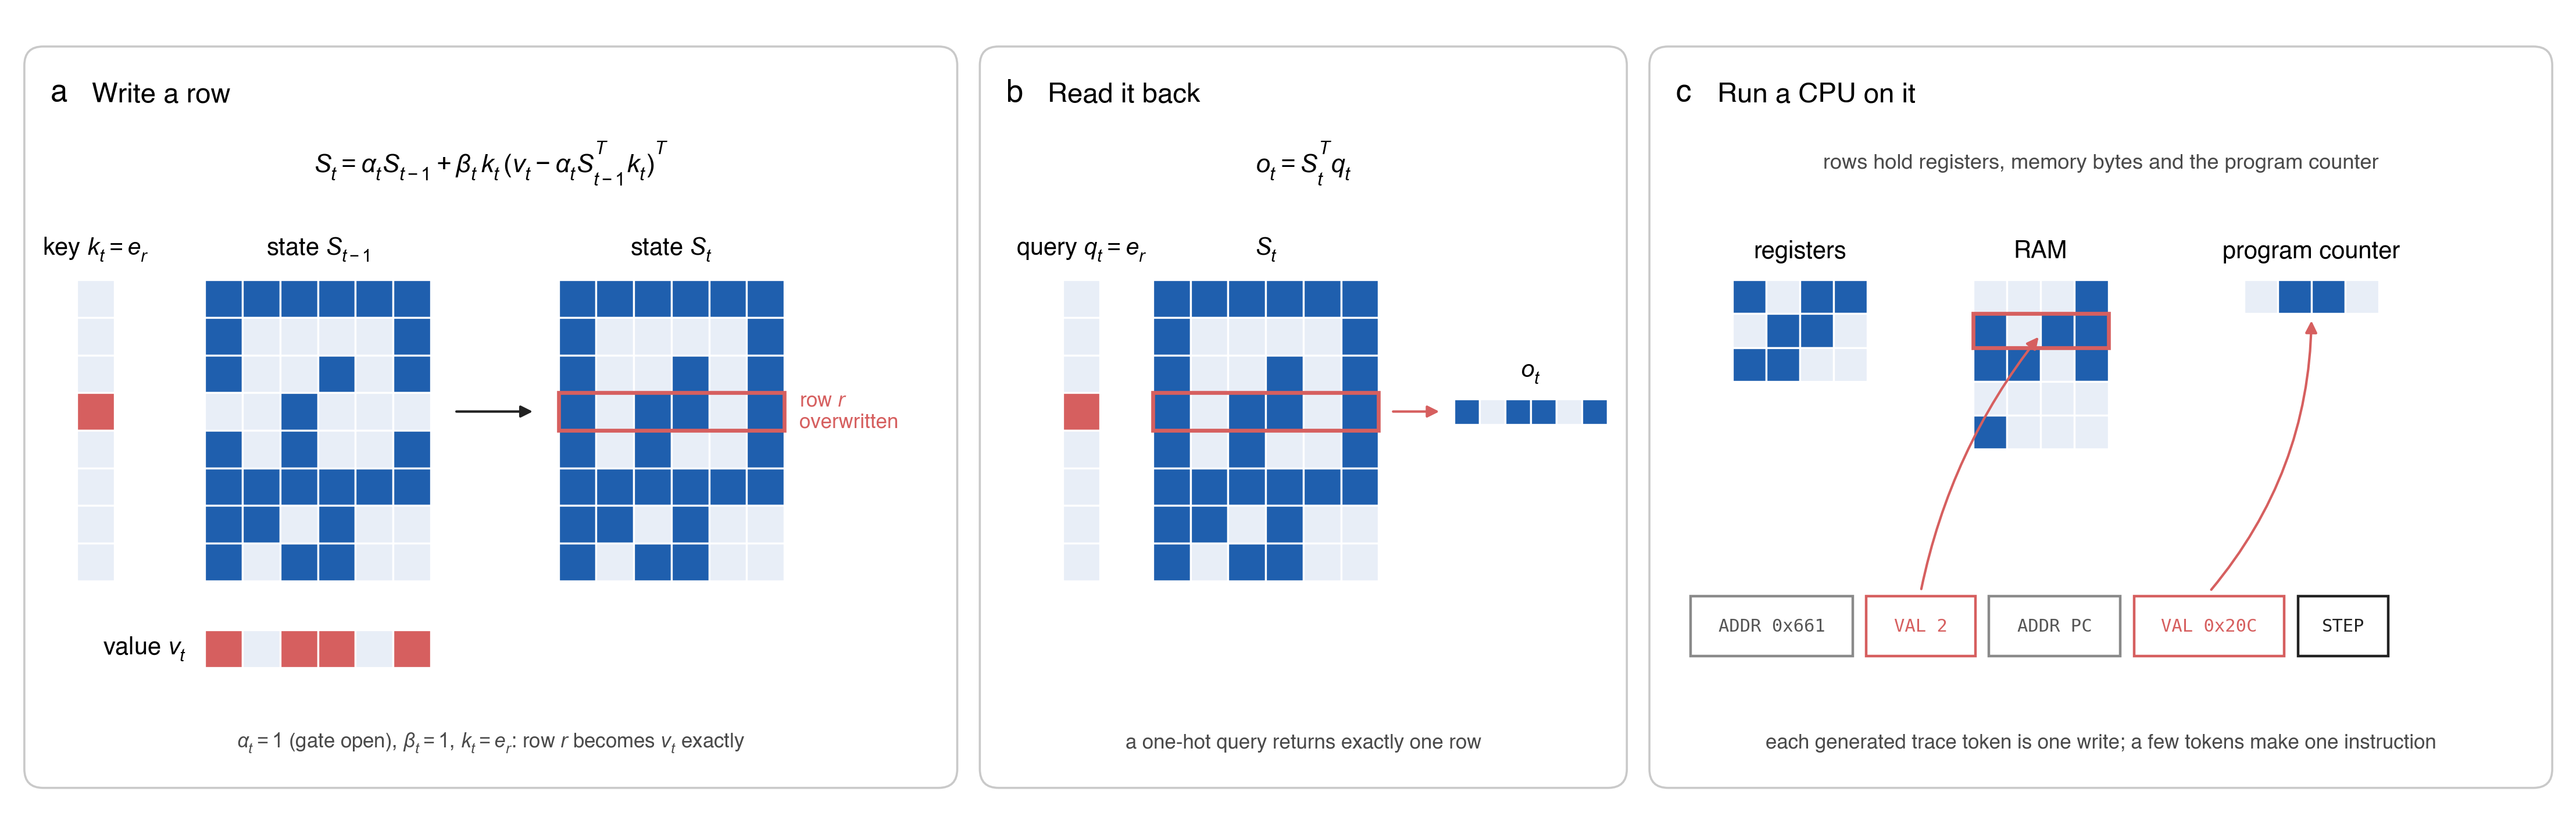 Trạng thái Gated DeltaNet được dùng như RAM
Việc quy tắc delta hoạt động như bộ nhớ liên kết không phải là điều mới — Schlag và cộng sự đã chỉ ra từ năm 2021 với khái niệm "fast weights". Cái mới ở đây là biến nó thành chính xác và có thể định địa chỉ, bên trong một mô hình thương mại, đủ tin cậy để vận hành cả một CPU.
Biên dịch một chiếc máy tính vào các lớp mạng
Khi đã có RAM hoạt động tốt, tác giả tiến hành biên dịch một CPU vào trọng số mô hình — không cần huấn luyện, trình biên dịch gán trực tiếp từng trọng số.
- Mô tả CPU dưới dạng mạch logic, gồm chuỗi bước nhỏ như "đọc thanh ghi", "cộng hai số", "nhảy nếu bằng không".
- Mỗi bước được chuyển thành một phần của lớp transformer: head attention để tra cứu, khối feed-forward để tính toán, head DeltaNet để giữ RAM.
- Mỗi lệnh sinh ra vài token: ADDR chỉ hàng bộ nhớ cần ghi, VAL mang giá trị, STEP kết thúc lệnh.
CPU là lõi RISC-V 32-bit (RV32IM), có thêm phần mở rộng Zba và một đơn vị tính số lớn, chiếm 11 lớp phía trước 32 lớp của Qwen. Nó vượt qua bộ kiểm thử chính thức riscv-tests, cho kết quả trùng khớp với qemu và đã chạy 18 triệu lệnh liên tục không một lỗi.
Kết quả thực tế: chính xác vượt cả công cụ Python
Qwen3.5-4B dùng được CPU này rất tốt mà không cần huấn luyện thêm. Mô hình gửi lệnh và đọc kết quả thông qua định dạng tool call quen thuộc, nhưng hoàn toàn không có công cụ hay runtime bên ngoài — mọi thứ diễn ra bên trong mô hình.
Trên các bộ kiểm tra số học của DeepMind và NUPA, Qwenputer đạt kết quả ấn tượng:
- div_big: 97,5% (so với 95% khi cho Qwen dùng công cụ Python, 72,5% với Qwen gốc)
- mul_big: 97,5% (so với 100% với Python, 55% với Qwen gốc)
- mul_div_multiple_longer: 100% (so với 97,5% với Python)
- add_or_sub_big: 97,5%, ngang với dùng Python (87,5% với Qwen gốc)
- Số học số nguyên dài của NUPA: tăng từ 48,6% lên 100%
Tác giả còn phát lại khoảng 230.000 vị trí đầu ra so với máy tham chiếu và không phát hiện sai lệch nào. Đồng thời, việc gắn thêm "máy tính" không làm thay đổi cách mô hình trò chuyện (KL 6e-4, sát với mức nhiễu nền 5e-4).
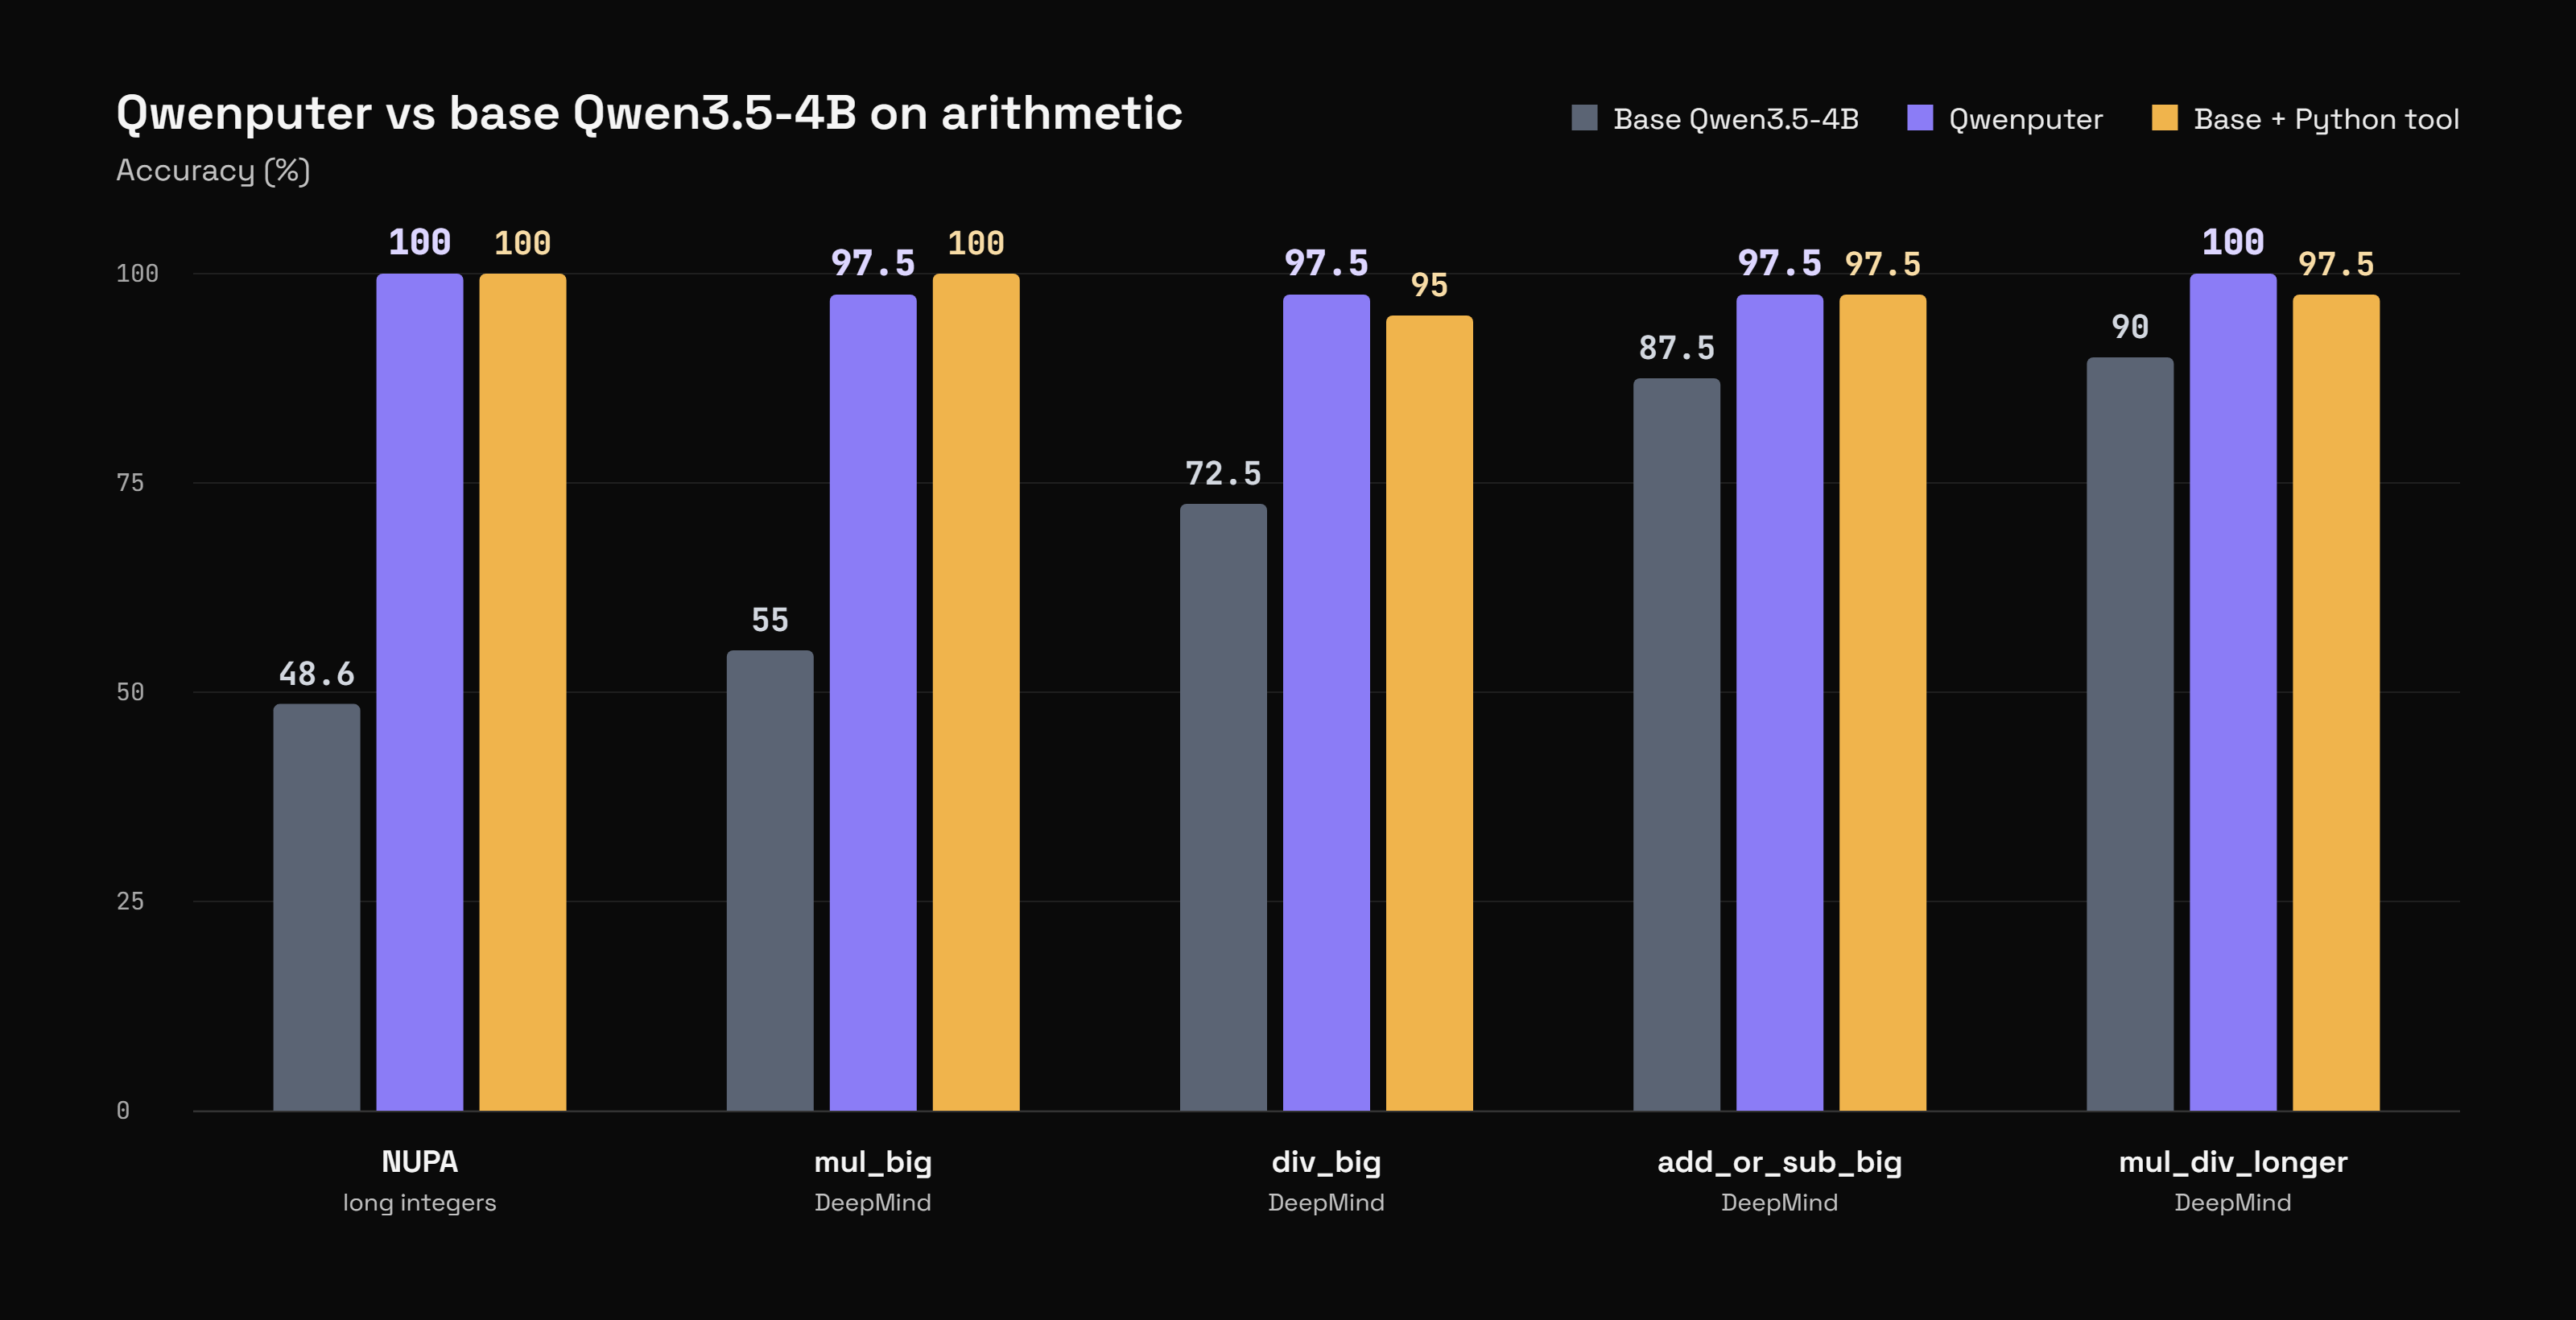 Kết quả benchmark của Qwenputer so với Qwen gốc và Qwen dùng công cụ Python
Và tất nhiên, phải có cả... ổ cứng
Vì đã có RAM hoạt động, việc thêm hệ thống tệp gần như là điều đương nhiên. Khi Qwen "lưu" một tệp, các lớp đã biên dịch băm tên tệp vào một trong 1.024 ô trong thư mục giữ ở trạng thái DeltaNet, nội dung lưu ở các head khác, mỗi hàng 8 token nối tiếp nhau. Hệ thống chứa được 512 tệp, tương đương khoảng 53.000 token văn bản.
Điều thú vị là nó có tính lưu trữ lâu dài: lưu trạng thái cuối cuộc hội thoại rồi nạp vào phiên tiếp theo, các tệp vẫn còn nguyên. Nhờ đó, Qwen trả lời đúng thông tin thay đổi giữa các phiên 90% số lần, so với 30% khi dán lại lịch sử chat cũ.
Hạn chế và hướng phát triển
Qwenputer vẫn là một thí nghiệm, nên còn vài điểm yếu:
- Checkpoint nặng 18,8 GB, gần gấp đôi Qwen gốc, dù phần lớn là padding bằng 0.
- Cần một driver nhỏ tên RvChat để khởi động firmware, nên chưa chạy được với lệnh
generate()thông thường. - Tốc độ còn chậm: mỗi lệnh CPU tốn vài token giải mã, nên phép tính lớn mất vài giây thay vì vài mili giây. Bộ thực thi theo lô đạt khoảng 3.200 token CPU/giây trên GPU L4.
Hướng đi tiếp theo của tác giả là cho Qwen tự viết mã Python và chạy trên MicroPython nằm ngay trong trọng số của nó, cùng với việc tăng tốc CPU.
Ý nghĩa lớn hơn: một bệ thử cho an toàn AI
Khả năng điều khiển chính xác các lớp RNN không chỉ hữu ích cho số học. Qwenputer còn là một bệ thử lý tưởng cho nghiên cứu an toàn AI. Tác giả đã viết hai bài tiếp theo, bàn về việc các mô hình lai như Qwen3.5 có thể học cách giấu lý luận trong trạng thái RNN để né giám sát chuỗi suy nghĩ (CoT), và cách các trọng số đã biên dịch có thể hoạt động như công cụ giám sát mà mô hình không thể vô hiệu hóa.
Trải nghiệm thử
Nếu muốn tự tay thử, mô hình chạy được trên một GPU 24 GB. Bạn cần uv và Hugging Face CLI, không cần tool server hay sandbox Python — vì CPU tính toán ngay bên trong mô hình:
git clone https://github.com/divagr18/qwenputer && cd qwenputer/experimental/riscv && uv sync --extra hf
hf download divagr1925/Qwen3.5-4B-Qwenputer --local-dir qwenputer-rv
uv run python -m chipformer.rv.chat qwenputer-rv --firmware tests/data/rv/calc-bridge.elf \
--ask "Use calc: what is 123456789 * 987654321?"
Toàn bộ mã nguồn nằm trên GitHub, cả hai mô hình có trên Hugging Face và ModelScope. Với những ai quan tâm đến ranh giới giữa mô hình ngôn ngữ và kiến trúc máy tính, Qwenputer chắc chắn là một trong những thí nghiệm đáng chú ý nhất thời gian gần đây — một lời nhắc rằng "tôi không thể tin đây không phải silicon" đôi khi lại là sự thật.