
Sáu mô hình AI Trung Quốc mang dấu vết GPU Blackwell bị cấm xuất khẩu
Phân tích pháp chứng của Will DePue (Unemployment Labs) trên trọng số công khai của các mô hình AI cho thấy sáu mô hình đến từ DeepSeek, Moonshot AI, MiniMax và Ant Group được khởi tạo trên GPU NVIDIA Blackwell — loại chip cần giấy phép xuất khẩu sang Trung Quốc mà chưa từng được cấp phép. Phát hiện này đưa ra bằng chứng kỹ thuật, không dựa vào rò rỉ hay nguồn tin nội bộ.
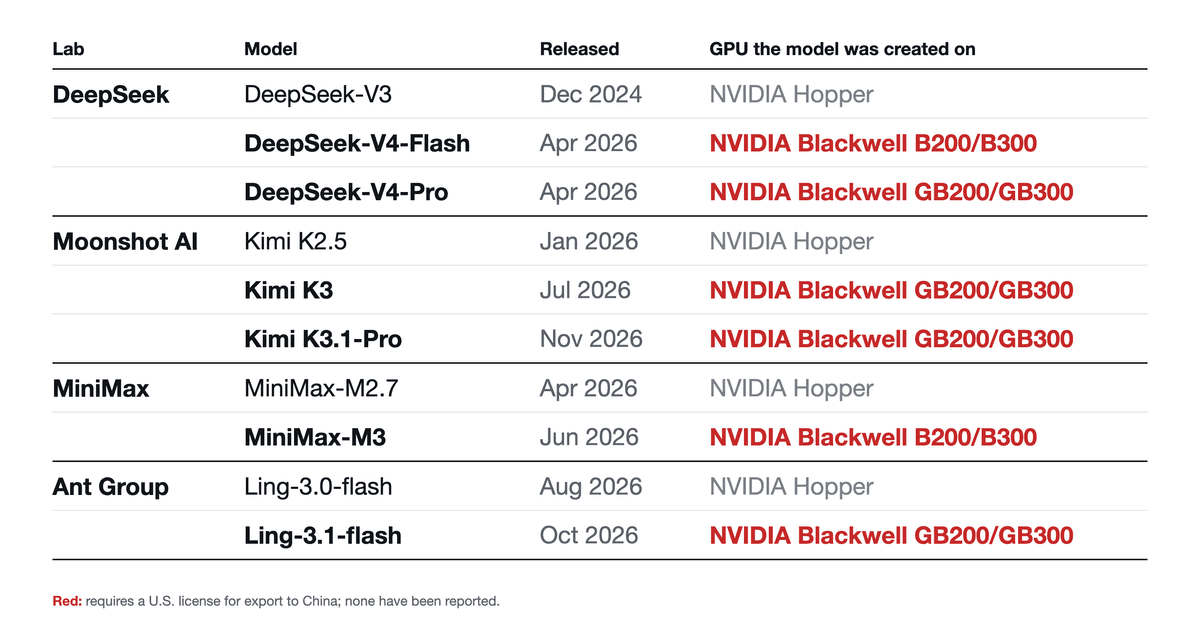
Một phân tích pháp chứng trên trọng số công khai của các mô hình AI phát hiện sáu mô hình đến từ bốn phòng lab Trung Quốc mang dấu vết phần cứng của GPU NVIDIA Blackwell — dòng chip cần giấy phép xuất khẩu của Mỹ sang Trung Quốc và chưa từng được cấp phép.
Báo cáo do Will DePue của Unemployment Labs công bố ngày 12/11/2026. Toàn bộ bằng chứng đến từ chính các trọng số (weights) mà các lab công bố, không phải từ rò rỉ hay lời kể nội bộ. Điều này khiến phát hiện có sức nặng khác với các cáo buộc trước đó của quan chức Mỹ và báo chí.
Sáu mô hình, bốn phòng lab
Các mô hình được xác định là khởi tạo trên phần cứng Blackwell gồm:
- DeepSeek-V4-Flash và DeepSeek-V4-Pro (DeepSeek, phát hành tháng 4/2026)
- Kimi K3 (tháng 7/2026) và Kimi K3.1-Pro (tháng 11/2026) của Moonshot AI
- MiniMax-M3 (tháng 6/2026)
- Ling-3.1-flash (tháng 10/2026) của Ant Group
Hai mô hình DeepSeek-V4-Flash và MiniMax-M3 khớp với cấu hình B200/B300 (148 SM — streaming multiprocessor, tức đơn vị xử lý đa luồng). Bốn mô hình còn lại khớp với GB200/GB300 (152 SM). Các mô hình trước đó của cùng những lab này — như DeepSeek-V3, Kimi K2, Kimi K2.5, MiniMax-M2.7, Ling-3.0-flash — đều mang dấu vết thế hệ Hopper cũ hơn.
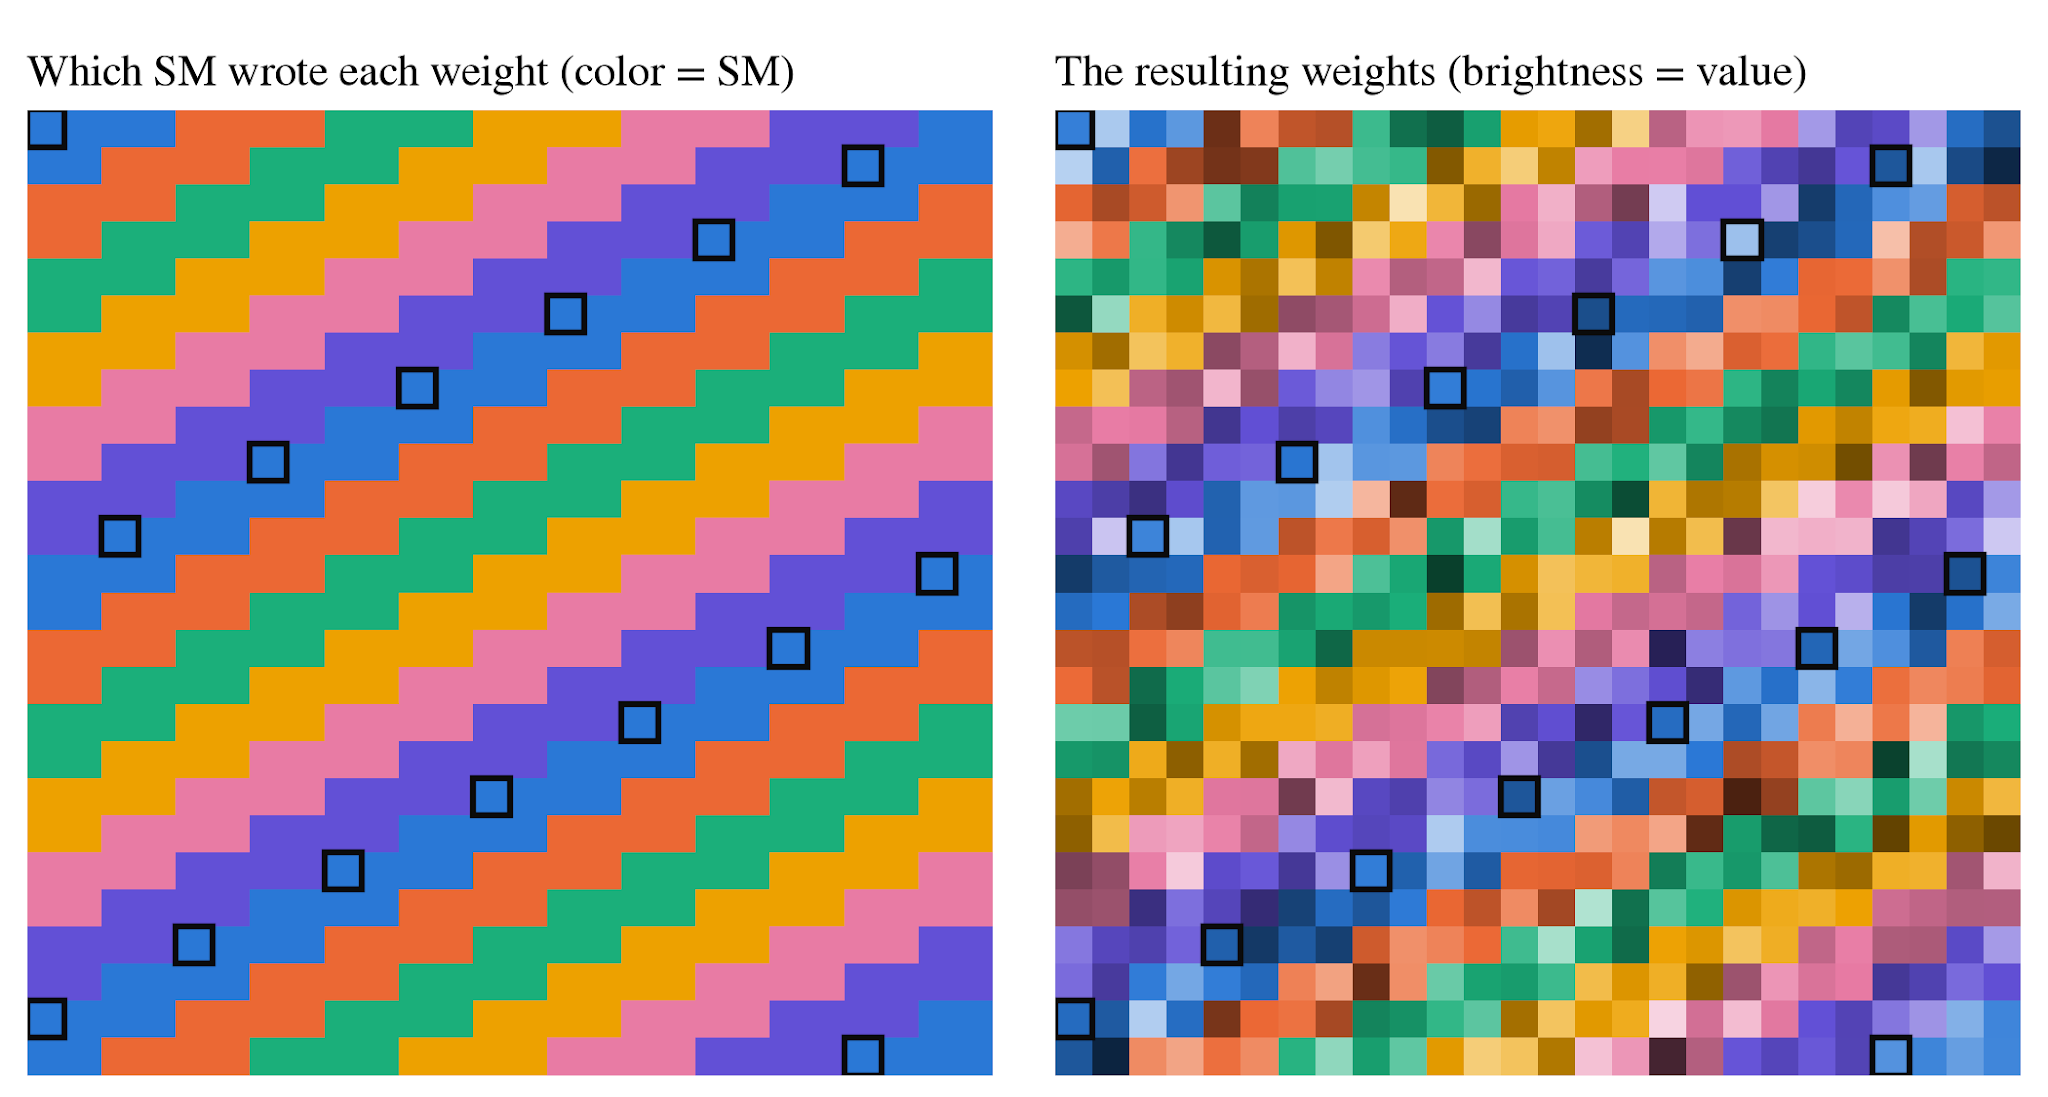 Sơ đồ cách GPU lấp đầy trọng số với số đơn vị xử lý và luồng khác nhau
Không phải lab nào cũng chuyển sang Blackwell. Các mô hình mới nhất đọc được từ Alibaba (Qwen), Zhipu (GLM), Tencent, Xiaomi và StepFun đều vẫn là Hopper. Meituan nói LongCat-2.0 được huấn luyện hoàn toàn trên "AI ASIC superpods" và báo cáo không tìm thấy dấu vết NVIDIA trong trọng số mô hình này.
Dấu vân tay hình thành từ cách sinh số ngẫu nhiên
Trọng số mô hình là hàng tỷ con số có thể điều chỉnh. Trước khi huấn luyện, chúng cần giá trị khởi tạo, và trong phần mềm được khảo sát, các giá trị này do thuật toán sinh số giả ngẫu nhiên Philox tạo ra từ một "hạt giống" (seed). Cùng seed và cùng cấu hình thì Philox luôn cho ra cùng dãy số.
Để lấp hàng tỷ trọng số nhanh, PyTorch — framework dùng trong hầu hết mô hình AI lớn — chia việc của Philox cho nhiều luồng chạy song song trên GPU (thông qua cuRAND của NVIDIA). Số luồng quyết định vị trí các con số được đặt vào. Trên các chip được khảo sát, một lần khởi tạo đủ lớn sẽ dùng tối đa 2.048 luồng cho mỗi SM. Chip càng nhiều SM thì cùng một việc được chia cho nhiều luồng hơn, và vị trí các con số vì thế thay đổi.
Nguyên nhân là: Hopper H100 SXM, H200 và H800 có 132 SM, dùng 270.336 luồng; Blackwell B200/B300 có 148 SM, dùng 303.104 luồng; Blackwell GB200/GB300 có 152 SM, dùng 311.296 luồng. Khôi phục được số luồng là biết được mô hình thuộc nhóm phần cứng nào.
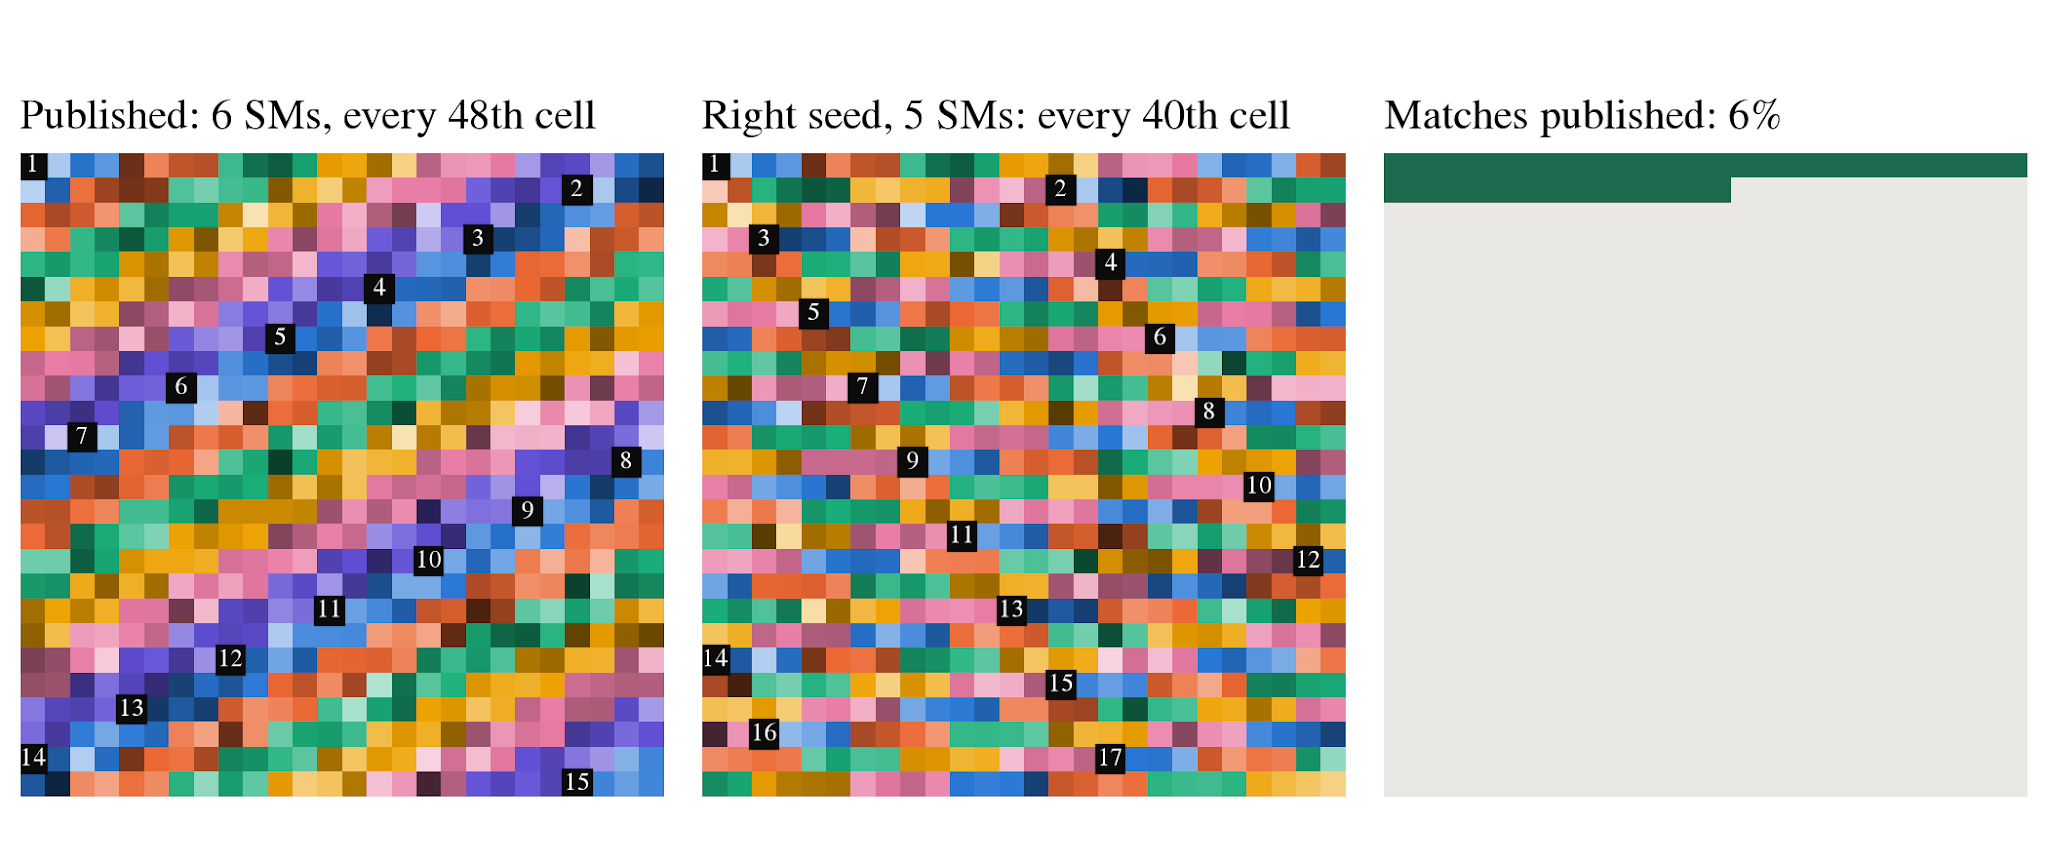 Cùng một seed trên GPU khác nhau cho ra cách sắp xếp khác nhau
Có những trọng số dành cho từ hoặc ký hiệu không xuất hiện trong quá trình huấn luyện, nên gần như giữ nguyên giá trị khởi tạo. Nhóm nghiên cứu so trực tiếp các giá trị này với giá trị sinh ra từ seed và số luồng ứng viên. Ngay cả trọng số đã bị huấn luyện thay đổi vẫn có thể giữ dấu vết yếu của giá trị ban đầu, đủ để kiểm định trên hàng trăm nghìn trọng số.
Độ tin cậy của kết quả
Nhóm nghiên cứu chọn seed và cách bố trí bằng một tập trọng số, rồi kiểm tra tổ hợp đó trên một tập khác không tham gia vào việc lựa chọn. Bằng chứng mạnh nhất cho mỗi mô hình trong sáu mô hình đạt từ 49 đến 1.385 sigma; phép thử yếu nhất được báo cáo cũng đạt 20 sigma. Với khoảng 6.000 tỷ tổ hợp seed và cách bố trí được thử, một kết quả trùng ngẫu nhiên mạnh nhất chỉ vào khoảng 8 sigma — nên các con số trên vượt xa ngưỡng nhiễu.
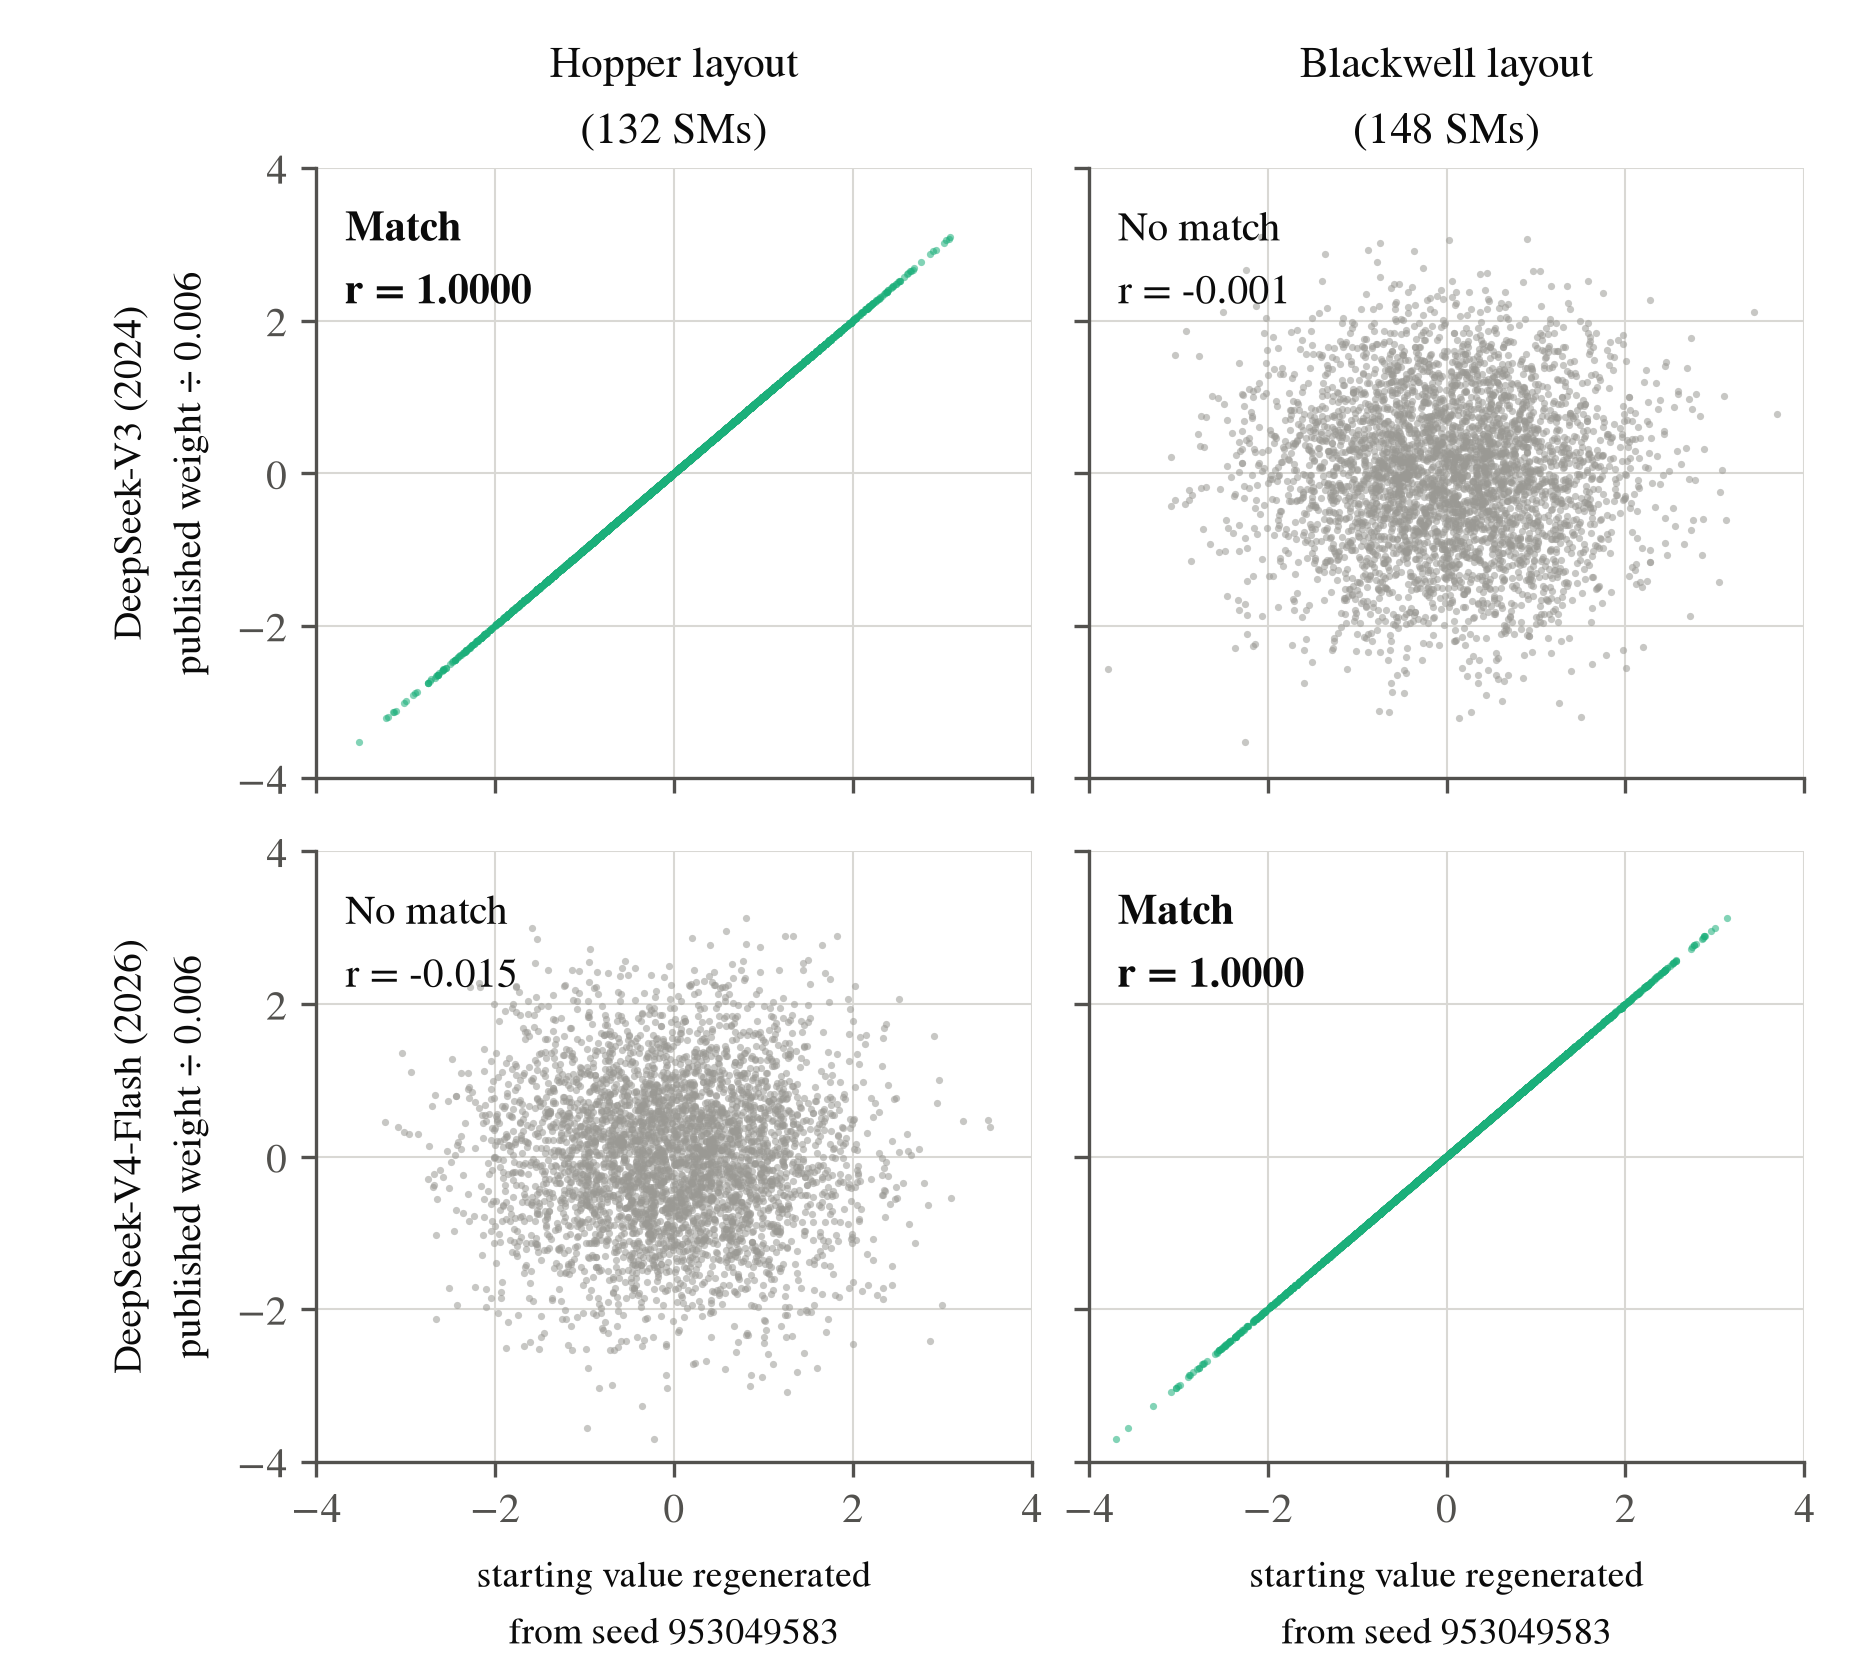 So sánh trọng số công khai với giá trị tái tạo từ seed
Để kiểm chứng, nhóm chạy PyTorch nguyên bản trên một GPU H100 (Hopper) và một B300 (Blackwell). Với seed 953049583 của DeepSeek, H100 tái tạo đúng toàn bộ 57.344 giá trị được giữ nguyên trong DeepSeek-V3, còn B300 tái tạo đúng 461 trong 469 dòng chọn lọc của DeepSeek-V4-Flash, trong đó 445 dòng khớp từng bit. Không chip nào tái tạo được mô hình của chip kia.
Phương pháp cũng khớp với 24 trường hợp mà nhà phát triển đã công bố phần cứng. Chẳng hạn Nemotron-3 Ultra của NVIDIA, có báo cáo kỹ thuật nêu GB200 cho một giai đoạn huấn luyện, đọc ra 152 SM giống Kimi K3.
Những giới hạn cần lưu ý
Báo cáo nêu rõ phương pháp chỉ xác định phần cứng đã khởi tạo trọng số, không xác định mọi chip tham gia huấn luyện sau đó. Một lab có thể sinh trọng số trên hệ thống này rồi chuyển sang hệ thống khác, hoặc huấn luyện tiếp trên phần cứng mới. Trọng số cũng không cho biết ai sở hữu chip hay chip nằm ở đâu — hệ thống Blackwell có thể thuê từ các trung tâm dữ liệu ngoài Trung Quốc.
Phương pháp cần trọng số công bố, nên không kiểm tra được các mô hình đóng. Nó cũng cần dấu vết phụ thuộc phần cứng do phần mềm sinh trọng số để lại: PyTorch có, còn PaddlePaddle của Baidu thì không. Nhóm nghiên cứu khôi phục được seed của ERNIE-5.5 (2760) nhưng không xác định được phần cứng.
Về khả năng thay thế, AMD MI300X thường dùng 304 đơn vị xử lý nhưng có thể chia thành hai nhóm 152 hoặc cấu hình chỉ dùng 148. Trên một MI300X thực tế, cấu hình như vậy tái tạo được cách bố trí tương tự Blackwell. Tuy nhiên với DeepSeek-V4-Flash, trong 377 giá trị mà hai hãng cho kết quả khác nhau, trọng số công bố khớp NVIDIA ở 363 giá trị và không khớp AMD ở giá trị nào.
Quy mô chi phí
Từ kích thước mô hình và lượng dữ liệu huấn luyện, nhóm nghiên cứu ước tính mỗi lần huấn luyện cần khoảng 500 đến 3.000 GPU Blackwell trong hai đến ba tháng, nếu giả định mô hình được huấn luyện trên chính phần cứng đã khởi tạo nó. Áp dụng cùng phép tính cho DeepSeek-V3 cho ra 2.000–2.500 chip, trong khi DeepSeek công bố dùng 2.048.
Với mức giá khoảng 70.000 USD mỗi GPU — suy ra từ thông tin của Wall Street Journal rằng khoảng 36.000 chip Blackwell lắp đặt tại Malaysia cho ByteDance sẽ tốn hơn 2,5 tỷ USD — cụm lớn nhất trong số này có giá 150–200 triệu USD, và cả năm cụm vượt nửa tỷ USD. Con số này chỉ tính các lần huấn luyện cuối cùng.
Góc nhìn
Với các kỹ sư và doanh nghiệp Việt Nam, báo cáo này cho thấy trọng số công khai không chỉ là tài sản trí tuệ mà còn là nguồn thông tin pháp chứng về hạ tầng đã tạo ra chúng. Đây là lời nhắc rằng cách khởi tạo mô hình có thể để lại dấu vết lâu dài, và những chi tiết tưởng như vô hại trong pipeline huấn luyện đều có thể bị truy ngược.
Câu chuyện cũng phản ánh thực tế phân mảnh của chuỗi cung ứng GPU: nhu cầu tính toán cho AI lớn đến mức các lab sẵn sàng tìm mọi cách tiếp cận phần cứng mạnh nhất, bất kể rào cản thương mại. Các đội ngũ Việt Nam khi thuê GPU qua đám mây nên biết rõ nguồn gốc và điều khoản sử dụng hạ tầng, vì các quy định xuất khẩu có thể ảnh hưởng đến khả năng truy cập chip thế hệ mới trong dài hạn.
Báo cáo đầy đủ và các số liệu chi tiết có tại trang của Will DePue, Unemployment Labs.
Nguồn: unemploymentlabs.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
NSA, FBI cảnh báo Trung Quốc đang 'hút cạn' công nghệ AI tiên tiến của Mỹ bằng kỹ thuật chưng cất dữ liệu
09 tháng 9, 2026
Công nghệ
Mô hình AI Trung Quốc giá rẻ và mã nguồn mở có thể gây ra cuộc 'tái cấu trúc' hạ tầng AI nghìn tỷ USD
13 tháng 10, 2026
Phần cứng
Alibaba thừa nhận đang chật vật đuổi kịp đối thủ chip và AI, giới thiệu bộ tăng tốc Zhenwu M890
22 tháng 5, 2026