
So sánh bảy mô hình ra quyết định mã nguồn mở với LLM tạo sinh: Bài học từ routing ngân hàng
Một thử nghiệm thực tế trên bảy dự án Jev-style mã nguồn mở so với baseline Qwen3-0.6B cho thấy mô hình chấm điểm ứng viên có thể đạt độ chính xác tới 98%, không sinh token trả lời và có độ trễ thấp hơn đáng kể so với việc để LLM sinh JSON.
Trong các hệ thống AI tác tử (agent), rất nhiều quyết định thực chất chỉ là chọn một phương án trong danh sách có sẵn — định tuyến yêu cầu, chọn công cụ, phân loại ý định. Vậy tại sao chúng ta vẫn dùng mô hình ngôn ngữ lớn để "sinh" ra câu trả lời từng token một, rồi lại phải phân tích cú pháp để đọc kết quả?
Một so sánh thực nghiệm mới đây trên bảy dự án mã nguồn mở theo phong cách Jev đã đặt câu hỏi này vào đúng trọng tâm: liệu mô hình ra quyết định chuyên dụng có thể vượt qua LLM tạo sinh trong các bài toán lựa chọn có giới hạn hay không, và cái giá phải trả là gì?
 Minh họa mô hình ra quyết định so với LLM tạo sinh
Vấn đề: sinh token cho một lựa chọn duy nhất
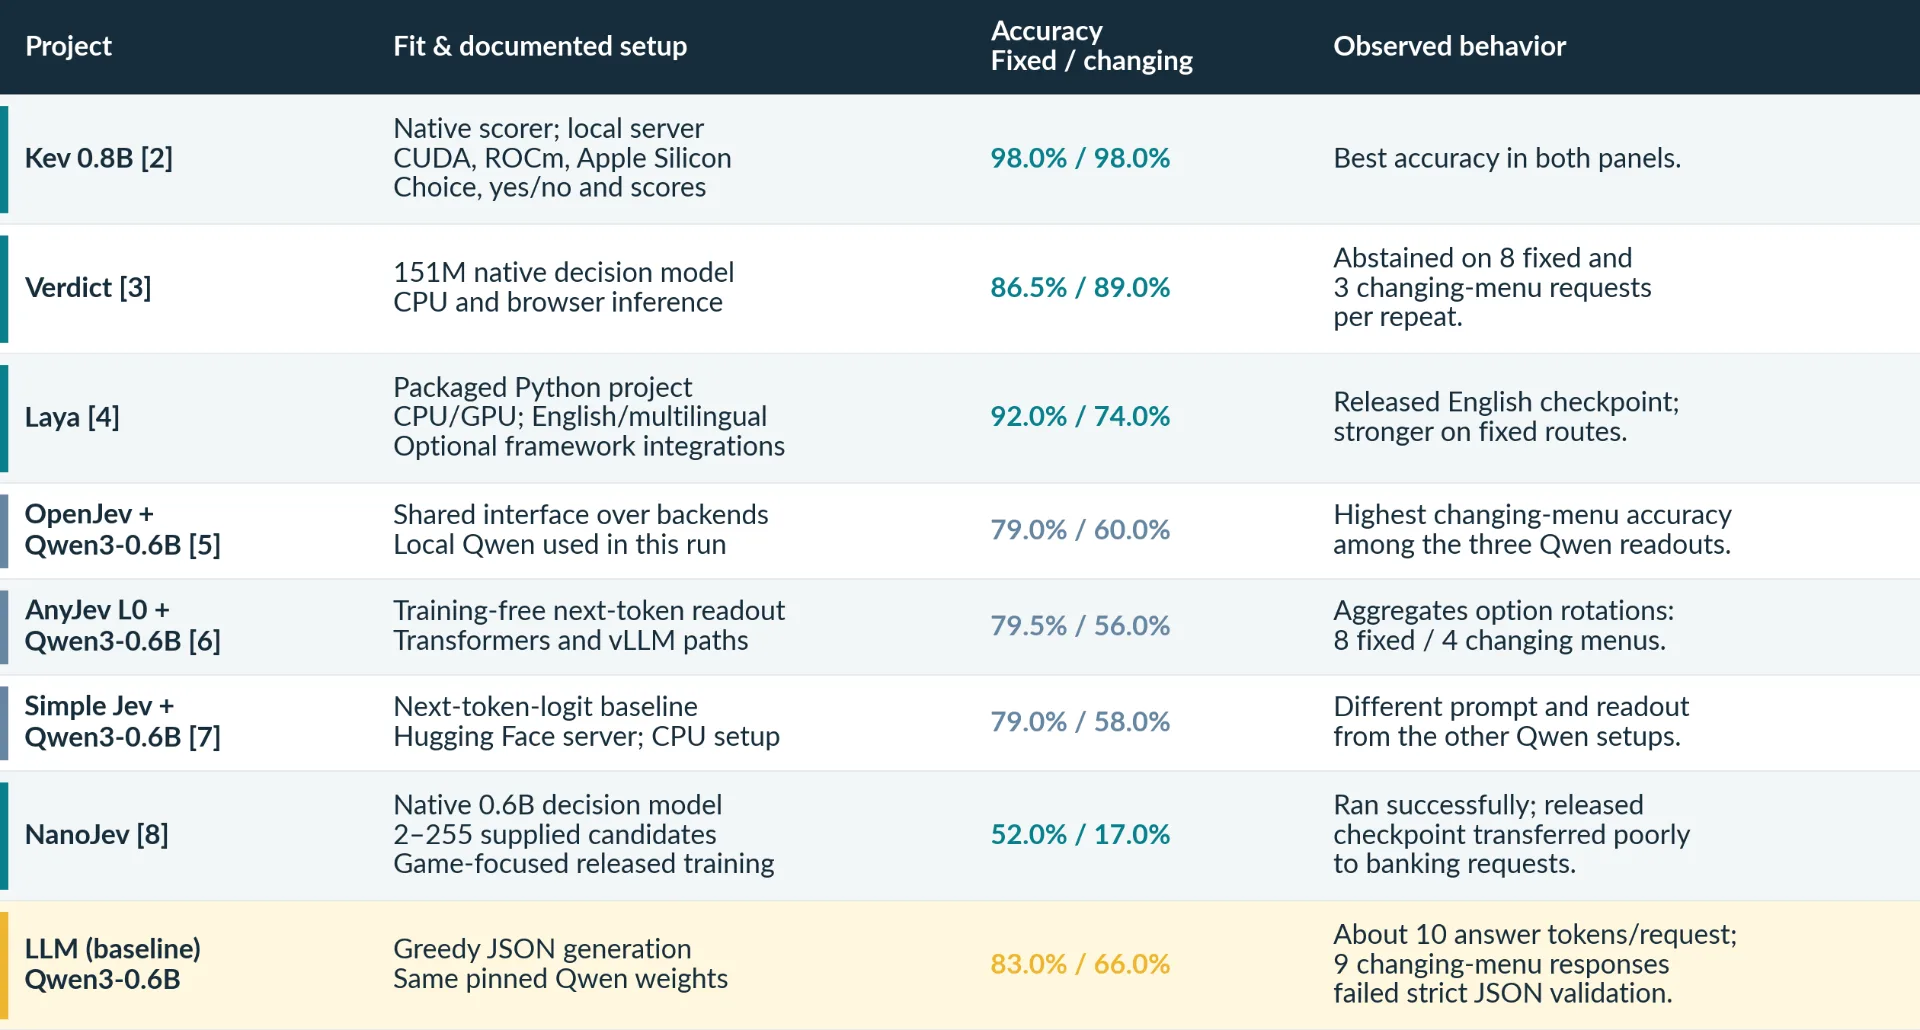
Hãy hình dung một khách hàng ngân hàng phàn nàn: "Tôi bị tính phí hai lần cho cùng một giao dịch chuyển khoản." Bước tiếp theo của hệ thống là chọn đúng luồng xử lý hỗ trợ. Nếu dùng LLM, ta phải yêu cầu mô hình viết ra chuỗi {"route": "duplicate charge"}, rồi phân tích cú pháp để lấy giá trị.
Cách làm này hoạt động, nhưng nó biến một quyết định có giới hạn thành một bài toán tạo văn bản — kéo theo hàng loạt rủi ro: mô hình thêm markdown fence, sai định dạng, hoặc sinh token thừa. Mô hình ra quyết định (decision model) đi theo hướng ngược lại: cung cấp trạng thái, định nghĩa các đáp án được phép, và nhận về một kết quả có kiểu dữ liệu xác định.
Điểm mấu chốt là khái niệm candidate (ứng viên) — một lựa chọn khả dụng. Giao diện dựa trên ứng viên cho phép luồng công việc cung cấp danh sách tuyến hoặc công cụ cho từng yêu cầu cụ thể, và mô hình chỉ việc chấm điểm danh sách đó. Bên gọi có thể thay đổi lựa chọn mà không cần thêm một "ô đầu ra cố định" cho mỗi tuyến mới.
Ba nhóm dự án mã nguồn mở
Bảy dự án được thử nghiệm chia thành ba nhóm rõ rệt:
- Bộ chấm điểm đã huấn luyện (Kev, Verdict, Laya, NanoJev): có mô hình trực tiếp cho điểm các lựa chọn.
- Đọc kết quả không cần huấn luyện (AnyJev, Simple Jev): suy ra điểm số từ đầu ra của mô hình ngôn ngữ.
- Tầng phục vụ (serving layer) (OpenJev): cung cấp giao diện chung cho một backend được chọn.
Đi kèm là một baseline LLM tạo sinh dùng chính checkpoint Qwen3-0.6B đã ghim phiên bản, tạo JSON trực tiếp.
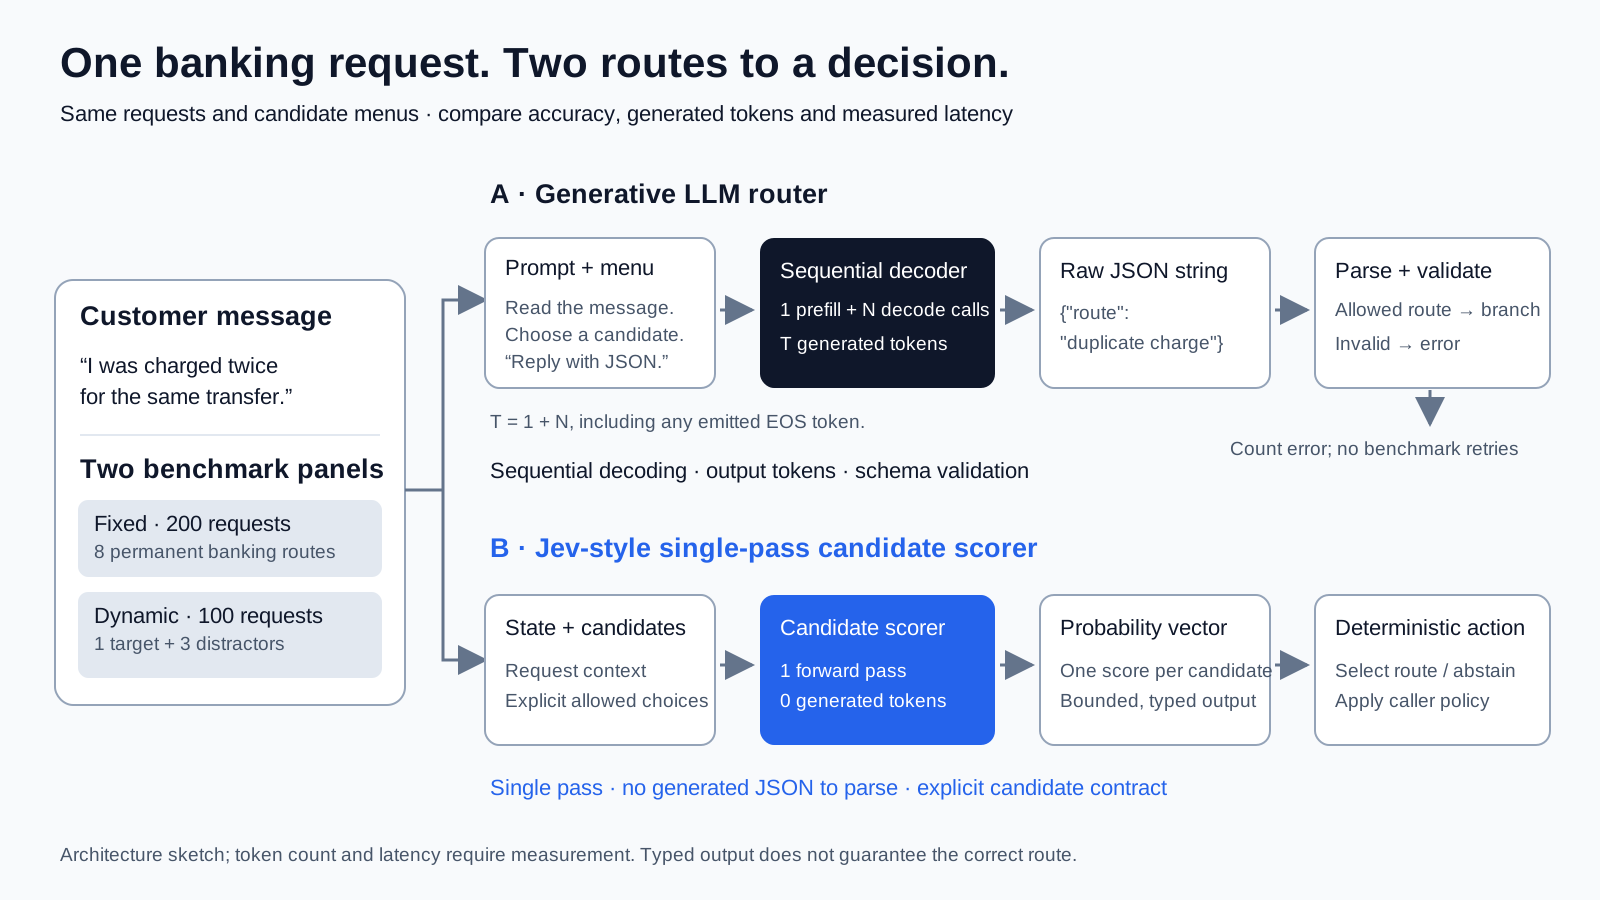 Sơ đồ so sánh các cấu hình
Cách thiết kế thử nghiệm
Nhóm nghiên cứu dùng bộ dữ liệu BANKING77 — các yêu cầu ngân hàng ngắn được gán nhãn theo ý định — và chia thành hai bảng:
- Tuyến cố định (Fixed routes): mọi yêu cầu đều nhận cùng một menu gồm 8 tuyến ngân hàng. 200 yêu cầu, lấy từ 8 ý định.
- Ứng viên thay đổi (Dynamic candidates): mỗi yêu cầu nhận một menu riêng gồm 4 tuyến đã xáo trộn — tuyến đúng cộng 3 nhiễu. 100 yêu cầu, lấy từ 4 ý định khác.
Mỗi cấu hình giữ nguyên prompt và chính sách đọc kết quả chính thức của mình. Nhóm chạy lặp lại mỗi so sánh 300 yêu cầu hai lần và thu được dự đoán giống hệt nhau. Ngoài độ chính xác, họ còn ghi lại số token sinh ra, lỗi định dạng và độ trễ yêu cầu.
Kết quả: bộ chấm điểm dẫn đầu rõ rệt
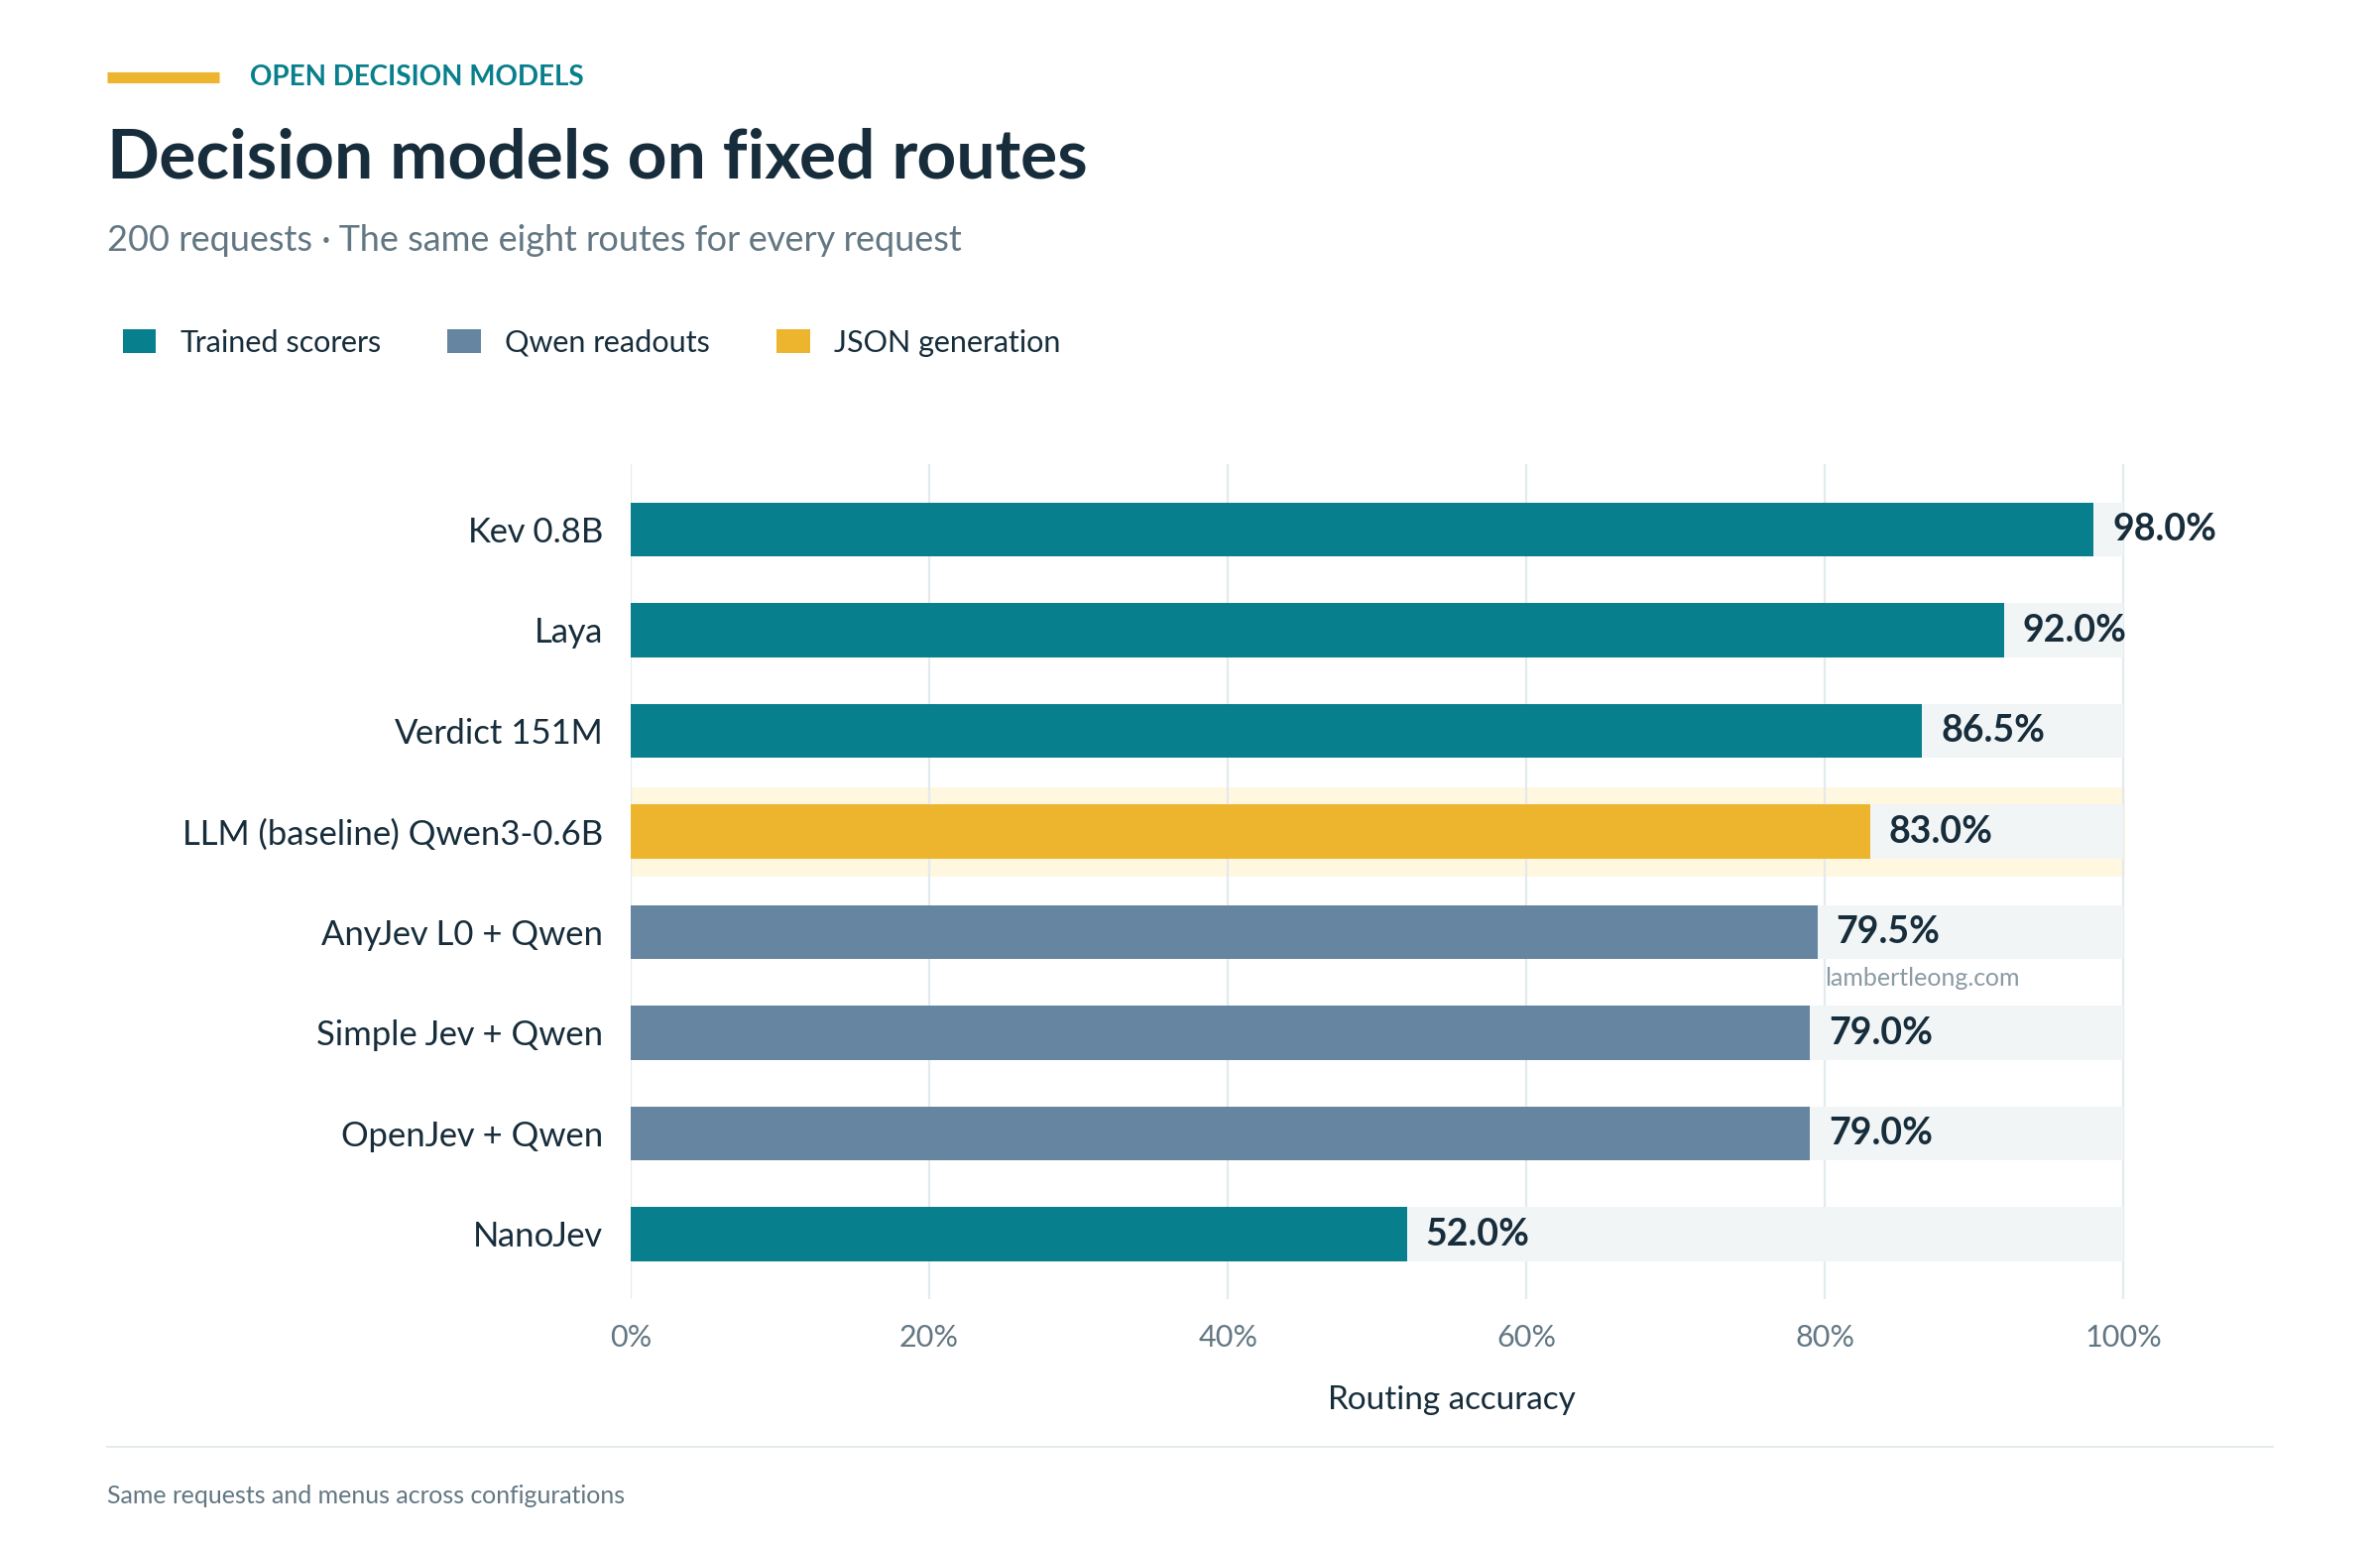
Ở bảng tuyến cố định, Kev 0.8B dẫn đầu với độ chính xác 98,0% (196/200 yêu cầu đúng), tiếp theo là Laya 92,0% và Verdict 86,5%. Baseline Qwen3-0.6B đạt 83,0%, còn NanoJev chỉ 52,0%.
Ở bảng ứng viên thay đổi, khoảng cách còn rõ hơn. Kev vẫn giữ 98,0%, Verdict vươn lên 89,0%, trong khi Laya tụt xuống 74,0%. Đáng chú ý, baseline LLM tạo sinh rơi từ 83,0% xuống chỉ còn 66,0%. Ba cấu hình đọc kết quả từ Qwen (AnyJev, Simple Jev, OpenJev) chỉ đạt 56–60%.
Bài học nổi bật: việc chấp nhận một danh sách ứng viên mới và việc chọn đúng từ danh sách đó là hai năng lực hoàn toàn khác nhau. NanoJev xử lý được giao diện ứng viên động, nhưng checkpoint huấn luyện trên trò chơi của nó chỉ đạt 17% trên các yêu cầu ngân hàng.
Chi phí vận hành: không sinh token, độ trễ thấp hơn nhiều
Đây có lẽ là phần thú vị nhất đối với các kỹ sư vận hành hệ thống. Các bộ chấm điểm gốc và đầu đọc logit sinh ra 0 token trả lời tự hồi quy, so với trung bình 9,71 token mỗi yêu cầu ở baseline Qwen.
Độ trễ trung vị (p50) ghi nhận được:
- Kev: 125–130 ms
- Verdict: 17–18 ms
- Baseline Qwen3-0.6B: 331–357 ms
 Biểu đồ độ chính xác và độ trễ
Với giả định chi phí tham chiếu 2,50 USD mỗi giờ GPU, ước tính chi phí cho 1.000 yêu cầu là khoảng 0,09 USD với Kev, 0,01 USD với Verdict, và 0,25 USD với baseline Qwen. Con số này chưa tính thời gian nạp mô hình, thời gian nhàn rỗi hay hạ tầng sản xuất bổ sung — nhưng khoảng cách vẫn rất đáng kể.
Một điểm đáng lưu ý: toàn bộ 9 lỗi ở bảng động của baseline Qwen đều là JSON hợp lệ nhưng bị bọc trong markdown fence. Bộ phân tích cú pháp JSON nghiêm ngặt đã từ chối chúng. Đây là lỗi định dạng chứ không phải lỗi cú pháp — và đầu ra ứng viên có kiểu dữ liệu tránh được đúng loại lỗi này.
Vậy nên chọn dự án nào?
Tùy vào nhu cầu cụ thể, nhóm tác giả đưa ra các gợi ý:
- Nếu cần điểm khởi đầu mạnh nhất trong hai bảng thử nghiệm này, hãy thử Kev. Nó có server cục bộ và tùy chọn mô hình nhỏ, rất tiện để thử nghiệm tuyến của riêng bạn.
- Nếu ứng viên thay đổi theo thời gian thực là yếu tố then chốt và bạn muốn một mô hình gốc nhỏ gọn, hãy xem Verdict — nó xếp thứ hai ở bảng động và có hỗ trợ cả CPU lẫn trình duyệt.
- Nếu muốn một dự án Python đóng gói sẵn với nhiều tùy chọn tích hợp, Laya là lựa chọn đáng cân nhắc.
- Nếu muốn định tuyến cùng một giao diện qua nhiều backend LLM khác nhau, OpenJev là hướng phù hợp.
- Nếu muốn nghiên cứu hoặc huấn luyện kiến trúc ứng viên động cho game, NanoJev thú vị về mặt học thuật — nhưng checkpoint phát hành của nó chưa phù hợp với bài toán ngân hàng.
Điều nên mang theo vào dự án mới là một so sánh nhỏ: một bộ chấm điểm gốc, một baseline sinh JSON trực tiếp, và một đầu đọc từ mô hình bạn đã có sẵn. Cho chúng cùng yêu cầu, cùng menu. Đo đồng thời tuyến đúng, đầu ra không hợp lệ, độ trễ và số lần từ chối trả lời. Như vậy bạn biến lựa chọn kiến trúc thành một quyết định về quy trình có thể kiểm chứng được.
Kết luận cho người làm AI tại Việt Nam
Với các đội ngũ phát triển tác tử AI tại Việt Nam — đặc biệt trong lĩnh vực fintech, chăm sóc khách hàng và tự động hóa quy trình — kết quả này mang lại bài học thực tiễn rõ ràng. Không phải mọi quyết định đều cần đến sức mạnh sinh văn bản của LLM. Với các lựa chọn có giới hạn như định tuyến, chọn công cụ hay phân loại ý định, một mô hình chấm điểm ứng viên nhỏ gọn có thể vừa chính xác hơn, vừa nhanh hơn, vừa rẻ hơn đáng kể so với việc gọi LLM sinh JSON.
Tuy nhiên, nhóm tác giả nhấn mạnh đây là một thử nghiệm nhỏ với 12 ý định ngân hàng, chưa bao phủ toàn bộ danh mục ý định, số lượng ứng viên thay đổi, tài liệu dài hay hành vi đa ngôn ngữ. Các mô hình có kích thước, lịch sử huấn luyện và chính sách prompt khác nhau. Cách làm hợp lý nhất vẫn là tự chạy so sánh nhỏ trên chính dữ liệu và quy trình của bạn trước khi quyết định.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Nvidia, Apple, Google, Microsoft, Amazon và Meta chi tổng cộng 92 triệu USD cho dự án phòng khiêu vũ của Trump
15 tháng 10, 2026