
Sự thật về Wide Events: Vì sao "Metrics, Logs, Traces" chỉ là ba trường hợp đặc biệt
Bài viết của Ivan Burmistrov lập luận rằng mô hình ba trụ cột observability (metrics, logs, traces) mà OpenTelemetry đang phổ biến chỉ là những trường hợp đặc biệt của một khái niệm đơn giản hơn nhiều: Wide Events. Tác giả kể lại trải nghiệm sử dụng Scuba tại Meta để chứng minh rằng khi lưu trữ sự kiện rộng với đầy đủ ngữ cảnh, kỹ sư có thể truy vết sự cố mà không cần biết trước mình đang tìm gì.
Sự thật về Wide Events: Vì sao "Metrics, Logs, Traces" chỉ là ba trường hợp đặc biệt
Có một câu nói nổi tiếng của Charity Majors – đồng sáng lập Honeycomb – rằng ngành công nghệ đang trong tình trạng hỗn loạn hoàn toàn về observability. Mọi người đều bối rối: trace là gì? span là gì? log có phải là span không? Nếu đã có log thì cần trace làm gì? Nếu metric đã tốt thì trace để làm gì?
Bài viết dưới đây của Ivan Burmistrov – một kỹ sư từng làm việc tại Meta – đưa ra một góc nhìn gây tranh cãi nhưng rất đáng suy ngẫm: vấn đề không nằm ở công cụ, mà nằm ở cách chúng ta được dạy để hiểu về chúng. Và lời giải có thể đơn giản hơn rất nhiều so với những gì OpenTelemetry đang trình bày.
OpenTelemetry và nỗi ám ảnh "ba trụ cột"
Không thể phủ nhận OpenTelemetry (OTel) là nền tảng của hầu hết các stack observability hiện đại. Nhưng theo tác giả, chính cách OTel giới thiệu sản phẩm của mình đã tạo ra sự nhầm lẫn diện rộng.
Ngay từ câu mô tả đầu tiên, OTel đã phân tách rạch ròi ba loại dữ liệu: metrics, logs và traces. Trang giới thiệu về traces vẽ ra những sơ đồ span lồng nhau phức tạp, khiến traces trông như một thứ gì đó "thiêng liêng", đòi hỏi đầu tư học tập nghiêm túc và hoàn toàn tách biệt với log hay metric.
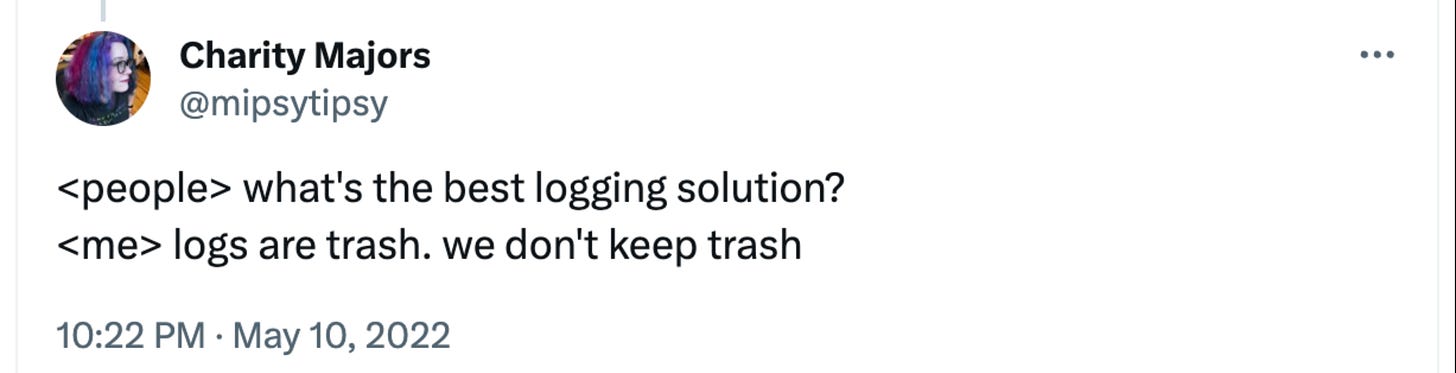 Sơ đồ traces của OpenTelemetry
Trang thuật ngữ của OTel có tới hơn 60 định nghĩa. Đó là mức độ phức tạp mà bất kỳ kỹ sư nào mới tiếp cận observability cũng phải vượt qua – trong khi giá trị cốt lõi mà observability mang lại lại nằm ở một chỗ khác: khả năng "đào sâu" vào dữ liệu, cắt lát, xây dựng góc nhìn, tương quan và tìm kiếm bất thường.
Scuba: thiên đường observability ít người biết
Khi còn làm việc tại Meta, tác giả sử dụng một hệ thống tên là Scuba – thứ mà theo anh là "món đồ số 1" mà các cựu nhân viên Meta nhớ nhất khi rời công ty.
Ý tưởng của Scuba đơn giản đến mức không cần trang thuật ngữ: nó vận hành với Wide Events. Một Wide Event chỉ là tập hợp các trường tên–giá trị, giống như một tài liệu JSON. Khi cần ghi lại thông tin gì đó – trạng thái hệ thống, một lần gọi API, một job chạy nền – bạn chỉ việc ghi một Wide Event vào Scuba.
Ví dụ với hệ thống quảng cáo, mỗi lần quảng cáo được hiển thị sẽ ghi lại một sự kiện như sau:
{
  "Timestamp": "1707951423",
  "AdId": "542508c92f6f47c2916691d6e8551279",
  "UserCountry": "US",
  "Placement": "mobile_feed",
  "CampaingType": "direct_ads",
  "UserOS": "Android",
  "OSVersion": "14",
  "AppVersion": "798de3c28b074df9a24a479ce98302b6"
}
Chúng được gọi là wide (rộng) vì nguyên tắc là hãy nhồi vào đó mọi thứ có thể liên quan. Bạn chưa biết nó sẽ hữu ích lúc nào, nhưng cứ ghi lại đã – đây chính là nền tảng để đối phó với "unknown unknowns": những thứ bạn không thể nghĩ ra ở hiện tại nhưng sẽ lộ diện trong lúc điều tra sự cố.
Sức mạnh thực sự: "slice and dice" dữ liệu
Giả sử biểu đồ số lượt hiển thị quảng cáo bất ngờ có dạng bất thường và một cảnh báo vừa kích hoạt. Phản xạ đầu tiên của bất kỳ ai dùng Scuba là lọc và nhóm dữ liệu theo đủ kiểu để xem có phát hiện gì không – dù chưa biết mình đang tìm gì.
Nhóm theo loại chiến dịch, thấy một loại trông khác lạ. Tiếp tục lọc riêng loại đó và nhóm theo hệ điều hành – Android có vấn đề, iOS thì ổn, gợi ý rằng lỗi nằm ở phía client. Nhóm tiếp theo phiên bản hệ điều hành – hóa ra chỉ phiên bản mới nhất gặp trục trặc, và chỉ với một số phiên bản ứng dụng nhất định.
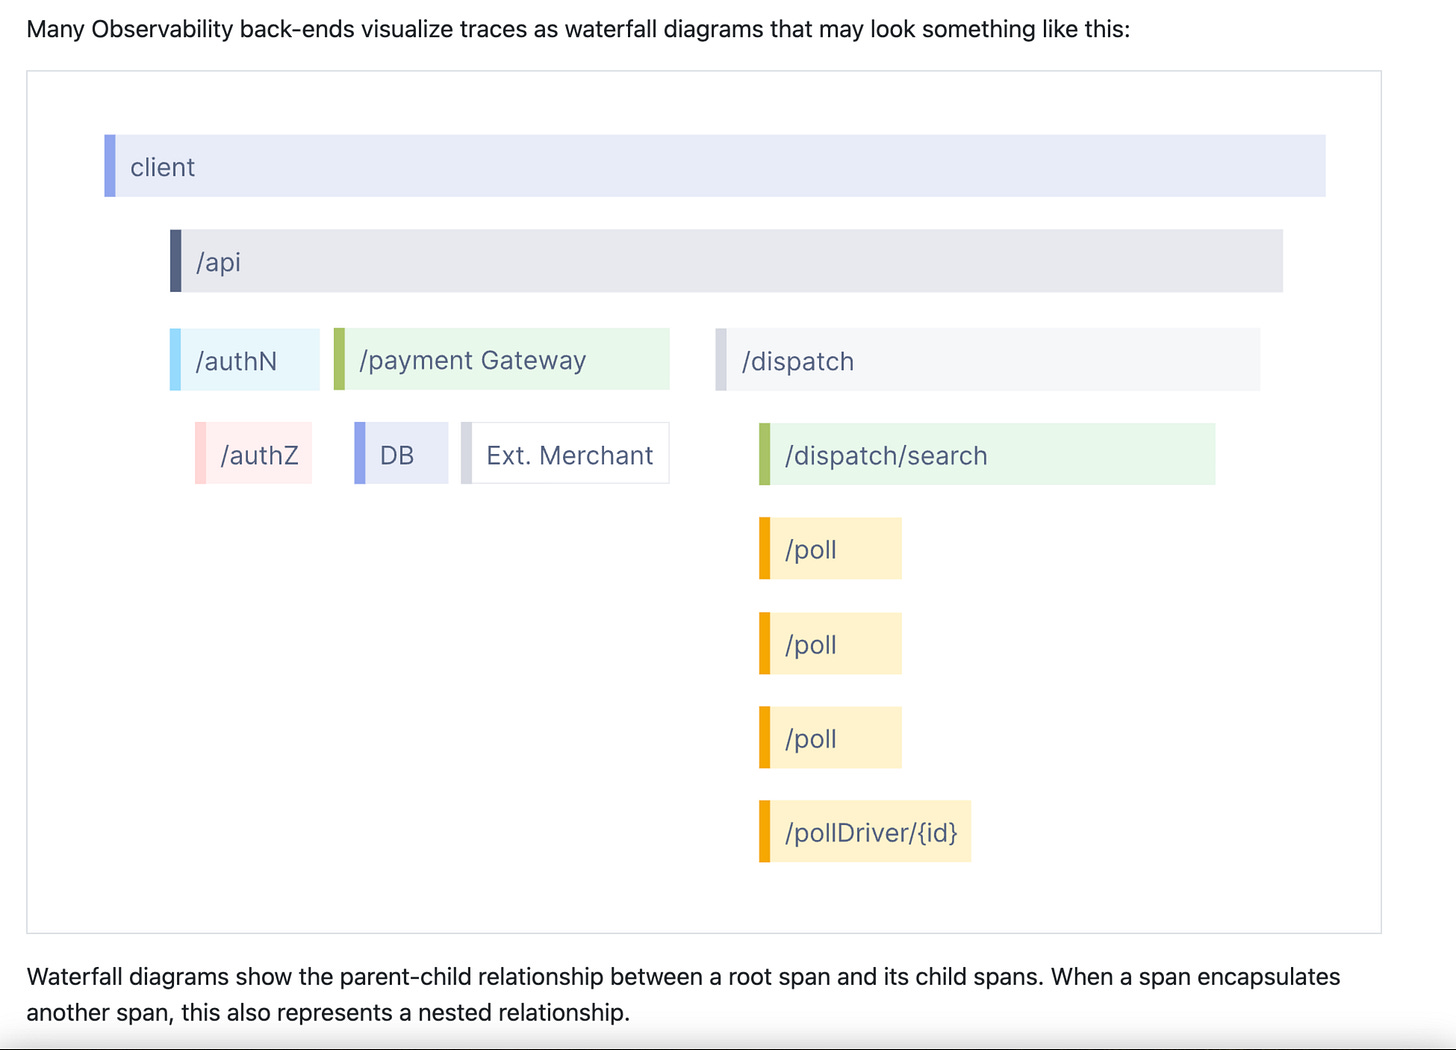 Giao diện điều tra dữ liệu dạng wide events
Chỉ trong vài phút, không cần hiểu rõ toàn bộ hệ thống, người điều tra đã khoanh vùng được phạm vi sự cố và xác định đội ngũ nào cần tiếp nhận xử lý. Điều quan trọng: không ai có thể biết trước tổ hợp kỳ quặc giữa hệ điều hành, phiên bản OS, loại chiến dịch và phiên bản app để chuẩn bị sẵn một metric riêng. Chính vì đã nhồi đủ ngữ cảnh vào Wide Events từ đầu, việc điều tra sau đó trở nên dễ dàng.
Đáng chú ý là cardinality hoàn toàn không phải vấn đề. Scuba làm việc trên sự kiện thô, không tổng hợp trước, nên bất kỳ trường nào cũng có thể có số lượng giá trị khác biệt tùy ý.
Một điểm cộng khác mà tác giả nhấn mạnh: mọi trường đều có thể khám phá được (explorable). Mọi hàm, bộ lọc, phép nhóm đều có UI trực quan để xem những giá trị nào có thể chọn. Điều này khác hẳn với các hệ thống chỉ cung cấp một ngôn ngữ truy vấn – dù là độc quyền (rất tệ) hay SQL (đỡ hơn nhưng vẫn khó dùng).
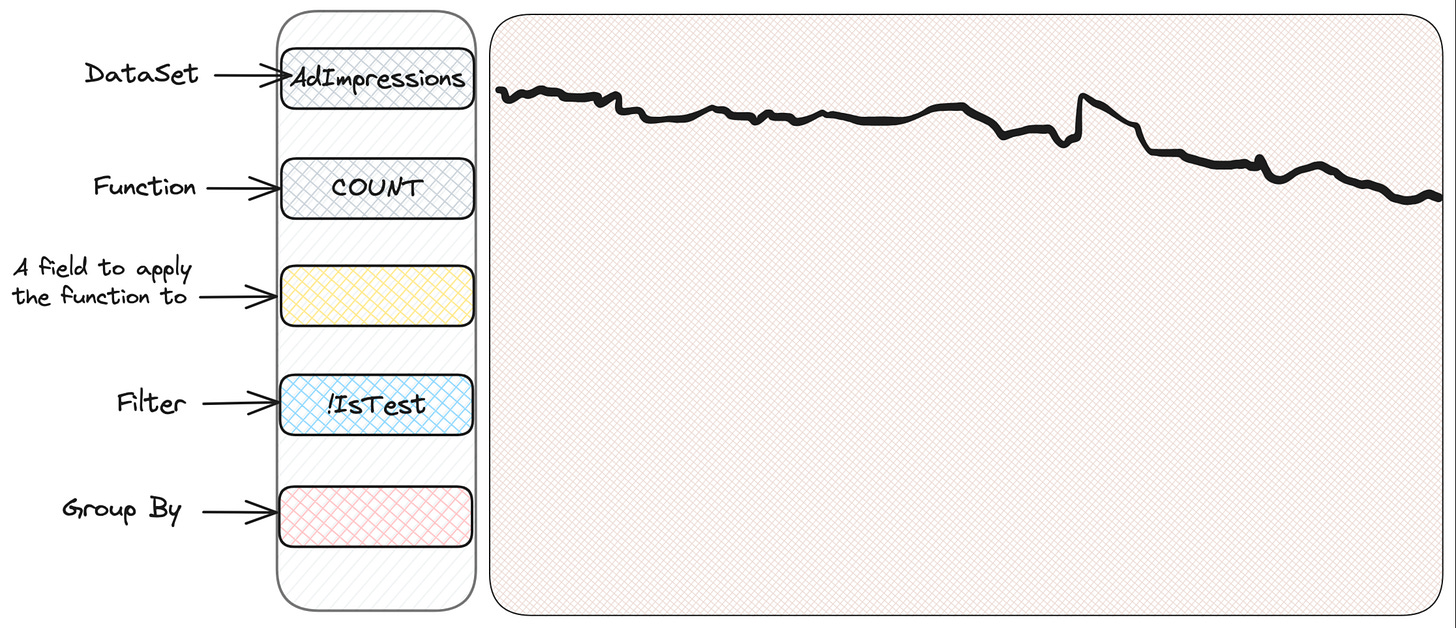 Phân tích tương quan nhiều chiều trên dữ liệu sự kiện
Cú sốc khi rời Meta
Tác giả kể lại sự bối rối khi ra khỏi Meta và đối mặt với thị trường observability bên ngoài: "Logs? Traces? Metrics? Cái quái gì thế này? Wide Events đâu rồi? Tôi có nhất thiết phải học 60 thuật ngữ đó không?"
Anh mất khá nhiều thời gian để ánh xạ mô hình tư duy từ Scuba sang OTel, và nhận ra rằng Span của OTel thực chất chính là Wide Event. Đáng tiếc là rất khó để thuyết phục người khác tiếp cận theo mô hình này khi họ đã học mô hình ba trụ cột.
Bởi vì, xét cho cùng, traces, metrics và logs đều chỉ là những trường hợp đặc biệt của Wide Events:
- Traces và Spans: chỉ là Wide Events có thêm các trường
SpanId,TraceId,ParentSpanId. Lọc theoTraceId, sắp xếp theo quan hệSpanId → ParentSpanId, bạn có ngay biểu đồ distributed tracing quen thuộc. - Logs: ở dạng structured log thì gần như đã là Wide Event. Thậm chí có thể tự động tách template từ thông điệp log, băm lại để nhóm các lỗi phổ biến nhất.
- Metrics: chỉ cần phát một Wide Event theo từng khoảng thời gian chứa trạng thái hệ thống (CPU, các bộ đếm…). Prometheus cũng làm đúng như vậy qua cơ chế scraping – chỉ khác là với Wide Events bạn không phải lo cardinality.
Và Wide Events còn làm được nhiều hơn thế: dữ liệu continuous profiling cũng có thể biểu diễn dưới dạng Wide Event và truy vấn để dựng flame graph – không cần hệ thống riêng. Khi mọi thứ nằm chung một chỗ, khả năng tương quan chéo và phân tích nguyên nhân gốc rễ trở nên mạnh mẽ hơn hẳn, đặc biệt trong thời đại các công cụ AI ngày càng giỏi tìm mối liên hệ trong dữ liệu.
Bài học cho đội ngũ kỹ thuật
Quan điểm của tác giả không phải là phủ nhận OTel – công cụ này vẫn cần thiết. Điều anh mong muốn là các nhà cung cấp observability đứng lên chống lại sự nhầm lẫn và mang đến cách tương tác đơn giản, tự nhiên hơn với dữ liệu.
Với các đội ngũ phát triển tại Việt Nam đang xây dựng hệ thống microservices và bắt đầu quan tâm đến observability, đây là gợi ý đáng cân nhắc:
- Ưu tiên ghi dữ liệu ngữ cảnh rộng ngay từ đầu thay vì chỉ log những dòng thông điệp rời rạc.
- Đầu tư vào khả năng khám phá dữ liệu – UI trực quan, truy vấn linh hoạt – hơn là chạy theo việc học thuộc hệ thuật ngữ.
- Chấp nhận rằng bạn không thể đoán trước mọi sự cố, nên hãy lưu đủ ngữ cảnh để sau này còn có thứ mà đào bới.
Hiện nay, một số nền tảng như Honeycomb hay Axiom đang theo hướng tiếp cận này. Câu hỏi còn lại là liệu phần còn lại của ngành có chịu từ bỏ nỗi ám ảnh về "ba trụ cột" hay không.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Vì sao tôi trở thành lập trình viên: Hành trình từ những chiếc đĩa mềm đến thế giới lập trình
25 tháng 10, 2026