
Tài liệu tòa án tiết lộ OpenAI và Microsoft biết mình đang tạo ra 'vòng lặp hủy diệt' cho web
Các tài liệu tòa án mới được công bố trong vụ kiện của New York Times chống lại OpenAI và Microsoft cho thấy cả hai công ty đều nhận thức rõ rằng việc thu thập dữ liệu để huấn luyện AI đang gây tổn hại nghiêm trọng cho web. Nội bộ Microsoft thậm chí gọi đây là 'vòng lặp hủy diệt' và 'hành vi trộm cắp sức lao động lớn nhất lịch sử nhân loại', nhưng vẫn tiếp tục vì lợi nhuận khổng lồ.
Các tài liệu tòa án vừa được công bố trong vụ kiện của New York Times chống lại OpenAI và Microsoft đang gây chấn động giới công nghệ. Những ghi chú nội bộ này cho thấy chính các công ty đã ý thức được rằng họ đang tạo ra một "vòng lặp hủy diệt" (doom loop) đối với toàn bộ hệ sinh thái web — nhưng vẫn tiếp tục thực hiện.
 Minh họa về vòng lặp hủy diệt của AI đối với web
Những tiết lộ gây sốc từ hồ sơ tòa án
Theo hồ sơ dài 92 trang của New York Times, nhiều nhân vật cấp cao trong cả hai công ty — bao gồm CEO Satya Nadella của Microsoft và đồng sáng lập OpenAI Sam Altman — đã có những phát ngôn đáng chú ý về cách AI đang tác động đến ngành xuất bản.
Đáng chú ý nhất là các bình luận của Brent Hecht, Giám đốc Khoa học Ứng dụng tại Microsoft. Ông gọi hành vi thu thập dữ liệu của ChatGPT và Copilot là "hành vi trộm cắp sức lao động lớn nhất trong lịch sử nhân loại", đồng thời cho rằng lập luận bảo vệ của Microsoft là "một sự nhạo báng hoàn toàn đối với khái niệm 'sử dụng hợp lý'" (fair use).
 Minh họa về số tiền khổng lồ từ AI
Tuy nhiên, Microsoft đã cố gắng tách mình khỏi những phát ngôn này. Phát ngôn viên Alex Haurek khẳng định với The Verge rằng đây chỉ là "quan điểm cá nhân của một nhân viên, không phải phân tích pháp lý và không đại diện cho quan điểm của công ty".
"Vòng lặp hủy diệt" được chính Microsoft thừa nhận
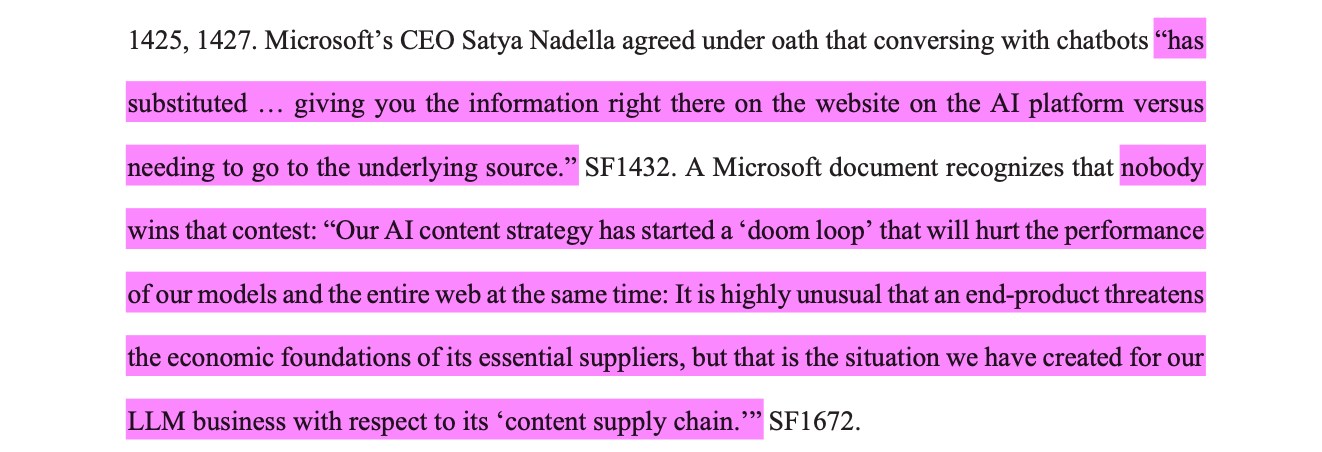
Điều gây sốc hơn cả là một tài liệu nội bộ của Microsoft thừa nhận:
"Chiến lược nội dung AI của chúng tôi đã khởi động một 'vòng lặp hủy diệt' sẽ gây tổn hại cho hiệu suất của các mô hình và toàn bộ web cùng lúc. Thật bất thường khi một sản phẩm cuối lại đe dọa nền tảng kinh tế của chính các nhà cung cấp thiết yếu của nó."
Nói cách khác, Microsoft hiểu rõ rằng nếu không còn nội dung chất lượng cao từ các nhà xuất bản, chính các mô hình AI của họ cũng sẽ suy giảm — nhưng họ vẫn chọn tiếp tục.
Google Zero đã thành hiện thực
Satya Nadella thừa nhận rằng các chatbot đã cơ bản thay thế tìm kiếm và loại bỏ nhu cầu truy cập trực tiếp vào nguồn thông tin. Các chuyên gia kinh tế và truyền thông của chính OpenAI ước tính lưu lượng truy cập giới thiệu (referral traffic) từ tìm kiếm có thể đã giảm tới 60%, và họ quy trực tiếp nguyên nhân cho các bản tóm tắt AI như AI Overviews của Google.
 Minh họa về paywall và nội dung trả phí
Những thừa nhận đáng xấu hổ khác
Hồ sơ còn tiết lộ nhiều chi tiết gây bất lợi cho cả hai công ty:
- Về bản quyền: Nhân viên OpenAI thừa nhận GPT-4 "ghi nhớ một lượng lớn dữ liệu và do đó sẽ cực kỳ giỏi trong việc tái tạo nguyên văn" nội dung có bản quyền — thừa nhận trực tiếp về nguy cơ xâm phạm bản quyền.
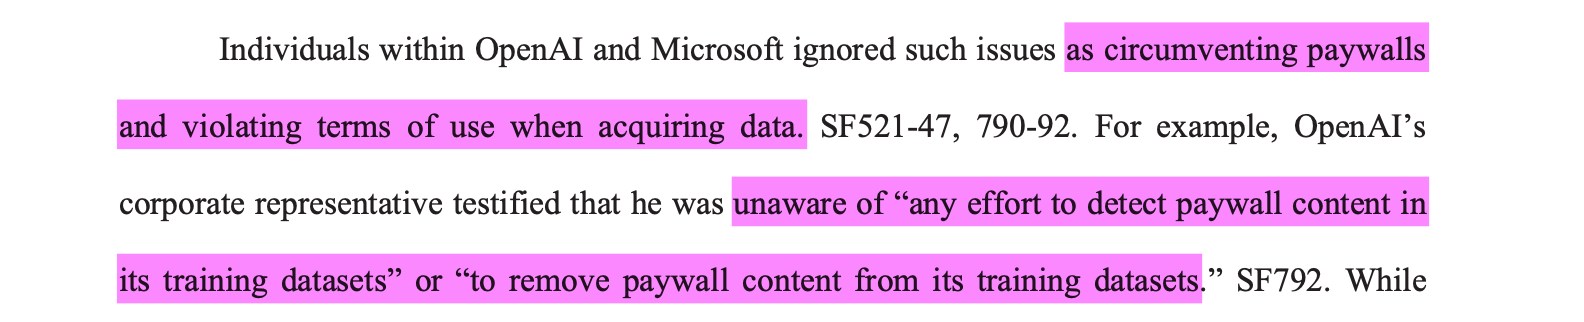
- Về paywall: Dù Nadella từng nói rằng "bất cứ thứ gì có paywall đều nên được cấp phép", một đại diện OpenAI thừa nhận họ "không biết" về bất kỳ nỗ lực nào nhằm phát hiện hoặc loại bỏ nội dung trả phí khỏi dữ liệu huấn luyện.
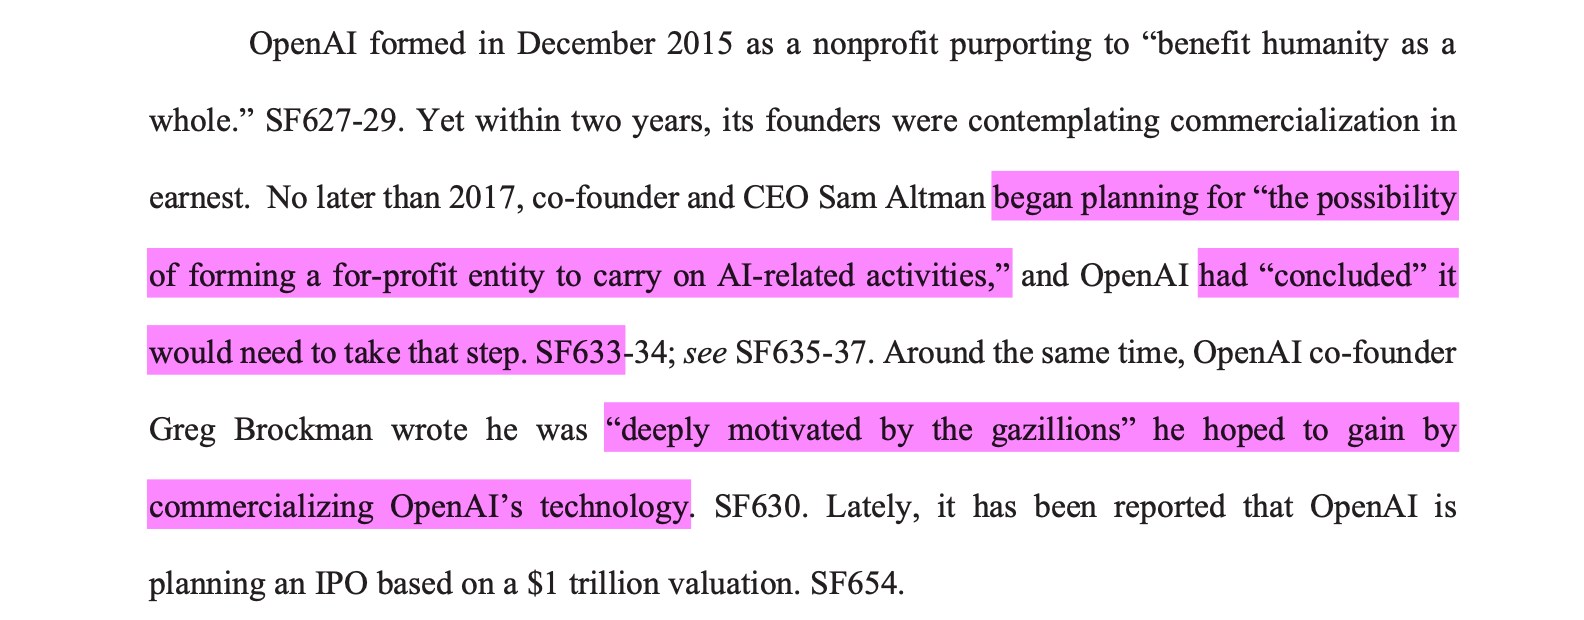
- Về động cơ: Đồng sáng lập OpenAI Greg Brockman thể hiện rõ mối quan tâm đến hàng "tỷ tỷ đô la" (gazillions) tiềm năng từ AI thương mại.
- Về chuỗi cung ứng: Microsoft thừa nhận "các mô hình ngôn ngữ lớn là sản phẩm tự hủy chuỗi cung ứng của chính nó".
- Về văn hóa: Giám đốc Chính sách OpenAI Jack Clark nhận định công ty đang "tạo ra các hệ thống thay thế sức lao động của những người định hình 'văn hóa' xã hội".
Ý nghĩa đối với Việt Nam
Câu chuyện này không chỉ liên quan đến nước Mỹ. Tại Việt Nam, các cơ quan báo chí và nhà sáng tạo nội dung cũng đang đối mặt với làn sóng tương tự khi các công cụ AI tóm tắt tin tức ngày càng phổ biến. Việc lưu lượng truy cập từ tìm kiếm sụt giảm đồng nghĩa với doanh thu quảng cáo — nguồn sống của nhiều tòa soạn — bị đe dọa trực tiếp.
Vụ kiện của New York Times có thể tạo ra tiền lệ pháp lý quan trọng, buộc các công ty AI phải đàm phán cấp phép nội dung với các nhà xuất bản thay vì thu thập miễn phí. Đây là bài học cảnh tỉnh cho các đơn vị truyền thông Việt Nam trong việc bảo vệ bản quyền nội dung số trước kỷ nguyên AI.
Kết luận rõ ràng từ hồ sơ: cả Microsoft và OpenAI đều biết mình sẽ gây tổn hại không thể khắc phục cho ngành xuất bản và hàng triệu lao động trong đó — nhưng vẫn tiến bước, bất chấp mọi hậu quả, vì mục tiêu lợi nhuận khổng lồ.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
PAC của Y Combinator rót tiền cho hàng loạt ứng viên Cộng hòa trên khắp nước Mỹ
18 tháng 9, 2026