
Thử nghiệm: Dạy AI học từ nhãn thưởng sai — và điều bất ngờ xảy ra
Một thử nghiệm thực tế kiểm chứng liệu các mô hình AI có thực sự học từ nhãn thưởng trong ngữ cảnh hay không. Kết quả cho thấy GPT-6 Sol tin tưởng gần như tuyệt đối vào nhãn thưởng, tuân theo cả khi chúng bị đảo ngược, trong khi Qwen3 4B lại có xu hướng sao chép những gì nó thấy hơn là đọc điểm số.
Thử nghiệm: Dạy AI học từ nhãn thưởng sai — và điều bất ngờ xảy ra
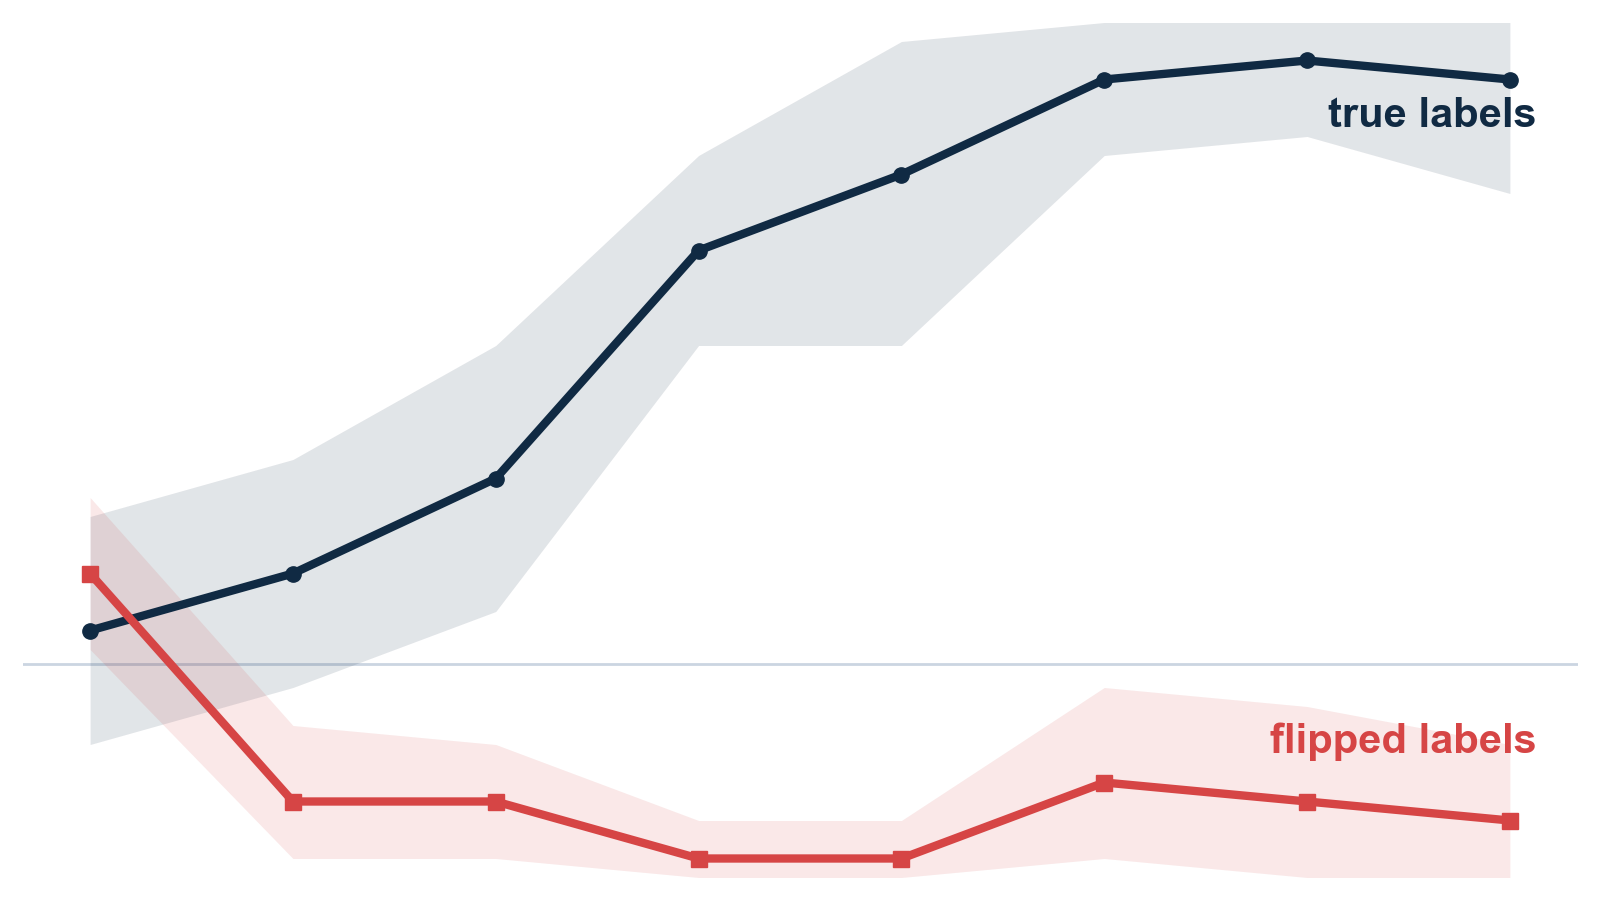
Nhiều đội ngũ phát triển AI agent lưu lại các lần thử trước đó kèm điểm số, rồi đưa chúng vào prompt ở lần thử tiếp theo với hy vọng mô hình sẽ đọc và lặp lại những gì hiệu quả. Một thử nghiệm mới đã lật ngược các nhãn thưởng này để kiểm chứng giả thuyết đó — và kết quả cho thấy hiệu ứng phụ thuộc rất nhiều vào từng mô hình.
 Minh họa thử nghiệm AI agent với nhãn thưởng
Nhãn thưởng là gì và tại sao lại đáng ngờ?
Nhãn thưởng (reward label) là một con số được ghi bên cạnh mỗi lần thử trong quá khứ — trong thử nghiệm này là 1 nếu đúng và 0 nếu sai. Bộ nhớ của agent là danh sách các lần thử được đặt vào prompt gửi kèm mỗi yêu cầu. Bản thân mô hình không được huấn luyện lại; khi mô hình tiến bộ chỉ nhờ các ví dụ nằm trong prompt, giới nghiên cứu gọi đó là học trong ngữ cảnh (in-context learning).
Một bài báo nộp ngày 8/10/2026 mang tên Do LLMs Learn from Rewards in Context? cho rằng việc đảo, ngẫu nhiên hóa hoặc loại bỏ nhãn thưởng gần như không thay đổi đường cong cải thiện trên bốn bộ benchmark và sáu mô hình. Thử nghiệm được mô tả trong bài viết này không phản bác kết luận đó, bởi nhiệm vụ được thiết kế khác đi: ẩn một quy tắc mà chỉ có nhãn thưởng mới tiết lộ được, buộc mô hình phải dựa vào nhãn nếu muốn học.
Thiết kế thử nghiệm
Mỗi lượt thử đưa cho mô hình một đơn hàng giả lập gồm vùng, kích cỡ, màu sắc và mã sản phẩm, rồi yêu cầu chọn một trong bốn tuyến giao hàng: Kiwi, Plum, Fig và Lime. Chỉ vùng hàng có ý nghĩa — kích cỡ, màu và mã chỉ là nhiễu. Một quy tắc ẩn gán mỗi trong bốn vùng giả lập với một tuyến, và quy tắc này được rút ngẫu nhiên mỗi lần chạy theo seed.
Ba mô hình tham gia thử nghiệm: Claude Haiku 5.5 (tắt chế độ suy nghĩ), GPT-6 Sol (tắt reasoning) và Qwen3 4B Instruct 2507 chạy trên GPU Colab T4 miễn phí. Toàn bộ chi phí API chỉ khoảng 2,55 USD và 0,65 đơn vị tính toán Colab.
 Sơ đồ bố cục thử nghiệm các điều kiện nhãn
Có hai thử nghiệm chính. Thứ nhất, bộ nhớ cố định với 4, 8 hoặc 16 đơn hàng cũ, nhãn được thay đổi theo sáu cách: nhãn thật, nhãn đảo, nhãn ngẫu nhiên, không nhãn, chỉ thành công và chỉ thất bại. Thứ hai, agent tự xây bộ nhớ qua 24 đơn hàng liên tiếp, sau mỗi câu trả lời thì đơn hàng, tuyến đã chọn và nhãn được thêm vào bộ nhớ.
Kết quả: Mỗi mô hình một kiểu
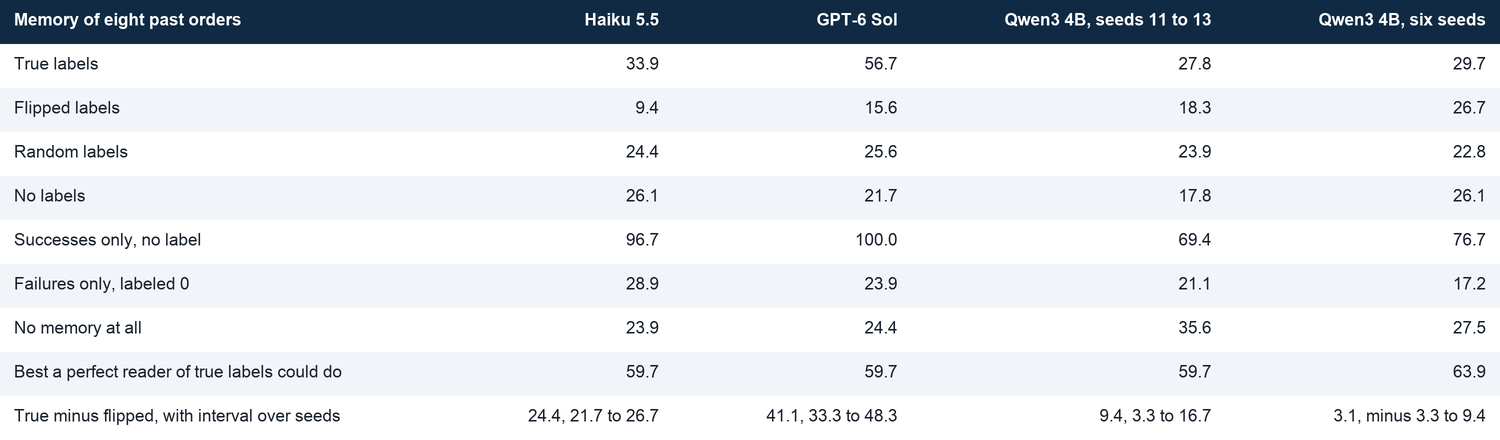
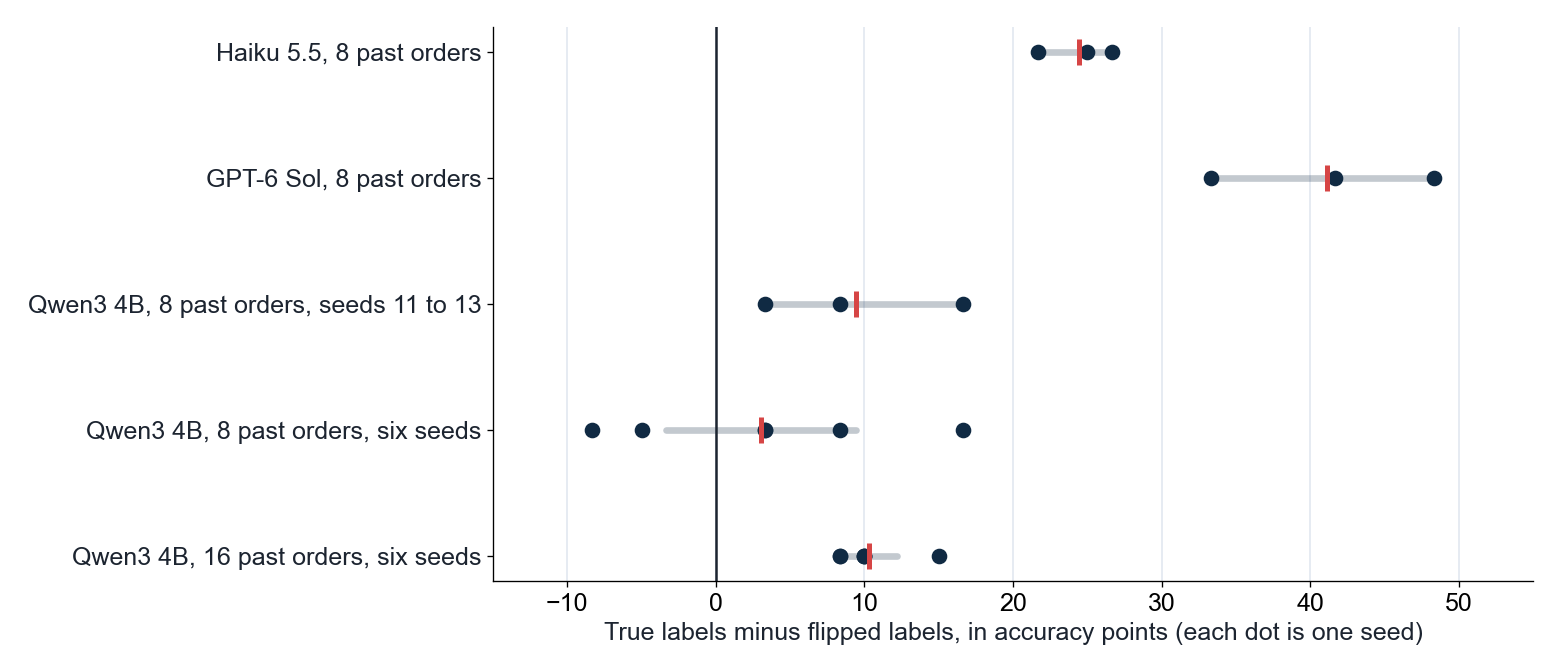
Với bộ nhớ cố định tám đơn hàng, GPT-6 Sol sử dụng nhãn gần như hoàn hảo. Với nhãn thật, mô hình đạt 56,7 điểm — sát mức trần 59,7 — còn với nhãn đảo chỉ đạt 15,6, tức là thấp hơn cả mức đoán ngẫu nhiên (25). Điều này có nghĩa mô hình đã trung thành làm theo những nhãn sai. Khoảng cách giữa nhãn thật và nhãn đảo lên tới 41,1 điểm.
Claude Haiku 5.5 cũng tuân theo nhãn nhưng kém hiệu quả hơn: 33,9 điểm với nhãn thật so với trần 59,7, và 9,4 với nhãn đảo. Khoảng cách 24,4 điểm.
Qwen3 4B lại kể một câu chuyện mờ nhạt hơn hẳn. Trên ba seed đăng ký đầu tiên, khoảng cách là 9,4 điểm, nhưng khi mở rộng ra sáu seed thì co lại còn 3,1 điểm — tức là không có lợi thế rõ ràng cho nhãn thật ở mức tám đơn hàng. Ở mười sáu đơn hàng, khoảng cách tăng lên 10,3 điểm.
 Biểu đồ khoảng cách độ chính xác giữa nhãn thật và nhãn đảo
Khi agent tự xây dựng bộ nhớ
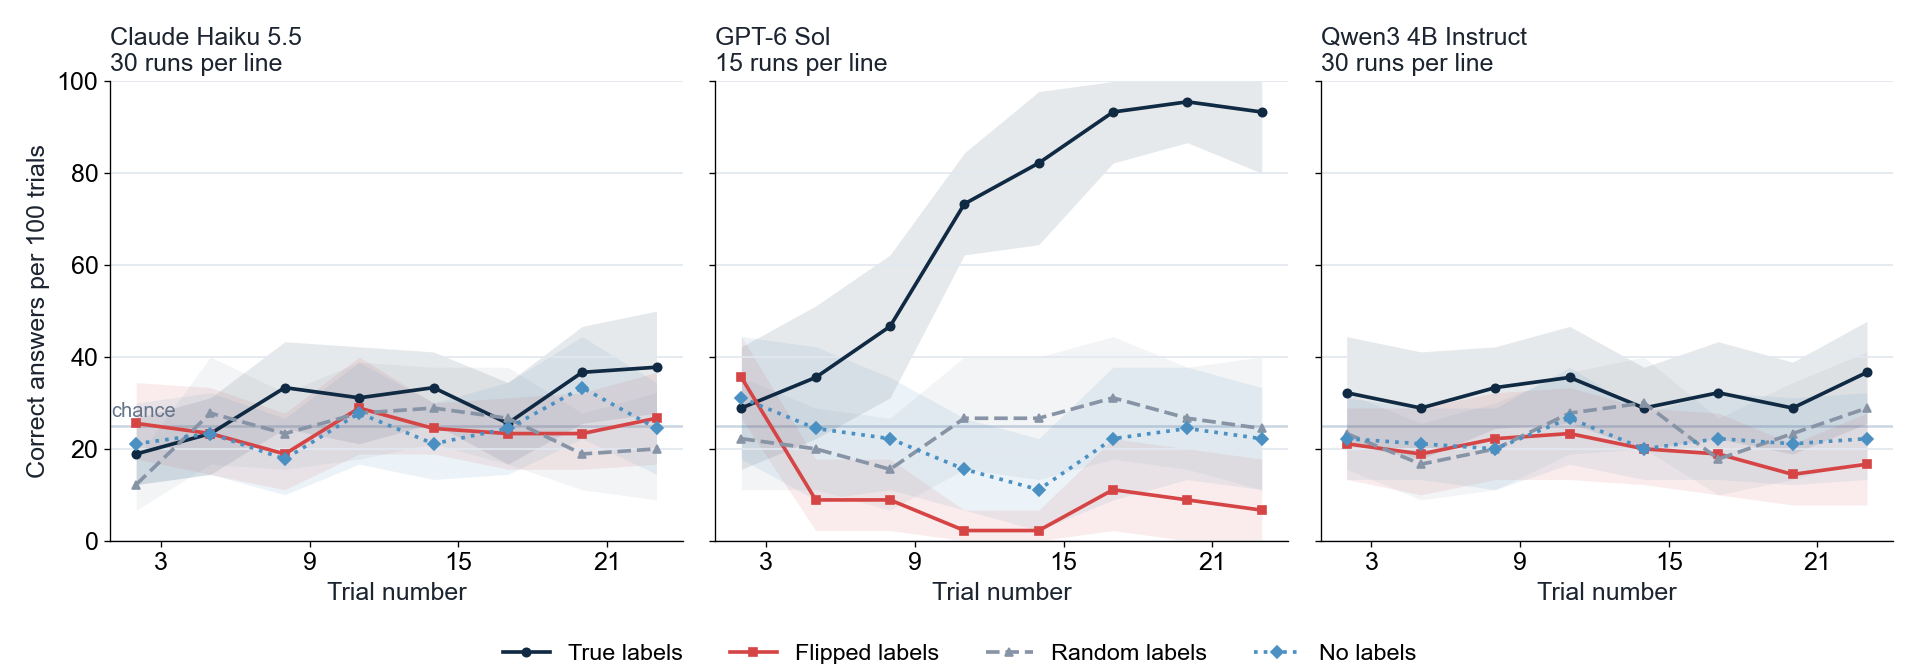
Đây là kịch bản sát thực tế hơn, vì bộ nhớ của agent trong thực tế chính là những lựa chọn trước đó của nó. GPT-6 Sol tăng vọt từ 32,2 lên 94,4 điểm với nhãn thật, nhưng với nhãn đảo lại tụt từ 22,2 xuống 7,8. Khoảng cách ở sáu lượt cuối lên tới 86,7 điểm.
Haiku cải thiện từ 21,1 lên 37,2 với nhãn thật, trong khi đường nhãn đảo của nó nằm ở mức 25,0 — đúng bằng đoán ngẫu nhiên. Đáng chú ý là trong thử nghiệm bộ nhớ cố định, Haiku rõ ràng tuân theo nhãn đảo, nhưng ở đây thì không. Tác giả đo được sự khác biệt này nhưng chưa tìm ra nguyên nhân.
Qwen3 4B gần như phẳng lì: 30,6 rồi 32,8 với nhãn thật. Khoảng cách 17,2 điểm chủ yếu đến từ việc đường nhãn đảo tụt xuống — nghĩa là nhãn thật không dạy được gì cho Qwen, nhưng nhãn sai thì làm nó yếu đi.
Hành vi thực sự đằng sau con số
Độ chính xác che giấu hành vi, nên tác giả đọc trực tiếp các phản hồi đã lưu. Qwen tái sử dụng tuyến đã thấy trong gần như mọi điều kiện — ngay cả khi chỉ hiển thị các thất bại, nó vẫn chọn tuyến bị gắn nhãn 0 tới 57,2% trường hợp. Có vẻ Qwen sao chép những gì nó thấy nhiều hơn là đọc điểm số.
Ngược lại, GPT-6 Sol né tránh thất bại rất tốt: chỉ chọn tuyến gắn nhãn 0 trong 5,6% trường hợp khi có nhãn thật. Haiku cũng né tránh tốt khi bộ nhớ chỉ chứa thất bại (4,4% so với 37,5% của đoán ngẫu nhiên), nhưng khi trộn lẫn thành công và thất bại thì mức né tránh giảm mạnh xuống còn 33,9%.
Một quy tắc đơn giản là loại bỏ mọi thất bại được hiển thị và đoán trong các tuyến còn lại sẽ đạt 42,4 điểm ở mức tám đơn hàng — cao hơn cả ba mô hình. Các mô hình có thể né một thất bại cụ thể mà không hề biến tất cả thất bại thành câu trả lời đúng.
Ba sự cố đáng chú ý
Thứ nhất, một lần chạy thử nhỏ phát hiện lỗi trong prompt: khi không có bộ nhớ, Haiku từ chối trả lời khiến mọi phản hồi không đọc được. Tác giả thêm một dòng yêu cầu mô hình đoán rồi chạy lại.
Thứ hai, một quy tắc dừng viết trước đã kích hoạt khi Qwen đạt 35,6 điểm không có bộ nhớ, cao hơn mức ngẫu nhiên tới hơn 10 điểm. Hóa ra Qwen có sở thích gắn với tên vùng, và cả ba seed đều tình cờ gán vùng Orrin cho tuyến Plum. Tác giả thêm ba seed nữa cho Qwen, đưa điểm số về 27,5 — trong ngưỡng cho phép, nhưng phần bổ sung này nằm ngoài thiết kế đăng ký trước.
Thứ ba, các khoảng tin cậy ban đầu quá hẹp do tác giả lấy mẫu lại các đơn hàng kiểm tra như thể chúng độc lập, trong khi thực tế 60 đơn trong một seed chia sẻ cùng quy tắc ẩn và bộ nhớ. Việc đổi sang lấy mẫu lại theo seed là lý do khiến kết luận về Qwen được sửa từ "không có tác dụng" thành "không có lợi thế rõ ràng".
Bài học cho người xây dựng agent
Lời khuyên rõ ràng nhất cũng là bước rẻ nhất: làm bài kiểm tra đảo nhãn. Toàn bộ thử nghiệm Haiku chỉ tốn 0,36 USD. Nếu đảo nhãn không làm thay đổi điểm số của agent, nhiều khả năng agent đang không học từ nhãn, và một thiết kế phần thưởng cầu kỳ hơn cũng sẽ không cứu được. Nếu đảo nhãn có tác động, bạn biết chắc mô hình đang đọc chúng.
Tác giả cũng khuyến nghị thử thêm bộ nhớ không nhãn và bộ nhớ chỉ chứa các lần thử thành công. Trong nhiệm vụ này, chỉ-thành-công đánh bại nhãn thật ở cả ba mô hình — nhưng chưa rõ điều đó có đúng với nhiệm vụ khác hay không, nên cần kiểm chứng trước khi thay đổi thiết kế.
Giới hạn của thử nghiệm
Thử nghiệm chỉ gồm một nhiệm vụ định tuyến giả lập với bốn tuyến và một quy tắc ẩn, trên ba mô hình. Thiết kế cho GPT-6 Sol nhỏ hơn do chi phí, Qwen có phần bổ sung sau khi phát hiện vấn đề, và tác giả không chạy lại các benchmark của bài báo gốc. Chưa có kết luận về các mô hình lớn hơn, quy tắc khó hơn, hay nhãn xung đột với niềm tin sẵn có của mô hình.
Tóm lại, tác động của nhãn thưởng phụ thuộc vào từng mô hình. Đó là một phát biểu về nhiệm vụ cụ thể này — và là lời nhắc rằng đừng mặc định nhãn thưởng đang được đọc, cũng đừng mặc định chúng bị bỏ qua. Hãy đo lường trên chính agent của bạn trước khi thiết kế hệ thống dựa trên giả định.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Tuần lễ bùng nổ của Spring: Hàng loạt bản Release Candidate đầu tiên cho Boot, Framework, AI và hơn thế nữa
31 tháng 10, 2026