
Tối ưu hóa prompt lookup drafting trong llama.cpp nhanh hơn 42 lần
Một loạt tối ưu hóa hiệu năng dựa trên ý tưởng của Daniel Lemire và Martin Ankerl đã giúp tính năng prompt lookup decoding trong llama.cpp nhanh hơn tới 42 lần và dùng ít bộ nhớ hơn 2,6 lần. Sau đó, chính Daniel Lemire gửi PR bổ sung, nâng mức tăng tốc tổng thể lên tới 140 lần.
Tối ưu hóa prompt lookup drafting trong llama.cpp nhanh hơn 42 lần
Trong các engine suy luận (inference engine) phổ biến như llama.cpp và vLLM, cùng nhiều thư viện học máy như Transformers của Hugging Face, tính năng prompt lookup decoding (còn gọi là n-gram speculation) giúp sinh token nhanh hơn đáng kể. Một bài viết kỹ thuật mới đây đã trình bày cách tối ưu phần drafting của tính năng này, đạt tốc độ nhanh hơn tới 42 lần và tiết kiệm bộ nhớ tới 2,6 lần, chỉ nhờ những thay đổi tưởng chừng rất đơn giản.
Đáng chú ý, sau khi bài viết được công bố, Daniel Lemire — tác giả của nhiều cấu trúc dữ liệu hiệu năng cao nổi tiếng — đã gửi một PR bổ sung, tiếp tục đẩy tốc độ drafting lên nhanh hơn 4,2 lần nữa. Cộng dồn lại, mức tăng tốc tổng thể có thể lên tới 140 lần so với phiên bản gốc.
Prompt lookup decoding là gì?
Prompt lookup decoding là một trường hợp đặc biệt của speculative decoding, sử dụng một mô hình draft cực kỳ đơn giản: mô hình n-gram. Thay vì dùng một mạng nơ-ron nhỏ để đoán token tiếp theo, phương pháp này dựa trên thống kê tần suất xuất hiện của các chuỗi token trong một corpus văn bản.
Cách hoạt động rất trực quan: engine chọn một corpus, phân tích thành các n-gram, đếm tần suất mỗi n-gram, rồi khi cần đoán token tiếp theo sau một chuỗi n-1 token, nó chọn token xuất hiện thường xuyên nhất sau chuỗi đó trong corpus.
llama.cpp duy trì ba loại cache n-gram:
- Context cache: lưu n-gram kích thước 1 đến 4 của các token hiện tại đang được xử lý, cập nhật liên tục khi model sinh token mới.
- Dynamic cache: lưu số đếm n-gram từ các lần chạy trước, ví dụ các cuộc hội thoại cũ.
- Static cache: lưu n-gram kích thước 2 từ một corpus văn bản tĩnh, được xây dựng bằng công cụ
llama-lookup-create.
 Quy trình drafting và tổng hợp kết quả
Khi drafting, llama.cpp chấm điểm từng token ứng viên dựa trên số đếm trong context cache hoặc dynamic cache, có trọng số ưu tiên các token đồng thuận với static cache. Token thắng phải vượt qua hai ngưỡng cấu hình: số lần n-gram xuất hiện tối thiểu và tỷ lệ xuất hiện tối thiểu của token đó. Engine thử lần lượt n = 4, 3, 2, 1 và chọn ứng viên đầu tiên đạt điều kiện.
Tối ưu 1: Loại bỏ việc copy map không cần thiết
Các cache n-gram trong llama.cpp hiện được cài đặt dưới dạng std::unordered_map lồng nhau — map ngoài ánh xạ n-gram tới map trong, chứa các token theo sau và số đếm của chúng.
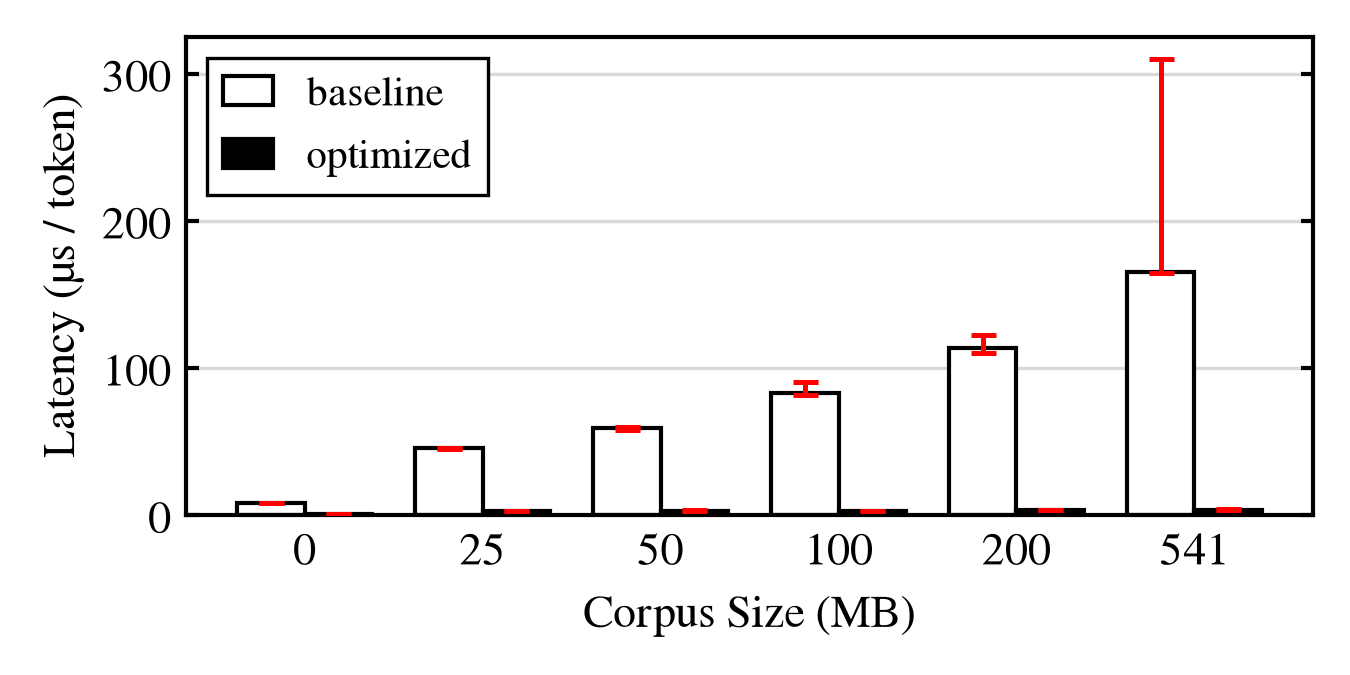
Tác giả bài viết phát hiện map trong bị copy không cần thiết ở nhiều chỗ trong mỗi bước drafting. Ông sửa lại để đọc chúng qua tham chiếu thay vì sao chép. Kết quả tức thì: drafting nhanh hơn 4,5 đến 25,6 lần tùy kích thước corpus. Tác giả thậm chí gọi thay đổi này gần giống một bản sửa lỗi hơn là một tối ưu hóa.
Tối ưu 2: Thay thế unordered_map bằng unordered_dense
std::unordered_map của thư viện chuẩn C++ nổi tiếng là chậm vì dùng phương pháp chaining để xử lý xung đột, với các bucket là linked list — rất thân thiện với cache.
Tác giả cân nhắc giữa Swiss Tables của Google (mới được thêm vào Golang) và unordered_dense của Martin Ankerl. Ông chọn ankerl::unordered_dense vì thiết kế và hiệu năng tốt, đồng thời tránh phải thêm toàn bộ thư viện abseil làm dependency cho llama.cpp.
Kết quả:
- Load static n-gram cache nhanh hơn 1,41 đến 1,65 lần
- Drafting token mới nhanh hơn 1,02 đến 1,13 lần
- Static cache dùng ít bộ nhớ hơn 1,07 đến 1,11 lần
Một chi tiết đáng lưu ý: tác giả dùng biến thể segmented_map thay vì map mặc định, vì map mặc định giữ mọi entry trong một vector tự nhân đôi khi đầy — với corpus 541 MB, lần nhân đôi cuối khiến bộ nhớ tăng vọt 1,16 lần so với baseline. Biến thể segmented_map tăng trưởng theo từng đoạn 4096 byte, giúp đỉnh bộ nhớ thấp hơn nhiều.
Tối ưu 3: Vector sắp xếp thay cho hash map ở lớp trong
Phân tích phân bố cho thấy 64% n-gram kích thước 2 trong static cache chỉ có một token theo sau duy nhất. Với những n-gram này, việc duy trì cả một hash map cho lớp trong là cực kỳ lãng phí bộ nhớ — một std::vector đơn giản là đủ.
Tuy nhiên phân bố có đuôi rất nặng: một số 2-gram phổ biến có hàng nghìn token theo sau khác nhau. Nếu dùng vector thường, tìm kiếm ở phần đuôi sẽ cực chậm. Vì vậy tác giả dùng vector sắp xếp để giữ độ phức tạp tìm kiếm ở mức O(log n).
Phiên bản đầu dùng std::lower_bound lại chậm hơn baseline 0,89 lần. Nguyên nhân nằm ở cách vòng lặp binary search phụ thuộc vào kết quả so sánh: độ dài còn lại phụ thuộc vào từng phép so sánh, nên CPU không thể tính trước số vòng lặp, và thường gặp cache miss với vector hàng nghìn phần tử.
 So sánh hiệu năng trước và sau tối ưu
Giải pháp là tách độ dài khỏi phép so sánh: n luôn giảm theo cùng một lượng bất kể kết quả so sánh. Với 8 phần tử, tìm kiếm luôn mất đúng 3 vòng lặp (8 → 4 → 2 → 1), cho phép CPU chạy trước mà không phải chờ dữ liệu từ bộ nhớ về.
Kết quả so với flat hash map:
- Drafting nhanh hơn 2,09 lần khi không có static cache, 1,19 đến 1,25 lần khi có static cache
- Đỉnh bộ nhớ giảm tới 1,97 lần
- Thời gian load static cache gần như không đổi
Tối ưu 4: Dùng constmap với binary fuse filter
Daniel Lemire công bố một cài đặt tối ưu cho map bất biến từ chuỗi sang số nguyên 64-bit tên là constmap, xây trên nền binary fuse filter. Vì static cache không bao giờ thay đổi sau khi load, đây là ứng dụng hoàn hảo.
Tác giả thay map ngoài của static cache bằng một constmap đã được kiểm chứng. Toàn bộ 2-gram trong cache được đóng gói vào một mảng liên tục các cặp (token, count). Ví dụ, nếu "of the" được theo sau bởi "city" 6 lần, "war" 3 lần và "year" 1 lần, thì:
- Các follower của ("of", "the") bắt đầu tại vị trí 1000 của mảng và có 3 phần tử
- Constmap lưu vị trí 1000 và số đếm 3 gộp trong một giá trị 64-bit: vị trí chiếm 40 bit cao, số đếm chiếm 24 bit thấp
File static cache chỉ gồm một header nhỏ, mảng cặp (token, count), và constmap đã serialize nối tiếp nhau. Khi load, toàn bộ file được đọc vào một buffer duy nhất và constmap được mở ngay trong buffer đó.
 Tiết kiệm bộ nhớ nhờ cấu trúc dữ liệu mới
Kết quả so với vector sắp xếp:
- Load static cache nhanh hơn 6,32 đến 16,12 lần — từ 3,76 giây xuống 0,23 giây với corpus 541 MB
- Bộ nhớ static cache gần bằng kích thước file: 463 MB cho file 467 MB
- Đỉnh bộ nhớ giảm tới 1,30 lần, từ 1,71 GB xuống 1,31 GB
- Drafting có static cache nhanh hơn 1,06 đến 1,20 lần
- Tỷ lệ chấp nhận (acceptance rate) giống hệt phiên bản vector sắp xếp
Đóng góp của Daniel Lemire: kiểm tra ngưỡng trước khi chấm điểm
PR bổ sung của Daniel Lemire dựa trên một quan sát đơn giản nhưng hiệu quả. Thay vì tính điểm cho tất cả token ứng viên của một n-gram rồi mới kiểm tra ngưỡng, ông làm ngược lại:
- Kiểm tra trước xem follower phổ biến nhất có vượt qua ngưỡng tỷ lệ
p_nhay không. Nếu không, mọi ứng viên khác cũng sẽ trượt, nên có thể bỏ qua toàn bộ việc chấm điểm. - Kiểm tra trước tổng số đếm của n-gram có đạt ngưỡng
a_nhay không. Nếu chưa đạt, bỏ qua chấm điểm luôn.
Kết quả: drafting nhanh hơn tới 4,2 lần khi có static cache và tới 1,9 lần khi không có, cộng dồn trên các tối ưu trước đó.
Với người dùng llama.cpp, những cải thiện này đồng nghĩa thời gian khởi động giảm mạnh khi nạp static cache lớn, và tốc độ sinh token cao hơn — đặc biệt hữu ích khi chạy mô hình trên máy cá nhân hoặc thiết bị có RAM hạn chế.
Ý nghĩa với cộng đồng
Toàn bộ thử nghiệm được chạy trên Apple M4 Pro (14 lõi, 48 GB RAM), đánh giá bằng cách build static cache từ WikiText-103 và replay tập test qua công cụ llama-lookup-stats. Tác giả cũng thử nghiệm với các corpus 25, 50, 100, 200 MB và 541 MB để quan sát ảnh hưởng của kích thước dữ liệu.
Điểm đáng học hỏi ở đây là các tối ưu hóa đều không thay đổi thuật toán drafting — tỷ lệ chấp nhận giữ nguyên hoàn toàn. Thành quả đến từ việc hiểu rõ hành vi vi phần cứng (cache miss, branch prediction), chọn cấu trúc dữ liệu phù hợp với phân bố thực tế, và loại bỏ những thao tác thừa như copy map.
Với những ai quan tâm sâu hơn, toàn bộ mã nguồn, dữ liệu benchmark và các PR đều được công khai, kèm hướng dẫn trích dẫn dưới dạng BibTeX cho các nghiên cứu tiếp theo.

