
Tối ưu và đo lường hiệu năng message bus quan trọng bằng chiến lược đánh chỉ mục mới
Một thực tập sinh tại Jane Street đã cải tiến hệ thống nhắn tin nội bộ Aria bằng cách thêm cấu trúc chỉ mục và thuật toán chia cây chủ đề thích ứng, giúp giảm 30% mức sử dụng CPU và rút ngắn đáng kể độ trễ khi khôi phục dữ liệu cho khách hàng.
Aria là khung nhắn tin nội bộ kiêm hệ thống lưu trữ của Jane Street, xử lý hàng terabyte dữ liệu mỗi ngày. Khi số lượng khách hàng tăng nhanh, nhóm phát triển buộc phải tìm cách tái kiến trúc hệ thống để đáp ứng khối lượng và thông lượng ngày càng lớn. Trong kỳ thực tập mùa hè 2026, Theodor Totev đã tập trung vào việc dùng chỉ mục và chia cây để giải quyết một bài toán cụ thể: làm sao để khách hàng đọc một tập con thông điệp với chi phí thấp hơn.
Kết quả là mức sử dụng CPU giảm 30% khi chạy trên khối lượng công việc thực tế, trong khi vẫn giữ được tiêu chuẩn chính xác cực cao mà một hệ thống then chốt như vậy đòi hỏi.
Lọc thông điệp làm quá tải máy chủ
Khi Aria gửi thông điệp cho khách hàng qua TCP, hệ thống giữ luồng gần nhất — gọi là stream tip — trong một bộ đệm vòng trên bộ nhớ. Nếu khách hàng bị tụt lại, họ có thể yêu cầu các thông điệp gần đây từ bộ đệm này để bắt kịp. Quá trình này gọi là tip recovery.
Vấn đề nằm ở chỗ Aria lưu toàn bộ luồng thông điệp, trong khi khách hàng thường chỉ quan tâm đến một tập con nhỏ hơn nhiều. Aria chia luồng thành các topic theo dạng không gian tên phân cấp giống như hệ thống tập tin. Khách hàng có thể đăng ký một topic riêng lẻ hoặc cả một cây con gồm mọi topic bên dưới, tương tự như globstar. Aria sẽ lọc toàn bộ luồng xuống chỉ còn các thông điệp thuộc những topic đã đăng ký.
Ban đầu, việc lọc này được thực hiện bằng một lượt quét tuyến tính đơn giản. Dù kém hiệu quả về mặt thuật toán, cách này lại thân thiện với bộ nhớ đệm CPU nên chạy khá nhanh. Tuy nhiên, khi số khách hàng thực hiện tip recovery tăng lên, máy chủ bắt đầu quá tải. Một số máy chủ đạt mức sử dụng CPU 100%, khiến khách hàng "rơi khỏi đỉnh" và không thể bắt kịp. Thêm máy chủ chỉ là giải pháp tạm thời, và rõ ràng cần phải suy nghĩ lại toàn bộ mã tip recovery.
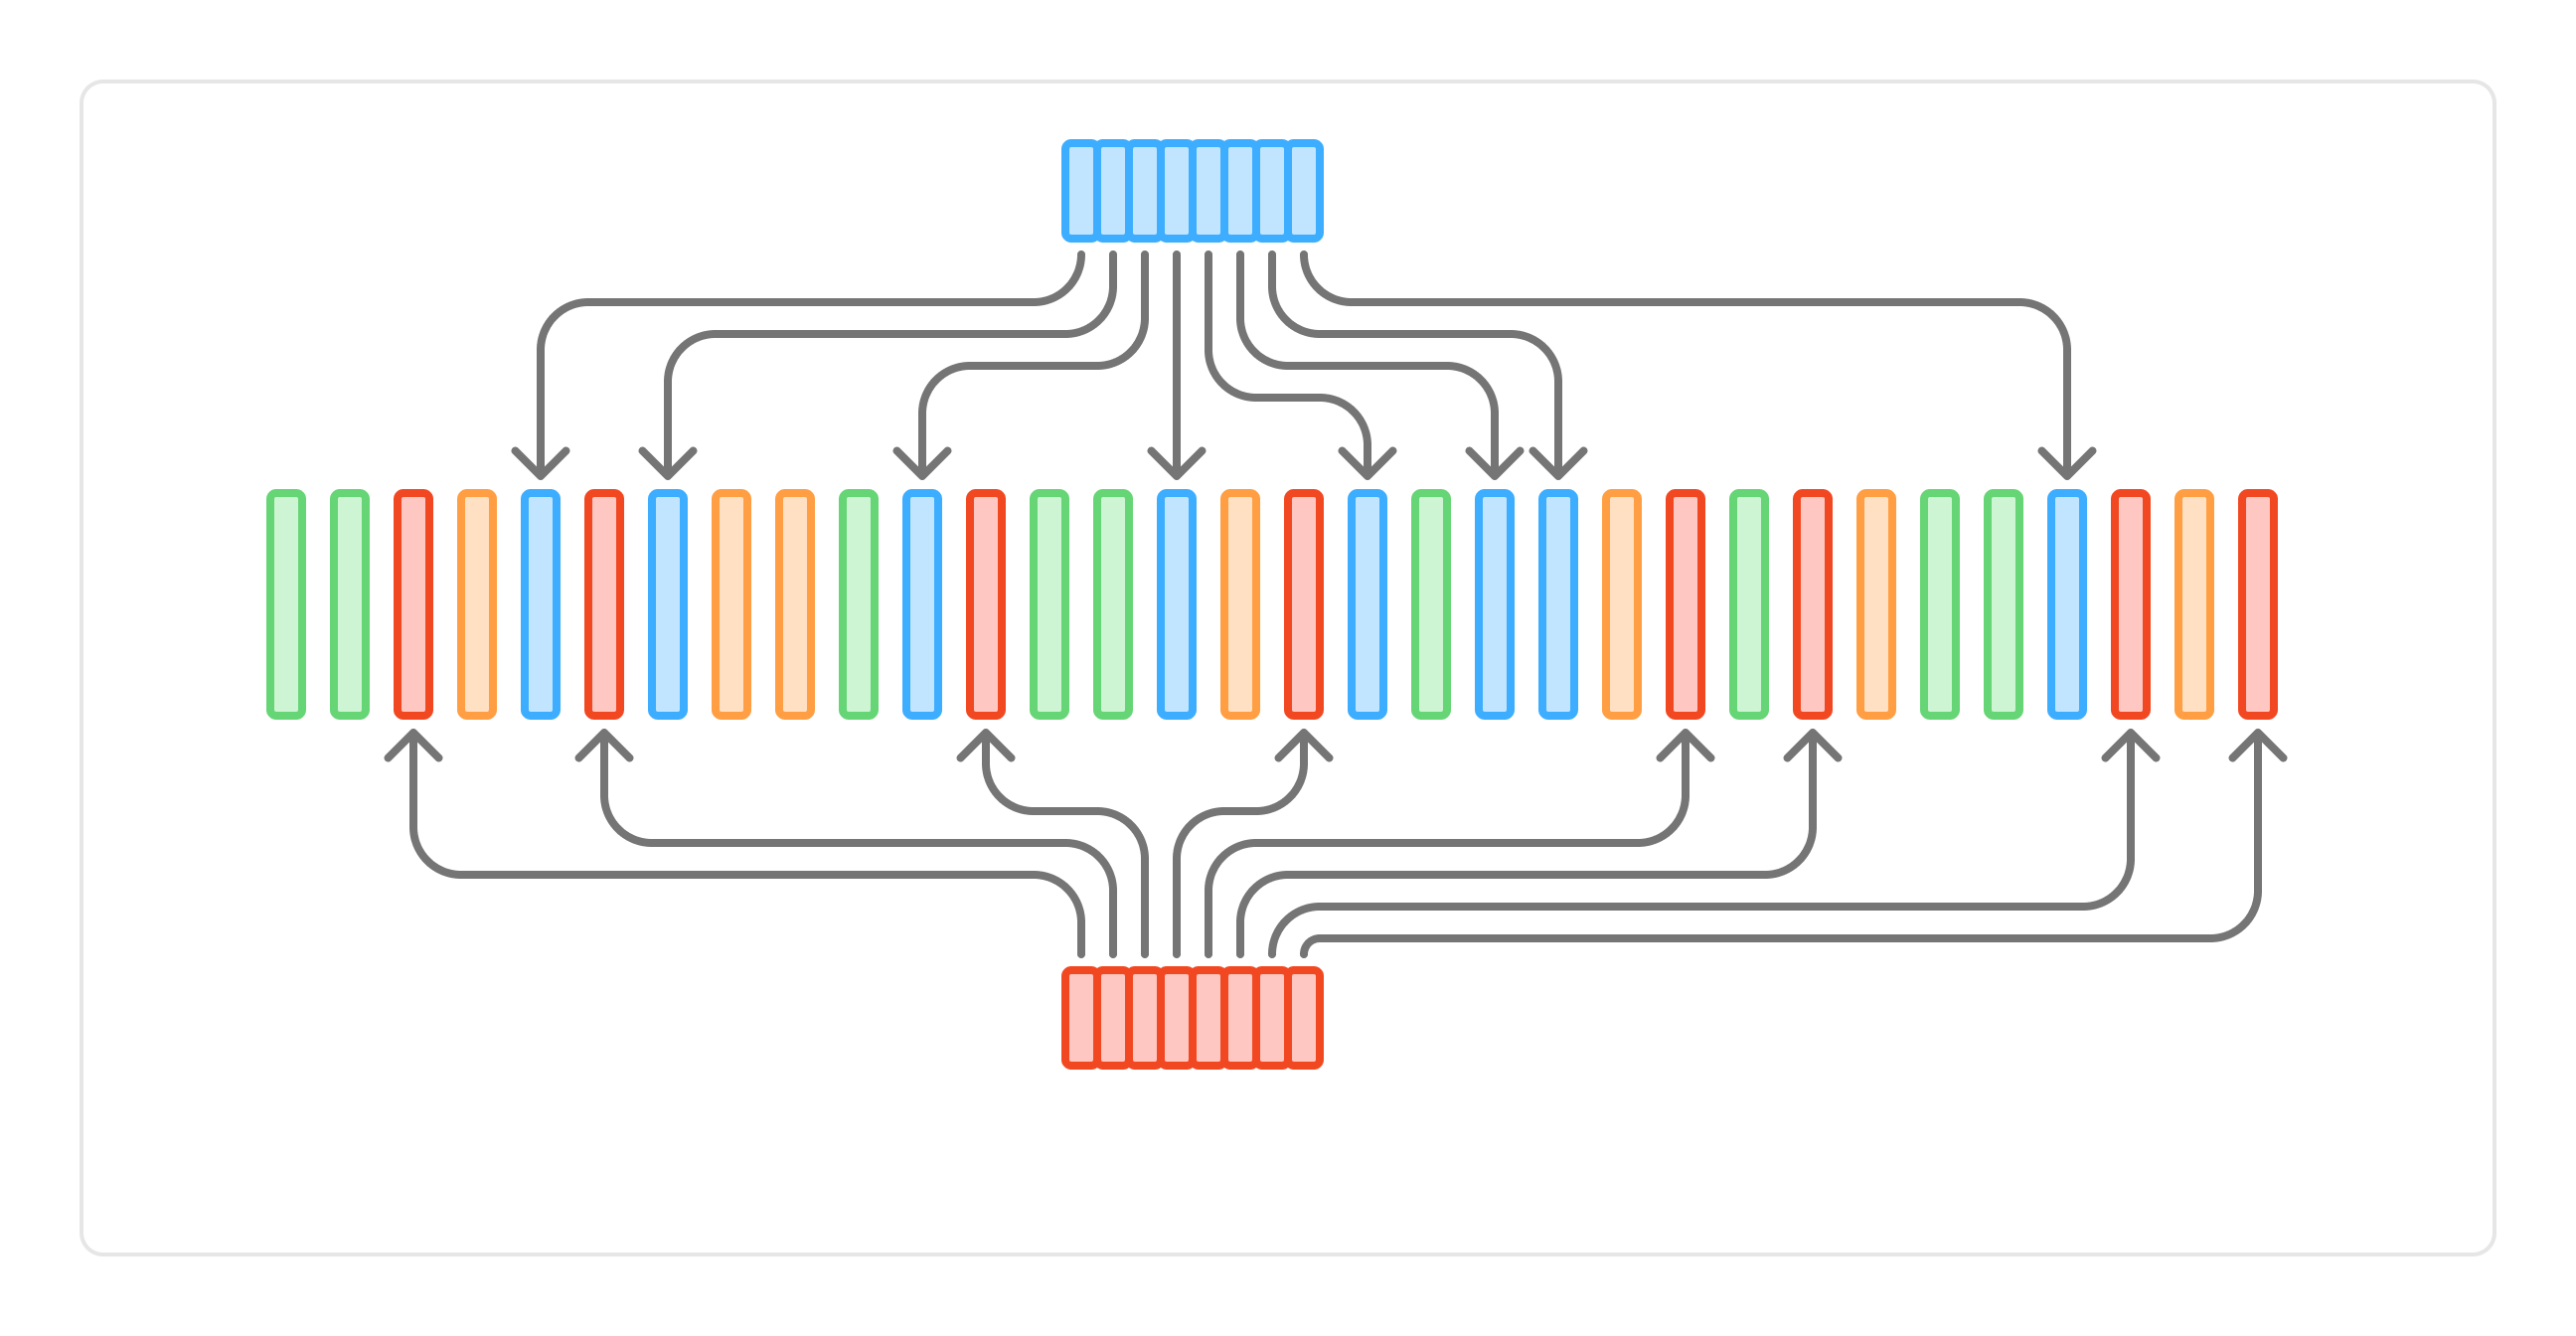
Theodor giải quyết vấn đề bằng cách thêm các cấu trúc dữ liệu chỉ mục để Aria lọc thông điệp hiệu quả hơn. Cách tiếp cận ngây thơ là tạo chỉ mục cho từng topic, nhưng một cá thể Aria có thể có gần một triệu topic, khiến cách này bất khả thi. Thay vào đó, anh tạo chỉ mục cho từng topic partition — tập hợp tất cả các topic có cùng tiền tố hai phân đoạn, với phân đoạn là một phần tên topic được ngăn bằng dấu gạch chéo. Ví dụ, app/codestore/commits và app/codestore/features đều thuộc topic partition app/codestore.
Mỗi topic partition có một chỉ mục lưu vị trí các thông điệp trong luồng Aria. Khi khách hàng yêu cầu thông điệp, Aria thực hiện phép trộn n chiều các chỉ mục bằng min-heap, cho phép tái tạo luồng thông điệp theo đúng thứ tự chỉ với những topic partition cụ thể đó.
Tạo nguyên mẫu và đo lường hiệu năng
Như mọi công việc tối ưu hiệu năng, cần phải đo lường để xác nhận cải tiến thực sự có tác dụng. Theodor bắt đầu bằng việc viết công cụ phân tích các tình huống khôi phục khác nhau, cho phép thử nghiệm nhiều cấu hình như số lượng topic partition, mức độ xen kẽ, số lượng trình đọc.
Với công cụ đo lường trong tay, anh triển khai phiên bản đầu tiên của chỉ mục topic partition. Khi phân tích, min-heap hóa ra lại là nút thắt lớn nhất. Trước đây, người ta thường chọn một cách triển khai có vẻ tốt hơn, nhưng ngày nay việc chạy thử nghiệm rất rẻ: Theodor yêu cầu một agent tạo năm cách triển khai heap khác nhau và phân tích chúng qua đêm. Kết quả là fast_heap_unboxed mang lại cải thiện hiệu năng gấp đôi cho mã khôi phục có chỉ mục.
Để đảm bảo độ chính xác, Theodor đã kiểm thử bằng nhiều expect test, chạy logic mới trong Antithesis, và cuối cùng dùng một nhóm agent phân tích mã với mức độ soi xét cao.
Dùng block pool để lưu chỉ mục
Sau khi có cấu trúc chỉ mục, cần tìm cách biểu diễn hiệu quả. Không thể tạo bộ đệm vòng cho từng chỉ mục vì bộ đệm vòng không co giãn linh hoạt, buộc phải cấp phát theo tình huống xấu nhất. Kích thước chỉ mục tỉ lệ nghịch với kích thước thông điệp: thông điệp càng nhỏ thì càng nhiều thông điệp nằm trong tip store, dẫn đến chỉ mục càng lớn. Một thông điệp Aria có thể chỉ 32 byte, và nếu toàn bộ tip store chứa thông điệp nhỏ như vậy, chỉ mục tương ứng sẽ lên tới 2GB — quá lãng phí bộ nhớ.
Thay vào đó, nhóm dùng một pool chia sẻ các block, mỗi block chứa 1024 mục. Các chỉ mục trỏ tới một block và chèn giá trị vào đó. Khi tất cả thông điệp trong một block đã rời khỏi bộ đệm vòng, block có thể được lấy ra khỏi chỉ mục và tái sử dụng cho chỉ mục khác.
Đọc thông điệp cũ mất quá nhiều thời gian
Công việc đánh chỉ mục giải quyết được vấn đề tip recovery, nhưng còn một vấn đề khác: khách hàng cần thông điệp trước stream tip phải chờ quá lâu.
Khi khởi động lại, khách hàng thường yêu cầu toàn bộ thông điệp từ đầu tuần cho các topic đã đăng ký — quá trình gọi là initial recovery. Quá trình này có thể liên quan đến hàng triệu, thậm chí hàng tỉ thông điệp, và việc đọc gửi đi càng nhanh càng tốt. Vì khách hàng thường khởi động lại cùng lúc, khả năng mở rộng càng quan trọng.
Trong một sự cố, một lần initial recovery thường mất dưới 2,5 giây lại kéo dài hơn 13 phút. Nguyên nhân là Aria đang đọc và lọc lượng dữ liệu gấp 10 lần so với thực cần gửi. Rõ ràng cần suy nghĩ lại cách lưu thông điệp trên đĩa.
Aria lưu thông điệp trong subtree store
Ban đầu Aria lưu thông điệp trên đĩa theo các phân đoạn thời gian cho mỗi topic partition. Sau đó, một tiến trình riêng tách các phân đoạn này thành nhiều subtree store, mỗi store chứa thông điệp cho một cây con topic. Mục tiêu là cân bằng giữa việc ghi vào nhiều file, giúp lọc hiệu quả nhưng khó tái hợp thành luồng thông điệp, và ghi vào ít file, dễ tái hợp nhưng lọc kém hiệu quả.
Aria dùng một heuristic đơn giản: chọn subtree store bằng cách đọc ba phân đoạn đầu tiên của topic. Nếu topic có ít hơn ba phân đoạn, nó được đặt vào store riêng. Cách này vô hiệu khi một topic trong store có lượng thông điệp lớn hơn hẳn các topic khác. Nếu khách hàng chỉ đăng ký topic ít hoạt động, Aria phải lọc bỏ toàn bộ thông điệp của topic kia — tạo ra nhiều công việc thừa.
Hơn nữa, nhóm không hài lòng khi người dùng phải hiểu chi tiết thiết kế nội bộ của Aria để thiết kế cấu trúc topic. Họ muốn người dùng tổ chức topic theo cách hợp lý với mình và tin rằng Aria sẽ tự chia tách thông minh.
Theodor được giao phát triển thuật toán chia cây topic dựa trên khối lượng thông điệp của từng topic. Aria có thể tính khối lượng này vì quá trình xử lý phân đoạn diễn ra sau khi lưu luồng thông điệp.
Thuật toán cuối cùng
Sau khi thử nghiệm nhiều phương án, Theodor chọn giải pháp kết hợp thuật toán gom cụm tham lam với tìm kiếm nhị phân. Các topic có nhiều thông điệp nhận store riêng, còn topic nhỏ được gộp vào một store chung.
Với heuristic cũ, một topic 2,72GB nằm chung store với các topic 10MB và 28,5MB, buộc người đọc topic nhỏ phải lọc bỏ lượng lớn thông điệp. Với thuật toán chia thích ứng mới, topic 2,72GB có store riêng, còn các topic nhỏ được gộp chung.
Nhiều chiến lược kiểm thử cho thuật toán
Vì việc chia thích ứng ảnh hưởng trực tiếp đến cách lưu thông điệp, nhóm cần đảm bảo độ chắc chắn cao. Mất hoặc đảo thứ tự thông điệp sẽ gây hậu quả nghiêm trọng.
Nhóm dùng expect test để kiểm tra các tính chất như topic lớn có store riêng, topic nhỏ cùng cấp chia sẻ store. Về tính nhất quán thông điệp, một kiểm thử dựa trên thuộc tính sẵn có chèn chuỗi thông điệp ngẫu nhiên vào các topic ngẫu nhiên rồi chạy thuật toán chia. Theodor mở rộng kiểm thử để ngẫu nhiên hóa việc chia cây, xác nhận nội dung thông điệp không đổi bất kể cách chia. Cuối cùng, nhiều lần chạy trong Antithesis xác nhận thay đổi không làm hỏng các phần khác của Aria.
Kết quả tối ưu ra sao?
Mã đánh chỉ mục cho tip đã được đưa vào production. Kết quả sơ bộ trong môi trường staging cho thấy mức sử dụng CPU giảm 30% trong một số tình huống thực tế, và độ trễ tổng thể trên khách hàng giảm đáng kể. Nhóm cũng ghi nhận độ trễ đuôi kéo dài vài giây ở các máy chủ chưa triển khai đánh chỉ mục, trong khi vấn đề này không xuất hiện ở máy chủ chạy mã mới.
Tính năng chia thích ứng đã được triển khai ở staging và sẽ sớm chạy trong production.
Bài học rút ra cho các đội kỹ thuật Việt Nam: ngay cả một hệ thống then chốt đã chạy ổn định vẫn có thể tối ưu đáng kể bằng cách nhìn lại cấu trúc dữ liệu và thuật toán nền tảng. Việc dùng LLM để nhanh chóng thử nghiệm nhiều phương án — từ cách triển khai heap đến giao diện trực quan hóa thuật toán — đang trở thành một phần tự nhiên trong quy trình tối ưu hiệu năng hiện đại.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Giảm thiểu hành vi không xác định trong ngôn ngữ C: Nỗ lực biến C thành ngôn ngữ an toàn bộ nhớ
09 tháng 10, 2026