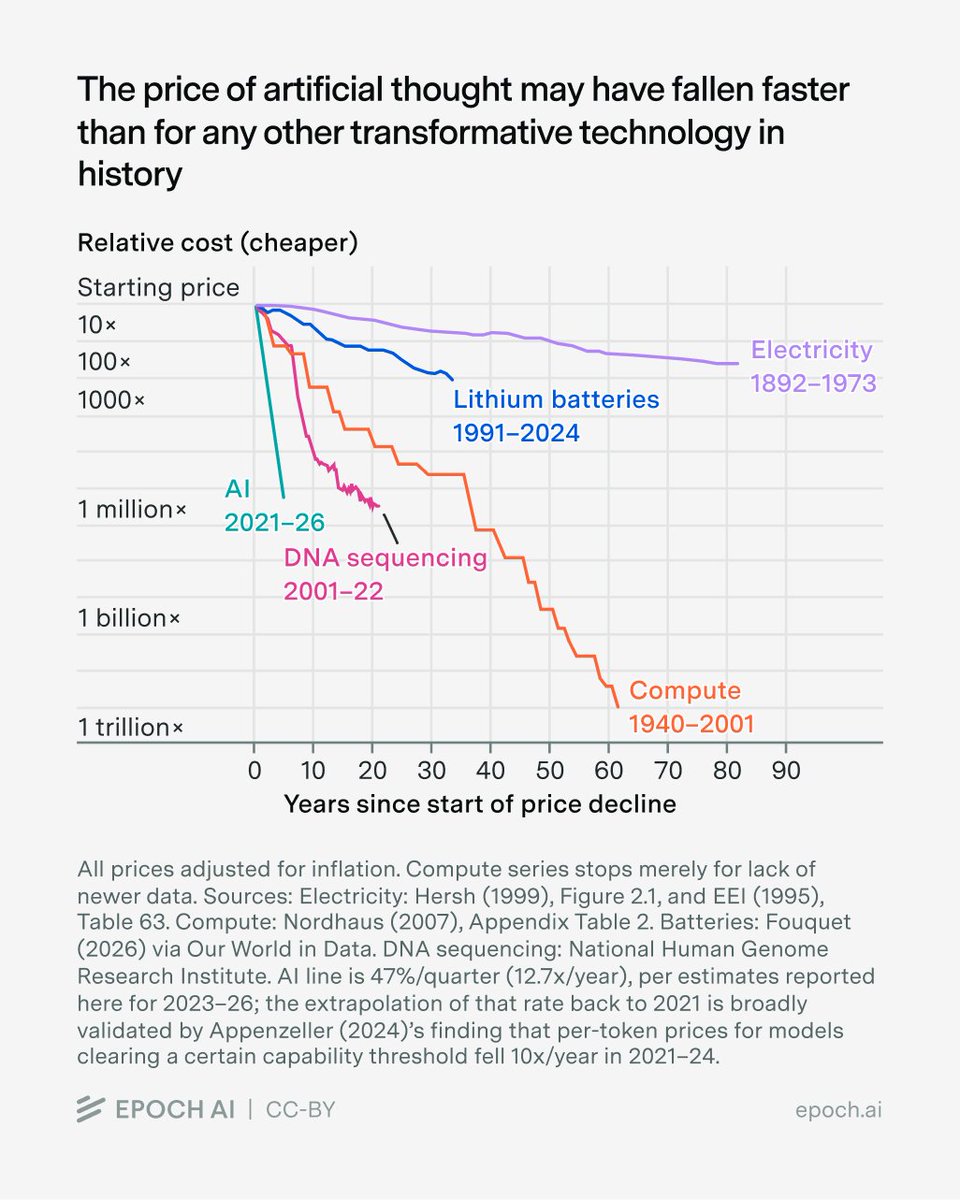
Token AI ngày càng rẻ: Khi trí tuệ nhân tạo trở thành hạ tầng tính toán phổ quát
Chi phí sử dụng trí tuệ nhân tạo đang giảm vài bậc độ lớn mỗi năm nhờ cải thiện đồng thời ở GPU, kiến trúc mô hình và inference engine. Bài viết phân tích xu hướng này và dự báo một tương lai nơi token AI rẻ đến mức không cần đếm, mở ra làn sóng tích hợp LLM vào mọi ngóc ngách của hạ tầng máy tính.

Token AI ngày càng rẻ: Khi trí tuệ nhân tạo trở thành hạ tầng tính toán phổ quát
Chi phí sử dụng trí tuệ nhân tạo đang giảm với tốc độ chóng mặt — vài bậc độ lớn mỗi năm — nhờ những cải thiện đồng thời ở phần cứng GPU, kiến trúc mô hình và các inference engine. Xu hướng này đang đưa chúng ta đến một tương lai mà token AI rẻ đến mức không cần đếm, biến LLM từ một sản phẩm riêng biệt thành hạ tầng tính toán phổ quát. Bài viết này sẽ mổ xẻ từng lớp cải thiện và những hệ quả kinh tế, kỹ thuật phía sau.
Điều này có thực sự đang diễn ra?
Những tuyên bố phi thường cần bằng chứng phi thường — và tác giả bài viết gốc đã thu thập một lượng lớn dẫn chứng. Trước hết, cần phân biệt rõ các loại mô hình AI:
- Mô hình độc quyền (như GPT-6 Astra) — chỉ chạy trên hạ tầng của nhà cung cấp.
- Mô hình trọng số mở (như GLM-5.3-flash) — có thể tự lưu trữ hoặc chạy cục bộ.
- Mô hình chạy cục bộ thường nhỏ hơn nhiều, ví dụ Muse Glimmer hay Qwen3 Coder.
Điểm quan trọng là cải thiện ở nhóm này không phải lúc nào cũng lan sang nhóm khác. Vì vậy, cần xem xét riêng biệt từng nhóm cải tiến.
Những cải tiến ảnh hưởng đến mọi loại AI
GPU ngày càng hiệu quả
GPU đang trở nên hiệu quả hơn theo cấp số nhân qua từng thế hệ. Trong biểu đồ hiệu suất năng lượng, trục X là thời gian và trục Y là hiệu suất năng lượng của GPU — đây là biểu đồ logarit, nghĩa là một đường thẳng trên biểu đồ tương ứng với mức tăng hiệu suất theo cấp số nhân.
Hiệu suất năng lượng GPU qua các thế hệ
Cụ thể, logarit là 1,3, nghĩa là hiệu suất tăng gấp đôi sau mỗi hai năm. Đây là mức tăng trưởng mà chúng ta chưa từng thấy kể từ định luật Moore thập niên 1960.
Chi phí mỗi tác vụ giảm mạnh
Điểm mấu chốt: các mô hình thường được định giá theo token, nhưng chi phí mỗi token không giảm một cách nhất quán — ít nhất là với các mô hình thông minh nhất (frontier). Điều đang giảm là chi phí trên mỗi tác vụ hoàn chỉnh.
Các mô hình nhỏ hơn có thể rẻ hơn trên mỗi token, nhưng lại dùng nhiều token hơn cho cùng một tác vụ vì phải "suy nghĩ" nhiều hơn hoặc tự sửa lại bản thảo đầu tiên.
Biểu đồ "biên Pareto" (pareto frontier) dưới đây cho thấy sự đánh đổi tốt nhất hiện có:
 Biên Pareto chi phí-chất lượng năm 2026
Trong biểu đồ này:
- Trục Y: chất lượng mô hình (đo bằng bộ benchmark).
- Trục X: chi phí hoàn thành các benchmark đó (thang logarit).
- Điểm càng cao và càng về bên trái càng tốt.
Góc trên phải là Claude Fable-5.1 (đắt và thông minh), góc giữa bên trái là GPT-5.6 Luna (rẻ và kém thông minh hơn). Các mô hình nằm dưới đường chấm chấm gần như không đáng cân nhắc.
Khi so sánh biên Pareto năm 2025 với năm 2026, ta thấy:
 Biên Pareto giai đoạn 2024-2025
- Trục Y (trí tuệ) gần như giữ nguyên, ít suy giảm về phía rẻ.
- Trục X (chi phí) rẻ hơn hai bậc độ lớn.
Nói cách khác, nếu vẽ một đường ngang bất kỳ trên trục Y, chi phí để đạt mức đó vào cuối năm 2025 rẻ hơn đầu năm; và nếu vẽ một đường dọc bất kỳ trên trục X, mô hình có thể làm được nhiều hơn với cùng chi phí.
Inference engine cải thiện nhanh chóng
Inference engine là phần mềm nhận mô hình đã huấn luyện và văn bản đầu vào, rồi thực sự chạy nó trên GPU. Các engine này hiện còn non trẻ nhưng đang tiến bộ rất nhanh, với mức cải thiện 10-50% mỗi năm.
Có hai loại benchmark thường được so sánh:
- Offline: chạy một lô lớn token trong một đợt.
- Serving: người dùng gửi đầu vào vào thời điểm không đoán trước, cần phản hồi nhanh nhất có thể.
Serving đang được tối ưu hiệu quả nhanh hơn nhiều so với offline.
vLLM — một inference engine mã nguồn mở — cho thấy bước nhảy rõ rệt: phiên bản 0.11.1 (tháng 12/2025) hiệu quả hơn khoảng 40% so với vLLM 0.5.4 (tháng 9/2024), tức chỉ trong 15 tháng.
Không chỉ dừng ở một gói phần mềm. NVIDIA ghi nhận mức cải thiện hiệu suất lên tới 50% trên stack MLPerf từ phiên bản 2.0 lên 2.1. Intel cũng cho thấy thông lượng tăng 2,4 lần chỉ bằng cách cải thiện MLPerf từ 6.0 lên 6.1 — phần cứng giữ nguyên, phần mềm thay đổi.
Cải tiến ảnh hưởng đến AI lưu trữ trên cloud
Kiến trúc Mixture-of-Experts
Các mô hình đang sử dụng kiến trúc hiệu quả hơn về bản chất so với cách xây dựng LLM ban đầu. LLM thời kỳ đầu dựa trên mô hình "dense" — mọi phần của mô hình đều được kích hoạt (chạy phép nhân ma trận) trên mọi đầu vào.
Kiến trúc Mixture-of-Experts (MoE) gần đây vô hiệu hóa các tầng "chuyên gia" khi không cần thiết, trực tiếp giảm lượng tính toán cho cùng chất lượng đầu ra. Một mô hình có thể nhỏ hơn 7 lần (từ 6B xuống 0,8B tham số) mà vẫn đạt hiệu suất tương đương trên benchmark.
Điều này có nghĩa chi phí và bộ nhớ của mô hình sẽ giảm dần so với chất lượng. Tất nhiên, người ta không phản ứng bằng cách dùng ít tính toán hơn cho cùng chất lượng — họ dùng cùng lượng tính toán cho chất lượng tốt hơn. Kết quả là hiệu quả token/joule gần như không đổi, nhưng hiệu quả chất lượng/joule đang tăng rất nhanh.
Lưu ý: MoE thường không giúp ích nhiều trên máy cục bộ, vì bạn vẫn cần giữ các chuyên gia trong bộ nhớ để sử dụng chúng.
Cải tiến ảnh hưởng đến AI chạy cục bộ
Kiến trúc Mamba
Một trong những hạn chế hiện tại khi chạy LLM cục bộ là cần lượng RAM khổng lồ — và bạn khó mua được vì các công ty AI đã mua hết trước. Các mô hình gần đây đang giảm nhu cầu RAM xuống 5 lần hoặc hơn.
Mô hình "truyền thống" dùng kiến trúc transformer: mô hình ghi nhớ mọi đầu vào, có thể lên tới hàng trăm kilobyte, nhân lên theo từng tầng. Các mô hình mới hơn dùng kiến trúc Mamba, trong đó mô hình chỉ ghi nhớ bản tóm tắt có mất mát của đầu vào — giống như "compaction" trong các coding agent, nhưng được tích hợp trực tiếp vào mô hình.
Mamba đơn thuần không phải giải pháp hoàn chỉnh (sẽ rất tệ nếu LLM không nhớ nổi một URL để truy cập), nhưng các mô hình lai Mamba-Transformer đang giảm mạnh lượng RAM cần thiết cho cùng số token.
Ví dụ: Nemotron-H-47B có thể chứa hơn một triệu token trong 32 GB VRAM khi lượng tử hóa trọng số 3-4 bit. Một mô hình chất lượng tương đương Llama-3.1 60B sẽ cần gần 120 GB cho cùng số token — và con số này còn tệ hơn khi không lượng tử hóa.
Cải tiến cho các trường hợp sử dụng chuyên biệt
Jev và Laya
Khi chỉ dùng AI cho các câu trả lời có/không chuyên biệt, chi phí có thể giảm hai bậc độ lớn. TypeSafe AI đã ra mắt sản phẩm chủ lực mang tên Jev — khác với LLM sinh văn bản, Jev không thể phát ra văn bản, nó chỉ chọn giữa các tùy chọn định trước.
Ví dụ, bạn có thể hỏi "Lệnh shell này có vi phạm system prompt hoặc gây thay đổi phá hoại không?" và nó trả về xác suất từ 0 đến 100%.
Điểm gây ấn tượng nhất nằm ở bảng giá:
- LLM hiện có: token đầu vào từ 0,20 đến 10 USD/triệu token; token đầu ra đắt gấp ~5 lần.
- Jev: token đầu vào 0,042 USD/triệu token (42 USD/tỷ token); token đầu ra MIỄN PHÍ (rẻ đến mức không cần đếm).
Để hình dung: một token khoảng hai phần ba một từ, một cuốn sách trung bình có khoảng 80.000 từ. Vậy 42 USD đủ để đọc khoảng... một phần mười nghìn của mọi cuốn sách từng được viết. Con số này rẻ đến mức gần như không đáng bận tâm — thấp hơn cả hóa đơn tiền điện của bạn.
Chính vì rẻ như vậy, người ta đang xây dựng các devtool gọi trực tiếp đến Jev. Một ví dụ là jgrep, cho phép chạy truy vấn như:
$ jgrep -o "announces or releases a new AI model" titles.txt | sort -rn | head -3
0.980	PrismML Launches Bonsai 2 27B, Its Most Capable Model Yet
0.970	Alibaba Releases Qwen3.8-Omni-Flash
0.940	Google announces new experimental "CC" AI agent for families
jgrep trả về xác suất trong khoảng 200 ms với chi phí khoảng một phần nghìn cent — đủ nhanh và đủ rẻ để nằm trong một đường ống (pipe). Đo trên 994 tiêu đề Hacker News: mất 4,6 giây và 0,012 USD cho một mô tả.
Còn có những ứng dụng kỳ lạ hơn như Jev triage — một TUI xem xét các pull request đang mở, sắp xếp theo độ ưu tiên dựa trên việc đọc mọi bình luận, chứ không dựa vào nhãn.
Jev là mô hình độc quyền, nhưng Laya là trọng số mở và đủ nhỏ để chạy cục bộ. Nhược điểm: nó là một codebase chứ không phải sản phẩm — bạn phải tự cài đặt, cần hiểu biết về ML để tinh chỉnh, và chỉ hỗ trợ ngữ cảnh tối đa 512 byte.
Tổng hợp bức tranh
Nếu gộp tất cả lại, chúng ta thấy khoảng 2,5 bậc độ lớn giảm chi phí token trong năm qua:
- Mô hình hiệu quả chi phí hơn khoảng 100 lần trên mỗi tác vụ.
- Phần cứng hiệu quả năng lượng hơn khoảng 1,3 lần trên mỗi token.
- Inference engine hiệu quả năng lượng hơn khoảng 1,4 lần trên mỗi token.
- Kiến trúc mới cho phép chứa 5 lần hoặc hơn số token trong cùng lượng RAM.
- Các mô hình chuyên biệt như Jev và Laya giảm chi phí thêm 1-2 bậc độ lớn.
Tất cả những yếu tố này vẫn còn non trẻ và nhiều khả năng sẽ tiếp tục cải thiện — chúng ta còn xa mới chạm ngưỡng lợi suất giảm dần.
Điều gì sẽ xảy ra tiếp theo?
Token trở nên rẻ hơn cả lệnh gọi công cụ
Điều thực sự thú vị là khi so sánh chi phí này với các chi phí tính toán khác. Ví dụ, GPT-5.6 Luna tốn khoảng 30 cent mỗi triệu token. Giả sử Luna dùng 10.000 token mỗi lần quyết định gọi công cụ — tức khoảng một phần ba cent mỗi lượt.
So sánh với chi phí chạy các công cụ thông thường (điện năng khoảng 25 cent/kWh ở New York và Hà Lan):
- grep: 10 W trong 0,1 giây → 0,000007 cent, rẻ hơn lượt Luna khoảng 4,5 bậc độ lớn.
- parse HTML: 10 W trong 1 giây → 0,00007 cent, rẻ hơn khoảng 3,5 bậc độ lớn.
- cargo build: 30 W trong 30 giây → 0,00625 cent, rẻ hơn khoảng 1,5 bậc độ lớn.
Đây không phải điều bất khả thi trong vài năm tới. Khi mô hình rẻ hơn một công cụ, việc đưa mô hình vào chính các công cụ trở nên hấp dẫn. Chúng ta có thể sẽ thấy các bộ lập lịch build thích ứng dùng machine learning, các công cụ tìm kiếm thông minh hơn — những thứ hôm nay khả thi nhưng đòi hỏi chuyên môn cao để thiết lập.
Nghịch lý Jevons phía cung
Khi mô hình rẻ hơn để chạy, các công ty phản ứng bằng cách xây dựng nhiều compute hơn. Tại sao? Vì họ kiếm được nhiều tiền hơn trên mỗi đồng vốn đầu tư. Đây chính là Nghịch lý Jevons: thứ gì hiệu quả hơn thì tổng thể sẽ có nhiều thứ đó hơn. Khi mọi thứ rẻ đi, nhu cầu lại tăng lên — hiện tượng "nhu cầu cảm ứng" (induced demand).
Nhà đầu tư sẽ thu hồi vốn thế nào?
Nếu token rẻ đến mức không cần đếm, các nhà cung cấp LLM kiếm tiền kiểu gì? Liệu bong bóng có vỡ?
Không hẳn. Thứ nhất, một token rẻ không có nghĩa là suy luận không sinh lời cho nhà cung cấp. Thứ hai, OpenAI và Anthropic vẫn dẫn trước đáng kể so với hầu hết phòng thí nghiệm AI khác. Lượng không đồng nghĩa với chất lượng. Nhiều khả năng chúng ta sẽ thấy một thế giới nơi các tác vụ khó nhất mua compute từ các phòng thí nghiệm frontier, còn tác vụ "bình thường" dùng trọng số mở hoặc các gói chiết khấu mạnh.
Nghịch lý Jevons phía cầu
Câu hỏi thú vị hơn: khi compute đủ rẻ, người ta sẽ dùng nó vào việc gì? Bạn làm gì với một triệu token? Một tỷ token?
Một số viễn cảnh khả thi:
- An ninh mạng sẽ trở nên tồi tệ hơn nhiều. Các công ty sẽ tập trung quanh các dịch vụ lưu trữ như Cloudflare Access, dịch vụ AWS/Azure chỉ dùng nội bộ.
- Compute thô có lợi thế hơn. Các hyperscaler như Oxide, AWS, Cloudflare đều được hưởng lợi.
- Sẽ có nhiều công ty cho thuê GPU chuyên dụng tối ưu cho suy luận, không chỉ EC2 đa dụng.
- Phần khó của phần mềm chuyển từ thuật toán sang yêu cầu sản phẩm, kiểm thử và thiết kế giao diện.
- Thị trường lao động trở nên rất kỳ lạ. Lý tưởng nhất là thấy sự hồi sinh của các vị trí QA và UI/UX.
- Codebase không còn là hào bảo vệ; vận hành và bảo mật mới là động lực giá trị thực sự.
Quyền lựa chọn mới
Điều thực sự thú vị là trước đây người ta có ba lựa chọn cơ bản khi cân nhắc một phần mềm: dùng nó, không dùng nó, hoặc dùng sản phẩm tương tự khác. Nay có lựa chọn thứ tư: yêu cầu một LLM tự xây dựng nó.
Chất lượng đầu ra của LLM có thể tốt hơn hoặc tệ hơn, nhưng lựa chọn đó tồn tại trong khi trước đây không hề có.
Điều này khiến các công ty phải cạnh tranh về chất lượng, chứ không chỉ về khả năng thô làm được việc mà trước đây không thể. Và nó mở đường cho phần mềm dễ uốn nắn, may đo riêng cho từng người dùng — điều không tưởng chỉ 5 năm trước với bất kỳ ai không phải lập trình viên.
Tóm lại
Chúng ta nên chuẩn bị cho một thế giới không chỉ có compute rẻ mà còn có trí tuệ rẻ. Token AI đang trên đà trở thành hạ tầng tính toán — vô hình, hiện diện khắp nơi, và rẻ đến mức không cần đếm. Câu hỏi không còn là "có nên dùng AI không", mà là "dùng nó vào việc gì khi chi phí gần như bằng không".