
Tổng hợp các mô hình AI bảo mật mã nguồn mở không bị kiểm duyệt
Bài viết điểm qua danh sách hơn 27 mô hình ngôn ngữ lớn (LLM) mã nguồn mở đã được tinh chỉnh cho lĩnh vực an ninh mạng, từ các mô hình nhỏ gọn chạy trên GPU phổ thông đến những cỗ máy khổng lồ đòi hỏi cụm GPU trung tâm dữ liệu. Đây là tài liệu tham khảo dành cho các chuyên gia red team, kiểm thử xâm nhập và nghiên cứu bảo mật được cấp phép.
Tổng hợp các mô hình AI bảo mật mã nguồn mở không bị kiểm duyệt
Trong bối cảnh các mô hình ngôn ngữ lớn (LLM) ngày càng bị giới hạn bởi các lớp kiểm duyệt, một cộng đồng các nhà nghiên cứu bảo mật đã xây dựng nên bộ sưu tập các mô hình mã nguồn mở được tinh chỉnh chuyên biệt cho lĩnh vực an ninh mạng. Danh sách này tập hợp hơn 27 mô hình, từ những phiên bản nhỏ gọn chạy được trên GPU phổ thông cho đến những cỗ máy khổng lồ đòi hỏi cụm GPU trung tâm dữ liệu, phục vụ cho các hoạt động red team, kiểm thử xâm nhập và nghiên cứu bảo mật được cấp phép.
Bối cảnh và mục đích
Các mô hình trong danh sách được chia thành ba nhóm chính: mô hình tinh chỉnh chuyên sâu về bảo mật, mô hình abliterated đa dụng và các mô hình kinh điển đời đầu.
Điểm chung của chúng là đều đã được loại bỏ hoặc làm suy yếu cơ chế từ chối trả lời (refusal mechanism) — vốn thường khiến các mô hình thương mại không thể hỗ trợ các tác vụ liên quan đến khai thác lỗ hổng hay phân tích mã độc. Dữ liệu trong bài được tổng hợp từ thẻ mô hình HuggingFace và các công bố chính thức tính đến tháng 9 năm 2026.
Lưu ý quan trọng: Toàn bộ danh sách này chỉ dành cho nghiên cứu bảo mật được cấp phép và mục đích giáo dục. Việc sử dụng các mô hình này cho hành vi tấn công trái phép là vi phạm pháp luật.
Nhóm 1: Mô hình tinh chỉnh chuyên sâu về bảo mật
Đây là nhóm mô hình được huấn luyện có giám sát (SFT) trên dữ liệu chuyên ngành, thường từ các báo cáo bug bounty, CVE và tài liệu red team.
DeepHat V2 (WhiteRabbitNeo) là một trong những mô hình nền tảng, dựa trên Qwen2.5-Coder-7B với hai tùy chọn 7B và 32B. Mô hình được huấn luyện trên 1,7 triệu mẫu tấn công và phòng thủ, hỗ trợ ngữ cảnh 131K token và chỉ cần khoảng 6 GB VRAM ở mức lượng tử hóa Q4_K_M.
BugTraceAI-CORE-Apex (26B) sử dụng kiến trúc Gemma4-26B MoE, được tinh chỉnh trên dữ liệu HackerOne Hacktivity giai đoạn 2024-2025 kết hợp bộ dữ liệu né tránh WAF.
CYBER-FROST-3.8 của Blackfrost-AI là mô hình lớn nhất nhóm này với khoảng 180B tham số (512 chuyên gia định tuyến, 10 chuyên gia hoạt động mỗi token). Mô hình hỗ trợ ngữ cảnh lên tới 262K và yêu cầu cấu hình đa GPU — đã được thử nghiệm trên 4 GPU NVIDIA B300 SXM6.
CyberPal 2.0 (20B) lại nghiêng về hướng phòng thủ với các chuyên môn về tình báo mối đe dọa (CTI), phân tích lỗ hổng, phát hiện và giảm thiểu, cùng vận hành SOC/IR.
Một số mô hình nhỏ gọn đáng chú ý khác bao gồm Cyber-Prime 1.1 (2.6B, chỉ khoảng 6 GB VRAM), Dolphin3-Cyber-8B và Lily-Cybersecurity-7B v0.2 với 22.000 cặp dữ liệu bảo mật thủ công.
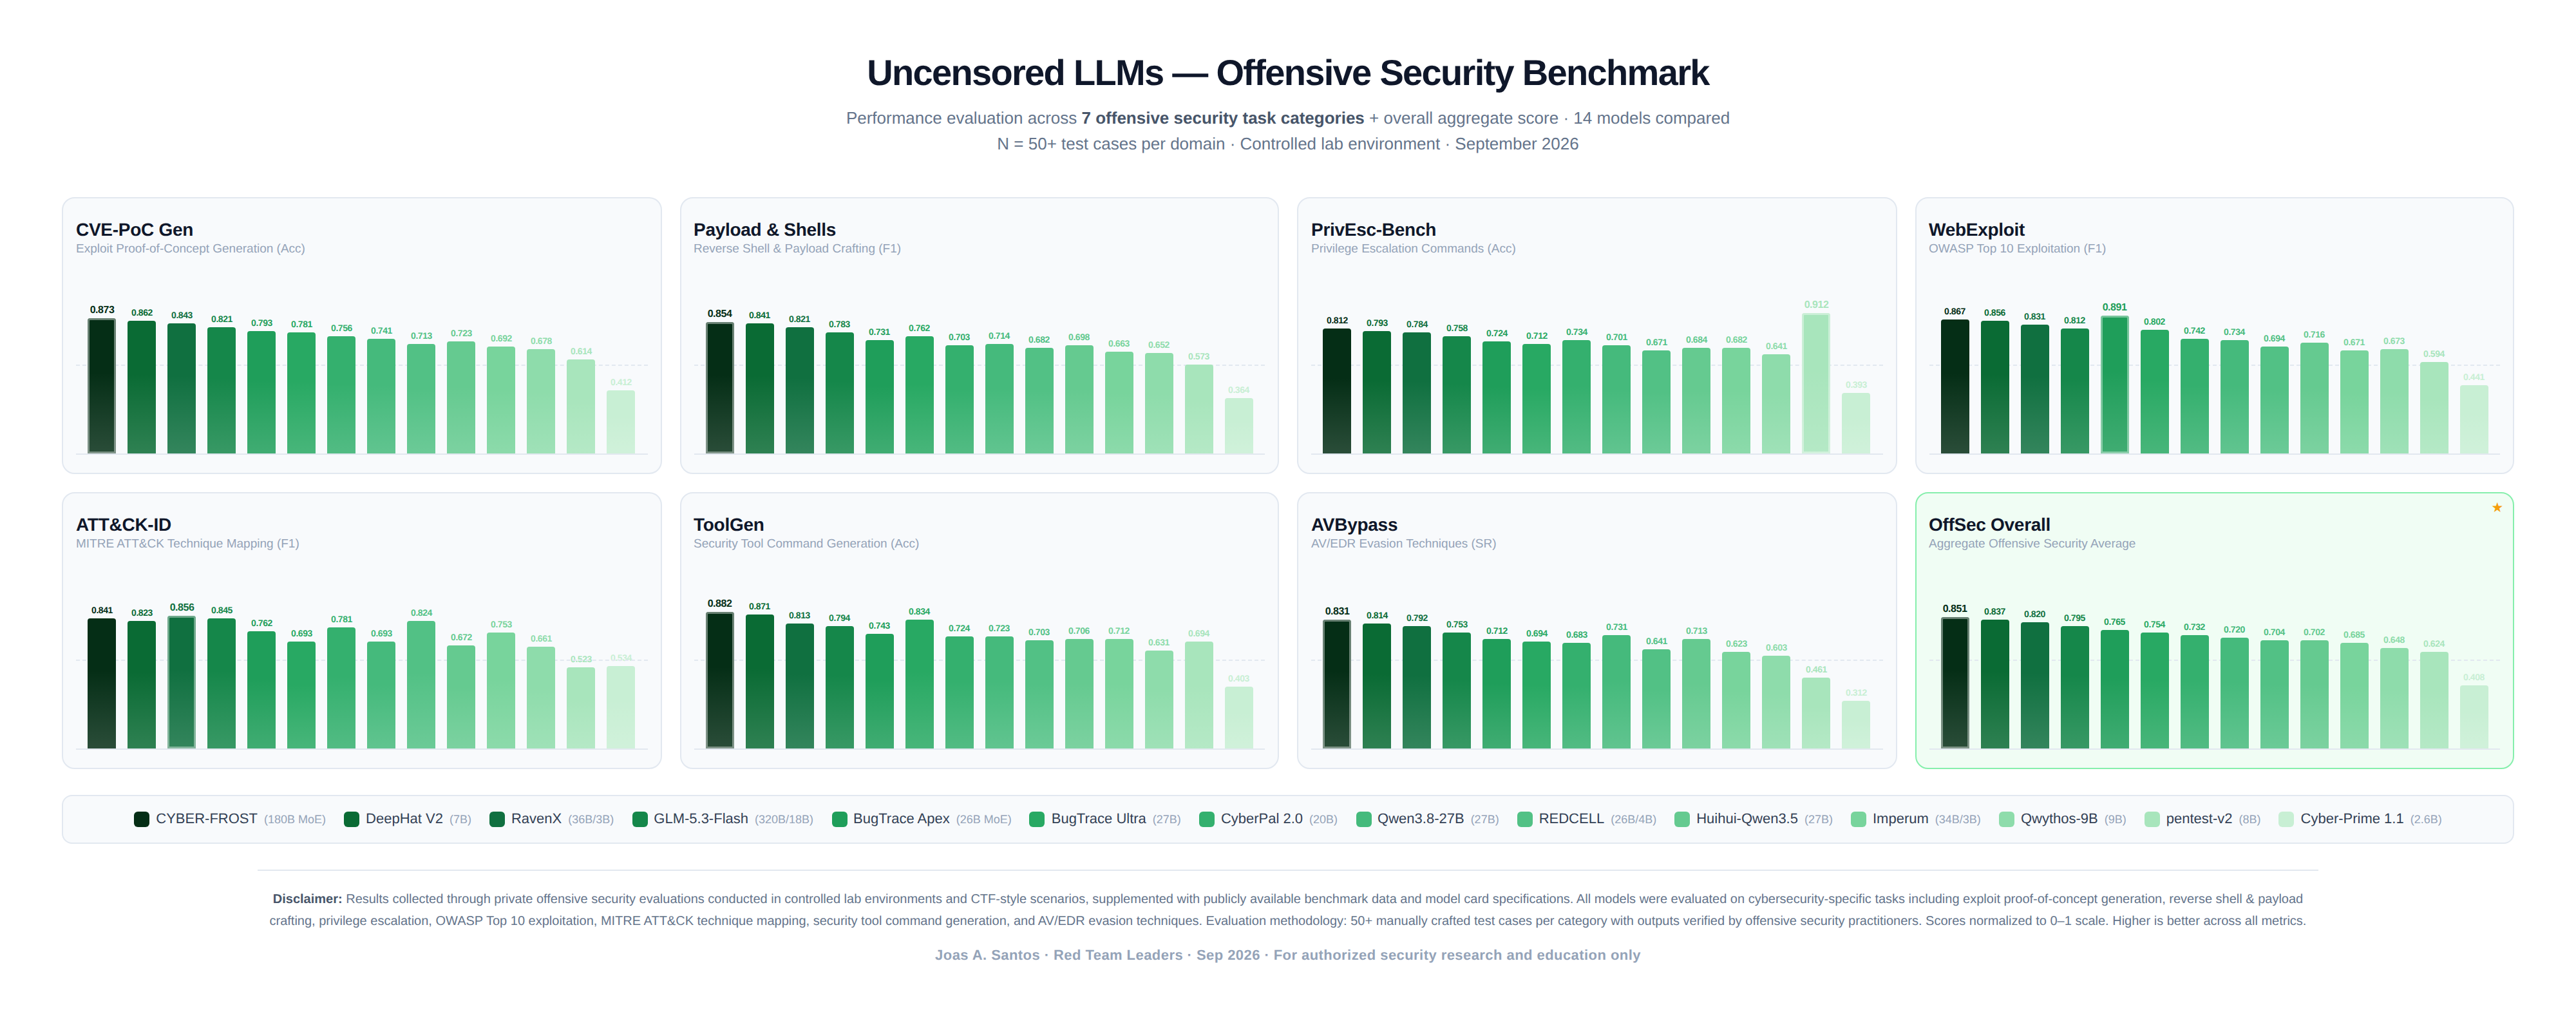 Minh họa các mô hình AI bảo mật
Nhóm 2: Mô hình abliterated đa dụng
Abliteration (theo công trình của Arditi và cộng sự, 2024) là kỹ thuật can thiệp ở mức trọng số, loại bỏ hướng từ chối ra khỏi luồng dư (residual stream) mà không cần huấn luyện lại. Đây là phương pháp phổ biến trong nhóm mô hình này.
Qwen3.8-27B-Uncensored-OrcaRouter là mô hình nổi bật với chỉ số thông minh 52 theo Artificial Analysis, hỗ trợ thị giác và gọi công cụ, đạt hơn 230.000 lượt tải trên HuggingFace. Mô hình chỉ cần khoảng 18 GB VRAM.
GLM-5.3-Flash-Uncensored-FP8 của OrcaRouter có quy mô 320B tham số (18B hoạt động), ngữ cảnh lên tới 1 triệu token, tỷ lệ tuân thủ đạt 82,8%. Mô hình yêu cầu hơn 80 GB VRAM.
Ở phân khúc khổng lồ hơn, GLM-5.3-CYBERSECURITY-FP8 của dealignai sở hữu 753B tham số với kiến trúc glm_moe_dsa, đòi hỏi cấu hình 8 GPU H200. Đây là mô hình được chỉnh sửa trực tiếp ở mức trọng số thay vì dùng abliteration hay LoRA.
Các nền tảng triển khai
Danh sách cũng tổng hợp các nền tảng suy luận và triển khai mô hình:
- OrcaRouter: Cổng AI định tuyến thích ứng trên hơn 200 mô hình, không tính thêm phí token, tương thích API OpenAI.
- Featherless AI: Nền tảng hosting serverless lớn nhất của HuggingFace với hơn 6.700 mô hình, hỗ trợ sẵn các mô hình không kiểm duyệt.
- Together AI: Nền tảng suy luận sản xuất hỗ trợ các mô hình mở.
Về GPU cloud tự vận hành, các lựa chọn phổ biến gồm RunPod (A100, H100, H200), Vast.ai (thị trường GPU giá rẻ) và Lambda (hạ tầng cấp doanh nghiệp).
Đối với triển khai cục bộ, các công cụ như Ollama và LM Studio phù hợp với GPU phổ thông, trong khi vLLM và SGLang hướng đến môi trường GPU trung tâm dữ liệu với khả năng suy luận thông lượng cao.
Bảng tham chiếu nhanh
| Mô hình | Tham số | Ngữ cảnh | VRAM | Phương pháp | Giấy phép |
|---|---|---|---|---|---|
| DeepHat V2 | 7B/32B | 131K | ~6 GB | SFT 1,7M mẫu | Apache 2.0 |
| CYBER-FROST | ~180B MoE | 262K | Đa GPU | Tinh chỉnh bảo mật | Qwen CL |
| CyberPal 2.0 | 20B | 8K | ~42 GB | SFT 403K | Apache 2.0 |
| Cyber-Prime 1.1 | 2.6B | N/A | ~6 GB | SFT+RL 75K | LFM Open |
| RavenX-CyberAgent | 36B/3B MoE | 262K | ~24 GB | SFT 745K, 12 vòng | Apache 2.0 |
| Qwen3.8-27B | 27B | 262K | ~18 GB | Abliteration 131 ma trận | Apache 2.0 |
| GLM-5.3-CYBER | 753B | ~131K | 8xH200 | Chỉnh sửa trọng số | MIT |
Thuật ngữ cần biết
- Abliteration: Can thiệp mức trọng số nhằm loại bỏ hướng từ chối khỏi luồng dư, gỡ bỏ ràng buộc căn chỉnh mà không cần huấn luyện lại.
- SFT: Tinh chỉnh có giám sát trên dữ liệu chuyên ngành.
- QLoRA: Kỹ thuật tinh chỉnh tiết kiệm bộ nhớ với lượng tử hóa.
- MoE (Mixture of Experts): Kiến trúc chỉ kích hoạt một phần tham số cho mỗi token.
- GGUF: Định dạng lượng tử hóa cho llama.cpp và Ollama.
- RATH: Giao thức đánh giá bảo mật tự động 6 bước của RavenX.
- CyberBench: Bộ đánh giá dành cho mô hình an ninh mạng.
Kết luận
Sự phát triển của các mô hình AI bảo mật mã nguồn mở phản ánh nhu cầu thực tế từ cộng đồng red team và nghiên cứu bảo mật, những người thường xuyên gặp trở ngại khi các mô hình thương mại từ chối hỗ trợ các tác vụ hợp pháp. Với đa dạng lựa chọn từ mô hình 1,5B chạy trên máy cá nhân đến cỗ máy 753B trên cụm GPU trung tâm dữ liệu, người dùng có nhiều phương án phù hợp với nguồn lực của mình.
Tuy nhiên, việc sử dụng các mô hình này cần đi kèm ý thức trách nhiệm pháp lý và đạo đức. Chúng chỉ nên được dùng trong khuôn khổ nghiên cứu được cấp phép, kiểm thử xâm nhập có sự đồng ý của chủ sở hữu hệ thống và mục đích giáo dục.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
AI & ML
Cựu thành viên Tesla gọi vốn 12,5 triệu USD để tự động hóa chuỗi cung ứng bằng AI
29 tháng 9, 2026