Transformer trực quan: Cách mạng kiến trúc đằng sau ChatGPT và Gemini
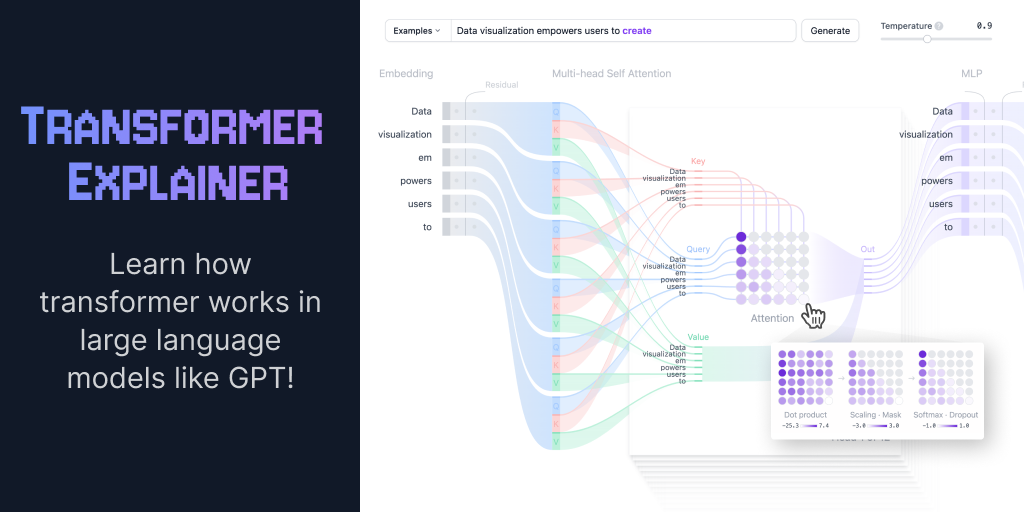
Transformer Explainer, công cụ tương tác mới từ Đại học Georgia Tech, cho phép người dùng khám phá trực tiếp cách hoạt động của kiến trúc Transformer ngay trên trình duyệt. Công cụ này chạy mô hình GPT-2 (small) với 124 triệu tham số, giúp giải mã cơ chế self-attention, embedding và quá trình sinh token — những nền tảng đằng sau các mô hình AI tạo sinh hiện đại.
Transformer trực quan: Cách mạng kiến trúc đằng sau ChatGPT và Gemini
Transformer là kiến trúc mạng nơ-ron đã thay đổi tận gốc cách tiếp cận trí tuệ nhân tạo. Ra đời năm 2017 qua bài báo kinh điển "Attention is All You Need", kiến trúc này nhanh chóng trở thành nền tảng cho các mô hình deep learning hiện đại như GPT của OpenAI, Llama của Meta hay Gemini của Google. Không chỉ dừng ở văn bản, Transformer còn được ứng dụng trong tạo âm thanh, nhận dạng hình ảnh, dự đoán cấu trúc protein và cả chơi game.
Transformer Explainer là công cụ tương tác do nhóm nghiên cứu tại Đại học Georgia Tech phát triển, cho phép người dùng quan sát trực tiếp cách một mô hình Transformer xử lý văn bản ngay trong trình duyệt.
 Minh họa quá trình embedding trong Transformer
Nguyên lý cốt lõi: Dự đoán token tiếp theo
Các mô hình Transformer sinh văn bản hoạt động dựa trên nguyên lý dự đoán token tiếp theo: khi nhận một câu lệnh (prompt) từ người dùng, mô hình sẽ xác định token (từ hoặc phần của từ) có xác suất cao nhất sẽ xuất hiện tiếp theo.
Điểm đột phá của Transformer nằm ở cơ chế self-attention — cho phép mô hình xử lý toàn bộ chuỗi và nắm bắt các phụ thuộc tầm xa hiệu quả hơn nhiều so với các kiến trúc trước đó như RNN hay LSTM.
Transformer Explainer sử dụng mô hình GPT-2 (small) với 124 triệu tham số. Dù không phải là mô hình mạnh nhất hiện nay, GPT-2 chia sẻ nhiều thành phần kiến trúc cốt lõi với các mô hình tiên tiến, khiến nó trở thành điểm khởi đầu lý tưởng để tìm hiểu.
Ba thành phần chính của một mô hình Transformer sinh văn bản
Mọi mô hình Transformer sinh văn bản đều bao gồm ba thành phần then chốt: embedding (nhúng), Transformer block (khối xử lý) và lớp đầu ra (output layer).
Bước 1 — Embedding: Chuyển văn bản thành số
Khi bạn nhập câu lệnh như "Data visualization empowers users to", hệ thống cần chuyển đổi văn bản thành định dạng số mà mô hình có thể xử lý. Quá trình này gồm bốn bước:
- Token hóa (Tokenization): Chia nhỏ văn bản thành các token. Từ "Data" và "visualization" là hai token riêng biệt, trong khi "empowers" được tách thành hai token. GPT-2 có vốn từ vựng gồm 50.257 token duy nhất.
- Lấy vector nhúng token: GPT-2 (small) biểu diễn mỗi token dưới dạng vector 768 chiều. Ma trận nhúng có kích thước (50.257, 768), chứa khoảng 39 triệu tham số — cho phép mô hình gán ý nghĩa ngữ nghĩa cho từng token.
- Thêm thông tin vị trí: GPT-2 tự huấn luyện ma trận mã hóa vị trí từ đầu, tích hợp trực tiếp vào quá trình training.
- Cộng token và vị trí: Kết quả cuối cùng là biểu diễn embedding kết hợp cả ngữ nghĩa lẫn vị trí trong chuỗi.
Bước 2 — Transformer Block: Trái tim của kiến trúc
Khối Transformer gồm hai thành phần: multi-head self-attention và Multi-Layer Perceptron (MLP). GPT-2 (small) xếp chồng 12 khối như vậy. Qua từng lớp, biểu diễn token dần tiến hóa, giúp mô hình xây dựng hiểu biết tinh vi về ngữ cảnh.
 Cơ chế Query, Key, Value trong self-attention
Self-attention: Cơ chế then chốt
Self-attention cho phép mỗi token "nhìn" các token khác trong chuỗi để điều chỉnh biểu diễn của mình. Mỗi vector embedding đầu vào được biến đổi thành ba vector:
- Query (Q): Token đang tìm kiếm thông tin gì?
- Key (K): Token này chứa thông tin gì để người khác tìm?
- Value (V): Thông tin thực tế được truyền đi là gì?
Các vector Q, K, V được chia thành 12 head trong GPT-2 (small). Mỗi head xử lý một phần embedding độc lập, nắm bắt các mối quan hệ cú pháp và ngữ nghĩa khác nhau — ví dụ một head theo dõi liên kết cú pháp tầm ngắn, head khác nắm bắt ngữ cảnh ngữ nghĩa rộng hơn.
 Cơ chế attention với softmax
Các head thực hiện tính toán masked self-attention — cho phép mô hình tập trung vào phần liên quan của đầu vào nhưng ngăn chặn truy cập các token tương lai. Điểm attention sau đó nhân với ma trận Value để tạo đầu ra cuối cùng. Kết quả từ 12 head được nối lại và đưa qua một phép chiếu tuyến tính.
Lớp MLP: Mở rộng khả năng biểu diễn
Sau khi self-attention nắm bắt mối quan hệ giữa các token, đầu ra được đưa qua lớp MLP gồm hai phép biến đổi tuyến tính với hàm kích hoạt GELU ở giữa:
- Biến đổi thứ nhất mở rộng chiều từ 768 lên 3.072, cho phép mô hình chiếu biểu diễn token vào không gian chiều cao hơn để nắm bắt các mẫu phức tạp hơn.
- Biến đổi thứ hai nén trở về 768 chiều, giữ lại các biến đổi phi tuyến hữu ích.
Khác với self-attention (tích hợp thông tin giữa các token), MLP xử lý từng token độc lập, làm phong phú thêm năng lực tổng thể của mô hình.
 Kiến trúc lớp MLP trong Transformer
Lớp đầu ra và quá trình sinh token
Sau khi đi qua tất cả 12 khối Transformer, đầu ra được đưa qua lớp tuyến tính cuối cùng, chiếu vào không gian 50.257 chiều — tương ứng với mỗi token trong vốn từ vựng có một giá trị gọi là logit.
Hàm softmax sau đó chuyển đổi logits thành phân phối xác suất có tổng bằng 1, cho phép lấy mẫu token tiếp theo dựa trên khả năng xuất hiện của nó.
 Hàm softmax chuyển logits thành xác suất
Điều chỉnh quá trình sinh: Temperature, top-k và top-p
Tham số temperature đóng vai trò then chốt — về mặt toán học, logits đầu ra chỉ đơn giản được chia cho giá trị temperature. Ngoài ra, quá trình lấy mẫu còn có thể tinh chỉnh bằng:
- Top-k: Chỉ xem xét k token có xác suất cao nhất.
- Top-p (nucleus sampling): Chỉ xem xét tập token nhỏ nhất có tổng xác suất đạt ngưỡng p.
Bằng cách điều chỉnh ba tham số này, bạn có thể cân bằng giữa đầu ra mang tính xác định và đa dạng, phù hợp với nhu cầu cụ thể.
Các thành phần kiến trúc bổ trợ
Ba kỹ thuật quan trọng giúp Transformer hoạt động ổn định, đặc biệt trong giai đoạn huấn luyện:
- Layer Normalization: Chuẩn hóa đầu vào theo đặc trưng, ổn định quá trình huấn luyện và giúp mô hình hội tụ nhanh hơn. Được áp dụng hai lần trong mỗi khối Transformer — một lần trước self-attention, một lần trước MLP.
- Dropout: Kỹ thuật regularization ngẫu nhiên vô hiệu hóa một phần trọng số trong quá trình huấn luyện, giúp mô hình học các đặc trưng bền vững hơn và giảm overfitting. Khi suy luận, dropout được tắt đi.
- Residual Connections: Ra đời từ mô hình ResNet năm 2015, đây là các "đường tắt" nối đầu vào của một lớp với đầu ra của nó, giúp giảm vấn đề gradient biến mất và cho phép huấn luyện các mạng rất sâu. Trong GPT-2, residual connections được dùng hai lần mỗi khối.
Transformer Explainer: Học bằng cách tương tác
Công cụ Transformer Explainer chạy mô hình GPT-2 (small) trực tiếp trong trình duyệt, dựa trên triển khai PyTorch từ dự án nanoGPT của Andrej Karpathy, chuyển đổi sang ONNX Runtime để thực thi mượt mà. Giao diện được xây dựng bằng JavaScript với Svelte làm framework front-end và D3.js cho các hình ảnh trực quan động. Các giá trị số được cập nhật trực tiếp theo dữ liệu người dùng nhập vào.
Công cụ được phát triển bởi Aeree Cho, Grace C. Kim, Alexander Karpekov, Alec Helbling, Jay Wang, Seongmin Lee, Benjamin Hoover và Polo Chau tại Viện Công nghệ Georgia (Georgia Institute of Technology).
Với những ai đang tìm hiểu về AI tạo sinh, đây là một trong những công cụ trực quan hóa dễ tiếp cận nhất hiện nay — biến những khái niệm trừu tượng như QKV, attention head hay softmax thành các bước có thể quan sát và tương tác trực tiếp.