
Từ túi từ đến Jev: Hành trình của các mô hình ngôn ngữ trong bài toán phân loại văn bản
Bài viết điểm lại lịch sử phát triển của các phương pháp phân loại văn bản, từ túi từ (bag-of-words) với naive Bayes và hồi quy logistic, qua mạng nơ-ron hồi tiếp (RNN), mạng tích chập (CNN), cho đến kiến trúc Transformer. Đặc biệt, bài phân tích sự xuất hiện của Jev — mô hình phân loại của TypeSafe AI — cùng cơ chế hiệu chỉnh xác suất (calibration) đằng sau nó.
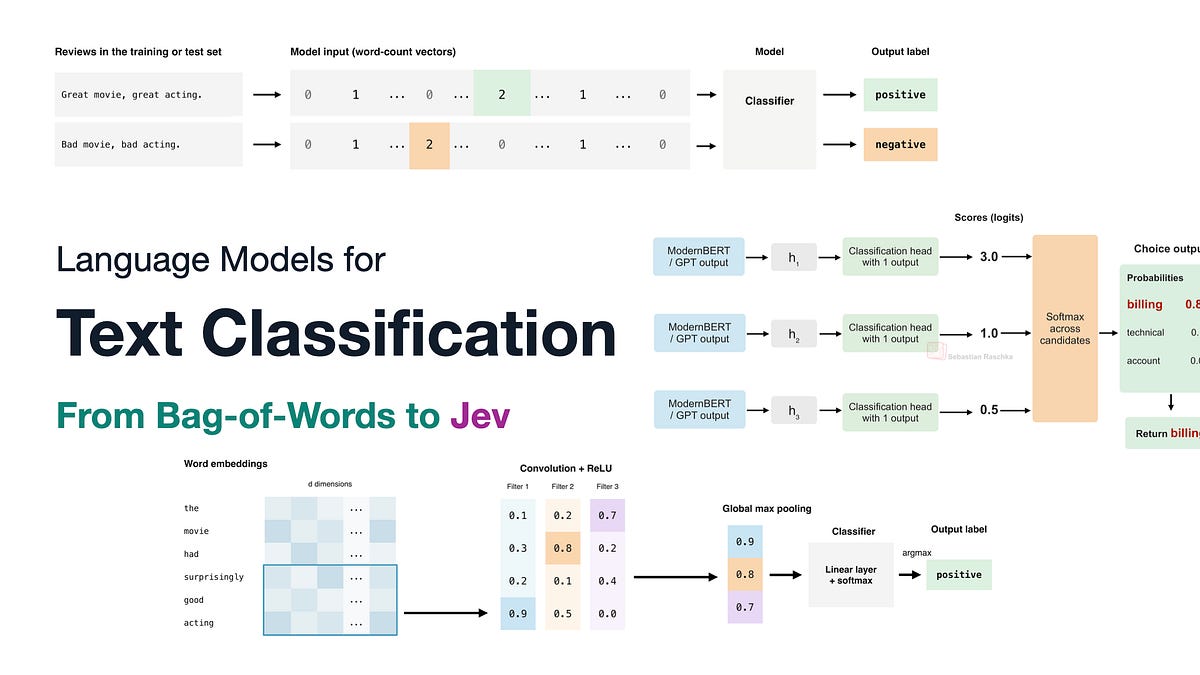
Từ túi từ đến Jev: Hành trình của các mô hình ngôn ngữ trong bài toán phân loại văn bản
Sự ra đời của Jev — mô hình phân loại văn bản do TypeSafe AI phát triển — đang gây chú ý trong giới kỹ thuật hai tuần qua. Thoạt nhìn, Jev giống như một bộ phân loại thông thường, nhưng điểm khác biệt nằm ở khả năng xử lý đa dạng tác vụ mà không cần tinh chỉnh riêng. Để hiểu vì sao Jev lại gây sốt, chúng ta cần nhìn lại chặng đường dài của các phương pháp phân loại văn bản, từ túi từ cho đến các kiến trúc Transformer hiện đại.
Kỷ nguyên tiền Transformer: Túi từ và các bộ phân loại cổ điển
Cách đây khoảng 15 năm, khi mà mạng nơ-ron hồi tiếp (RNN) đã tồn tại nhưng chưa phổ biến, phân loại văn bản chủ yếu dựa trên biểu diễn túi từ (bag-of-words). Đây là phương pháp chuyển đổi văn bản có độ dài tùy ý thành vector kích thước cố định để phù hợp với các bộ phân loại cổ điển như naive Bayes, hồi quy logistic, SVM hay XGBoost.
Ý tưởng rất đơn giản: xây dựng một từ vựng gồm tất cả các từ duy nhất trong tập huấn luyện, sau đó đếm tần suất xuất hiện của từng từ trong mỗi văn bản. Ví dụ, nếu từ vựng có 50.000 từ, mỗi văn bản sẽ được biểu diễn bằng một vector 50.000 chiều, bất kể văn bản đó dài hay ngắn.
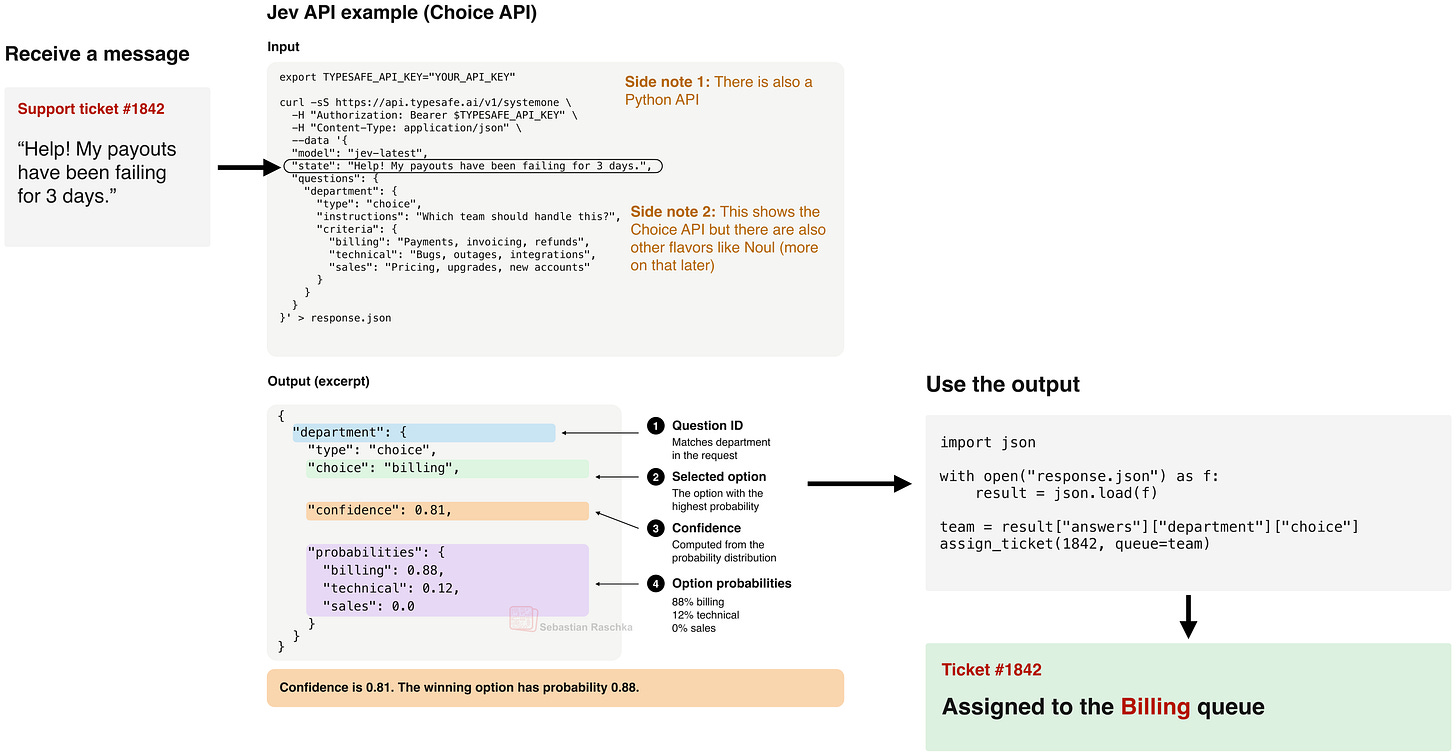 Minh họa biểu diễn túi từ
Cách tiếp cận này rẻ về mặt tính toán và cho kết quả khá tốt trong các bài toán đơn giản như lọc thư rác. Tương truyền, bộ lọc spam đầu tiên của Gmail cũng dùng naive Bayes với biểu diễn túi từ. Tuy nhiên, nhược điểm lớn nhất là mất hoàn toàn thứ tự từ. Câu "con chó cắn người" và "người cắn con chó" sẽ cho ra cùng một vector, dù ý nghĩa hoàn toàn khác nhau.
Dù vậy, túi từ + hồi quy logistic vẫn là baseline đáng tin cậy cho mọi bài toán phân loại văn bản, đạt khoảng 89,9% độ chính xác trên bộ dữ liệu đánh giá phim IMDb.
Mạng nơ-ron sâu: RNN và CNN cho văn bản
Để khắc phục nhược điểm mất thứ tự từ, các kiến trúc mạng nơ-ron tiên tiến hơn ra đời, sử dụng vector nhúng từ (word embeddings) — biểu diễn mỗi từ bằng một vector dày đặc các số đã học. Khác với túi từ biểu diễn cả văn bản bằng tần suất từ, nhúng từ biểu diễn từng từ riêng lẻ, giống như lớp embedding trong các mô hình ngôn ngữ lớn (LLM) ngày nay.
Mạng nơ-ron hồi tiếp (RNN) đọc chuỗi văn bản từng từ một, kết hợp vector nhúng của từ hiện tại với trạng thái ẩn từ bước trước. Trạng thái ẩn này là một vector kích thước cố định tóm tắt nội dung đã xử lý, nhờ đó thứ tự từ trở nên quan trọng. Các biến thể nổi tiếng như LSTM (1997) và GRU (2014) sử dụng cơ chế cổng để kiểm soát thông tin được giữ lại và cập nhật.
Tuy nhiên, RNN rất khó huấn luyện. Trên bộ dữ liệu IMDb, một LSTM đơn giản chỉ đạt 85,66% độ chính xác — thấp hơn cả túi từ. Phương pháp ULMFiT (2018) cải thiện đáng kể khi đạt 95,4% nhờ chiến lược học chuyển giao (transfer learning): huấn luyện trước trên tập dữ liệu lớn rồi tinh chỉnh trên tập mục tiêu.
Mạng tích chập (CNN) — vốn quen thuộc trong thị giác máy tính — cũng có thể áp dụng cho văn bản. Thay vì áp bộ lọc lên các vùng ảnh, ta áp bộ lọc lên các cửa sổ từ liền kề. Ưu điểm là các phép tính lọc có thể chạy song song, tránh phụ thuộc tuần tự như RNN. Trên IMDb, CNN đạt khoảng 90,07% độ chính xác.
 Minh họa kiến trúc CNN phân loại văn bản
Kỷ nguyên Transformer
Năm 2017, kiến trúc Transformer ra đời trong bài báo nổi tiếng "Attention Is All You Need". Ban đầu được thiết kế cho dịch máy theo cấu trúc encoder-decoder, nhưng nhanh chóng được chuyển thể cho phân loại văn bản.
Thời kỳ đầu sau khi Transformer ra mắt chứng kiến cuộc đua giữa hai hướng tiếp cận. Các mô hình kiểu encoder như BERT (Google) là bộ phân loại văn bản tự nhiên nhờ token phân loại ở vị trí đầu tiên có thể tinh chỉnh. Trong khi đó, các mô hình kiểu decoder như GPT (OpenAI) mạnh về sinh văn bản nhưng cũng có thể phân loại zero-shot hoặc few-shot như một tính năng nổi bật.
Với BERT, ta tinh chỉnh token [CLS] cho tác vụ phân loại. Một ví dụ hiện đại là ModernBERT (2024), đạt khoảng 95% độ chính xác trên IMDb chỉ với rất ít công sức tinh chỉnh. Với GPT, ta có thể thay lớp đầu ra bằng một đầu phân loại gọn nhẹ, hoặc dùng phương pháp phân loại văn bản sang văn bản (text-to-text) khi mô hình trực tiếp sinh nhãn như "positive" hay "negative".
Ngoài ra còn có kiến trúc encoder-decoder với T5 (2019) của Google, sử dụng tiền huấn luyện với kỹ thuật span corruption và có thể áp dụng cả hai cách: thêm đầu phân loại hoặc cho decoder sinh nhãn trực tiếp.
Jev: "Khoảnh khắc ChatGPT" của phân loại văn bản
Jev là mô hình độc quyền do TypeSafe AI phát hành, rẻ và được cho là ngang ngửa với các mô hình frontier như GPT-5.6 Luna về khả năng ra quyết định, nhưng nhanh và rẻ hơn nhiều bậc. Điểm hấp dẫn nhất là nó hoạt động tốt trên mọi loại tác vụ mà không cần tinh chỉnh riêng.
Giống như ChatGPT năm 2022 gây sốt vì là mô hình trò chuyện đa dụng sinh được mọi loại văn bản, Jev được giới kỹ thuật hào hứng vì nó là "khoảnh khắc ChatGPT" của phân loại văn bản: phân loại rẻ mọi loại đầu vào mà không cần xây dựng bộ phân loại tùy chỉnh cho từng tác vụ.
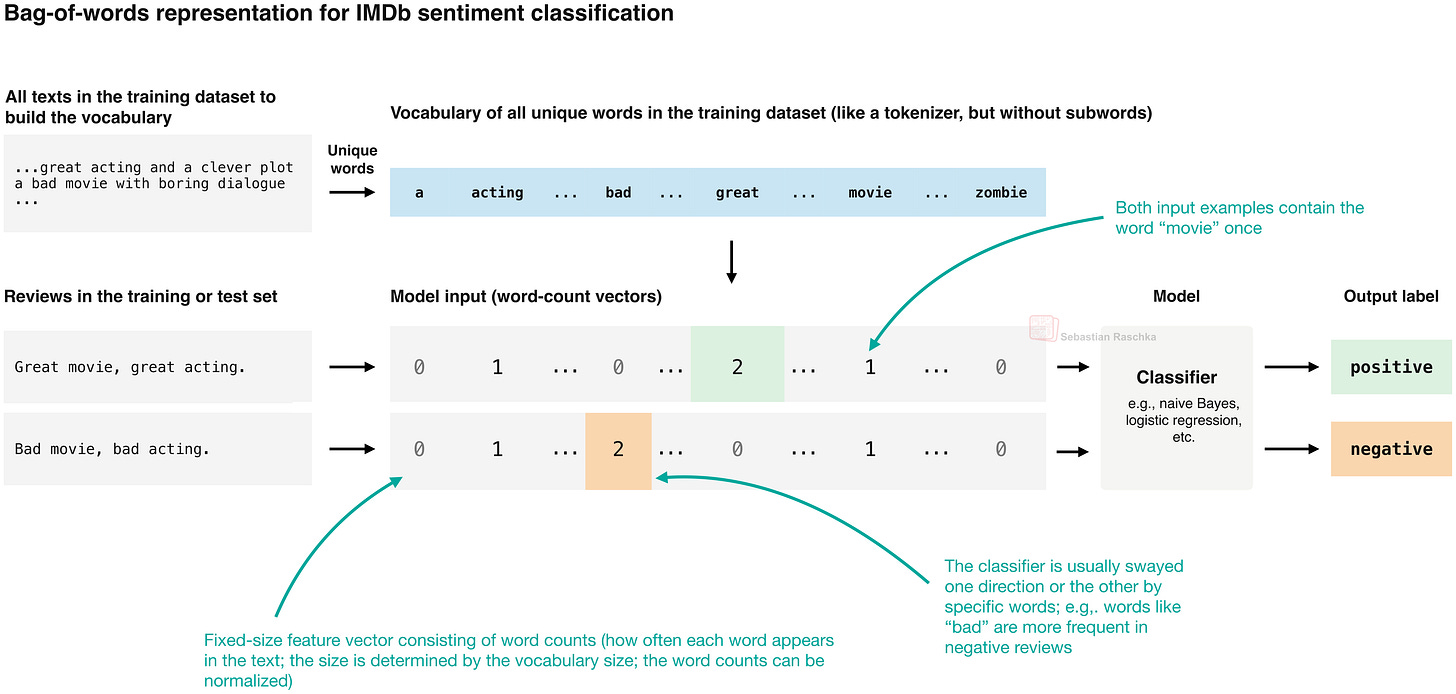 Tổng quan API của Jev
Jev cung cấp ba loại API chính:
- Choice API: dùng cho phân loại đa lớp, trả về nhãn được chọn cùng độ tin cậy và xác suất từng lớp.
- Noul API: đơn giản hơn, gán xác suất "có" cho một câu hỏi, phù hợp phân loại nhị phân hoặc đa nhãn.
- Score API: gán điểm theo thang đánh giá, dùng cho phân loại thứ tự.
Trên bộ 25.000 đánh giá phim IMDb, Jev đạt kết quả ấn tượng: Choice API đạt 96,47% độ chính xác với tổng chi phí chỉ 0,65 USD, trong khi Noul API đạt 96,20% với chi phí 0,63 USD. So sánh với ModernBERT — vốn cần 23 phút tinh chỉnh và 7 phút đánh giá — Jev có độ chính xác tương đương nhưng linh hoạt hơn hẳn vì có thể xử lý mọi tác vụ khác mà không cần huấn luyện lại.
Bí ẩn đằng sau Jev và vai trò của hiệu chỉnh xác suất
Kiến trúc và thuật toán huấn luyện của Jev không được công bố. Giám đốc TypeSafe AI tiết lộ 100% dữ liệu huấn luyện là dữ liệu tổng hợp, nhưng được chọn lọc kỹ lưỡng chứ không phải loại đầu ra thô từ LLM. Điều này nhấn mạnh một bài học lâu đời: chất lượng và số lượng dữ liệu thường mang lại cải thiện lớn hơn việc tinh chỉnh siêu tham số.
Về thuật toán, TypeSafe AI cho biết họ dùng phương pháp mới gọi là Học tăng cường cho các quyết định được hiệu chỉnh (RLCD). Một phương pháp tương tự đã công bố là RLCR (Reinforcement Learning with Calibration Rewards) trong bài báo năm 2025 "Beyond Binary Rewards". Thay vì chỉ thưởng đáp án đúng, RLCR còn phạt khi mô hình đưa ra ước lượng độ tin cậy không chính xác.
Hiệu chỉnh xác suất (calibration) là bước quan trọng với mọi mô hình production sử dụng xác suất. Ví dụ, nếu mô hình gán 74% khả năng tích cực cho một đánh giá, thì sau khi hiệu chỉnh, trong số các đánh giá được gán xác suất khoảng 74%, thực tế phải có khoảng 74% thực sự tích cực. Kỹ thuật phổ biến là temperature scaling — chia logits của mô hình cho một giá trị nhiệt độ T trước khi áp dụng softmax, với T được học trên tập validation.
Ý nghĩa với nhà phát triển Việt Nam
Với các đội ngũ phát triển tại Việt Nam, sự xuất hiện của Jev mở ra nhiều hướng ứng dụng thực tế: phân loại ticket hỗ trợ khách hàng, lọc phản hồi người dùng, hay tự động gán nhãn nội dung mà không cần đầu tư vào hạ tầng huấn luyện mô hình. Chi phí chỉ vài chục xu cho hàng chục nghìn lượt phân loại là mức rất cạnh tranh so với việc tự tinh chỉnh và vận hành một mô hình riêng.
Tuy nhiên, các đội ngũ cũng nên cân nhắc: nếu tác vụ có khối lượng cực lớn và yêu cầu độ chính xác tối đa trên một miền hẹp, việc tinh chỉnh một mô hình như ModernBERT vẫn hợp lý hơn. Còn với các tác vụ đa dạng, không đoán trước được — Jev và các mô hình phân loại đa dụng thế hệ mới là lựa chọn đáng cân nhắc.


