UTF-8000: Ý tưởng mở rộng UTF-8 lên vô hạn của một lập trình viên
Một bài viết kỹ thuật đề xuất UTF-8000, biến thể mở rộng của UTF-8 cho phép độ dài đơn vị mã hóa tùy ý để biểu diễn các điểm mã khổng lồ, chỉ thêm hai trường hợp đặc biệt kế thừa từ UTF-8. Bài viết phân tích kiến trúc, cơ chế tự đồng bộ, phát hiện mã hóa overlong và các biến thể như ASCVI hay zigzag cho số có dấu.
UTF-8000: Khi một lập trình viên muốn mở rộng UTF-8 lên vô hạn
Có những ý tưởng kỹ thuật nghe qua tưởng như đùa, nhưng càng đọc càng thấy logic bên trong. UTF-8000 là một ví dụ như vậy. Đây là đề xuất mở rộng UTF-8 để hỗ trợ độ dài đơn vị mã hóa (code unit) tùy ý, thay vì dừng lại ở 4 byte như chuẩn hiện hành.
Tác giả của ý tưởng này đã dành nhiều tuần để phân tích kiến trúc UTF-8, tách các bit lãnh đạo thành hai phần: bit tự đồng bộ (self-synchronization) và bit tự định độ dài (self-punctuation). Từ cách nhìn đó, ông chứng minh rằng UTF-8 hiện tại thực chất chỉ là một phần nhỏ của UTF-8000.
UTF-8 đang bị giới hạn ở đâu?
Chuẩn UTF-8 hiện hành (RFC 3629) giới hạn đơn vị mã hóa tối đa 4 byte, đủ để biểu diễn các điểm mã Unicode trong khoảng U+0000 đến U+10FFFF. Trước đó, các phiên bản cũ như RFC 2044 và RFC 2279 từng cho phép tới 6 byte, nhưng đã bị thu hẹp lại để tương thích với UTF-16.
Ý tưởng cốt lõi của UTF-8000 là: nếu ta hiểu đúng cấu trúc bit của UTF-8, ta có thể mở rộng nó lên bất kỳ độ dài nào mà không phá vỡ bất kỳ thuộc tính quan trọng nào.
Cấu trúc của một đơn vị mã UTF-8000
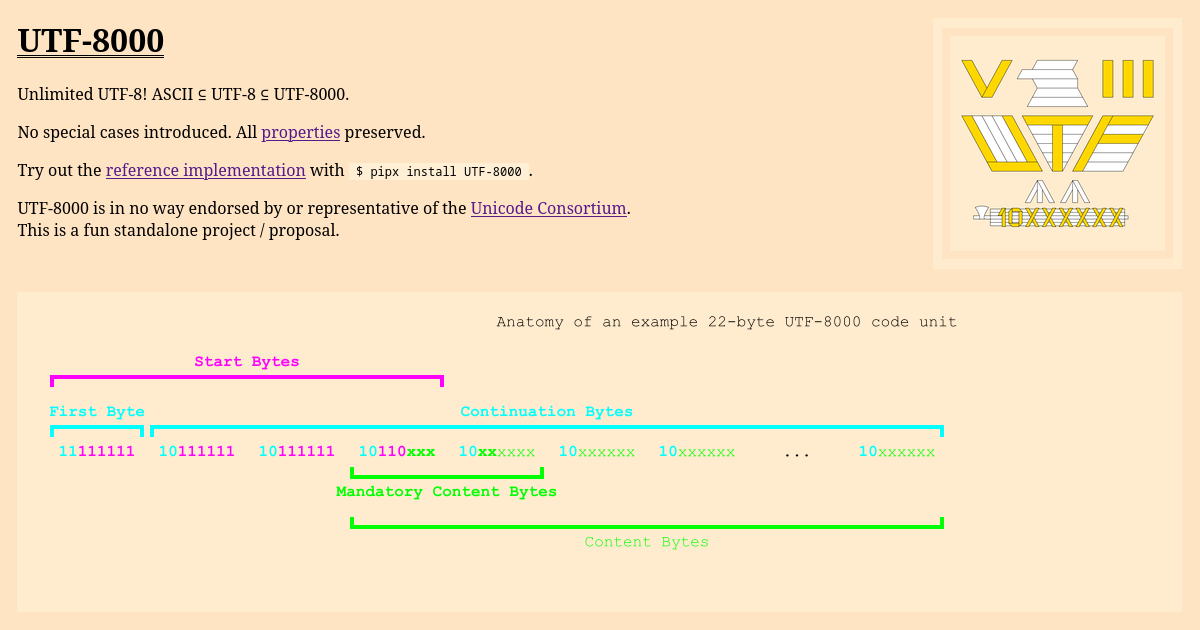
Ở dạng đơn giản nhất, mỗi byte trong UTF-8000 có tiền tố tự đồng bộ như sau:
- Bit 0 ở đầu: byte ASCII
- Bit 10 ở đầu: byte tiếp nối (continuation byte)
- Bit 11 ở đầu: byte bắt đầu (start byte) của đơn vị mã nhiều byte
Điểm thú vị là các bit bắt đầu (start bits) có thể trải dài qua nhiều byte, cho phép tạo ra các chuỗi 1 dài tùy ý, theo sau là một bit 0 kết thúc. Với một đơn vị mã gồm n byte, số bit nội dung là 5n+1.
 Cấu trúc giải phẫu của một đơn vị mã UTF-8000 nhiều byte
Hai trường hợp đặc biệt duy nhất
Điều khiến tác giả tin rằng đây là cách mở rộng "chính thống" của UTF-8 nằm ở chỗ UTF-8000 không tạo ra bất kỳ trường hợp đặc biệt mới nào. Nó chỉ kế thừa hai trường hợp đặc biệt vốn có của UTF-8:
- ASCII (1 byte): có 7 bit nội dung, không khớp với công thức 5n+1. Nó cũng không cần kiểm tra mã hóa overlong vì đây là đơn vị mã nhỏ nhất có thể.
- UTF-8 2 byte: chỉ có 4 bit nội dung bắt buộc, thay vì 5 như các đơn vị mã dài hơn. Lý do là vì bước nhảy từ ASCII 7 bit lên UTF-8 2 byte 11 bit chỉ tăng thêm 4 bit nội dung.
Trong tất cả các đơn vị mã có n > 2, số bit nội dung bắt buộc luôn là 5.
Phát hiện mã hóa overlong và lý do bảo mật
Mã hóa overlong là cách mã hóa một điểm mã bằng đơn vị mã dài hơn mức cần thiết. Ví dụ, ký tự 'A' (U+0041) có thể bị mã hóa sai thành hai byte 11000001 10000001 thay vì một byte 01000001.
Đây không chỉ là vấn đề kỹ thuật mà còn là vấn đề bảo mật nghiêm trọng. Nếu một đơn vị mã overlong có thể biểu diễn byte null (0x00), kẻ tấn công có thể lợi dụng để vượt qua các hàm xử lý chuỗi trong C như strcpy, gây ra lỗi tràn bộ đệm hoặc các lỗ hổng bảo mật nghiêm trọng.
Chính vì vậy, mỗi đơn vị mã UTF-8000 đều được thiết kế để có các bit nội dung bắt buộc phải chứa ít nhất một bit 1, ngăn chặn hoàn toàn mã hóa overlong.
 Ví dụ minh họa cơ chế kiểm tra bit trong UTF-8000
Tự đồng bộ: điểm mạnh được kế thừa từ UTF-8
Thuộc tính tự đồng bộ (self-synchronization) cho phép ta xác định ngay lập tức một byte là byte bắt đầu hay byte tiếp nối mà không cần biết lịch sử trước đó của luồng dữ liệu.
Điều này cực kỳ hữu ích trong hai tình huống:
- Truy cập ngẫu nhiên: Khi seek đến một vị trí bất kỳ trong file, ta biết ngay có thể bắt đầu giải mã từ đó hay cần tìm byte bắt đầu tiếp theo.
- Phục hồi lỗi: Khi gặp byte không hợp lệ trong luồng dữ liệu, ta có thể xuất ký tự thay thế U+FFFD và tiếp tục giải mã từ byte bắt đầu kế tiếp, thay vì phải dừng toàn bộ.
Ken Thompson và Rob Pike đã chọn thiết kế tự đồng bộ cho UTF-8 để khắc phục nhược điểm của bản nháp FSS-UTF trước đó, nơi byte bắt đầu và byte tiếp nối không thể phân biệt nếu không biết lịch sử luồng dữ liệu.
Tốc độ thông tin và giới hạn thực tế
Tỷ lệ bit nội dung trên tổng số bit của UTF-8000 được tính bằng (5n+1)/8n, tiến dần về 62,5% khi n tăng. Với ASCII, tỷ lệ này là 87,5%.
Một điểm thú vị về mặt toán học: các đơn vị mã có số bit nội dung là lũy thừa của 2. Ví dụ, đơn vị mã 3 byte chứa đúng 16 bit nội dung, đủ để mã hóa toàn bộ Basic Multilingual Plane của Unicode. Các giá trị tiếp theo là 51 byte (256 bit), 819 byte (4096 bit) và 13107 byte (65536 bit).
 Minh họa hành vi tuần hoàn của các bit bắt đầu trong đơn vị mã dài
Các biến thể và ý tưởng mở rộng
Bài viết cũng đề xuất một số biến thể thú vị:
- ASCVI: Phiên bản giả định nếu ASCII là mã 6 bit thay vì 7 bit. Điều này loại bỏ trường hợp đặc biệt của ASCII, nhưng lại khiến đơn vị mã 1 byte kém linh hoạt hơn và không thể chứa số bit nội dung là lũy thừa của 2.
- Biến thể có dấu dùng ZigZag: Áp dụng hàm zigzag (từ Protobuf của Google) lên các bit nội dung để mã hóa cả số nguyên có dấu, giúp các số nhỏ gần 0 chiếm đơn vị mã ngắn hơn.
- Biến thể có dấu dùng Two's Complement: Đơn giản hơn về mặt khái niệm nhưng kém khả năng mở rộng và tạo ra các đơn vị mã dài không cần thiết cho các số âm nhỏ.
Ý nghĩa với cộng đồng lập trình viên
UTF-8000 không phải là một chuẩn được đề xuất thay thế UTF-8. Tác giả cũng thừa nhận rằng UTF-8 hiện tại đã quá phổ biến và ổn định để có thể thay đổi.
Giá trị thực sự của bài viết nằm ở góc nhìn kỹ thuật: nó cho thấy thiết kế của UTF-8 tinh tế đến mức nào, và cách Thompson cùng Pike đã "để cửa mở" cho sự mở rộng trong tương lai. Như chính tác giả nhận xét, UTF-8 xứng đáng được xem là "đỉnh cao của Triết lý Unix".
Với các lập trình viên Việt Nam làm việc với xử lý văn bản, hiểu rõ cấu trúc bit của UTF-8 không chỉ giúp viết code an toàn hơn mà còn mở ra cách nhìn sâu sắc về thiết kế hệ thống nói chung: một thiết kế tốt thường không cần thêm ngoại lệ khi mở rộng, mà chỉ cần được hiểu đúng.