
Vì sao công cụ gọi hàm của LLM hay lỗi và cách vLLM sửa đến 100%
Bài viết từ Ubicloud phân tích nguyên nhân khiến các mô hình mở như Kimi K2.6 chỉ đạt 92% độ chính xác khi gọi công cụ trên vLLM, và cách tính năng constrained decoding giúp đưa con số này lên 100%. Đây là vấn đề then chốt với các tác vụ agentic nhiều lượt, nơi một lần gọi lỗi có thể làm hỏng toàn bộ ngữ cảnh.
Khi chạy các mô hình mã nguồn mở trên hạ tầng của mình, nhiều đội ngũ nhận về kết quả thấp hơn hẳn so với những gì các bảng xếp hạng chất lượng công bố. Một trong những nguyên nhân ít được chú ý nhất nằm ở độ chính xác khi gọi công cụ (tool-call accuracy) — yếu tố quyết định với các tác vụ agentic.
 Biểu tượng GitHub
Vấn đề: 2 trong 25 lần gọi công cụ bị hỏng
Khi Ubicloud phục vụ mô hình Kimi K2.6 bằng vLLM phiên bản 0.28, tỷ lệ trả về đúng schema của lệnh gọi công cụ chỉ đạt 92%. Nói cách khác, cứ 25 lần gọi thì có 2 lần thất bại.
Con số này nghe có vẻ nhỏ, nhưng hậu quả lại mang tính dây chuyền. Mỗi lần gọi lỗi sẽ đẩy một thông báo lỗi vào cửa sổ ngữ cảnh, khiến mô hình phải "xây" tiếp trên nền tảng vô nghĩa. Trong các phiên agentic nhiều lượt — vốn rất phổ biến — chất lượng đầu ra tụt dốc nhanh, chi phí tăng do phải thử lại, và trải nghiệm người dùng trở nên thiếu ổn định.
Gọi công cụ hoạt động như thế nào?
Quy trình gọi công cụ gồm hai bước. Đầu tiên, ứng dụng gửi cho mô hình một mảng JSON mô tả các công cụ sẵn có, ví dụ công cụ webfetch dùng để tải nội dung trang web. Mỗi mô tả bao gồm tên công cụ, tham số, kiểu dữ liệu và những tham số bắt buộc — tất cả tạo thành schema của công cụ.
Sau đó, khi người dùng yêu cầu tải một trang web, mô hình sinh ra chuỗi token đại diện cho lệnh gọi. Máy chủ suy luận phân tích các token này, chuyển thành một đối tượng JSON rồi gửi lại cho agent harness để thực thi.
Điểm mấu chốt: lệnh gọi chỉ thành công khi tuân thủ đúng schema. Cách tiếp cận đơn giản nhất là để mô hình sinh tự do và tin vào quá trình huấn luyện — tương tự như cách ta tin mô hình viết văn đúng ngữ pháp. Cách này đúng phần lớn thời gian, nhưng "phần lớn" không đủ cho môi trường production.
Nguyên nhân gốc: bản chất xác suất của mô hình ngôn ngữ
Mô hình ngôn ngữ chọn token kế tiếp dựa trên xác suất, chứ không chạy trình biên dịch hay kiểm tra kiểu dữ liệu. Vì thế, dù prompt rõ ràng đến đâu, mô hình vẫn có thể sinh ra lệnh gọi sai cấu trúc.
Một nguyên nhân phổ biến là sự lệch pha giữa dữ liệu huấn luyện và môi trường suy luận thực tế. Mô hình được huấn luyện trên nhiều bộ dữ liệu gọi công cụ khác nhau, mỗi bộ có quy ước riêng. Kết quả là nó có thể sinh ra search_web trong khi công cụ thực tế tên là web_search, hoặc dùng city_name khi schema yêu cầu location.
Để đo lường vấn đề này, Moonshot AI đã công bố bộ K2VV ToolCall benchmark gồm 2000 yêu cầu, đánh giá hai chỉ số: trigger similarity (mức độ giống nhau trong việc quyết định khi nào gọi công cụ) và schema accuracy (tỷ lệ lệnh gọi tuân thủ schema).
 Biểu tượng GitHub màu cam
Constrained decoding: biến độ chính xác thành cam kết runtime
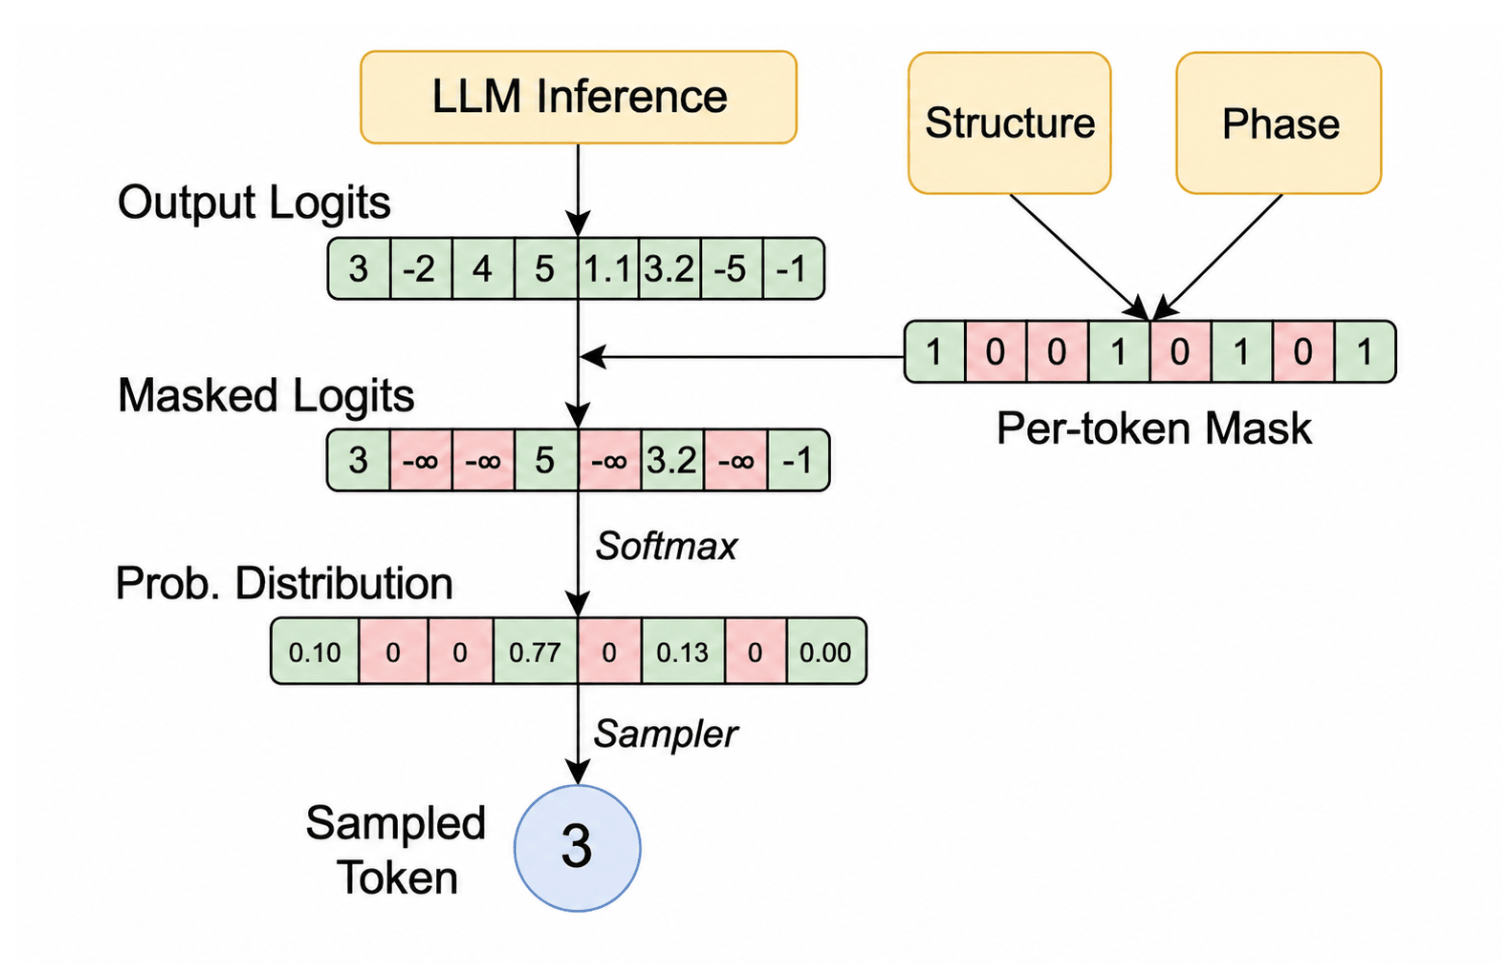
Constrained decoding là kỹ thuật chặn mô hình lấy mẫu những token sẽ tạo ra lệnh gọi sai cú pháp. Thay vì để mô hình sinh tự do rồi kiểm tra kết quả sau, engine suy luận sẽ dẫn dắt từng bước sinh token, chỉ cho phép những token hợp lệ theo schema.
vLLM triển khai kỹ thuật này thông qua thư viện XGrammar, sử dụng các thẻ cấu trúc để định nghĩa đường đi hợp lệ của một lệnh gọi:
- Bắt đầu lệnh gọi → Tên công cụ → Chỉ số lệnh gọi → Bắt đầu tham số → JSON ràng buộc theo schema → Kết thúc lệnh gọi
Mọi đường đi không hợp lệ đều bị chặn ngay trong quá trình sinh. Chẳng hạn, khi tới giai đoạn chỉ số lệnh gọi, engine chỉ cho phép token số nguyên và che (mask) toàn bộ phần còn lại.
Điều đáng chú ý là cơ chế này gần như không tốn thêm hiệu năng. Nhờ tính trước các mask token cho từng giai đoạn và áp dụng hiệu quả trên GPU, XGrammar đảm bảo lệnh gọi đúng mà không phải đánh đổi tốc độ.
Bài học từ thực tế triển khai
Moonshot AI khuyến nghị bật constrained decoding và API chính thức của họ cũng hoạt động theo cách này. Ubicloud ban đầu tự thêm tính năng vào bản fork vLLM của mình, sau đó chuyển sang dùng tính năng có sẵn từ upstream kể từ v0.25.
Thế nhưng không lâu sau, điểm số độ chính xác lại tụt về 91%. Nguyên nhân không phải do vLLM triển khai sai, mà do vLLM đã thay đổi hành vi mặc định: các yêu cầu không bật rõ ràng constrained decoding sẽ không được áp dụng.
Lý do khá dễ hiểu. vLLM phục vụ hàng trăm mô hình khác nhau, và hỗ trợ constrained decoding là công việc riêng cho từng mô hình. Các maintainer ghi nhận nhiều mô hình gặp trục trặc khi bật tính năng này, nên tắt mặc định là lựa chọn an toàn hơn. Sau đó, vLLM bổ sung cờ --tool-strict-level để người dùng chủ động bật.
Với Ubicloud, trọng tâm khác hẳn: họ chỉ phục vụ Kimi và DeepSeek với chất lượng tương đương nhà cung cấp gốc. Vì vậy, họ bật constrained decoding, chạy lại K2VV ToolCall benchmark và xác nhận 100% độ chính xác schema trên mọi phiên bản mô hình được phục vụ trước khi đưa lên production.
Chất lượng bạn thấy khi dùng LLM không chỉ phụ thuộc vào mô hình. Engine suy luận cũng đóng vai trò quan trọng không kém. Thay engine và cấu hình của nó, bạn thay đổi chất lượng đầu ra.
Ý nghĩa với cộng đồng phát triển tại Việt Nam
Với các đội ngũ Việt Nam đang tự dựng hạ tầng chạy mô hình mở — từ startup làm trợ lý AI đến doanh nghiệp triển khai agent nội bộ — câu chuyện này là lời nhắc thực tế. Chọn mô hình tốt chưa đủ; cần kiểm tra cả engine suy luận và các cờ cấu hình, đặc biệt là những tham số ảnh hưởng đến khả năng tuân thủ schema.
Nếu hệ thống của bạn có agent gọi API hay công cụ bên ngoài, hãy đo chỉ số schema accuracy trên chính workload của mình thay vì tin vào benchmark chung. Một lá cờ cấu hình có thể là khác biệt giữa 92% và 100% — và với các phiên hội thoại dài, khoảng cách đó tích lũy rất nhanh.
Bài viết liên quan
Công nghệ
Anthropic chính thức nộp hồ sơ IPO: Doanh thu bùng nổ, lỗ khủng và cấu trúc quản trị đặc biệt
26 tháng 10, 2026
Công nghệ
Kevin Roose và cuốn sách về AGI: Khi giới công nghệ tin rằng trí tuệ nhân tạo tổng quát đã cận kề
26 tháng 10, 2026
Công nghệ
Bản đồ hé lộ lực lượng lao động ẩn sau AI: Sinh viên Brown phơi bày "chủ nghĩa thực dân AI"
26 tháng 10, 2026