
Vì sao OpenAI và Anthropic đồng loạt giảm giá LLM tới 80% chỉ trong vài tháng?
Từ tháng 6 đến tháng 9/2026, OpenAI và Anthropic liên tục cắt giảm giá các mô hình ngôn ngữ lớn, có mô hình rẻ đi tới 80%. Nguyên nhân không chỉ là cuộc đối đầu song phương mà còn đến từ áp lực của các mô hình open-weight và hàng chục nhà cung cấp suy luận trên OpenRouter.
Vì sao OpenAI và Anthropic đồng loạt giảm giá LLM tới 80% chỉ trong vài tháng?
Chỉ trong khoảng bốn tháng, giá sử dụng các mô hình ngôn ngữ lớn (LLM) phổ biến nhất đã lao dốc chóng mặt, có trường hợp giảm tới 80%. Đằng sau màn giảm giá liên tục giữa OpenAI và Anthropic là áp lực cạnh tranh từ các mô hình open-weight, sự bùng nổ của các nhà cung cấp suy luận trung gian, và cả những toan tính trước thềm IPO.
Dòng thời gian của một cuộc chiến giảm giá
Nhìn lại các cột mốc chính, có thể thấy rõ thế "ăn miếng trả miếng" giữa hai ông lớn:
- 26/6/2026: OpenAI ra mắt GPT-5.6 Sol và Luna. Sol giữ nguyên mức giá cũ 5/30/0,50 USD (đầu vào/đầu ra/đọc cache, tính trên mỗi triệu token), còn Luna hướng đến các tác vụ rẻ hơn với giá 1/6/0,10 USD.
- 30/6/2026: Anthropic công bố Claude Sonnet 5 với mức giá khai trương 2/10/0,20 USD, ban đầu được cho là chỉ tạm thời.
- 24/7/2026: Claude Opus 5 ra mắt với giá 5/25/0,50 USD.
- 30/7/2026: OpenAI bất ngờ cắt giá GPT-5.6 Luna tới 80%, xuống còn 0,20/1,20/0,02 USD.
- 10/8/2026: Anthropic biến mức giá khai trương của Sonnet 5 thành giá chính thức.
- 21/8/2026: OpenAI giảm khoảng 20% giá GPT-5.6 Sol trong ba tháng.
- 1/9/2026: Anthropic ra mắt Fable 5.1, giảm 75% chi phí đọc cache so với bản trước.
- 3/9/2026: OpenAI công bố GPT-6 Astra với mức giá tương đương Fable 5.1 nhưng chưa có ưu đãi cache.
- 22/9/2026: GPT-6 Sol ra mắt với giá sốc 2/10/0,20 USD, cùng ngày Anthropic công bố Opus 5.5 với mức giảm tổng chi phí 40-60%.
- 29/9/2026: GPT-6.1 Sol ra mắt, tiếp tục cắt đôi giá cache, đưa cả dòng mô hình rẻ đi tổng cộng 75%.
 Chi phí trên mỗi tác vụ của GPT-5.6 Luna sau đợt giảm giá mạnh
Điểm đáng chú ý là các mô hình mới rẻ hơn nhưng không hề đánh đổi chất lượng đầu ra. Đây chính là điều khiến đợt giảm giá này khác biệt so với những lần "xả hàng" thông thường.
Chi phí đọc cache: khoản tiết kiệm bị xem nhẹ
Với các tác nhân lập trình (agentic coding), chi phí đọc cache chiếm tới 96-99% tổng chi phí token, bởi cache chứa toàn bộ hội thoại trước đó ở mỗi lượt. Tỷ lệ trúng cache thường đạt 90-100% tùy hạ tầng của nhà cung cấp suy luận.
Chỉ riêng việc giảm 75% chi phí đọc cache đã tương đương với mức giảm 70-75% tổng chi phí sử dụng mô hình — dù khoản này thường chỉ được ghi chú nhỏ ở cuối bảng giá.
Đây là lý do vì sao những con số như giá đầu vào hay đầu ra không phản ánh đầy đủ mức tiết kiệm thực tế mà người dùng được hưởng.
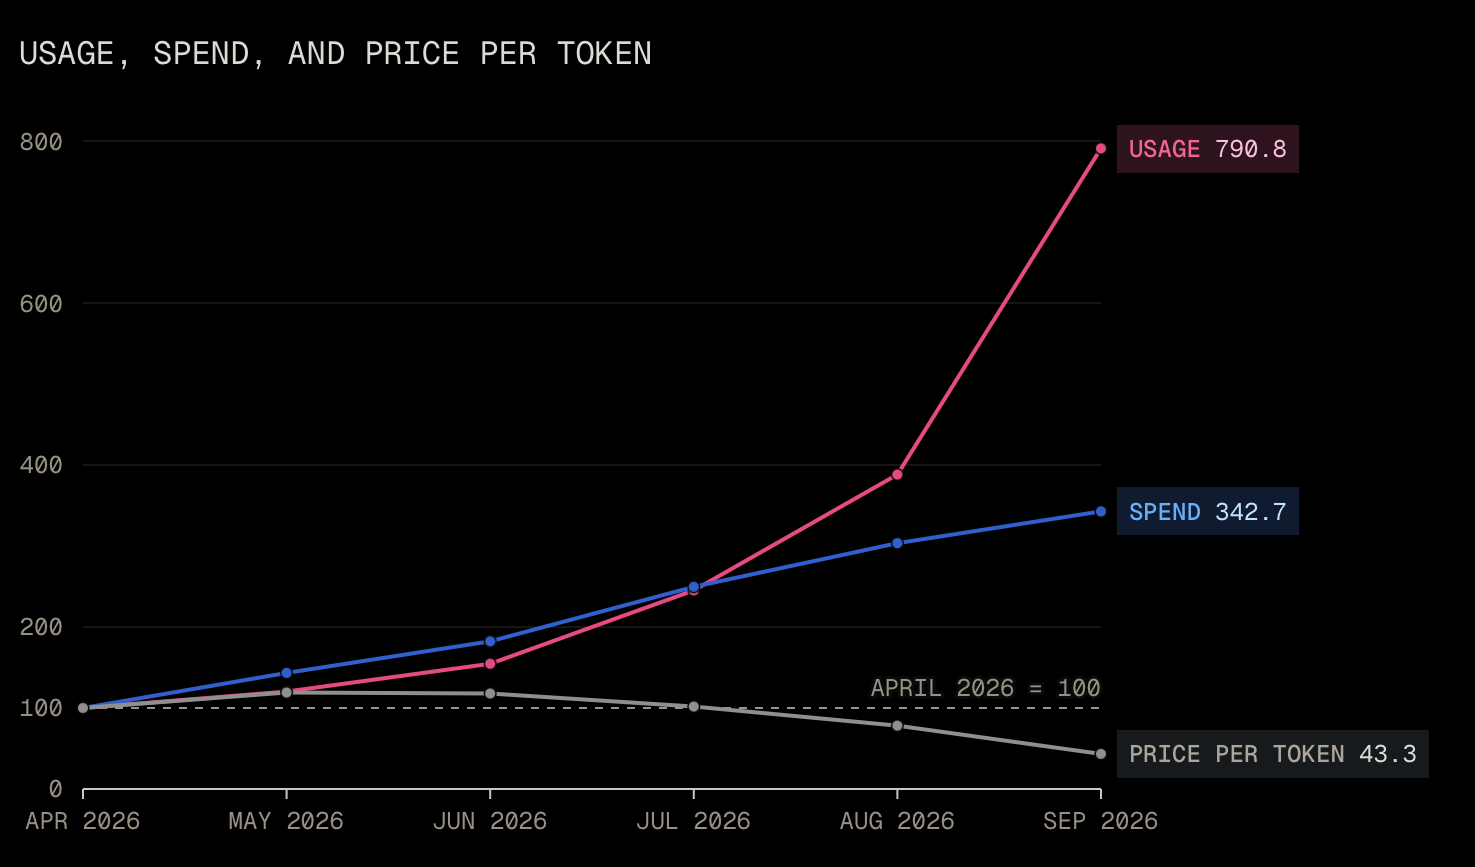
 Dữ liệu từ cổng AI của Vercel cho thấy chi phí trên mỗi token đang giảm mạnh
Kinh tế học hành vi và áp lực giá từ đối thủ
Theo dõi các mô hình mới ra mắt, người dùng khó phân biệt chúng ngoài cảm nhận chủ quan. Từ tháng 11/2025, khi các LLM tác nhân bùng nổ, mô hình đã trở nên phổ cập (commodity) đến mức chỉ cần một nút bật/tắt trong công cụ như OpenCode hay Zed Agent, hoặc đổi một chuỗi endpoint qua OpenRouter, là có thể thử mô hình mới trên mã nguồn của mình. Rào cản chuyển đổi gần như bằng không, đồng nghĩa lợi thế cạnh tranh (moat) rất mỏng.
Đáng chú ý, không chỉ Google hay Meta mới là đối thủ. Các mô hình open-weight như DeepSeek đang tạo sức ép giá trực tiếp. Bản DeepSeek V4 Flash hồi tháng 4/2026 có giá 0,14/0,28/0,0028 USD, trong đó tỷ lệ đọc cache chỉ 2% — thấp hơn nhiều so với mức 5-10% của OpenAI và Anthropic, khiến chi phí thực tế còn thấp hơn giá niêm yết. Nhiều khả năng đợt giảm giá 80% của GPT-5.6 Luna hồi tháng 7 chính là để đối phó với nhóm mô hình nhỏ này.
Bản DeepSeek Flash V4.1 1017 mới có hiệu năng vượt trội và giữ mức giá tương đương, với 29 nhà cung cấp khác nhau đang phục vụ mô hình này trên OpenRouter — con số từng chỉ là 13 hồi tháng 5.
 Danh sách các nhà cung cấp DeepSeek V4.1 Flash 1017 xếp theo chi phí đọc cache
 Chi phí hiệu dụng theo từng endpoint, với Cloudflare và DeepInfra chỉ cách DeepSeek chưa đến 10%
Lời cảnh báo "giá token sẽ tăng trở lại" khó thành hiện thực
Một lập luận quen thuộc của những người hoài nghi AI là: giá token đang được giữ thấp một cách nhân tạo để dụ người dùng, giống như Uber và Lyft đốt tiền trong thập niên 2010, rồi sẽ tăng vọt lên "chi phí thực" sau đó.
Tuy nhiên, khác với thời kỳ gọi xe, OpenAI và Anthropic không phải thế lực độc quyền nhóm có toàn quyền định giá. Rào cản gia nhập ngành suy luận không cao, và miễn là các nhà cung cấp vẫn phục vụ mô hình với giá và chất lượng tương đương, chi phí chuyển đổi không đáng kể thì giá còn có thể tiếp tục giảm.
Các yếu tố kinh tế hành vi cơ bản cũng ủng hộ điều này: nhà cung cấp chỉ duy trì mô hình khi giá trên mỗi token thấp hơn doanh thu trên mỗi token. Với 29 nhà cung cấp trên OpenRouter, không ai có lý do phục vụ một mô hình thua lỗ — họ chỉ cần chuyển công suất tính toán sang mô hình sinh lời. Kết quả là "chi phí thực của một token" rất có thể sẽ hội tụ về đúng chi phí cận biên.
Bài toán IPO và những hệ quả khó đoán
Thời điểm giảm giá đặc biệt đáng chú ý vì cả hai công ty đều được đồn sắp IPO — OpenAI vào năm 2027, Anthropic trong vài tháng tới. Cắt tới 80% nguồn thu chính dường như đi ngược lại những gì một hồ sơ S-1 cần thể hiện.
Nhưng biên lợi nhuận từ suy luận có thể kể câu chuyện khác, với một số báo cáo cho rằng biên lợi nhuận trên mỗi token lên tới 80% kèm vài điều kiện. Giới đầu tư chắc chắn sẽ soi kỹ con số này khi bản cáo bạch của Anthropic được công bố.
Một hệ quả tinh tế hơn: nếu các mô hình mới thực sự tiết kiệm tính toán hơn, nhu cầu xây dựng trung tâm dữ liệu quy mô lớn có thể giảm — kịch bản đầy nghịch lý về mặt kinh tế. Tuy vậy, suy luận chỉ là một phần trong tổng thể nhu cầu tính toán, nên rủi ro này khó xảy ra.
Đối với người dùng Việt Nam đang xây dựng ứng dụng AI, đây là thời điểm thuận lợi để thử nghiệm và tối ưu chi phí. Việc theo dõi bảng giá trên OpenRouter và lựa chọn endpoint có chi phí hiệu dụng thấp nhất có thể giúp tiết kiệm đáng kể, đặc biệt với các tác nhân lập trình chạy liên tục.
Dù đợt giảm giá này có kỳ lạ đến đâu, người dùng chắc chắn không có gì để phàn nàn. Các mô hình open-weight và nhà cung cấp suy luận thứ cấp sẽ tiếp tục đóng vai trò "phanh kinh tế" cho giá LLM, và ngay cả khi IPO của hai ông lớn thất bại, ngành AI cũng khó sụp đổ theo.


