
Vì sao truyện do AI viết luôn khiến người đọc thấy 'sai sai'?
Nghiên cứu StoryScope phân tích hơn 61.000 truyện ngắn để tìm ra những khác biệt trong cách AI xây dựng cấu trúc câu chuyện so với con người. Kết quả cho thấy AI có xu hướng giải thích rõ bài học đạo đức, xây dựng cốt truyện gọn gàng và lạm dụng các mô tả cảm xúc qua phản ứng cơ thể — những dấu vết khó xóa bỏ dù có chỉnh sửa lại văn phong.
Vì sao truyện do AI viết luôn khiến người đọc thấy "sai sai"?
Chúng ta đang sống trong một thời đại công nghệ đầy thú vị, với rất nhiều câu hỏi về đạo đức và tính hợp pháp của việc dùng AI để sáng tạo nội dung. Nhiều nhà nghiên cứu đã tự mình tìm kiếm những quy luật trong những gì AI tạo ra, cố gắng "định lượng hóa" cảm giác kỳ lạ mà ta có khi đọc một văn bản do máy viết.
Nói một cách đơn giản, họ đi tìm lời giải cho câu hỏi: liệu một câu chuyện có thể "quá gọn gàng", "quá sạch sẽ", "quá đi thẳng vào vấn đề" hay không?
 Minh họa về trí tuệ nhân tạo và sáng tạo nội dung
Hãy thử hình dung một truyện ngắn kể về người phụ nữ trở về ngôi nhà thời thơ ấu sau hai mươi năm. Cô tìm thấy một lá thư giấu sau tấm ván sàn lỏng. Lá thư hé lộ một bí mật gia đình. Cô đối chất với mẹ, cuối cùng hiểu vì sao tuổi thơ mình lại phức tạp đến vậy, và rút ra một bài học quan trọng về sự tha thứ.
Thoạt nghe, đây là một cốt truyện hoàn toàn hợp lý. Mạch truyện rõ ràng, nhân vật có động cơ logic, cái kết gắn kết mọi thứ lại với nhau. Nhưng nếu thử một phiên bản khác thì sao? Truyện mở đầu ở đám tang người mẹ, nhảy lùi hai mươi năm về quá khứ, rồi tiến ba ngày, rồi rẽ ngang sang một ký ức tưởng chừng chẳng liên quan. Lá thư mâu thuẫn với điều ta được biết trước đó. Người con gái đưa ra một quyết định mà tùy góc nhìn, có thể là dũng cảm hoặc ích kỷ. Và cái kết từ chối giải thích bất cứ điều gì.
Vậy phiên bản nào "giống người viết" hơn? Câu hỏi này mang tính chủ quan. Nhiều nhà văn thích cái kết gọn gàng, và không ít truyện do AI tạo ra lại kỳ lạ một cách thú vị. Nhưng nếu những trực giác đó phản ánh các quy luật có thể đo lường được thì sao?
Vấn đề của các công cụ phát hiện AI hiện nay
Phần lớn công việc phát hiện AI tập trung vào cách văn bản được viết ra: tìm những từ ngữ đặc trưng, mức độ dự đoán được của câu, hay các mẫu thống kê quen thuộc trong văn phong.
Những tín hiệu này hữu ích, nhưng chúng có thể thay đổi. Một mô hình ngôn ngữ có thể học cách tránh những sáo ngữ AI phổ biến, một biên tập viên có thể viết lại đoạn văn đáng ngờ, và một câu lệnh (prompt) tốt có thể khiến văn máy tạo ra nghe tự nhiên hơn nhiều.
Khi mô hình mới thay đổi vốn từ và cấu trúc câu, các phân bố đặc trưng dịch chuyển, và ranh giới phân loại từng hiệu quả trước đó có thể không còn đúng nữa.
Nghiên cứu StoryScope đặt câu hỏi: liệu ta có thể nhìn xa hơn các đặc trưng bề mặt đó không? Những câu hỏi họ đặt ra gồm: Ai là người đẩy cốt truyện tiến lên? Chuỗi sự kiện dễ đoán đến mức nào? Truyện có tuyến phụ không? Người kể chuyện giải thích ý nghĩa sự kiện nhiều đến đâu? Truyện có nhảy cóc về thời gian không? Các quyết định của nhân vật rõ ràng về mặt đạo đức đến mức nào?
Đây là những đặc trưng mô tả kiến trúc của câu chuyện — và thay đổi chúng là việc lớn hơn nhiều so với việc thay vài từ.
Biến truyện thành dữ liệu
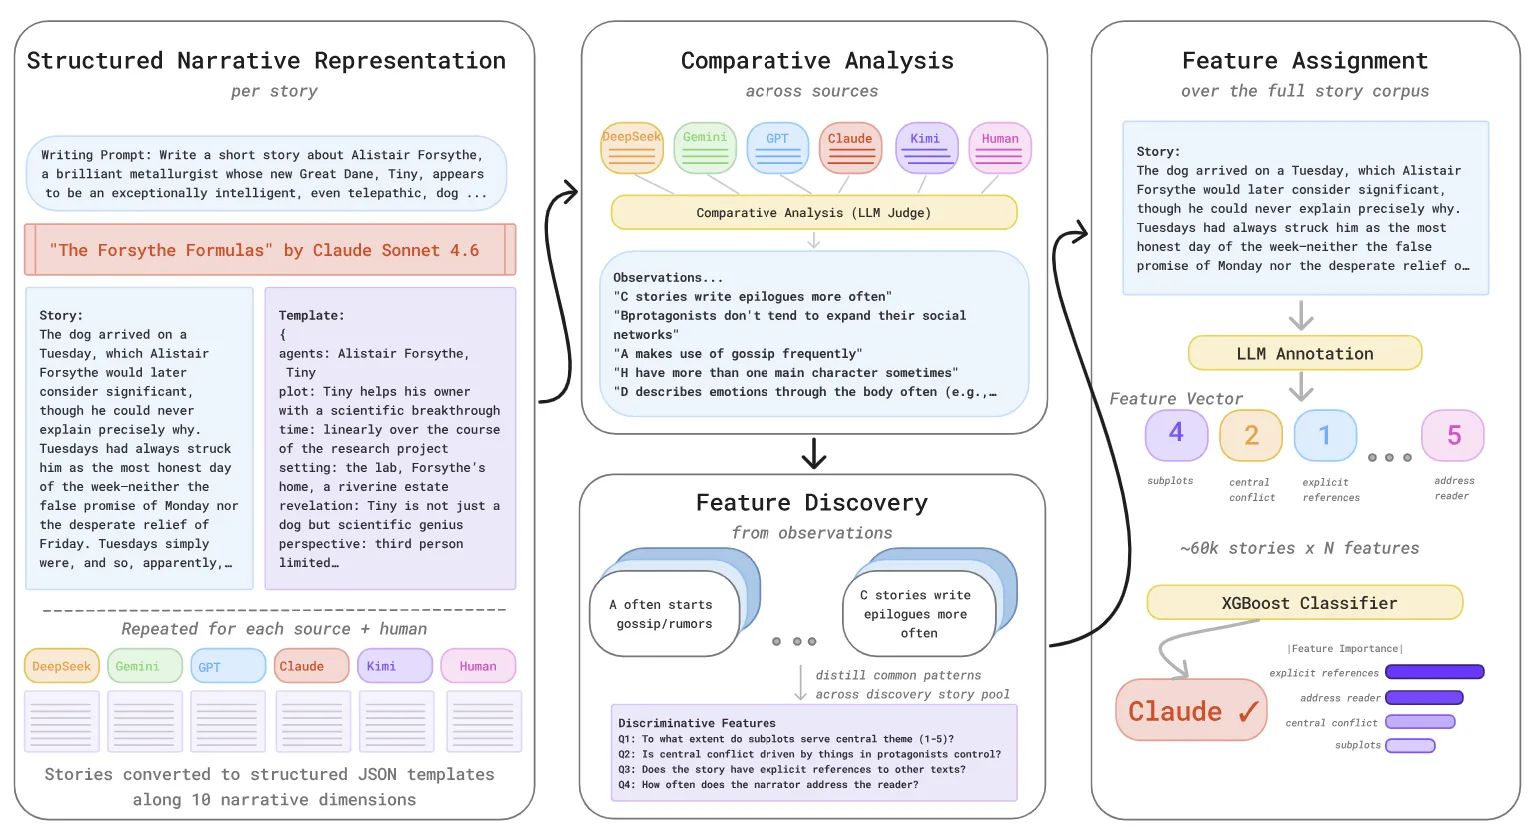
Nhóm nghiên cứu StoryScope đã xây dựng một quy trình để "định lượng hóa sự sáng tạo". Họ dùng một bộ dữ liệu gồm 10.272 đề bài viết. Với mỗi đề, họ ghép một truyện do con người viết với năm phiên bản do các mô hình Claude, DeepSeek, Gemini, GPT và Kimi tạo ra — tổng cộng 61.632 truyện.
Các truyện dài trung bình khoảng 4.753 từ, đủ dài để nghiên cứu cấu trúc tường thuật ở mức mà văn bản ngắn hơn không đáp ứng được. Sau đó, họ phát triển quy trình ba bước để trích xuất 304 đặc trưng tường thuật từ mỗi truyện.
- Bước 1: Chuyển văn xuôi thành biểu diễn có cấu trúc. Một mô hình AI trích xuất thông tin như nhân vật, động cơ, sự kiện, bối cảnh, cấu trúc cốt truyện và tổ chức thời gian.
- Bước 2: So sánh các truyện viết từ cùng một đề bài, nhờ đó kiểm soát được khác biệt về ngữ cảnh.
- Bước 3: Chuyển các quan sát tường thuật thành đặc trưng đo lường được, mỗi đặc trưng là một câu hỏi với các lựa chọn trả lời xác định.
Kết quả là một vector đặc trưng mô tả các quyết định tường thuật của truyện. Nhóm nghiên cứu dùng bộ phân loại XGBoost và phân tích mức độ quan trọng của đặc trưng để tìm ra những quyết định phân biệt tốt nhất giữa văn do người viết và văn do AI viết.
Kết quả nghiên cứu
Bộ phân loại dùng đặc trưng tường thuật, loại bỏ hoàn toàn các đặc trưng văn phong, đạt điểm macro-F1 là 93,2% trong bài toán phân biệt người viết với AI. Mô hình cũng đạt 68,4% macro-F1 khi phân biệt giữa cả sáu nguồn — một việc khó hơn nhiều, vì nhận biết nội dung nào do AI tạo ra không giống với việc xác định chính xác mô hình nào đã viết ra nó.
Vậy họ tìm ra điều gì? Ba quy luật nổi bật trong cách AI viết truyện hư cấu:
1. AI thích giải thích rõ ý nghĩa
Các truyện do AI tạo ra nêu thẳng chủ đề của mình trong 77% trường hợp, so với 52% ở truyện do người viết. Hãy so sánh hai kiểu kết truyện: kiểu thứ nhất là "Cuối cùng cô hiểu ra rằng tha thứ không phải là quên đi quá khứ, mà là tìm được can đảm để bước tiếp". Kiểu thứ hai là "Cô gấp lá thư, đặt lại dưới tấm ván sàn, và rời khỏi ngôi nhà trước khi mặt trời mọc".
Cách thứ nhất nói toạc ra bài học đạo đức, cách thứ hai để ngỏ cho người đọc tự cảm nhận. Đôi khi một câu chuyện được lợi từ việc nói rõ thông điệp, nhưng khi mô hình liên tục chọn cách giải thích tường minh thì đó trở thành một quy luật có thể đo lường được.
2. AI thích cốt truyện gọn gàng
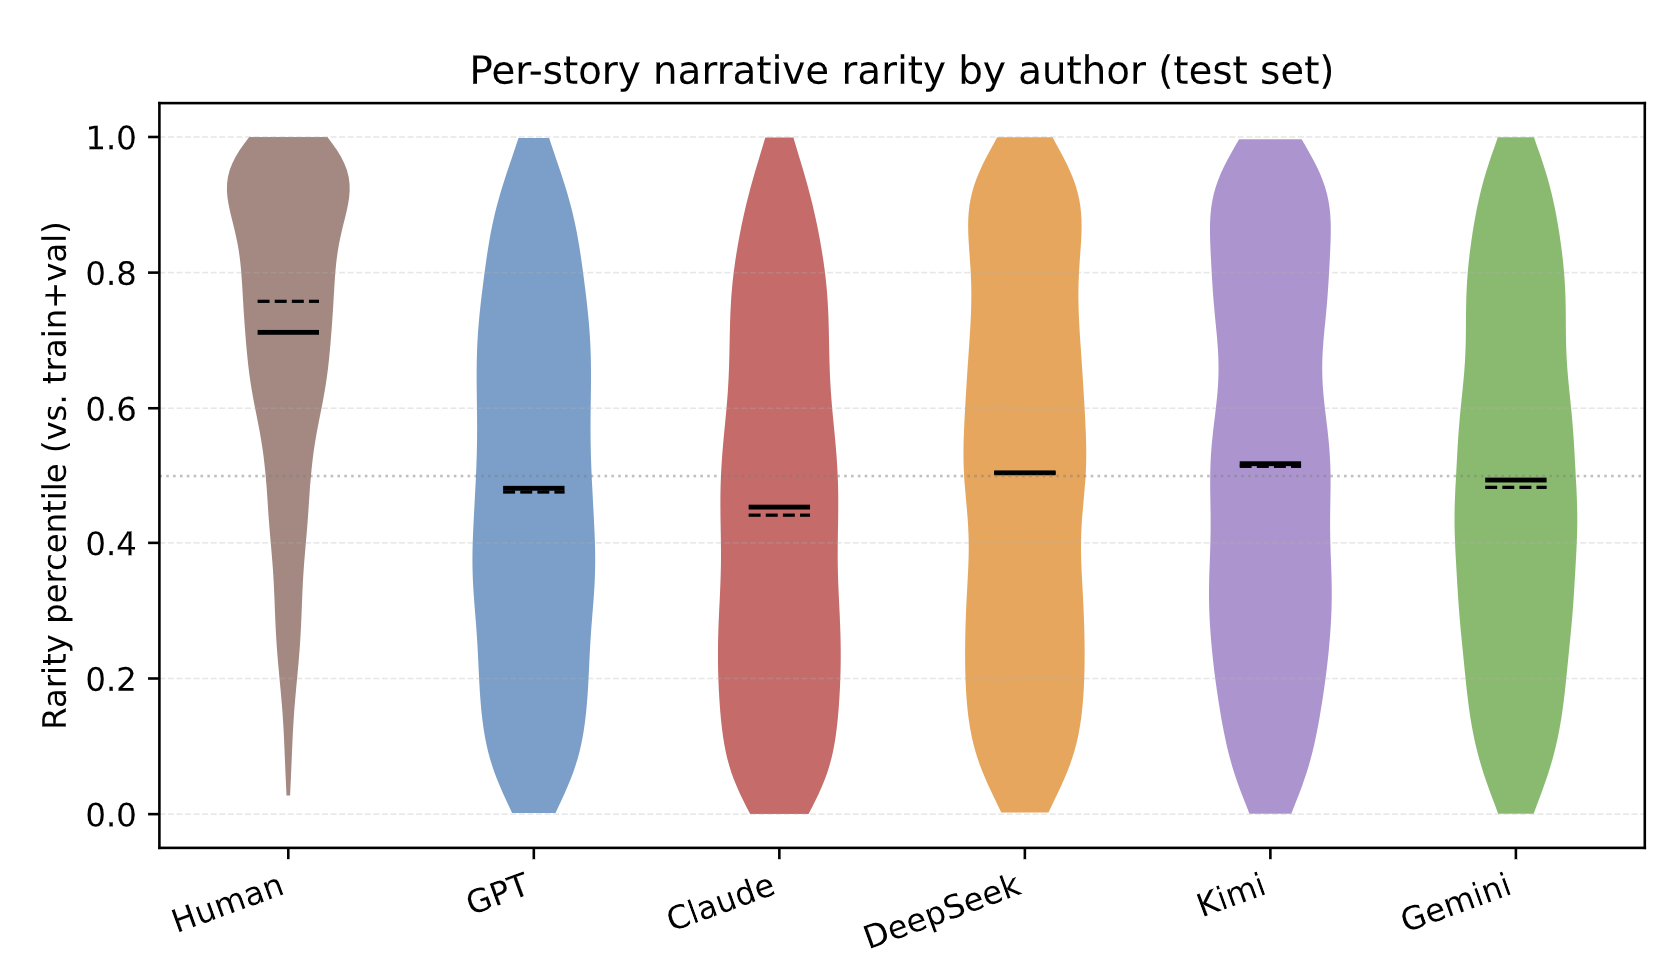
Truyện AI thường có chuỗi nhân quả đơn giản và ít tuyến phụ hơn. Khoảng 79% truyện AI không có tuyến phụ, so với 57% ở truyện người viết. Truyện AI cũng giải quyết xung đột thông qua lựa chọn của nhân vật chính thường xuyên hơn: 69% so với 46%.
Ngược lại, truyện của con người có xu hướng có nhân vật mơ hồ về đạo đức, dòng thời gian phi tuyến tính và những căng thẳng không được giải quyết. Cấu trúc kiểu này khó tóm gọn thành một chuỗi nhân quả, trong khi truyện AI lại có hình hài tường thuật rất đều đặn, đồng nhất.
3. AI có thể... kịch tính quá mức!
Một phát hiện khá thú vị liên quan đến mô tả giác quan: truyện do AI tạo ra truyền tải cảm xúc qua cảm giác cơ thể và ẩn dụ thể chất thường xuyên hơn nhiều — 81% so với 38% ở truyện người viết. Hãy nghĩ đến kiểu kết hợp quen thuộc trong văn học: lồng ngực thắt lại, mồ hôi lạnh, đôi tay run rẩy, và căn phòng bỗng trở nên tối hơn.
Trong bộ dữ liệu nghiên cứu, các nhà văn con người lại thường dùng những nhãn cảm xúc trực tiếp thay vì mô tả thể chất. Cần lưu ý rằng đây là đặc điểm của bộ dữ liệu cụ thể này, không phải quy luật phổ quát của mọi sáng tác người viết.
 Minh họa phân tích dữ liệu và cấu trúc câu chuyện
Chỉnh sửa bề mặt không xóa được dấu vết
Nhiều người tạo văn bản bằng AI rồi chỉnh sửa để nghe tự nhiên hơn: loại bỏ sáo ngữ, thay đổi độ dài câu, thay các từ chuyển tiếp chung chung, xóa những đoạn lặp lại ý trước đó.
Nhưng điều gì xảy ra nếu bạn cải thiện phần chữ mà không thay đổi phần truyện bên dưới?
Nhóm nghiên cứu trả lời câu hỏi này bằng phương pháp viết lại gọi là LAMP, áp dụng chỉnh sửa bề mặt để xóa các dấu hiệu AI phổ biến lên 278 truyện do Gemini tạo ra. Kết quả phân loại đạt 95,5% macro-F1 trên các truyện gốc và 93,9% trên các phiên bản đã chỉnh sửa — chênh lệch không đáng kể, vì việc chỉnh sửa chỉ thay đổi văn phong chứ không thay đổi cấu trúc tường thuật bên dưới.
Dù vậy, cần nhấn mạnh một điều kiện quan trọng: thí nghiệm chỉnh sửa chỉ bao gồm 278 truyện từ một mô hình duy nhất là Gemini. Đây là bằng chứng rằng các đặc trưng tường thuật có thể tồn tại qua một kiểu chỉnh sửa văn phong nhất định, chứ không phải bằng chứng rằng mọi truyện do AI viết sẽ luôn bị phát hiện sau mọi kiểu chỉnh sửa.
Có thực sự dùng được để phát hiện AI viết không?
Một nghiên cứu tốt luôn nêu rõ giới hạn của mình. Thứ nhất, StoryScope chỉ nghiên cứu truyện hư cấu dài, nên kết quả không tự động áp dụng cho email, bài luận, tài liệu kỹ thuật, bài đăng mạng xã hội hay bài báo ngắn.
Thứ hai, bộ dữ liệu được xây dựng theo cách đặc thù: ghép truyện người viết với truyện AI dựa trên các đề bài được tái tạo lại. Đây là một so sánh có kiểm soát, nhưng không phản ánh mọi cách người ta dùng AI trong thực tế.
Thứ ba, chính các nhà nghiên cứu gán nhãn đặc trưng tường thuật bằng mô hình ngôn ngữ. Và như thường lệ, một điểm phân loại cao không chứng minh được rằng một cá nhân cụ thể đã dùng AI.
Kết quả 93,2% macro-F1 chỉ đúng với bối cảnh đánh giá của nghiên cứu này. Nó không có nghĩa là một công cụ phát hiện có thể soi bất kỳ văn bản nào và xác nhận đáng tin cậy tác giả hay tính nguyên bản của nó.
Điểm đóng góp của StoryScope không phải là phân tích tường thuật vượt qua mọi công cụ phát hiện khác, mà là các đặc trưng tường thuật diễn giải được vẫn giữ sức mạnh dự báo đáng kể mà không dựa vào văn phong bề mặt.
Suy nghĩ cuối cùng
Rất dễ biến những nghiên cứu như thế này thành một kết luận đơn giản hóa: "Văn do AI viết thì luôn dở". Tôi không nghĩ dữ liệu ủng hộ điều đó. Truyện do AI tạo ra có thể thú vị; một cốt truyện tuyến tính có thể chính là điều người đọc muốn. Chủ đề tường minh không phải là khuyết điểm văn học, và sự mơ hồ không tự động là dấu hiệu của thiên tài.
Mô hình ngôn ngữ có thể tạo ra những câu văn thuyết phục trong khi vẫn thể hiện những thiên kiến có hệ thống trong cách chúng tổ chức câu chuyện. Ta thấy điều này suốt ngày khi làm việc với các mô hình học máy: một mô hình có thể đạt kết quả tốt trên một tác vụ trong khi vẫn bộc lộ thiên kiến trong các mẫu mà nó dùng để đạt được kết quả đó. Chỉ nhìn vào điểm số đầu ra cuối cùng có thể che giấu những mẫu hình ấy.
Các tác giả cho rằng đánh giá AI tạo sinh cần nhiều hơn việc hỏi liệu đầu ra có nghe hợp lý hay không; họ khuyến khích ta nghĩ cách làm một câu chuyện trở nên thú vị hơn không chỉ bằng việc thay những từ dễ đoán bằng từ lạ, mà bằng cách đặt câu hỏi ngay với chính cấu trúc truyện.
Có lẽ bước tiếp theo trong phát triển AI tạo sinh không chỉ là tạo ra những từ ngữ thuyết phục hơn, mà là học được khi nào không nên đi theo con đường tường thuật hiển nhiên nhất. Đó, theo tôi, là một bài toán thú vị hơn nhiều so với việc đếm số dấu gạch ngang dài. Và như vậy, những người viết — chủ yếu là tôi — có thể yên tâm dùng lại dấu gạch ngang dài mà không bị buộc tội dùng AI.
Tài liệu tham khảo: Russell, J., Rajendhran, R., Pham, C. M., Iyyer, M., and Wieting, J. (2026). StoryScope: Investigating Idiosyncrasies in AI Fiction. Conference on Language Modeling (COLM 2026).
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Hồ sơ IPO của Anthropic hé lộ chiến lược giữ chân khách hàng doanh nghiệp
26 tháng 10, 2026