Vì sao "vụ nổ trí tuệ" vẫn chưa xuất hiện?
Nhà tương lai học Ramez Naam phân tích sự hoài nghi về khả năng AI tự cải thiện đệ quy (RSI) dẫn tới siêu trí tuệ bùng nổ. Dựa trên dữ liệu thực tế từ OpenAI và Anthropic, ông ước tính vòng lặp tự cải thiện hiện tại còn yếu hơn ngưỡng cần thiết khoảng 5-10 lần để có thể tự duy trì.
Vì sao "vụ nổ trí tuệ" vẫn chưa xuất hiện?
Trong giới AI, niềm tin vào một "vụ nổ trí tuệ" — thời điểm AI tự cải thiện bản thân đến mức tạo ra siêu trí tuệ nhân tạo (ASI) chỉ trong vài tháng, vài ngày, hoặc thậm chí vài giờ — đã trở thành một giáo điều gần như bất khả xâm phạm. Nhưng Ramez Naam, một trong những nhà tương lai học hàng đầu thế giới, lại đưa ra một góc nhìn hoàn toàn trái ngược: dữ liệu thực tế cho thấy vòng lặp tự cải thiện của AI vẫn còn quá yếu để có thể tự duy trì, chứ chưa nói đến việc bùng nổ.
Tự cải thiện đệ quy (RSI) là gì?
Khái niệm Recursive Self-Improvement (RSI) — tự cải thiện đệ quy — được dùng để mô tả nhiều mức độ khác nhau, từ việc AI hỗ trợ các nhà nghiên cứu con người làm việc hiệu quả hơn, cho đến việc AI tự khởi động bản thân để đạt tới trí tuệ không thể hiểu nổi.
Naam phân loại RSI thành 5 cấp độ:
- Loại 1: AI giúp tăng năng suất của các nhà nghiên cứu con người
- Loại 2-4: Tăng dần mức độ tự chủ, nhưng vẫn đối mặt với quy luật lợi suất giảm dần
- Loại 5: Vòng lặp tự chạy không kiểm soát dẫn tới siêu trí tuệ
Chúng ta đã có tiến bộ thực sự ở Loại 1 và Loại 2. AI hiện đang hỗ trợ cả nhà nghiên cứu lẫn kỹ sư bên trong các công ty AI, và các mô hình mạnh có thể huấn luyện, cải thiện các mô hình nhỏ hơn. Nhưng chưa có bằng chứng rõ ràng cho Loại 3, và chắc chắn chưa có gì cho Loại 4.
Naam cho rằng tự cải thiện tự chủ sẽ đến vào một thời điểm nào đó. Nhưng ông hoài nghi việc nó dẫn tới Loại 5 — siêu trí tuệ bùng nổ — mà không cần một bước đột phá khái niệm lớn.
 Vòng lặp tự cải thiện của AI
Siêu trí tuệ hẹp đã tồn tại, nhưng đó không phải câu chuyện
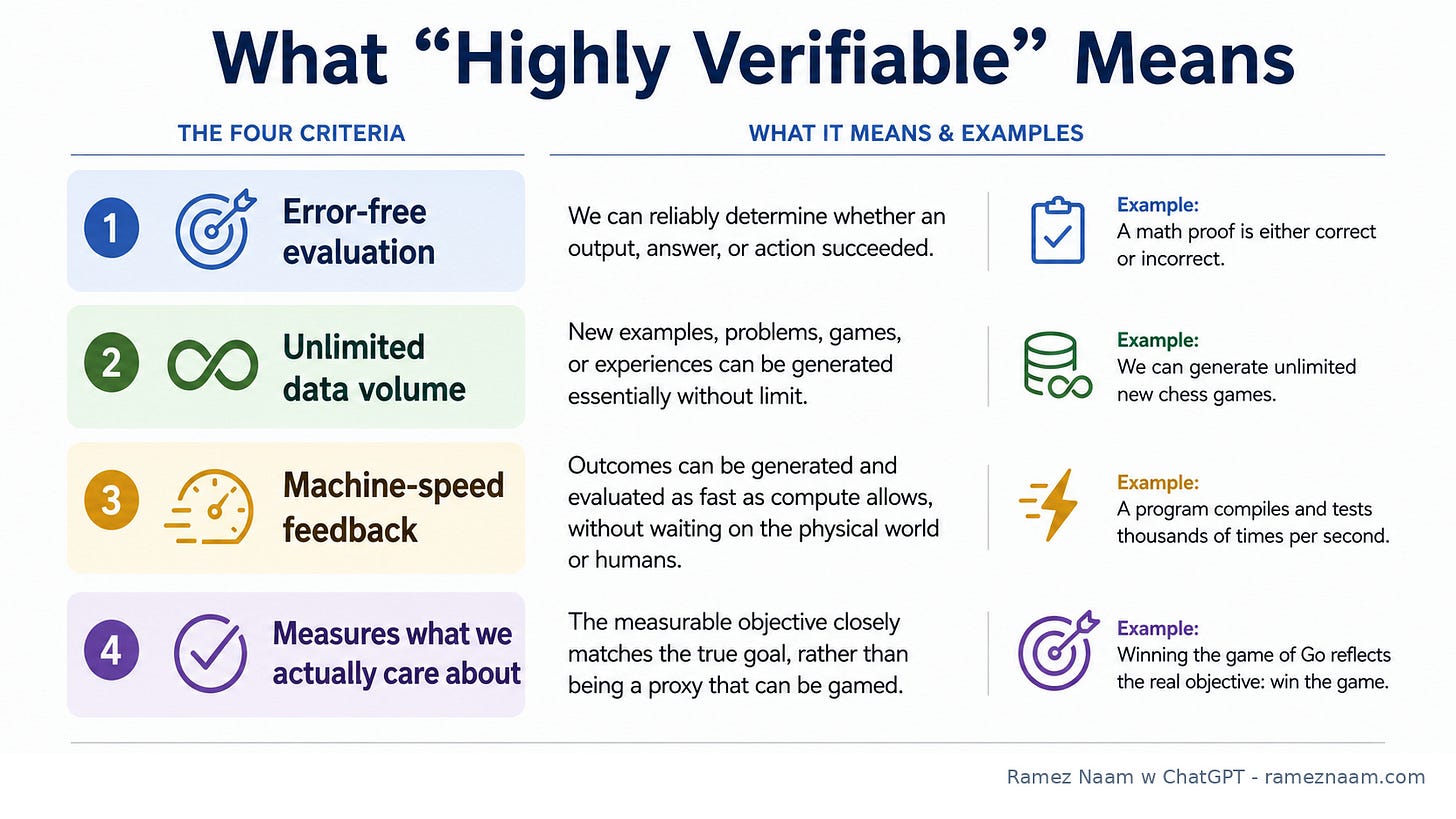
Naam dự đoán siêu trí tuệ hẹp sẽ xuất hiện trong các lĩnh vực có khả năng kiểm chứng cao: cờ vua, cờ vây, toán học hình thức, một phần của khoa học máy tính và lập trình. Đây là những lĩnh vực mang tính hình thức và có cấu trúc, nơi máy có thể tạo ra lượng dữ liệu huấn luyện vô hạn và kiểm chứng đúng/sai gần như hoàn hảo.
Thực tế, chúng ta đã có siêu trí tuệ hẹp trong lập trình trò chơi và đang chứng kiến điều này ở những phần hình thức nhất của toán học, đặc biệt là chứng minh và tìm phản ví dụ bác bỏ các giả thuyết lớn. Ví dụ, OpenAI gần đây báo cáo một chứng minh do AI tạo ra giải quyết bài toán tồn tại và tính trơn của Navier–Stokes.
Nhưng đó không phải là siêu trí tuệ tổng quát. Ngay cả những mô hình mạnh nhất của chúng ta vẫn cần lượng dữ liệu huấn luyện lớn hơn con người rất nhiều, gặp khó khăn khi học từ trải nghiệm liên tục, và thất bại một cách đáng ngạc nhiên ở những việc con người thấy đơn giản. Toán học siêu phàm không tự động đồng nghĩa với phán đoán siêu phàm ở mọi lĩnh vực khác.
Khoảng cách giữa benchmark và thực tế
Các benchmark và dự báo cho rằng mô hình AI nên thành công một cách đáng tin cậy ở các tác vụ lập trình mà con người cần hàng giờ để hoàn thành. Thực tế phức tạp hơn nhiều.
Dữ liệu nội bộ của OpenAI cho thấy các mô hình của họ chỉ hoàn thành thành công 86% các tác vụ mà con người cần dưới 15 phút, ngay cả khi không có sự can thiệp của con người. Độ dài tác vụ ước tính đạt 80% thành công chỉ khoảng 15 phút trong bảy tháng đầu năm.
Trong khi đó, METR — tổ chức chuyên đánh giá năng lực AI — ước tính mô hình tốt nhất có thể thành công 80% các tác vụ lập trình mà con người cần ba giờ. Theo công thức của Epoch, mỗi 5 điểm ECI tăng thêm tương ứng với việc gấp đôi độ dài tác vụ METR. Kịch bản AI 2027 thậm chí dự báo tới tháng 7/2026, AI tiên tiến sẽ thành công 80% ở các tác vụ dài khoảng 11 giờ.
Khoảng cách thực sự rất lớn: đường chân trời nghiên cứu thực tế tại OpenAI ở mức 80% thành công chỉ khoảng 15 phút. So với benchmark 4 giờ, con số này ngắn hơn 16 lần. So với dự báo 11 giờ của AI 2027, nó ngắn hơn 44 lần.
Nghiên cứu AI thực tế tại OpenAI khó hơn các chỉ số, benchmark hay dự báo từ một bậc độ lớn trở lên. Điều đó khiến chúng ta phải thận trọng khi dựa quá nhiều vào benchmark, hoặc nói rằng các kịch bản tương lai như AI 2027 đang "đúng tiến độ".
 Từ token đến mã nguồn đến thí nghiệm
Lợi suất giảm dần ở mọi hướng tiếp cận
Ngay cả khi các con số về sử dụng AI trông ấn tượng — nhà nghiên cứu dùng lượng token nhiều gấp 124 lần, kỹ sư viết lượng mã gấp 7 lần — thì đó chỉ là các chỉ số trung gian, không phải kết quả cuối cùng.
Tốc độ thí nghiệm tăng 1,6 lần so với mức trung bình cả năm 2025 của OpenAI. Nhưng ngay cả con số đó cũng không có nghĩa là AI đang cải thiện nhanh hơn 1,6 lần. Trong hầu hết các ngành khoa học, số lượng thí nghiệm tăng thêm cũng có lợi suất giảm dần rất dốc. Điều đó có nghĩa là mức tăng 60% tốc độ thí nghiệm có thể chỉ tương đương khoảng 10% tốc độ cải thiện AI.
Anthropic thậm chí còn thẳng thắn hơn trong tài liệu hệ thống của mình: để tăng gấp đôi tốc độ tiến bộ AI nhờ kênh năng suất, họ ước tính AI cần tăng năng suất nhân viên lên khoảng 40 lần so với khi không có AI hỗ trợ.
Việc cho mô hình thêm thời gian suy nghĩ cũng có lợi suất giảm dần theo hàm logarit. Mỗi lần gấp đôi lượng tính toán cho mô hình chỉ mang lại mức tăng thành công tương đương, trong khi chi phí tăng gấp đôi.
Với các "bầy" agent (agent swarm), quy tắc ước lượng thô là căn bậc hai. Nếu một agent có thể hoàn thành tác vụ trong 10 giờ, thì 100 agent có thể làm trong 1 giờ — nhưng chi phí tính toán tăng gấp 10 lần. Thêm vào đó, các agent thường suy nghĩ giống nhau: một nghiên cứu so sánh LLM với 467 người cho thấy mười phản hồi AI đầu tiên có mức sáng tạo tập thể tương đương khoảng 8-10 người, nhưng sau đó khoảng hai phản hồi AI mới chỉ tương đương một phản hồi người.
Vòng lặp tự cải thiện yếu hơn ngưỡng cần thiết
Tom Cunningham và các cộng sự đã mô hình hóa vòng lặp tự cải thiện trong bài báo "The Economics of Recursive Self-Improvement". Họ đặt ra hai câu hỏi: ngưỡng nào để tạo ra vòng lặp tự duy trì, và con số thực tế hiện nay là bao nhiêu?
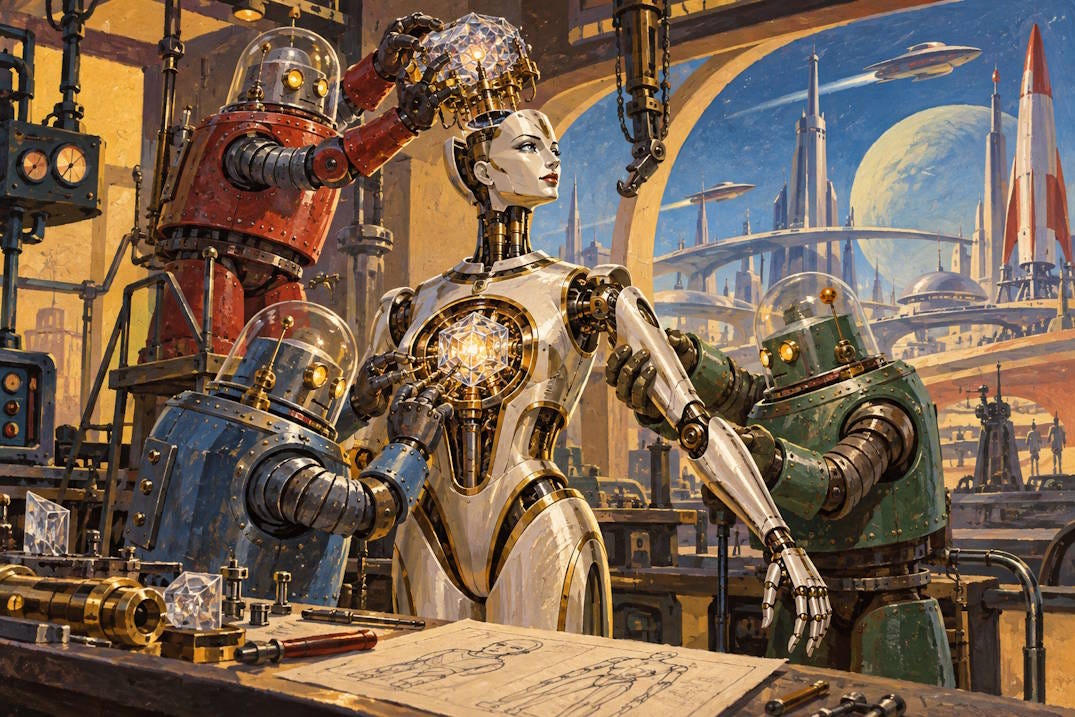
Kết quả: ngưỡng tự duy trì RSI vào khoảng 15% năng suất nghiên cứu tăng thêm cho mỗi điểm ECI. Cập nhật với dữ liệu từ thí nghiệm Stockfish, ngưỡng này nhích lên khoảng 19%.
Ước tính ban đầu của Cunningham cho rằng mức tăng năng suất hiện tại khoảng 9% mỗi điểm ECI — vẫn dưới ngưỡng. Nhưng khi Naam dùng dữ liệu mới hơn từ OpenAI — dựa trên số thí nghiệm thực tế được ghi lại chứ không phải khảo sát tự đánh giá — con số này chỉ còn khoảng 2-3% mỗi điểm ECI.
 So sánh các ước tính năng suất
Naam lý giải vì sao ông đặt nhiều trọng số hơn vào dữ liệu OpenAI: đó là đo lường trực tiếp và toàn diện thay vì khảo sát, bao phủ toàn bộ mẫu thay vì chỉ 130 nhân viên tự nguyện trả lời, và lượng dữ liệu lớn hơn nhiều lần.
Với giả định 2-3% mỗi điểm ECI so với ngưỡng 15-19%, khoảng cách là 5 đến 10 lần. Đó là một khoảng cách lớn.
Vì sao tiến bộ ngày càng khó?
Tom Cunningham và Manish Shetty đưa ra một ẩn dụ hữu ích về hái táo. AI có thể hái nhanh những quả táo thấp, trong khi con người vẫn với tới được những quả mà AI không tới. Nhưng khi những quả đó đã hái hết, một bản sao khác của cùng agent tìm lại chúng cũng không giúp gì. Mô hình mạnh hơn có thể với cao hơn — nhưng táo cũng có thể thưa dần và xa nhau hơn khi bạn leo lên.
Mô hình này xuất hiện khắp nơi trong R&D. Bloom và các cộng sự ghi nhận các lĩnh vực nơi nỗ lực nghiên cứu tăng trong khi năng suất nghiên cứu giảm. Ví dụ nổi tiếng là Định luật Eroom: trong dữ liệu phát triển thuốc, chi phí R&D điều chỉnh lạm phát cho mỗi loại thuốc mới được phê duyệt tăng gấp đôi sau mỗi chín năm.
Anthropic mô tả mô hình Opus 5.5 một cách thẳng thắn: "nó yếu hơn ở nghiên cứu mở — người dùng nội bộ báo cáo rằng nó chủ yếu kiểm tra các ý tưởng gia tăng và thích những giả thuyết ít tham vọng hơn, và trong bài tập sinh học do con người thực hiện, nó dựa vào tài liệu đã công bố và gặp khó khăn trong việc phát triển ý tưởng mới."
METR bổ sung: "chúng tôi kỳ vọng rằng tự động hóa hoàn toàn R&D AI sẽ cần những cải thiện lớn về tầm nhìn xa, dự đoán, tạo vòng phản hồi cho chính mình, và nói chung là những kỹ năng khác thường được gọi là 'phán đoán' hay 'gu' của nhà nghiên cứu."
Điều gì có thể tăng tốc?
Naam thừa nhận ông có thể sai. Các nhà dự báo đã nhiều lần đánh giá thấp tiến bộ AI, và ông có thể là người tiếp theo.
Vòng lặp phần mềm này tồn tại song song với chip nhanh hơn, trung tâm dữ liệu lớn hơn, nhiều dữ liệu huấn luyện hơn và đầu tư lớn hơn. Những yếu tố đó có thể tiếp tục thúc đẩy tiến bộ nhanh ngay cả khi vòng lặp không tự duy trì được.
Một đột phá ở tầm cỡ kiến trúc Transformer năm 2017 có thể thay đổi hoàn toàn bức tranh. Nhưng Naam lưu ý rằng lợi suất giảm dần trong machine learning không phải chuyện mới. Cortes và các cộng sự đã vẽ đường cong scaling của machine learning từ năm 1993: thêm ví dụ giảm lỗi theo hàm lũy thừa với lợi suất giảm dần. Những lợi suất giảm dần và định luật scaling khắc nghiệt này đã tồn tại lâu như chính machine learning.
Những lợi suất giảm dần này không xuất hiện lần đầu với transformer, LLM hay deep learning. Điều đó không chứng minh các mối quan hệ ngày nay sẽ tồn tại mãi mãi. Nhưng cho đến khi chúng ta thấy bằng chứng về một cách tiếp cận mới có thể scale mà không gặp những rào cản này, chúng ta nên lên kế hoạch cho khả năng lợi suất giảm dần sẽ còn ở bên chúng ta một thời gian.
Kết luận
Câu hỏi trung tâm không phải là liệu AI có thể tự động hóa toàn bộ nghiên cứu hay không, mà là liệu việc đó có đủ để vượt qua lợi suất giảm dần vốn có trong việc cải thiện AI hay không.
Việc để AI làm toàn bộ nghiên cứu không loại bỏ lợi suất giảm dần, cũng không loại bỏ vấn đề ngày càng khó tìm ra những ý tưởng hữu ích. Một AI có thể tự thiết kế, huấn luyện và kiểm thử phiên bản kế nhiệm của mình — và vẫn cần nguồn lực tăng theo cấp số nhân cho mỗi bước tiến thêm. Đóng vòng lặp lại không cho chúng ta biết liệu nó có đủ mạnh để tự duy trì hay không.
Naam dự đoán vòng phản hồi sẽ mạnh lên theo thời gian. AI tốt hơn sẽ trở nên giỏi nghiên cứu hơn. Nhưng dựa trên dữ liệu tốt nhất hiện có, việc đạt được phản hồi tự duy trì đòi hỏi một vòng lặp mạnh hơn hiện tại khoảng năm đến mười lần. Coi nghiên cứu phần mềm được tự động hóa hoàn toàn là đã đạt ngưỡng đó là một bước nhảy vọt đáng kể.