AMD Verano: CPU chuyên dụng đầu tiên cho siêu chip AI
AMD tiết lộ Verano, dòng CPU Epyc được thiết kế riêng để làm host cho GPU Instinct, hướng tới mô hình siêu chip tích hợp CPU+GPU đối đầu với Vera Rubin của Nvidia. Chip dùng bộ nhớ LPDDR5X, xGMI 112 Gbps và đóng gói BGA thay vì socket.
AMD đang chuẩn bị ra mắt Verano, một dòng vi xử lý Epyc khác biệt hoàn toàn so với những gì hãng từng làm. Thay vì phục vụ đa mục đích, Verano được thiết kế chuyên biệt để cấp dữ liệu cho thế hệ GPU server tiếp theo của AMD.
Đây là bước đi đầu tiên của AMD hướng tới một sản phẩm gần giống siêu chip Vera Rubin của Nvidia – nơi CPU và GPU được tích hợp chặt chẽ trong cùng một gói thay vì là các thành phần rời rạc.
 AMD Verano
Không cạnh tranh với Vera mà cạnh tranh với Vera+Rubin
Trong cuộc phỏng vấn với The Register tại sự kiện báo chí ở Las Vegas, ông Madhu Rangarajan, CVP mảng sản phẩm compute và enterprise AI của AMD, mô tả Verano là bước đầu tiên để xây dựng thứ gì đó giống Vera Rubin của Nvidia hơn.
"Verano thực sự được thiết kế cho một giải pháp CPU+GPU tích hợp ở quy mô rack", ông nói. "Theo góc độ đó, tôi không cho rằng CPU là đối thủ của Vera. Có thể nói giải pháp Verano + GPU là đối thủ của Vera + Rubin."
Để so sánh, Vera Rubin cùng GB200 và GB300 trước đó không phải là những nền tảng server thông thường. Chúng giống như một chiếc máy tính đơn bo mạch khổng lồ, kết hợp CPU và GPU thành một khối tích hợp chặt chẽ. Mỗi siêu chip của Nvidia ghép một CPU Vera 88 lõi cùng 1,5 TB bộ nhớ LPDDR5X với hai GPU Rubin thông qua liên kết NVLink-C2C tốc độ cao.
Theo Rangarajan, Verano sẽ là CPU host cho một lớp sản phẩm tương tự sử dụng GPU AMD, và cũng giống siêu chip Nvidia, chip này dùng bộ nhớ LPDDR5X thay vì RDIMM truyền thống.
Tuy nhiên, khác với Vera – vốn còn được triển khai như CPU độc lập trong server lưu trữ và môi trường sandbox cho agent – Verano chỉ có một mục đích duy nhất: giữ cho GPU luôn được cung cấp dữ liệu đầy đủ. Giới phân tích dự đoán đó sẽ là các GPU MI500X.
Bên trong Verano
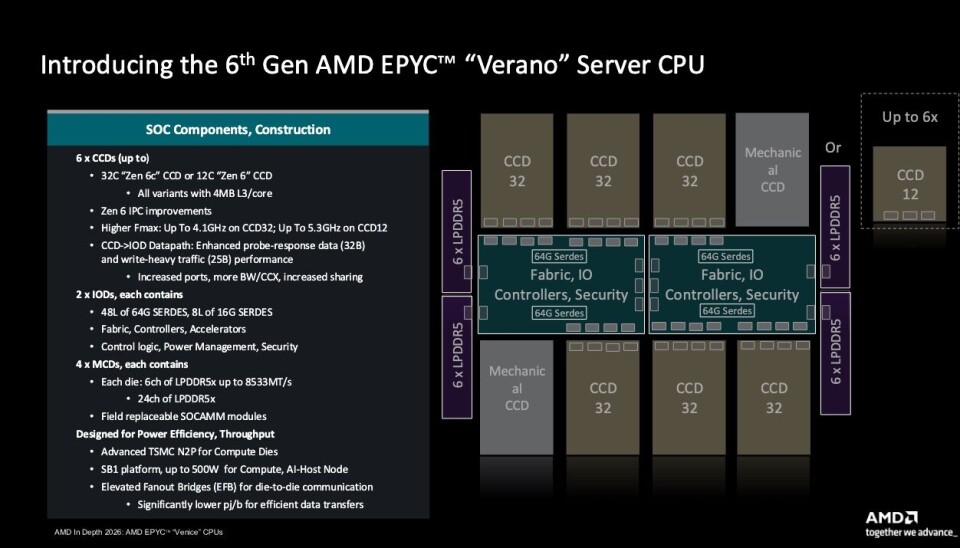
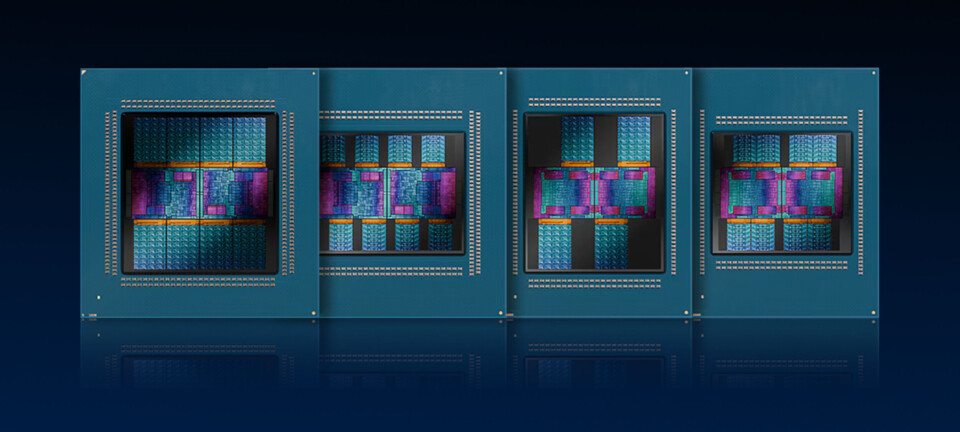
Nếu "bóc" nắp tản nhiệt của Verano, con chip trông khá giống các mẫu Epyc Venice được giới thiệu hồi tháng 9. Nó có thể dùng sáu die phức hợp lõi (CCD) với tổng cộng 72 lõi tần số cao chạy tới 5,3 GHz, hoặc 192 lõi tối ưu mật độ chạy tới 4,1 GHz – tùy theo khách hàng ưu tiên mật độ lõi hay tốc độ xung nhịp.
Nhưng điểm tương đồng về ngoại hình chỉ dừng ở đó. Phần lớn con chip đã được làm lại để loại bỏ các điểm nghẽn luồng dữ liệu giữa CPU và GPU. Chip sở hữu một cặp die I/O tùy chỉnh hoàn toàn, qua đó gắn bốn bộ điều khiển bộ nhớ LPDDR5X.
Các bộ điều khiển này hiện đang được kiểm định với 24 kênh bộ nhớ ở tốc độ lên tới 8.533 MT/s. Theo AMD, con số này có thể tăng nhẹ khi chip bắt đầu xuất xưởng vào năm tới, nhưng hiện tại đó là mức được xác nhận.
 Verano interconnect
Điều đó đồng nghĩa nền tảng này không chỉ có ít lõi hơn mà còn dùng bộ nhớ chậm hơn. Băng thông bộ nhớ lý thuyết đỉnh chỉ đạt khoảng 800 GB/s – bằng một nửa so với các mẫu Venice cấu hình cao nhất của AMD và khoảng 66% so với Vera của Nvidia.
Bù lại, LPDDR5X giúp AMD giảm 30-40% mức tiêu thụ điện năng so với RDIMM, đồng thời cho diện tích nhỏ gọn hơn, thuận lợi cho làm mát bằng chất lỏng. Nhưng nó cũng có nhược điểm: ở phiên bản đầu tiên, Verano sẽ không dùng socket mà dùng đóng gói BGA (ball-grid array) hàn trực tiếp lên bo mạch, khiến việc bảo trì khó khăn hơn.
"LPDDR thường khá khó tính về tốc độ. Mỗi lần đi qua một đầu nối, bạn thường mất một hai chân tín hiệu, và bạn đã có sẵn một đầu nối với chính module SoCam. Vì vậy để giảm thiểu mất tốc độ, chúng tôi chọn BGA cho CPU", Rangarajan giải thích.
Khác với nhiều laptop, bản thân module bộ nhớ không bị hàn chết mà dùng SOCAMM2, loại module tương tự có trong siêu chip Vera-Rubin và Vera-Vera của Nvidia.
Liên kết CPU-GPU "béo" hơn
Trước đây, giao tiếp CPU-GPU của AMD diễn ra qua PCIe. Cách này hoạt động được nhưng thường phải cần switch PCIe để theo kịp số lượng GPU, NIC và lưu trữ trên bo mạch. Siêu chip của Nvidia đã loại bỏ điều này, thay PCIe bằng NVLink-C2C, cung cấp 900 GB/s băng thông hai chiều cho mỗi GPU trong hệ thống.
Venice và Verano làm điều tương tự. Khác với các bộ tăng tốc Instinct trước đây, thế hệ GPU mới của AMD không giới hạn ở PCIe cho giao tiếp CPU-GPU. Bắt đầu từ Venice, AMD chuyển sang dùng xGMI.
GMI (Global Memory Interconnect) là cách AMD truyền dữ liệu giữa các chiplet trên CPU, GPU và APU trong nhiều thế hệ. xGMI mở rộng cơ chế này ra giao tiếp GPU-GPU và CPU-GPU.
Với Venice, băng thông mỗi làn xGMI đạt tối đa 64 Gbps – tương đương PCIe 6.0. Verano đẩy lên tầm cao mới: nhờ tách rời các bộ điều khiển bộ nhớ và tận dụng phần diện tích đó cho các SerDes (serializer/deserializer) lớn hơn, liên kết xGMI của Verano đạt tới 112 Gbps mỗi làn – gần mức của PCIe 7.0, nhiều năm trước khi chuẩn này xuất hiện trên CPU thương mại.
AMD chưa công bố tỷ lệ CPU/GPU mục tiêu của Verano nên khó so sánh trực tiếp với Nvidia. Nếu dùng tỷ lệ 2:1 như Vera Rubin, Verano sẽ đạt băng thông chip-tới-chip tương đương; còn với tỷ lệ 1:4 như trong rack Helios của AMD, băng thông sẽ chỉ khoảng một nửa, tức 448 GB/s. AMD cũng chưa rõ có tăng số làn xGMI trên mỗi die I/O hay không, nên băng thông mỗi GPU có thể còn cao hơn. Thông tin chi tiết dự kiến sẽ có gần thời điểm MI500X ra mắt vào năm sau.
Một phần của hệ sinh thái rộng hơn
AMD không kỳ vọng Verano sẽ thay thế Venice trong mọi rack AI: chip này được thiết kế riêng để dùng với bộ tăng tốc Instinct. Hơn nữa, AMD không chờ Verano mới triển khai hệ thống quy mô rack Helios. Như đã công bố tại sự kiện Advancing AI đầu năm nay, các hệ thống đó sẽ có 18 CPU Venice 96 lõi ghép với 72 GPU Instinct MI455X.
Trong tương lai, AMD dự kiến Venice vẫn là CPU host phổ biến cho các node đầu não AI, không chỉ cho GPU của chính hãng mà còn cho ngày càng nhiều bộ tăng tốc tự phát triển của các "nhà làm mô hình lớn".
Góc nhìn
Verano cho thấy một xu hướng rõ ràng: CPU trong hạ tầng AI đang tách thành hai hướng. Một loại đa dụng, linh hoạt cho đủ loại tác vụ; loại còn lại chuyên biệt, tối ưu cho việc "nuôi" GPU. Với các kỹ sư và doanh nghiệp Việt Nam đang xây dựng hoặc thuê hạ tầng GPU để huấn luyện và chạy mô hình, điều này có nghĩa là các quyết định mua sắm cần tính đến kiến trúc tổng thể của rack chứ không chỉ cấu hình riêng lẻ từng thành phần.
Việc chuyển sang đóng gói BGA cũng là điểm cần lưu ý: khó nâng cấp, khó thay thế hơn so với socket truyền thống. Doanh nghiệp nên xem đây là phần cứng gắn chặt với vòng đời của cả hệ thống chứ không phải linh kiện có thể hoán đổi linh hoạt như CPU server trước đây.
Nguồn: theregister.com · Quy trình biên tập