
Apple dạy AI định tuyến truy vấn RAG nhanh gấp nhiều lần
Nhóm nghiên cứu Apple công bố phương pháp amortized MIPS tại ICML 2026, dùng mạng nơ-ron nhỏ học cách định tuyến truy vấn tới kết quả khớp nhất trong cơ sở dữ liệu lớn. Cách này đạt độ chính xác cao hơn định tuyến theo tâm cụm với độ trễ thấp hơn, hứa hẹn tăng tốc đáng kể các hệ thống RAG và tìm kiếm vector trong môi trường sản xuất.
Trong RAG (retrieval-augmented generation — kỹ thuật tăng cường sinh văn bản bằng truy xuất tài liệu), tìm kiếm và hệ gợi ý, bước then chốt là maximum inner product search (MIPS): đưa vào một vector truy vấn và tìm trong hàng triệu vector khóa ứng viên vector khớp nhất. Nhóm nghiên cứu của Apple vừa công bố tại hội nghị ICML 2026 một cách tiếp cận mới mang tên Amortizing Maximum Inner Product Search with Learned Support Functions, dùng mạng nơ-ron nhỏ huấn luyện trước để định tuyến truy vấn nhanh và chính xác hơn.
Vấn đề nằm ở chi phí. Khi số khóa tăng lên hàng triệu và số chiều vector lên tới hàng nghìn, việc so sánh truy vấn với toàn bộ khóa trở nên quá đắt. Các phương pháp xấp xỉ phổ biến hiện nay dựa vào phân cụm và lượng tử hóa, nhưng chúng chỉ nhìn vào cấu trúc của tập khóa mà bỏ qua đặc điểm của tập truy vấn. Trong khi đó, ở RAG, truy vấn thường là câu hỏi ngắn do người dùng gõ, còn khóa là những đoạn văn bản dài, được biên soạn kỹ — hai bên khác nhau rõ rệt.
Học cách định tuyến thay vì đo khoảng cách tới tâm cụm
Cách làm quen thuộc là chia tập khóa thành k cụm, mỗi cụm có một tâm (centroid). Khi có truy vấn mới, hệ thống so sánh với k tâm rồi chỉ tìm kỹ trong cụm gần nhất. Nếu số khóa là n và các cụm phân bố đều, thực chất chỉ cần so sánh khoảng n/k khóa — nhanh hơn gấp k lần. Nhưng định tuyến theo tâm cụm có thể sai: một khóa nằm xa tâm cụm mình lại rất gần truy vấn, và khi đó hệ thống sẽ bỏ sót kết quả đúng.
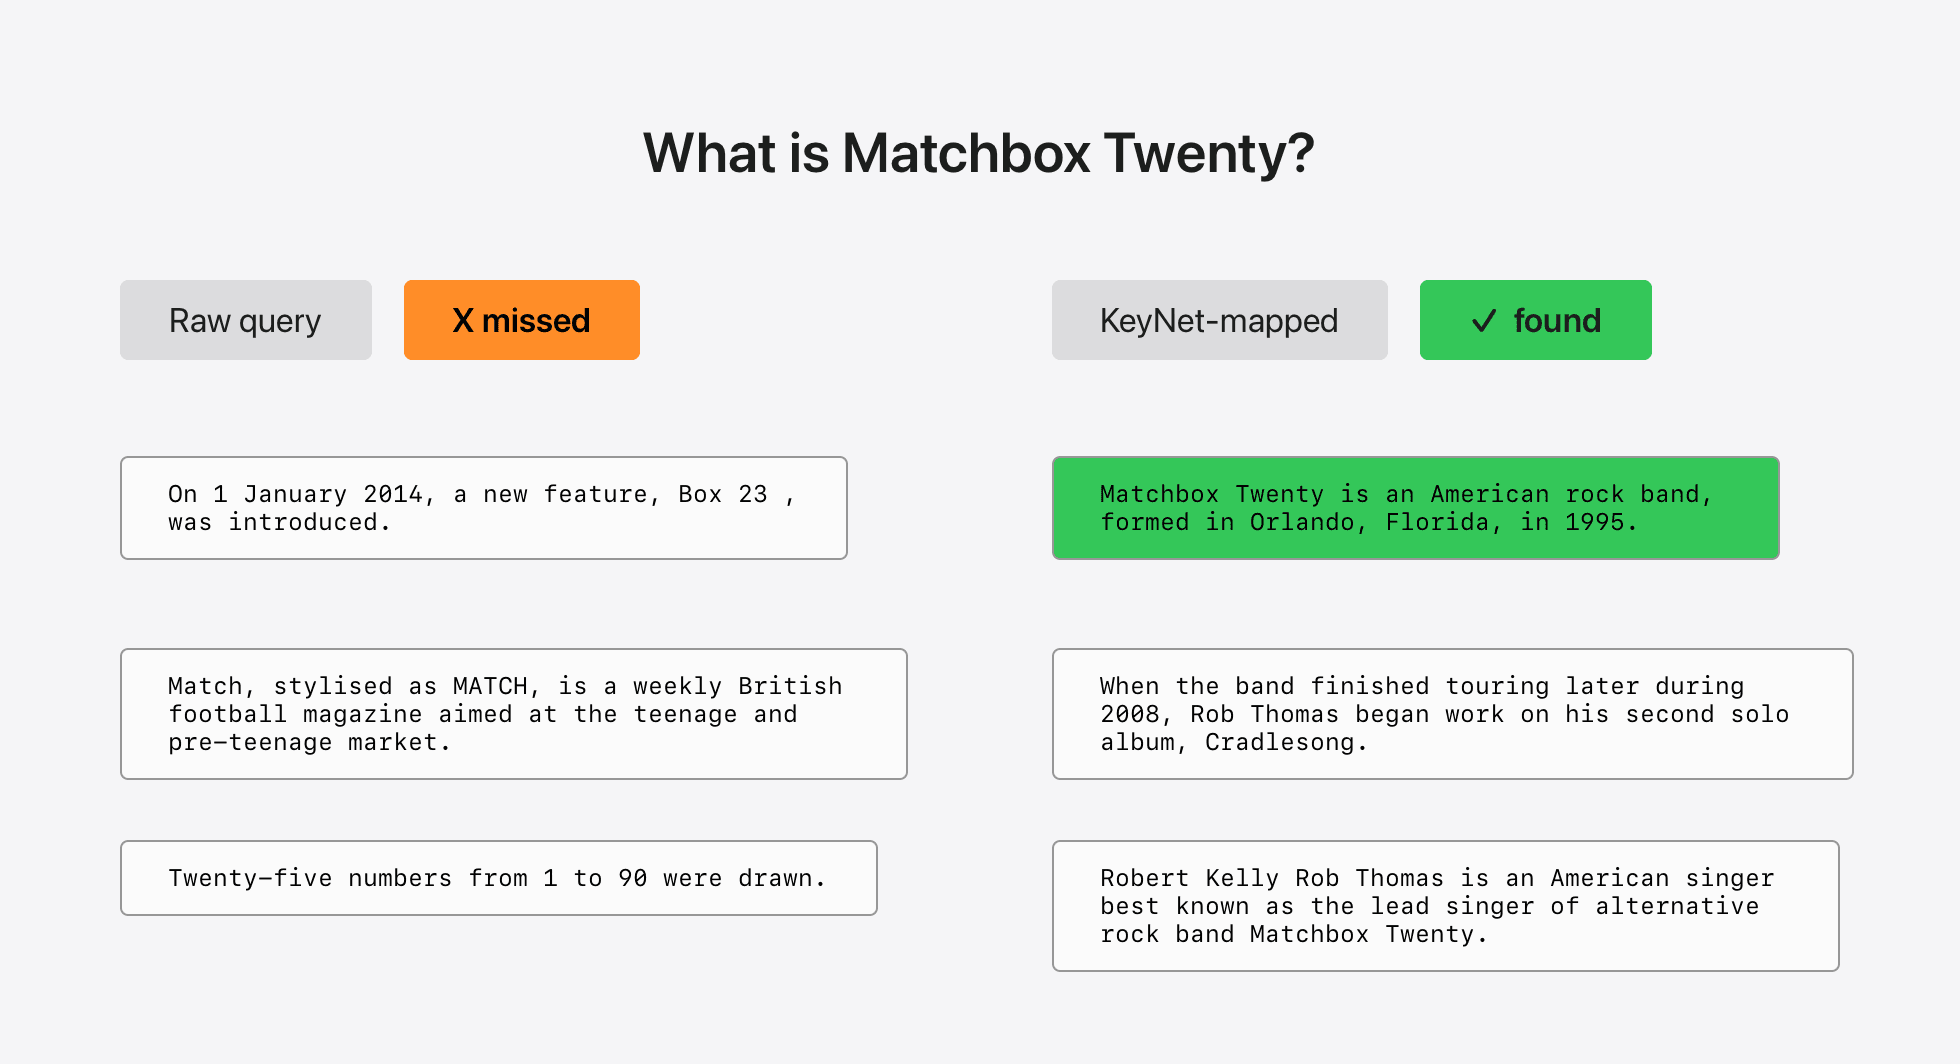 Minh họa định tuyến theo tâm cụm bỏ sót điểm khớp nhất
Nhóm Apple nhận ra MIPS có một cấu trúc toán học ít được chú ý: hàm ánh xạ truy vấn tới giá trị inner product lớn nhất với tập khóa chính là hàm nâng đỡ (support function) của tập đó, một đối tượng quen thuộc trong giải tích lồi. Hàm này có hai tính chất quan trọng: nó lồi, nên có thể xấp xỉ bằng input convex neural networks (ICNN) — lớp mạng nơ-ron chuyên cho hàm lồi; và đạo hàm của nó tại một truy vấn chính là khóa khớp nhất.
Từ đó, nhóm đề xuất học một mạng nơ-ron mô phỏng hàm nâng đỡ thật, bằng kỹ thuật hồi quy cổ điển: sinh nhiều mẫu truy vấn, tính trước kết quả MIPS đúng bằng tìm kiếm vét cạn, rồi huấn luyện mạng tái tạo lại kết quả đó. Chi phí bỏ ra một lần khi huấn luyện được "khấu hao" (amortization) qua vô số lần suy luận về sau.
SupportNet và KeyNet: hai cách học
Nhóm nghiên cứu tách thành hai mạng chuyên biệt:
- SupportNet học trực tiếp hàm nâng đỡ bằng ICNN, phù hợp để tính một hàm nâng đỡ cho mỗi cụm và cải thiện chất lượng định tuyến.
- KeyNet học thẳng ra vector khóa khớp nhất từ truy vấn, có thêm hàm mất mát nhất quán dựa trên định lý Euler cho hàm thuần nhất để dự đoán vẫn bám sát cấu trúc hình học của hàm nâng đỡ.
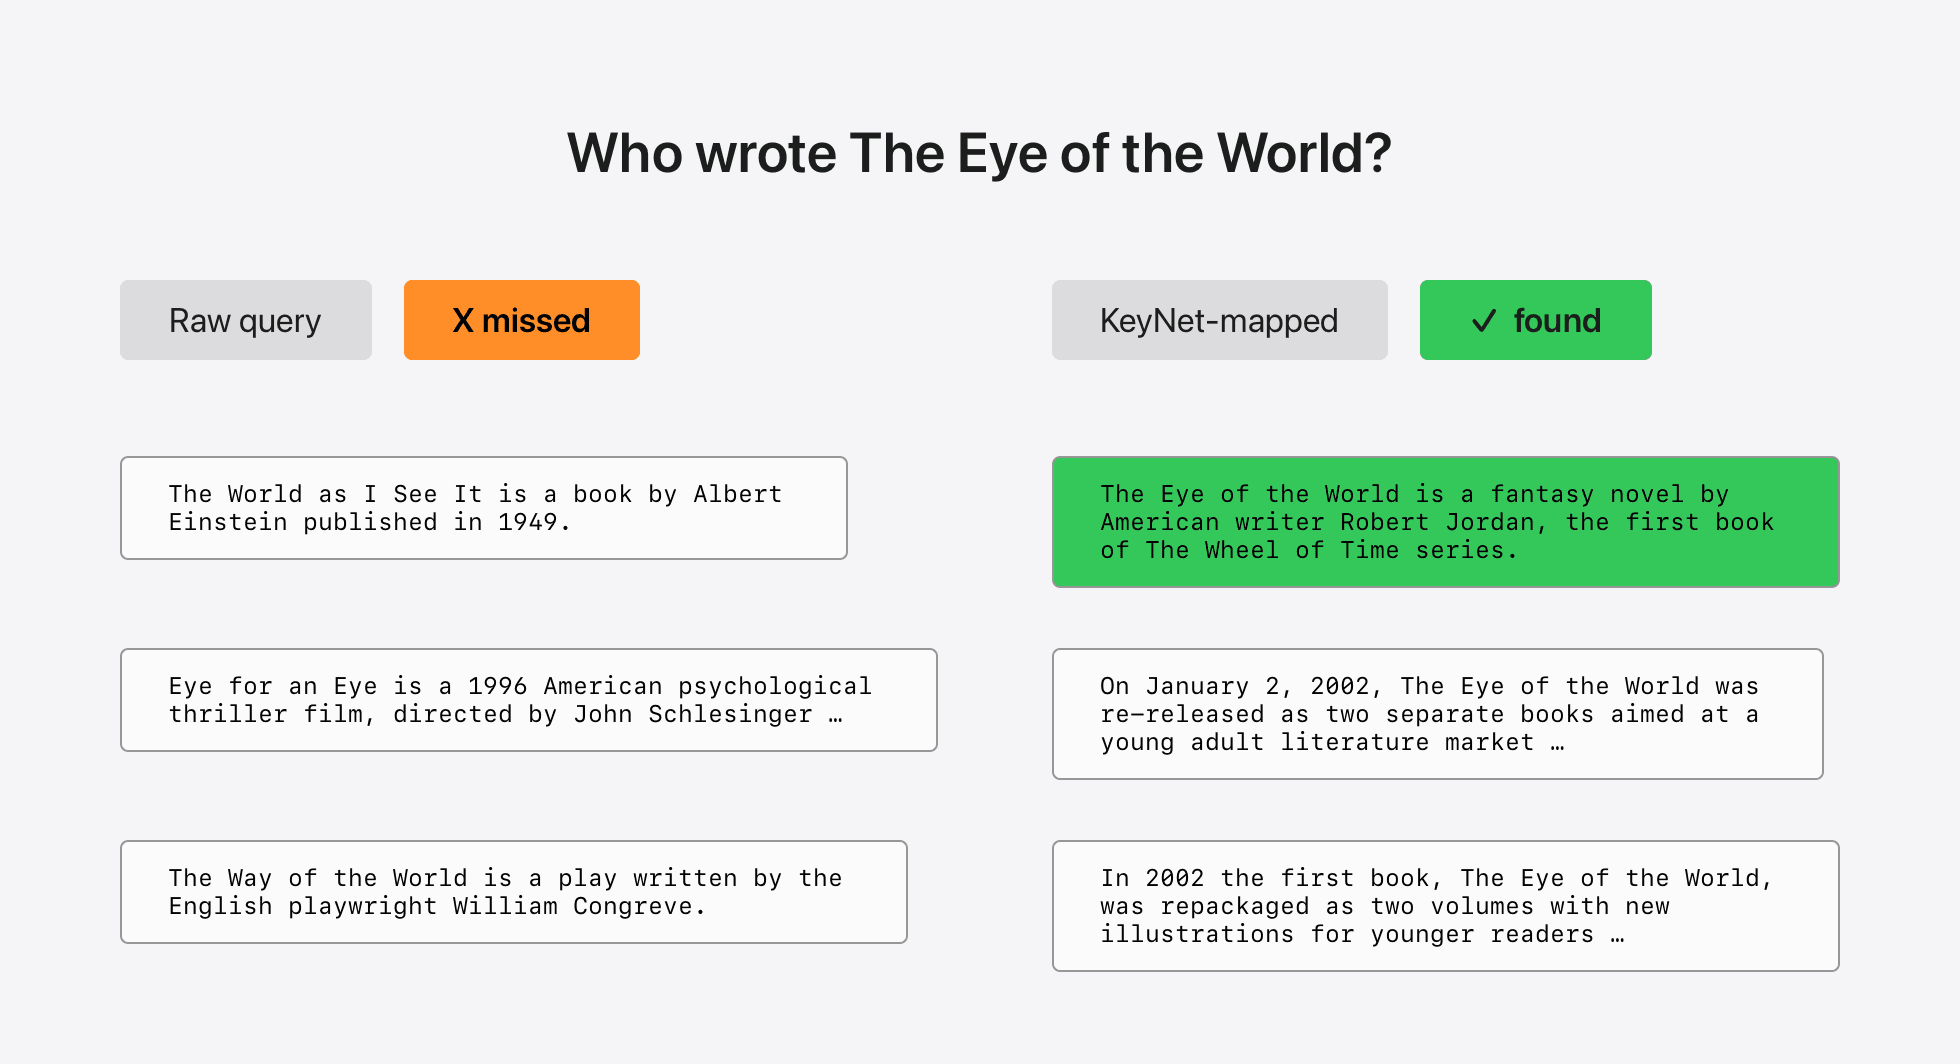 SupportNet xấp xỉ hàm nâng đỡ của từng cụm để định tuyến truy vấn
Với SupportNet, thay vì so truy vấn với tâm cụm, hệ thống trả lời câu hỏi hữu ích hơn: "Khóa tốt nhất trong cụm này khớp với truy vấn đến mức nào?". Nhóm huấn luyện các SupportNet kích thước tăng dần (XS, S, M, L tương ứng 1%, 5%, 10% và 20% kích thước cơ sở dữ liệu) trên bộ dữ liệu Natural Questions chia thành 128 cụm, với khoảng 2,6 triệu đoạn văn bản.
Kết quả: với cùng độ trễ, SupportNet đạt độ chính xác định tuyến cao hơn định tuyến theo tâm cụm. Mô hình nhỏ đạt 95% recall định tuyến nhanh hơn khoảng 1,9 lần (1,74 ms so với 3,36 ms), còn mô hình lớn đạt 97% trong 1,74 ms. Xét riêng chất lượng, khi chỉ quét 5% cơ sở dữ liệu, các bộ định tuyến học được tìm đúng phân vùng khoảng 90–93% số truy vấn (cao nhất 92,6% ở mô hình M), so với 87,5% của tâm cụm.
Ghép thẳng vào chỉ mục có sẵn
Với KeyNet, không cần thay đổi hệ thống chỉ mục IVF (inverted file index) hiện hữu: mạng chỉ đóng vai trò "viết lại truy vấn", dự đoán vị trí khóa khớp nhất trong không gian embedding rồi để IVF tìm từ đó. Kết quả thử nghiệm trên chỉ mục FAISS IVF với cùng bộ Natural Questions cho thấy để đạt 99% recall, mô hình lớn cần ít thời gian hơn tới khoảng 8 lần (0,23 ms so với 1,8 ms khi dùng truy vấn gốc), và cần ít khóa hơn tới khoảng 11 lần.
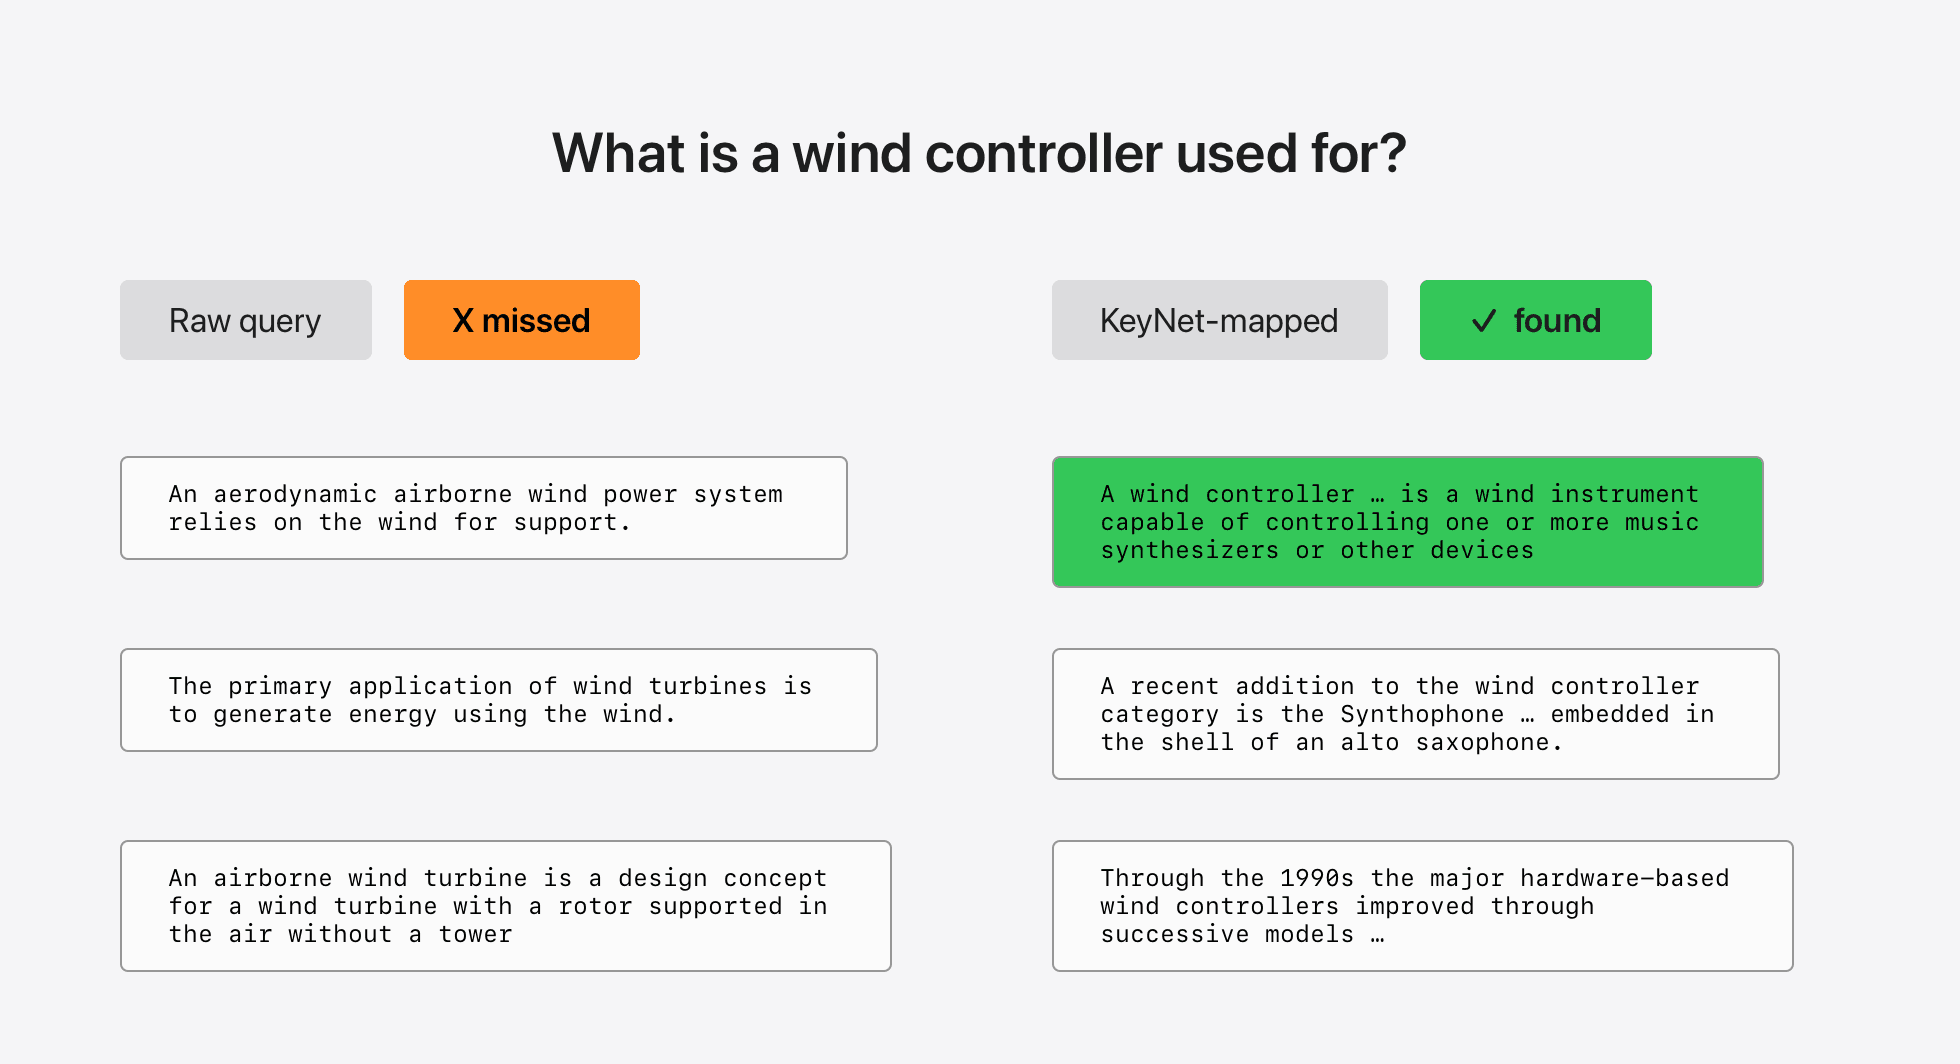 KeyNet viết lại truy vấn trước khi đưa vào chỉ mục IVF
Cụ thể, khi chỉ quét 0,001% cơ sở dữ liệu, truy vấn đã qua KeyNet tìm đúng khóa 89–97% số lần (cao nhất 96,7% ở mô hình L), so với 86% của truy vấn gốc. Nhóm nghiên cứu cho biết xu hướng này nhất quán trên nhiều bộ dữ liệu khác ngoài Natural Questions.
Chọn mạng nào?
Theo nhóm tác giả, lựa chọn mang tính thực dụng: dùng KeyNet khi tốc độ suy luận là điểm nghẽn và chỉ cần xấp xỉ khóa tốt nhất; dùng SupportNet khi cần điểm số đã hiệu chỉnh (để xếp hạng lại, đặt ngưỡng hay dùng cho bước sau) hoặc khi tài nguyên tính toán eo hẹp ở kích thước mô hình nhỏ. Với hệ thống MIPS quy mô rất lớn, có thể cần cả hai: một SupportNet định tuyến trên toàn bộ cụm, rồi mỗi cụm một KeyNet riêng.
Cả hai mạng đều huấn luyện theo cùng cách, tích hợp được với hạ tầng tìm kiếm xấp xỉ hiện có và chịu được mức dịch chuyển phân phối truy vấn nhẹ.
Góc nhìn
Với các đội kỹ thuật ở Việt Nam đang xây dựng chatbot RAG hay hệ tìm kiếm ngữ nghĩa trên kho tài liệu nội bộ, điểm đáng chú ý là chi phí có thể giảm mà không phải thay chỉ mục vector hiện tại. Cách tiếp cận của Apple không đòi hỏi hạ tầng mới, chỉ cần huấn luyện thêm một mạng nhỏ trên chính phân phối truy vấn thực tế của hệ thống — vốn là dữ liệu các đội đã có sẵn trong log.
Tuy nhiên, lợi ích này gắn chặt với giả định phân phối truy vấn ổn định. Khi mảng nội dung hoặc hành vi người dùng thay đổi mạnh, mạng cần được huấn luyện lại, và đây là khoản chi phí vận hành cần tính trước. Với các hệ thống vừa và nhỏ, việc cân nhắc giữa một lần huấn luyện và độ trễ tiết kiệm được mỗi truy vấn sẽ là bài toán cần đo đạc thực tế trước khi áp dụng.
Nguồn: machinelearning.apple.com (bài gốc ngày 11 tháng 11, 2026) · Quy trình biên tập
Bài viết liên quan
Phần mềm
RAG bị "mù" thời gian: Cách tôi xây dựng Temporal Layer để khắc phục trong môi trường sản xuất
09 tháng 5, 2026
Công nghệ
Agentic RAG có thực sự tìm được bằng chứng tốt hơn? Thử nghiệm trên 298 câu hỏi
22 tháng 10, 2026

Công nghệ
Giải mã ngược Neural Engine của Apple: Từ kỷ nguyên CNN đến kỷ nguyên Transformer
12 tháng 9, 2026