
Chạy GLM-5.3 trên hai trạm DGX, đạt 607,8 tok/s
NVIDIA hướng dẫn cách phục vụ mô hình GLM-5.3 753 tỷ tham số trên hai trạm DGX Station nối bằng RDMA, dùng vLLM với tensor parallelism. Hệ thống đạt đỉnh 607,8 token/giây ở mức 16 yêu cầu đồng thời, mở ra khả năng tự vận hành mô hình quy mô lớn ngay tại chỗ.
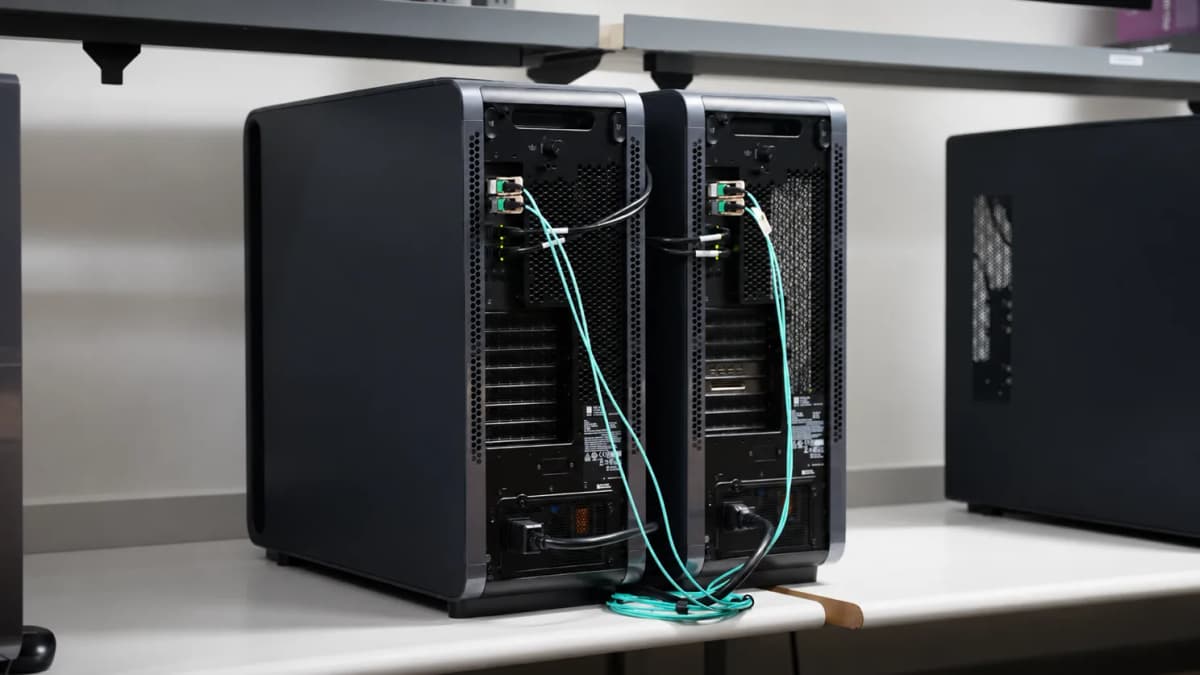
Chạy GLM-5.3 trên hai trạm NVIDIA DGX với vLLM
Các mô hình ngôn ngữ quy mô lớn ngày càng vượt quá dung lượng bộ nhớ của một GPU đơn lẻ. NVIDIA vừa công bố hướng dẫn chi tiết cách phục vụ GLM-5.3 NVFP4 — phiên bản lượng tử hóa mô hình mixture-of-experts (MoE, hỗn hợp chuyên gia) của Z.ai — trên hai trạm DGX Station, đạt đỉnh 607,8 token/giây ở mức 16 yêu cầu đồng thời.
Ý tưởng cốt lõi: hai trạm được nối với nhau qua ConnectX-8 RDMA (truy cập bộ nhớ trực tiếp từ xa, giúp GPU trao đổi dữ liệu mà không cần qua CPU), rồi phục vụ một mô hình duy nhất qua một endpoint duy nhất. Kỹ thuật tensor parallelism (TP=2) chia trọng số và phép tính của mô hình ra hai GPU GB300, mỗi trạm giữ một phần.
Vì sao cần hai trạm?
Mô hình GLM-5.3 có 753 tỷ tham số, nhưng chỉ kích hoạt khoảng 40 tỷ tham số mỗi token nhờ cơ chế kích hoạt thưa (sparse activation). Tuy vậy, toàn bộ trọng số vẫn phải nằm sẵn trong bộ nhớ GPU, vì mỗi token có thể được định tuyến tới các chuyên gia khác nhau.
Checkpoint nặng khoảng 464 GB, vượt xa mức 252 GB HBM3e của một GPU GB300. Giải pháp là dùng hai trạm, tắt tính năng đẩy trọng số sang CPU (CPU weight offload), để giữ toàn bộ trọng số trong bộ nhớ GPU.
Yêu cầu chuẩn bị
- Hai trạm GB300 DGX Station chạy Linux, đã được nối và kiểm tra bằng playbook "Connect Two DGX Stations", bao gồm bài kiểm tra RDMA GPU-memory trên cả hai tuyến mạng.
- Quyền SSH và sudo trên cả hai trạm với cùng tên người dùng. Docker và NVIDIA Container Toolkit đã có sẵn trong bộ phần mềm DGX Station.
- Ít nhất 464 GB dung lượng đĩa trống trên mỗi trạm cho bản sao checkpoint, cộng thêm chỗ cho container vLLM và tệp tạm.
- Chấp nhận NVIDIA Open Model Agreement và điều khoản giấy phép gốc của GLM-5.3.
- Tài khoản Hugging Face cùng token đọc, có quyền truy cập dataset cais/hle (dataset được kiểm soát quyền truy cập).
Các bước triển khai chính
Bước 1 — Chuẩn bị hai trạm. Một trạm A giữ vai trò rank 0 và chạy API, trạm B là rank 1 chạy worker không có API server. Người dùng cần xác định tuyến RDMA (ví dụ cx8r1), thiết bị RDMA tương ứng (ví dụ mlx5_1) và địa chỉ IPv4 của từng trạm, rồi lưu vào tệp ~/glm53.env. Các lệnh kiểm tra ethtool, ping khung jumbo và nvidia-smi giúp phát hiện lỗi cáp hoặc địa chỉ trước khi chúng biểu hiện thành lỗi timeout NCCL.
Bước 2 — Tải và sao chép mô hình. Cả hai trạm kéo image container vllm/vllm-openai:v0.30.0-aarch64 (đã ghim theo mã băm) để đảm bảo chạy cùng một phần mềm. Trạm A tải checkpoint về bằng hf download, sau đó dùng rsync đẩy sang trạm B. Mỗi ổ đĩa giữ bản checkpoint đầy đủ, vLLM sẽ tự chia trọng số lên hai GPU khi nạp. Một đoạn script kiểm tra tên và kích thước tệp ở hai máy khớp nhau và config.json đúng kiến trúc GlmMoeDsaForCausalLM.
Bước 3 — Khởi chạy dịch vụ phân tán. Cùng một script launch-glm53.sh chạy trên cả hai trạm. Hai tham số quan trọng nhất:
--max-model-len 98304: giới hạn ngữ cảnh tính bằng token, gồm cả đầu vào lẫn đầu ra.--gpu-memory-utilization 0.93: cấp cho vLLM 93% bộ nhớ GPU.
Script bật multi-token prediction (MTP) — một dạng giải mã suy đoán (speculative decoding): lớp MTP nháp bốn token mỗi bước, vLLM kiểm chứng bằng mô hình đầy đủ trước khi chấp nhận, nên mỗi bước có thể sinh nhiều token. Bộ nhớ đệm KV được lưu ở FP8, giảm một nửa dung lượng so với lưu 16-bit, nhờ đó chứa được nhiều token hơn. Prefix caching cũng được bật để tránh xử lý lại phần đầu prompt đã thấy.
Lưu ý bảo mật:
--host 0.0.0.0kết hợp--network hostsẽ phơi bày API không xác thực trên mọi giao diện mạng của trạm A. Cần chặn cổng bằng firewall và thêm xác thực cùng TLS trước khi mở rộng truy cập.
Script còn ghim NCCL 2.30.7 từ trong image, vì các phiên bản cũ hơn có thể bị deadlock khi phát lại CUDA graph liên nút qua RoCE.
Bước 4 — Kiểm tra phục vụ. Sau khi log hiện Application startup complete, endpoint /health trả về HEALTH_OK. Một bước kiểm tra đọc log NCCL để xác nhận GPU giao tiếp qua RDMA trực tiếp (GDRDMA) chứ không rơi về socket TCP. nvidia-smi cho thấy trạm A chạy tiến trình VLLM::Worker_TP0 và trạm B chạy VLLM::Worker_TP1, mỗi GPU giữ khoảng 218 GiB trọng số — tức khoảng một nửa checkpoint.
Bước 5 — Đo tải đồng thời. Công cụ AIPerf của NVIDIA được cài trong môi trường ảo riêng để không làm xáo trộn phụ thuộc của vLLM. Bài đo dùng 80 hội thoại lập trình từ SPEED-Bench — bộ prompt thật dùng để đánh giá giải mã suy đoán — nhằm đo MTP trên văn bản thực tế.
Kết quả đo đạc
| Mức đồng thời | Thông lượng tổng (tok/s) | Độ trễ trung bình (s) | TTFT trung bình (ms) | Độ trễ liên token (ms/token) |
|---|---|---|---|---|
| 1 | 107,4 | 49,8 | 4479,75 | 8,78 |
| 8 | 386,0 | 114,17 | 433,79 | 19,01 |
| 16 | 607,8 | 136,46 | 482,90 | 23,77 |
| 32 | 385,0 | 453,54 | 899,36 | 77,90 |
Thông lượng tổng đạt đỉnh 607,8 tok/s ở mức C16, rồi giảm còn 385,0 tok/s ở C32 — nơi độ trễ trung bình mỗi yêu cầu lên tới 453,5 giây. Thông lượng bình quân mỗi người dùng cũng giảm từ 115,3 tok/s ở C1 xuống 13,0 tok/s ở C32. Số liệu này đo với prefix caching bật, bốn token nháp MTP mỗi bước và KV cache FP8.
Sau khi đo xong, người dùng dừng container trên A rồi đến B. Checkpoint, container và kết quả vẫn lưu trên đĩa; để khởi động lại chỉ cần docker start trên B trước rồi đến A.
Góc nhìn
Kết quả này cho thấy việc tự vận hành một mô hình cỡ 753 tỷ tham số không còn là đặc quyền của các trung tâm dữ liệu lớn với cụm GPU khổng lồ. Với hai trạm DGX và một đường RDMA, đội kỹ thuật có thể giữ toàn bộ trọng số trong GPU, phục vụ qua API tương thích OpenAI — nghĩa là tích hợp vào ứng dụng hiện có gần như không phải sửa code.
Điểm đáng chú ý cho các kỹ sư vận hành là đường cong thông lượng: đỉnh xuất hiện ở mức đồng thời vừa phải và sụp rõ rệt khi tăng quá tay. Việc dò mức đồng thời phù hợp với workload thực tế bằng AIPerf nên là bước bắt buộc trước khi đưa vào dùng, thay vì giả định đẩy thêm người dùng là luôn có lợi. Bên cạnh đó, các yêu cầu về chặn cổng, xác thực và TLS trong hướng dẫn nhắc nhở rằng tự lưu trữ mô hình cũng kéo theo trách nhiệm bảo mật mà endpoint thuê ngoài thường gánh thay.
Nguồn: developer.nvidia.com · Quy trình biên tập
Bài viết liên quan
Phần cứng
Grace Blackwell cần bộ lập lịch mới: tăng 27% GPU khả dụng trên cùng số rack
29 tháng 10, 2026
Qwen3.8 27B chạy 50 tok/s trên GPU 24 GB: Bí quyết tối ưu lượng tử hóa NVFP4 và MTP
17 tháng 8, 2026
Phần cứng
Prefill là bài toán tính toán, Decode là bài toán bộ nhớ: Tại sao GPU không nên làm cả hai?
15 tháng 4, 2026