Chi phí ẩn của định tuyến LLM: Vì sao chuyển model giữa chừng lại tốn hơn bạn tưởng
Định tuyến yêu cầu sang model rẻ hơn tưởng như là cách tiết kiệm hiển nhiên, nhưng mỗi lần chuyển model giữa một phiên agent dài sẽ xóa sạch bộ nhớ đệm KV và buộc hệ thống xử lý lại toàn bộ ngữ cảnh với giá đầy đủ. Thí nghiệm trên phiên 20 lượt cho thấy định tuyến theo từng request chỉ đạt 13% mức tiết kiệm mà bảng giá hứa hẹn, trong khi định tuyến theo ranh giới giai đoạn đạt tới 29%.
Chi phí ẩn của định tuyến LLM: Vì sao chuyển model giữa chừng lại tốn hơn bạn tưởng
Khi hạn mức của một model sắp cạn hoặc muốn tiết kiệm ngân sách, nhiều đội ngũ chọn cách đặt một bộ định tuyến (router) ở cổng vào để đẩy các yêu cầu "dễ" sang model rẻ hơn. Nghe rất hợp lý — cho đến khi bạn hỏi: bản thân việc chuyển model tốn bao nhiêu? Không phải chênh lệch giá mỗi token, mà là cái giá của cú chuyển.
Bài viết dưới đây tổng hợp một nghiên cứu thực nghiệm về câu hỏi đó, kèm số liệu sản xuất thực tế từ GitHub Copilot và các kết quả đo trực tiếp trên vLLM.
Vấn đề: bộ nhớ đệm KV là thứ giúp phiên agent dài có giá phải chăng
Một mô hình ngôn ngữ lớn không tự ghi nhớ gì giữa các lần gọi. Lớp harness — phần mềm bao quanh model, quản lý vòng lặp agent, dựng prompt, gọi công cụ và lưu trạng thái — phải gửi lại toàn bộ lịch sử hội thoại ở mỗi lượt.
Hệ quả là một phiên agent 20 lượt không phải 20 prompt độc lập, mà là cùng một prompt ngày càng dài được gửi đi lặp lại. Trong một phiên được đo, đến lượt 20 prompt chỉ có 10.135 token, nhưng tổng cộng server đã xử lý 111.871 token — tức là cùng một ngữ cảnh bị xử lý khoảng 11 lần.
Thứ khiến điều này khả thi về mặt chi phí là prefix caching: nếu request mới bắt đầu bằng đúng chuỗi token cũ, server tái sử dụng trạng thái KV đã tính thay vì tính lại. Trên Claude API, đọc một token từ cache chỉ tốn 0,1× giá thường, còn ghi vào cache tốn 1,25×.
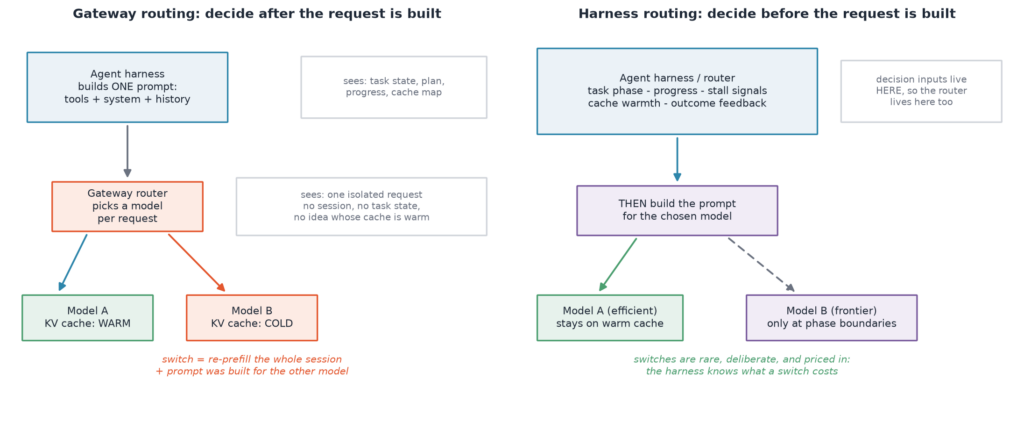 Kiến trúc: quyết định định tuyến nằm ở cổng vào hay trong harness
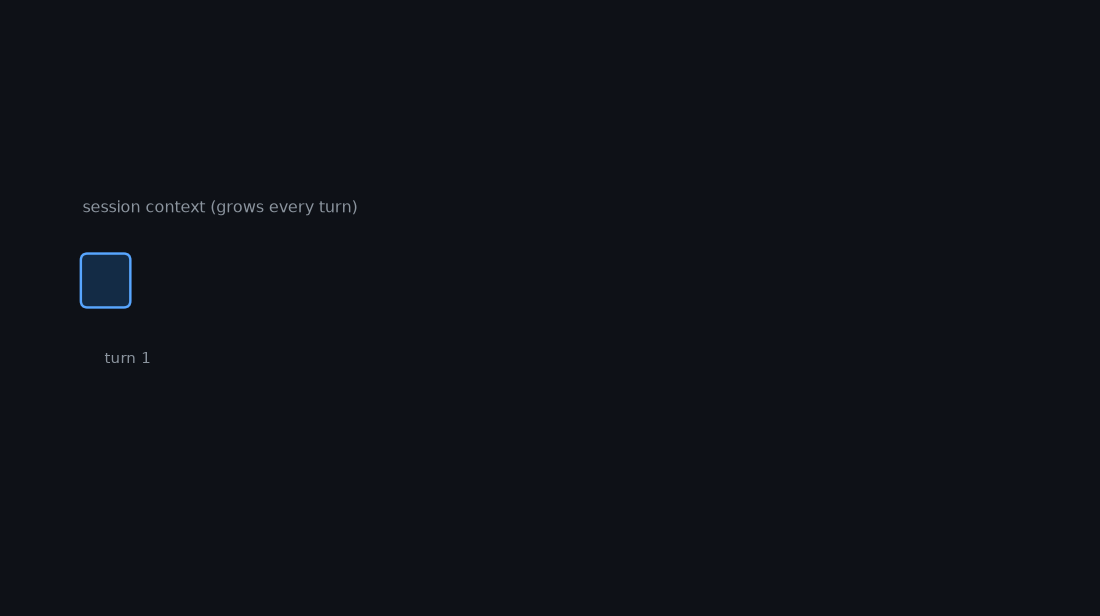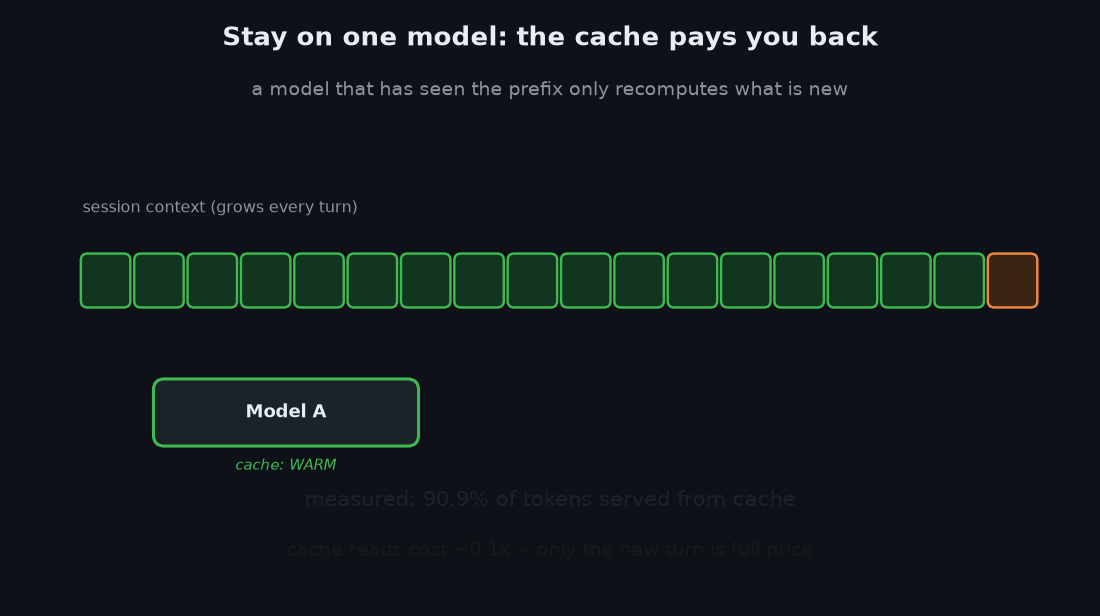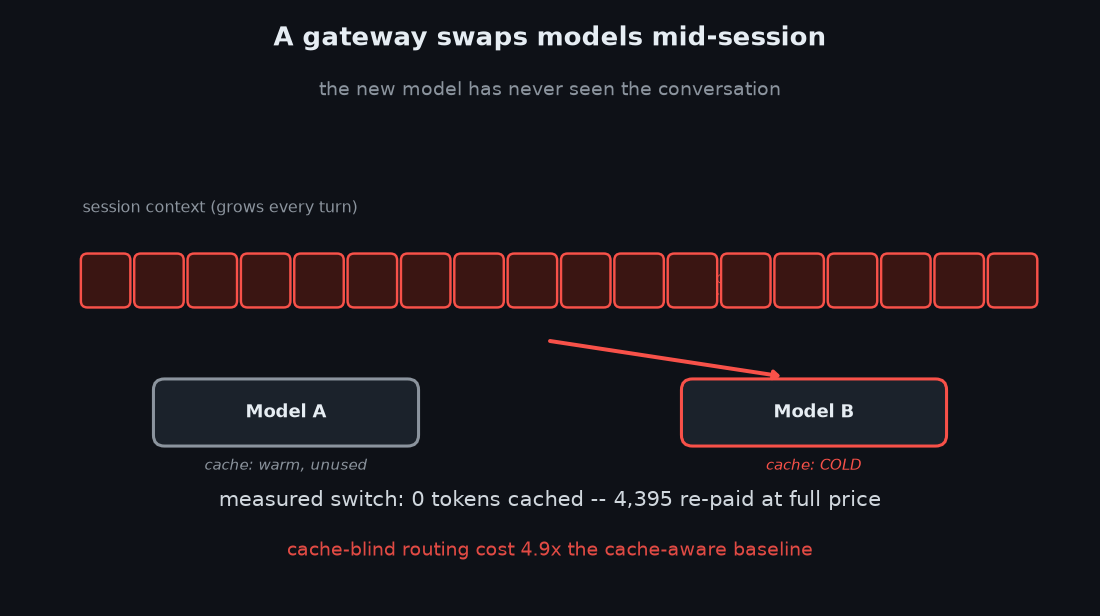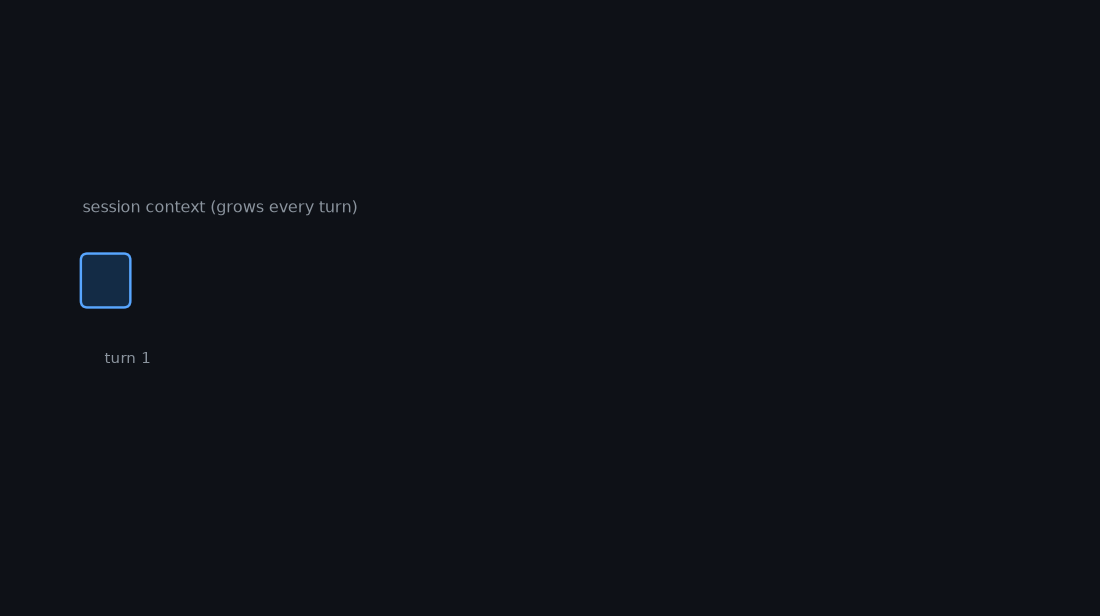
Nhưng cache KV thuộc về một model cụ thể. Model B không thể tái sử dụng cache do model A tạo ra, vì trọng số, số chiều ẩn, kiến trúc, thậm chí tokenizer đều khác. Khi router chuyển một phiên đang chạy sang model khác, model mới bắt đầu từ trạng thái lạnh hoàn toàn và phải xử lý lại toàn bộ lịch sử với giá đầy đủ.
Một switch giữa phiên không chỉ là đổi nhà cung cấp — nó là một lần prefill lạnh toàn bộ phiên, một trong những thao tác đắt nhất trong phục vụ LLM.
Dữ liệu thực tế từ GitHub Copilot
Tháng 8/2026, nhóm nghiên cứu Microsoft Azure công bố nghiên cứu quy mô sản xuất đầu tiên về khối lượng công việc coding agent: một tuần lưu lượng GitHub Copilot, gồm 13,5 triệu phiên và 760 triệu lần gọi model. Kết quả về hành vi cache rất đáng chú ý:
- Trong cùng một lượt: khoảng 90% prompt có thể tái sử dụng từ cache.
- Vượt ranh giới lượt trên cùng model: giảm còn 55%.
- Chuyển sang model khác: chỉ còn 8%.
Khoảng 6,4% phiên có chuyển model, thường do lỗi hoặc giới hạn tốc độ. Nghĩa là rất nhiều đội ngũ đã và đang trả khoản phí này mà không hề biết.
Thí nghiệm: cùng một hội thoại, ba chính sách định tuyến
Tác giả dựng một server vLLM có bật prefix caching, dùng một model 0,9B và một phiên kịch bản cố định: system prompt ~1.000 token cộng 20 lượt, mỗi lượt ~475 token. Mọi phản hồi đều được phát lại y nguyên để chỉ có chính sách định tuyến là biến số thay đổi. Số token tái sử dụng và tính lại được đọc trực tiếp từ bộ đếm prefix_cache_queries_total và prefix_cache_hits_total của server.
Ba chính sách:
- Sticky: cả 20 lượt đi vào model A — hành vi mặc định của phiên dính model.
- Alternate: lượt lẻ sang A, lượt chẵn sang B — mô phỏng định tuyến từng request ở gateway.
- Phase: lượt 1–7 sang A, 8–14 sang B, 15–20 quay lại A — mô phỏng harness chỉ chuyển model ở ranh giới giai đoạn.
Kết quả: cùng 111.871 token prompt đi qua server, nhưng chi phí tính lại khác hẳn nhau.
| Chính sách | Token tính lại | Tỷ lệ cache hit | So với sticky |
|---|---|---|---|
| Sticky | 10.191 | 90,9% | 1,0× |
| Phase (2 lần chuyển) | 17.455 | 84,4% | 1,7× |
| Alternate (19 lần chuyển) | 19.855 | 82,2% | 1,9× |
 Mỗi request được tách thành phần đọc từ cache và phần tính lại với giá đầy đủ
Ở trạng thái ổn định, nhánh sticky chỉ tính lại khoảng 479 token mỗi lượt — đúng phần mới thêm vào. Nhánh alternate tính lại 957 token vì mỗi model tụt lại hai lượt và phải đuổi kịp ở mọi request.
Cú chuyển giữa phiên tốn bao nhiêu?
Nhánh Phase cho thấy rõ khoản phí chuyển đổi. Lượt 8 là request đầu tiên của model B:
- Lượt 7 (model A, ấm): 3.920 token prompt, 3.440 token từ cache, chỉ 480 token tính lại.
- Lượt 8 (model B, lần đầu): 4.395 token prompt, 0 token từ cache, toàn bộ 4.395 token tính lại.
- Lượt 9 (model B, ấm): 4.870 token prompt, 4.400 từ cache, chỉ ~470 token tính lại.
Chiều ngược lại rẻ hơn nhưng vẫn phải trả cho ngữ cảnh tích lũy trong lúc model vắng mặt: ở lượt 15, model A tái sử dụng 3.920 trong 7.740 token và phải tính lại 3.820 token.
Độ trễ cũng phản ánh điều tương tự. Với prompt ~12k token, thời gian đến token đầu tiên là 287 ms khi lạnh so với 60–95 ms khi ấm, tức nhanh hơn khoảng 3–4,8 lần. Trên các model frontier, prefill lạnh lặp lại có thể cộng thêm vài giây vào độ trễ mà người dùng cảm nhận được.
Quy ra tiền: tiết kiệm bị "bốc hơi" phần lớn
Áp bảng giá Claude API (frontier 5 USD/triệu token đầu vào, model tiết kiệm 1 USD/triệu, đọc cache 0,1×, ghi cache 1,25×), kết quả cho phiên 20 lượt như sau:
| Chính sách | Chi phí | So với baseline |
|---|---|---|
| Frontier sticky, có nhận biết cache (baseline) | 11,45 cent | 1,00× |
| Frontier sticky, không nhận biết cache | 55,94 cent | 4,88× |
| Alternate frontier/model rẻ theo từng lượt (gateway) | 10,00 cent | 0,87× |
| Phase routing: rẻ → frontier → rẻ (harness) | 8,10 cent | 0,71× |
| Model rẻ sticky, có nhận biết cache | 2,29 cent | 0,20× |
Ba kết luận đáng chú ý:
- Hành vi cache quan trọng ngang giá model. Điếc cache trên model frontier khiến chi phí tăng 4,88 lần, xóa sạch gần như toàn bộ lợi ích của việc dùng model rẻ.
- Chuyển liên tục xóa phần lớn khoản tiết kiệm kỳ vọng. Đưa một nửa số lượt sang model rẻ hơn 5 lần lẽ ra phải giảm khoảng 40% chi phí đầu vào, nhưng thực đo chỉ được 13%, vì phần tính lại "ăn" mất khoảng hai phần ba lợi ích lý thuyết.
- Định tuyến theo giai đoạn làm tốt hơn nhiều. Phase routing dùng model frontier cho một phần ba số lượt nhưng vẫn rẻ hơn 19% so với alternate, nhờ chỉ gây ra hai lần xáo trộn cache.
 Cùng một phiên, năm cách chạy: điếc cache tốn hơn (+388%) nhiều so với mức model rẻ có thể tiết kiệm
Còn chất lượng thì sao?
Ba thí nghiệm đầu chỉ phát lại kịch bản nên không thể đánh giá chất lượng. Thí nghiệm thứ tư chạy 30 bài toán Python có bộ test ẩn qua vòng lặp viết–kiểm thử–thử lại, tối đa bốn lượt, với ba cấu hình: Opus 5 sticky, Haiku 4.5 sticky và phase routing (khởi đầu bằng Haiku, chuyển sang Opus sau hai lần test thất bại liên tiếp).
| Cấu hình | Tỷ lệ đạt | Chi phí mỗi lần thành công |
|---|---|---|
| Frontier sticky | 30/30 (100%) | 4,66 cent |
| Model rẻ sticky | 29/30 (96,7%) | 0,90 cent |
| Phase routing | 30/30 (100%) | 1,43 cent |
Phase routing đạt cùng tỷ lệ thành công như Opus sticky với 31% chi phí. Tuy nhiên tác giả thẳng thắn lưu ý đây không phải bằng chứng mạnh về tương đương chất lượng: Haiku tự giải được 29/30 bài, chỉ còn đúng một bài để phân biệt các chính sách.
Điều rõ ràng hơn là thuế chuyển đổi. Ở lần nâng cấp đầu tiên, Opus không có prefix nào trong cache cho hội thoại mà Haiku đang mang, nên 10.963 token prompt bị xử lý lại với giá đầy đủ, không có cache hit nào. Bài toán đó khiến nhánh định tuyến tốn gấp 2,1 lần so với Opus sticky.
Nền tảng hạ tầng đã giải quyết được gì?
Các hệ thống phục vụ đã tiến bộ nhiều trong hai năm qua, nhưng phần lớn giải quyết ba bài toán hẹp hơn:
- Định tuyến đến replica đã ấm. Lập lịch nhận biết prefix cache — có trong llm-d, NVIDIA Dynamo và router của SGLang — đưa request tới pod đã giữ block cache phù hợp. Trong một bài hướng dẫn của Red Hat, cách này đạt tỷ lệ cache hit 87,4% và giảm thời gian đến token đầu tiên từ 2.850 ms xuống 340 ms.
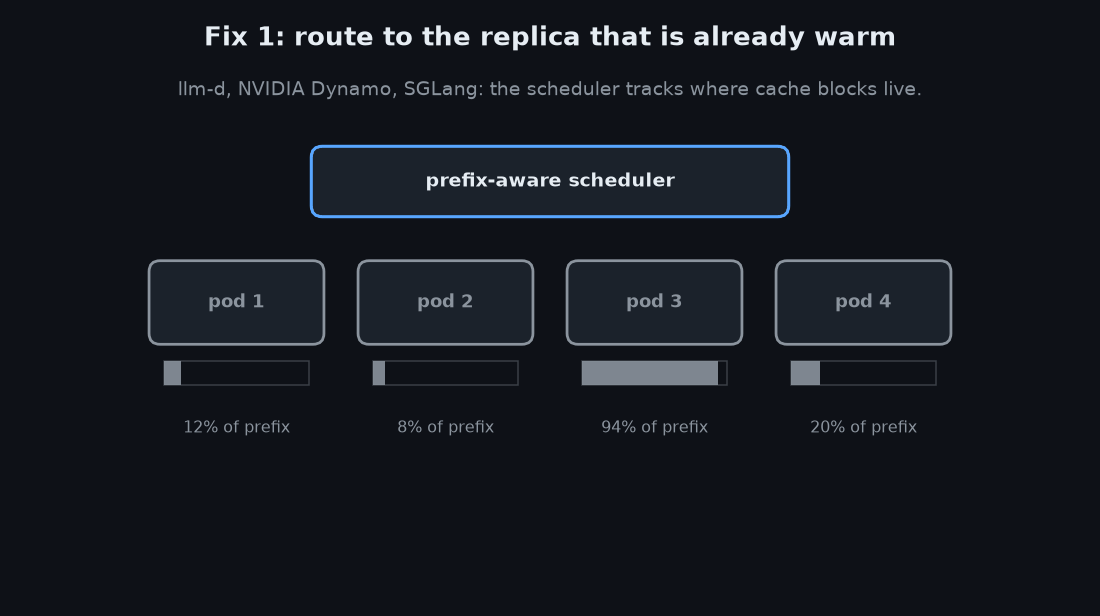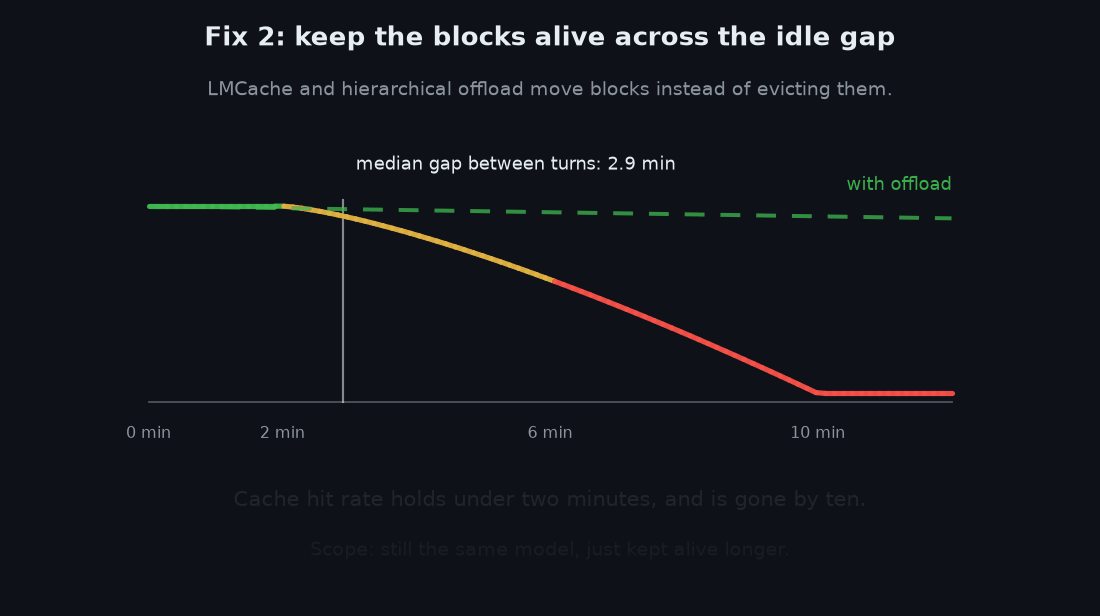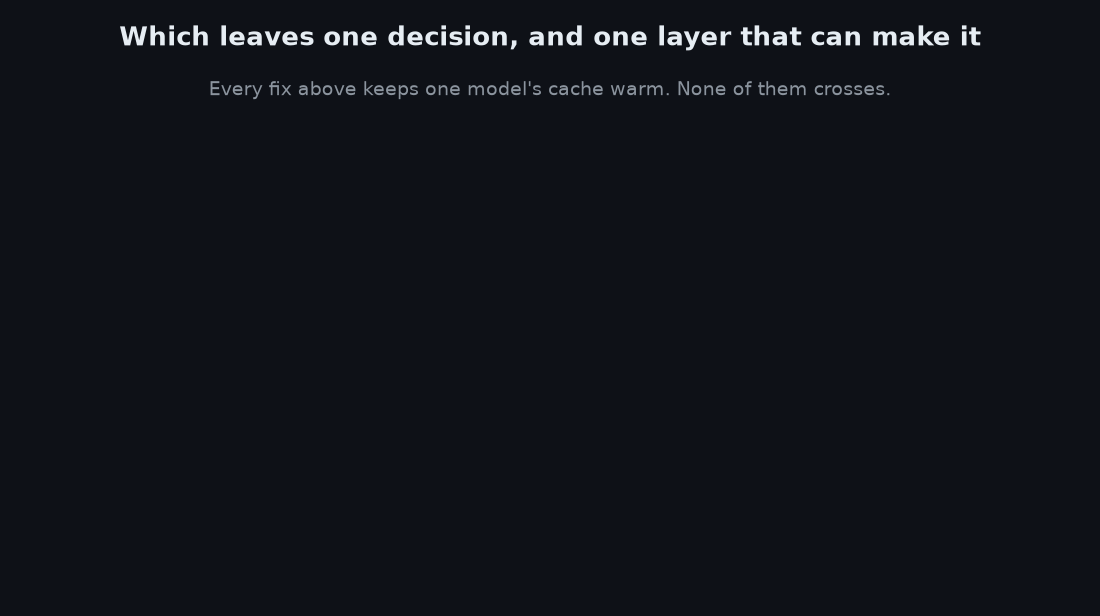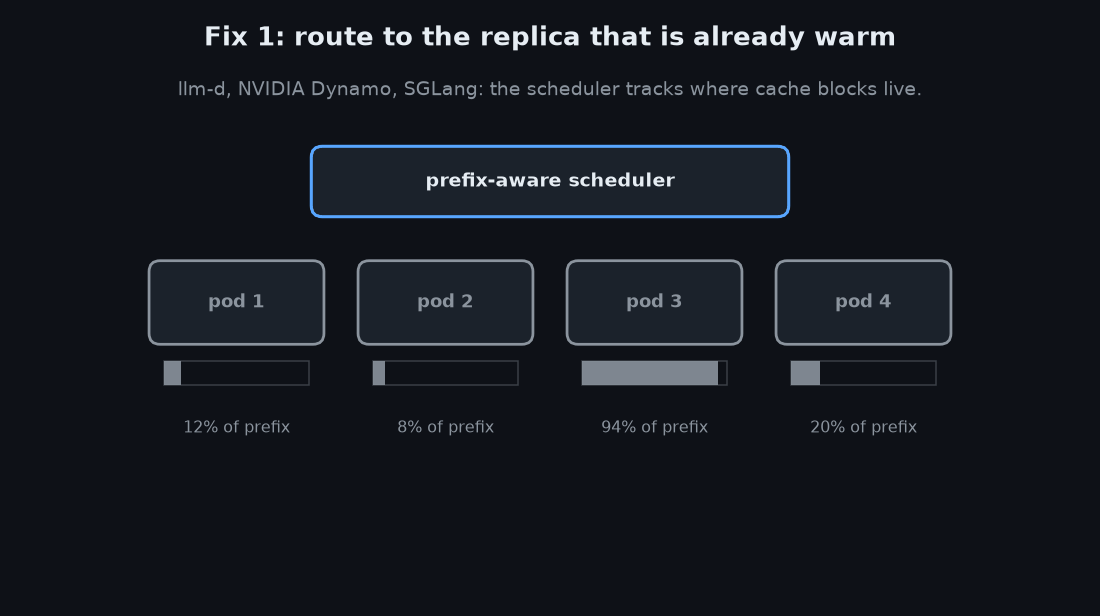
- Giữ cache sống lâu hơn. LMCache và bộ quản lý block của Dynamo có thể chuyển block KV từ GPU sang CPU hoặc đĩa. Dữ liệu Copilot cho thấy cache hit còn trên 95% khi khoảng nghỉ dưới hai phút, giảm nhanh trong khoảng hai đến mười phút và gần như mất hẳn sau mười phút — trong khi khoảng nghỉ trung vị giữa các lượt là 2,9 phút.
- Tái sử dụng KV giữa các model gần nhau. DroidSpeak cho phép một model dùng lại phần lớn trạng thái KV của model khác, nhưng chỉ khi hai model chung kiến trúc nền — thực tế là các biến thể fine-tune của cùng một model gốc.
Ranh giới chung của cả ba hướng: chúng giữ cache ấm cho một model, chứ không bắc cầu giữa hai model không liên quan. Vì vậy câu trả lời không phải là làm cho việc chuyển model tùy ý rẻ đi, mà là tránh những lần chuyển không cần thiết.
Bộ quy tắc thực dụng cho đội ngũ xây dựng agent
Từ các kết quả trên, có thể rút ra một nguyên tắc: một lần chuyển model là một giao dịch mua, và giá của nó là chi phí đọc lại toàn bộ ngữ cảnh mà model mới chưa thấy. Chỉ lớp sở hữu phiên — tức harness — mới nhìn thấy được cái giá đó.
Cụ thể:
- Mặc định sticky. Khởi đầu bằng một model tiết kiệm và chỉ chuyển khi thật có lý do.
- Nâng cấp dựa trên tín hiệu trạng thái tác vụ, không phải cảm giác "câu hỏi này khó". Công cụ thất bại lặp lại, test đỏ liên tiếp hay ranh giới lập kế hoạch là những trigger tốt hơn nhiều.
- Định giá cú chuyển trước khi chuyển: so sánh
uncached_tokens × giá đầu vàovới lợi ích kỳ vọng. - Dùng subagent khi cần suy luận mạnh tạm thời. Một subagent mới có thể cho model frontier một ngữ cảnh nhỏ, trong khi cache của model cha vẫn ấm.
- Học từ kết quả thực thi. Harness biết được bản vá có qua test hay không — tín hiệu mà gateway thường không có.
Ngoài định tuyến, harness còn một đòn bẩy khác: vì nó dựng ngữ cảnh, nó có thể thu nhỏ ngữ cảnh — nạp schema công cụ theo nhu cầu, trả về tham chiếu gọn thay vì phát lại kết quả lớn, đẩy các nhánh dài sang subagent chỉ báo cáo tóm tắt. Một nghiên cứu năm 2026 báo cáo cách làm này giảm 38% token mỗi tác vụ và 41% chi phí tổng hợp trên sáu model nền tảng khác nhau.
Với các đội ngũ Việt Nam đang triển khai agent trên hạ tầng cloud, bài học khá trực tiếp: trước khi cài một router để giảm chi phí inference, hãy hỏi nó một câu — "cú chuyển này tốn bao nhiêu?". Nếu router không trả lời được, nó đang ra quyết định mà không nhìn thấy toàn bộ kinh tế của phiên làm việc.
Nguồn tham khảo: nghiên cứu của Microsoft Azure về lưu lượng GitHub Copilot ở quy mô sản xuất (arXiv:2608.00101), bài phân tích về kiến trúc định tuyến của Factory AI, tài liệu vLLM về automatic prefix caching, và tài liệu prompt caching của Anthropic.