Có thể dùng diffusion tự hồi quy để sinh dữ liệu thị trường?
Một thực tập sinh tại Jane Street đã thử xây dựng mô hình sinh dữ liệu thị trường bằng diffusion tự hồi quy. Kết quả cho thấy dữ liệu thị trường vừa liên tục vừa rời rạc, khiến diffusion thuần túy không đủ đáp ứng và cần những kỹ thuật xử lý điểm gián đoạn đặc biệt.
Có thể dùng diffusion tự hồi quy để sinh dữ liệu thị trường?
Trong tài chính định lượng, các mô hình dự đoán giá thị trường đã quá quen thuộc. Nhưng một mô hình sinh (generative) có thể tạo ra chính các sự kiện trên sổ lệnh — kèm cả thời điểm chúng xuất hiện — lại là chuyện hiếm gặp. Một thực tập sinh tại Jane Street đã thử sức với bài toán này trong mùa hè 2026, và những phát hiện thu được hé lộ nhiều điều thú vị về bản chất dữ liệu thị trường.
Bài viết gốc được đăng trên blog của Jane Street, thu hút sự quan tâm của cộng đồng công nghệ trên Hacker News.
Dữ liệu thị trường là liên tục hay rời rạc?
Đây là câu hỏi nền tảng mà bất kỳ mô hình sinh nào cũng phải trả lời. Dữ liệu thị trường mang đặc điểm của cả hai phía.
Sổ lệnh (order book) biến đổi qua từng lượt hành động rời rạc: người tham gia đặt lệnh chờ, hủy lệnh, hoặc khớp lệnh. Như vậy rõ ràng có một không gian hành động rời rạc. Nhưng nhiều tham số quan trọng như giá lại có số lượng giá trị khả dĩ quá lớn, khiến chúng gần như liên tục.
Thời điểm lệnh đến sàn — yếu tố then chốt với mô hình sinh — lại càng phức tạp. Trên thực tế, phân phối của nó có những đỉnh nhọn: hiện tượng "pennying" (cải thiện giá một tick) phổ biến hơn hẳn việc cải thiện hai tick, và các lệnh thường đến theo cụm, chẳng hạn quanh các mốc thời gian tròn.
 Minh họa quá trình sinh dữ liệu thị trường bằng diffusion tự hồi quy
Thiết lập mô hình
Nhóm nghiên cứu phân tích bốn năm dữ liệu cổ phiếu Mỹ, mỗi dòng gồm timestamp, giá, loại sự kiện (khớp lệnh, đặt lệnh, hủy lệnh...) và các thông tin khác. Mô hình diffusion sẽ cố sinh ra các đặc trưng này cho sự kiện kế tiếp, rồi tự hồi quy nối tiếp vào chuỗi dữ liệu.
Lấy cảm hứng từ bài báo Autoregressive Image Generation without Vector Quantization, thực tập sinh Kavish xây dựng kiến trúc encoder–diffuser: một transformer encoder có mặt nạ nhân quả tạo embedding tiềm ẩn tại mỗi vị trí. Latent này được đưa vào hai nhánh:
- Một đầu phân loại sự kiện (2 lớp) dự đoán sự kiện kế tiếp là khớp lệnh hay cập nhật BBO (giá mua/bán tốt nhất).
- Một đầu diffusion sinh các mục tiêu liên tục như giá, thời gian trôi qua, được điều kiện hóa theo latent và loại sự kiện thật.
Khi suy luận, mô hình chỉ cần đưa latent của sự kiện cuối vào đầu phân loại, lấy mẫu loại sự kiện, rồi dùng đầu diffusion sinh các đặc trưng liên tục tương ứng.
DDPM thất bại, flow matching tỏa sáng
DDPM (denoising diffusion probabilistic model) dự đoán nhiễu được thêm vào mẫu rồi khử dần để thu về ước lượng sạch. Phương pháp này rất thành công trong sinh ảnh, nhưng ở mức nhiễu cao, sai số nhỏ trong dự đoán nhiễu lại dẫn đến sai số lớn trong ước lượng đích.
Kavish ban đầu dùng DDPM với lịch cosine 1.000 bước và sinh mẫu theo DDIM. Kết quả cực kỳ bất ổn: 88–95% giá trị nằm xa hơn 8 độ lệch chuẩn so với trung bình phân phối trên cả 7 mục tiêu liên tục. Các quỹ đạo khử nhiễu nhanh chóng bùng nổ ra ngoài biên.
Flow matching khắc phục bằng cách nội suy tuyến tính giữa nhiễu và dữ liệu, huấn luyện mạng dự đoán vector vận tốc trên đường thẳng đó. Nhờ quỹ đạo gần như thẳng, mô hình có thể lấy tích phân chính xác chỉ với vài bước. Kavish chuyển sang flow matching và thu được kết quả ổn định ngay từ đầu.
 So sánh quỹ đạo khử nhiễu giữa DDPM và flow matching
Xử lý các điểm gián đoạn
Phần lớn thời gian của dự án dành cho vấn đề cốt lõi: dữ liệu thị trường không hoàn toàn liên tục cũng không hoàn toàn rời rạc.
Hãy so sánh với video — lĩnh vực mà diffusion rất mạnh. Video liên tục cả trong từng khung hình (cường độ và màu điểm ảnh biến thiên mượt) lẫn trong diễn tiến (điểm ảnh nhận mọi giá trị liên tục giữa các khung). Dữ liệu thị trường thì khác: các "khung hình" liên tục nhưng diễn tiến lại rời rạc, bị chi phối bởi vi cấu trúc thị trường.
Điều này lộ rõ khi xem phân phối các đặc trưng — chúng có những ranh giới sắc nét:
- Thời điểm lệnh đến không theo phân phối chuẩn mà tụ lại thành cụm, với khối xác suất tập trung quanh 0 giây, quanh thời gian phản ứng sớm nhất có thể, và quanh các giây tròn.
- Giá có xu hướng tập trung quanh trung điểm bid–ask, hoặc quanh bid hiện tại, hoặc ask hiện tại.
Ngoài ra còn mất cân bằng giữa các lớp: chỉ 8% sự kiện là khớp lệnh, phần còn lại là thay đổi BBO, khiến đầu phân loại dự đoán thừa khớp lệnh.
Kavish thử chia nhỏ các lớp thành 20 loại phổ biến như "chỉ đổi khối lượng", "ask tăng", "bid giảm"... Cách này cho phân phối biên tốt hơn rõ rệt, nhưng đòi hỏi nhiều công chỉnh tay và khó mở rộng khi tập đặc trưng lớn dần — ví dụ biến "sự kiện xảy ra ở sàn nào" có thể làm số lớp bùng nổ.
Kỹ thuật "atom smoothing"
Để giải quyết vấn đề gián đoạn một cách tổng quát hơn, Kavish phát triển thủ tục gọi là "atom smoothing". Ý tưởng là làm mượt phân phối đỉnh nhọn thật, sau đó tái tạo lại đỉnh theo cách vẫn giữ được khối xác suất tại đó mà không tạo ra điểm gián đoạn.
Điểm mấu chốt là chọn biểu diễn biến phù hợp: những đỉnh nhọn dưới một biểu diễn này có thể bớt nhọn dưới biểu diễn khác, và bạn cần phơi bày rồi làm mượt mọi đỉnh sắc.
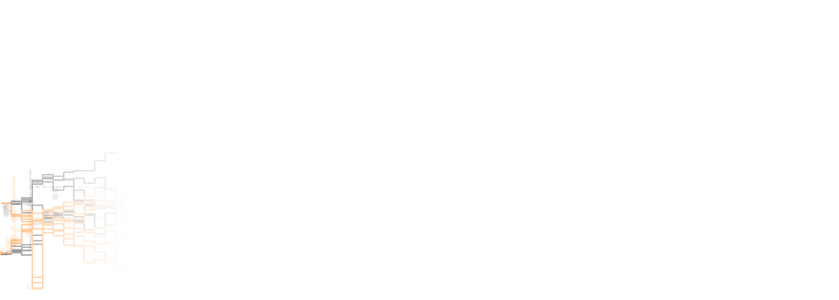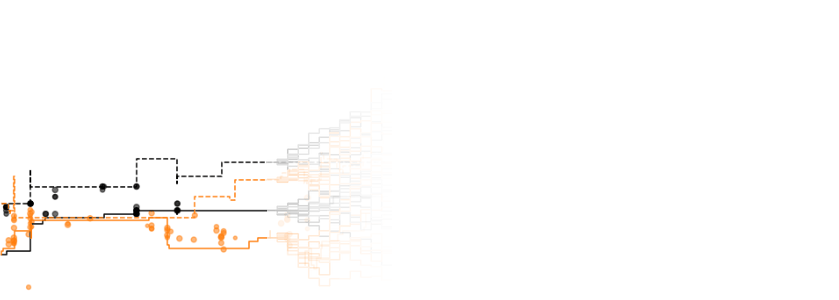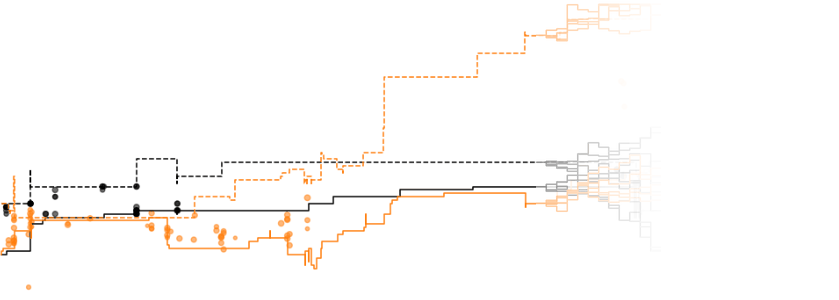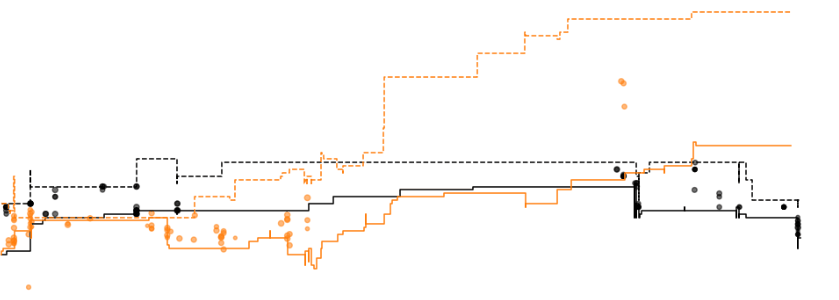
 Minh họa kỹ thuật atom smoothing trên phân phối dữ liệu thị trường
Kết quả và triển vọng
Mô hình diffusion kết hợp flow matching và atom smoothing hoạt động khá tốt. Kavish so sánh phân phối biên đầu ra với phân phối biên thật theo từng mục tiêu, đo bằng phân kỳ toàn biến thiên (TV divergence) trong bối cảnh một bước: đưa vào 10.240 sự kiện thật làm ngữ cảnh, lấy mẫu một sự kiện kế tiếp, rồi đối chiếu với sự kiện thực tế đã xảy ra.
Ông cũng huấn luyện một bộ phân loại để phân biệt dự đoán của mô hình với sự kiện thật — đọc một cửa sổ ngữ cảnh thật kèm một sự kiện ứng viên, rồi đoán ứng viên đó từ đâu mà có. Mô hình với biểu diễn đặc trưng tối ưu cho atom smoothing tạo ra mẫu chân thực hơn hẳn.
Mục tiêu cuối cùng là triển khai tự hồi quy (rollout). Dự đoán đương nhiên suy giảm theo thời gian, và một câu hỏi mở là mức độ suy giảm chính xác đến đâu. Ở đồ thị độ trải rộng của CME US, có thể thấy độ phân tán nới rộng dần trong bản tự hồi quy tổng hợp.
Mô hình của Kavish chưa đủ chính xác để trở thành bộ sinh thực dụng, nhưng nghiên cứu này đã làm rõ những "núm vặn" quan trọng: nên đưa bao nhiêu tính rời rạc vào mô hình, và nên biểu diễn cùng làm mượt phân phối đặc trưng thế nào để diffusion phát huy tốt nhất.
Ý nghĩa với người làm AI tài chính
Dự án mở ra một góc nhìn: sự kiện trên sổ lệnh tồn tại đồng thời trong không gian liên tục ("khối lượng ask tăng 10%") và không gian hành động rời rạc ("pennying giá bid"). Đó là hai cách nhìn cùng một thứ, và muốn sinh dữ liệu thị trường thì phải mô hình hóa đúng sự pha trộn ấy.
Với cộng đồng AI và fintech tại Việt Nam, hướng nghiên cứu này đáng chú ý bởi nó kết hợp hai lĩnh vực đang phát triển nhanh: mô hình sinh hiện đại (diffusion, flow matching) và dữ liệu tài chính vi mô. Các kỹ thuật như atom smoothing hay xử lý điểm gián đoạn có thể hữu ích cho nhiều bài toán dữ liệu chuỗi có cấu trúc phức tạp khác, không chỉ riêng thị trường chứng khoán.
Nếu bạn quan tâm đến dạng công việc này, Jane Street hiện đã mở đơn cho chương trình thực tập ML Research năm 2027.