Continuous batching nhanh hơn static tới 2,91 lần trên vLLM
Một thử nghiệm có đối chứng trên DGX Spark cho thấy cơ chế continuous batching trong vLLM giúp tăng thông lượng tới 2,91 lần so với static batching khi độ dài đầu ra biến thiên mạnh, trong khi động cơ suy luận chỉ đóng góp 1,33 lần. Kết quả nhấn mạnh rằng lợi ích phụ thuộc vào phân bố độ dài câu trả lời chứ không phải tốc độ GPU.
Một thử nghiệm có kiểm soát trên vLLM đã tách riêng được phần đóng góp của bộ lập lịch (scheduler) và của động cơ suy luận (inference engine) trong các tuyên bố tăng tốc phục vụ mô hình ngôn ngữ lớn (LLM). Kết quả: continuous batching đạt thông lượng gấp 2,91 lần static batching trên lưu lượng có độ dài đầu ra biến thiên mạnh, trong khi bản thân động cơ chỉ mang lại 1,33 lần.
Điều này quan trọng với bất kỳ ai đang vận hành hoặc lựa chọn máy chủ suy luận, bởi các con số "nhanh gấp 10 hay 20 lần" thường gộp nhiều cải tiến khác nhau vào một chỉ số duy nhất.
 Sơ đồ so sánh các chính sách batching
Vì sao một bước decode tốn gần như nhau dù phục vụ 1 hay 32 chuỗi
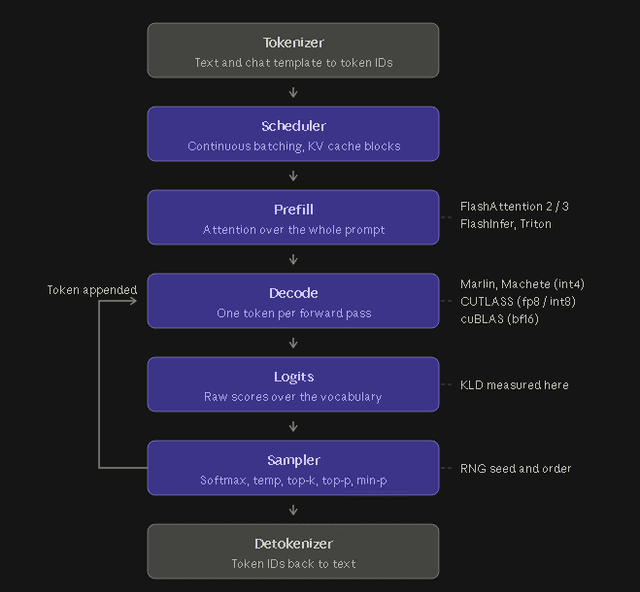
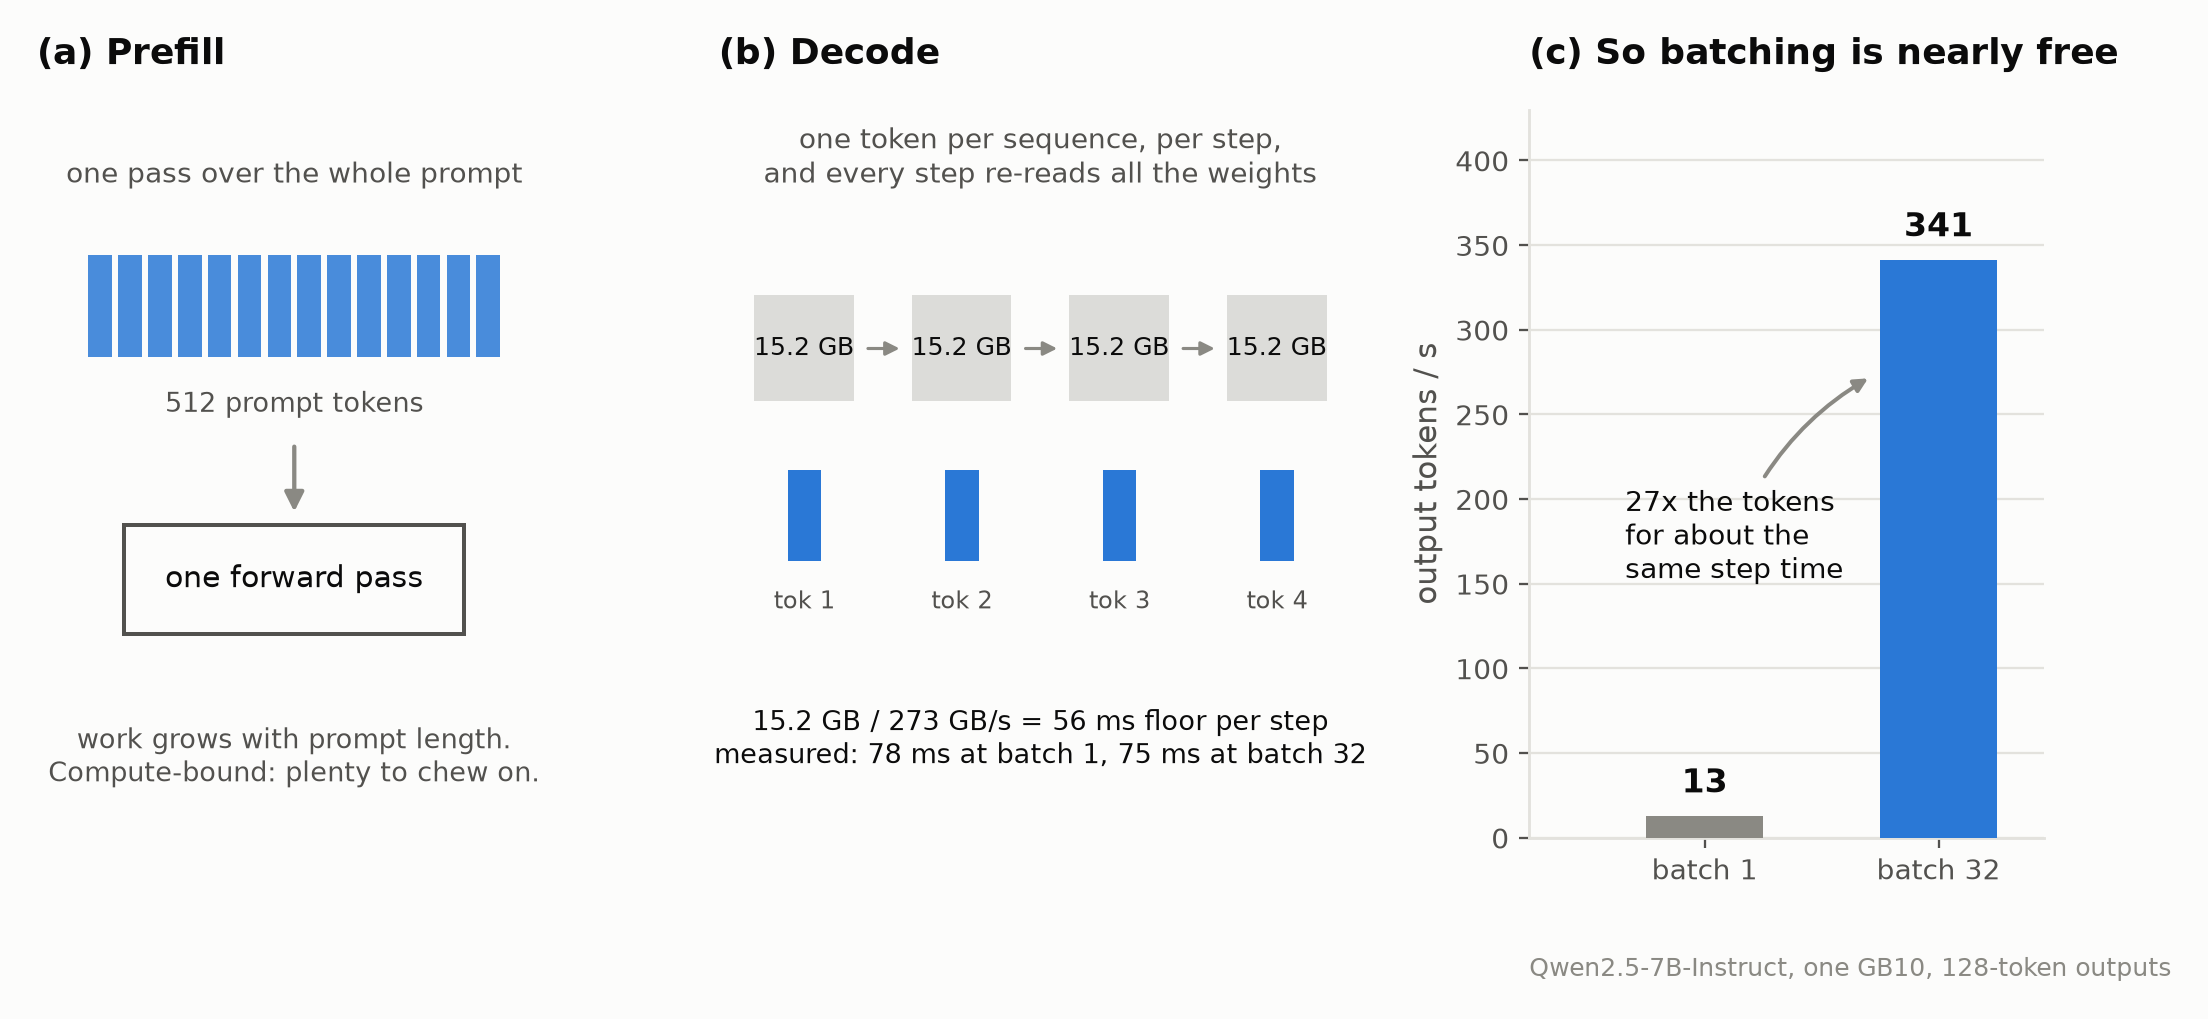
Quá trình sinh văn bản của transformer chia làm hai pha. Prefill đọc toàn bộ prompt trong một lượt lan truyền xuôi, nên chi phí tăng theo độ dài prompt và tạo nhiều phép tính cho GPU. Decode thì khác: mỗi bước chỉ sinh một token cho mỗi chuỗi, nhưng bước nào cũng phải đọc lại toàn bộ trọng số mô hình.
Với Qwen2.5-7B-Instruct ở định dạng bfloat16, trọng số chiếm khoảng 15,2 GB. Trên GB10 của DGX Spark với băng thông bộ nhớ danh định 273 GB/s, việc đọc trọn bộ trọng số một lần tốn tối thiểu khoảng 55,7 ms. Tác giả đo được 78,05 ms mỗi bước ở batch 1, tức khoảng 194,7 GB/s hay 71% băng thông danh định.
Hệ quả thực tế rất rõ: tăng batch từ 1 lên 32 nâng tổng thông lượng lên 26,7 lần (từ 12,76 lên 341,24 token/giây), trong khi khoảng cách giữa các token gần như không đổi. Mỗi chuỗi đơn lẻ chậm đi đôi chút vì phải chờ xếp hàng và prefill, nhưng GPU vẫn phải đọc đúng khối trọng số đó bất kể batch lớn hay nhỏ.
Nói cách khác, để trống một chỗ trong batch decode không tiết kiệm được chi phí đọc trọng số. Bài toán trở thành làm sao giữ các chỗ đó luôn có việc mà không đẩy độ trễ lên quá mức người dùng chấp nhận.
Ba chính sách, một GPU
Thử nghiệm giữ nguyên khối lượng công việc: tám yêu cầu, bốn chỗ, cùng độ dài đầu ra. Biến duy nhất được thay đổi là thời điểm yêu cầu đang chờ được phép bắt đầu.
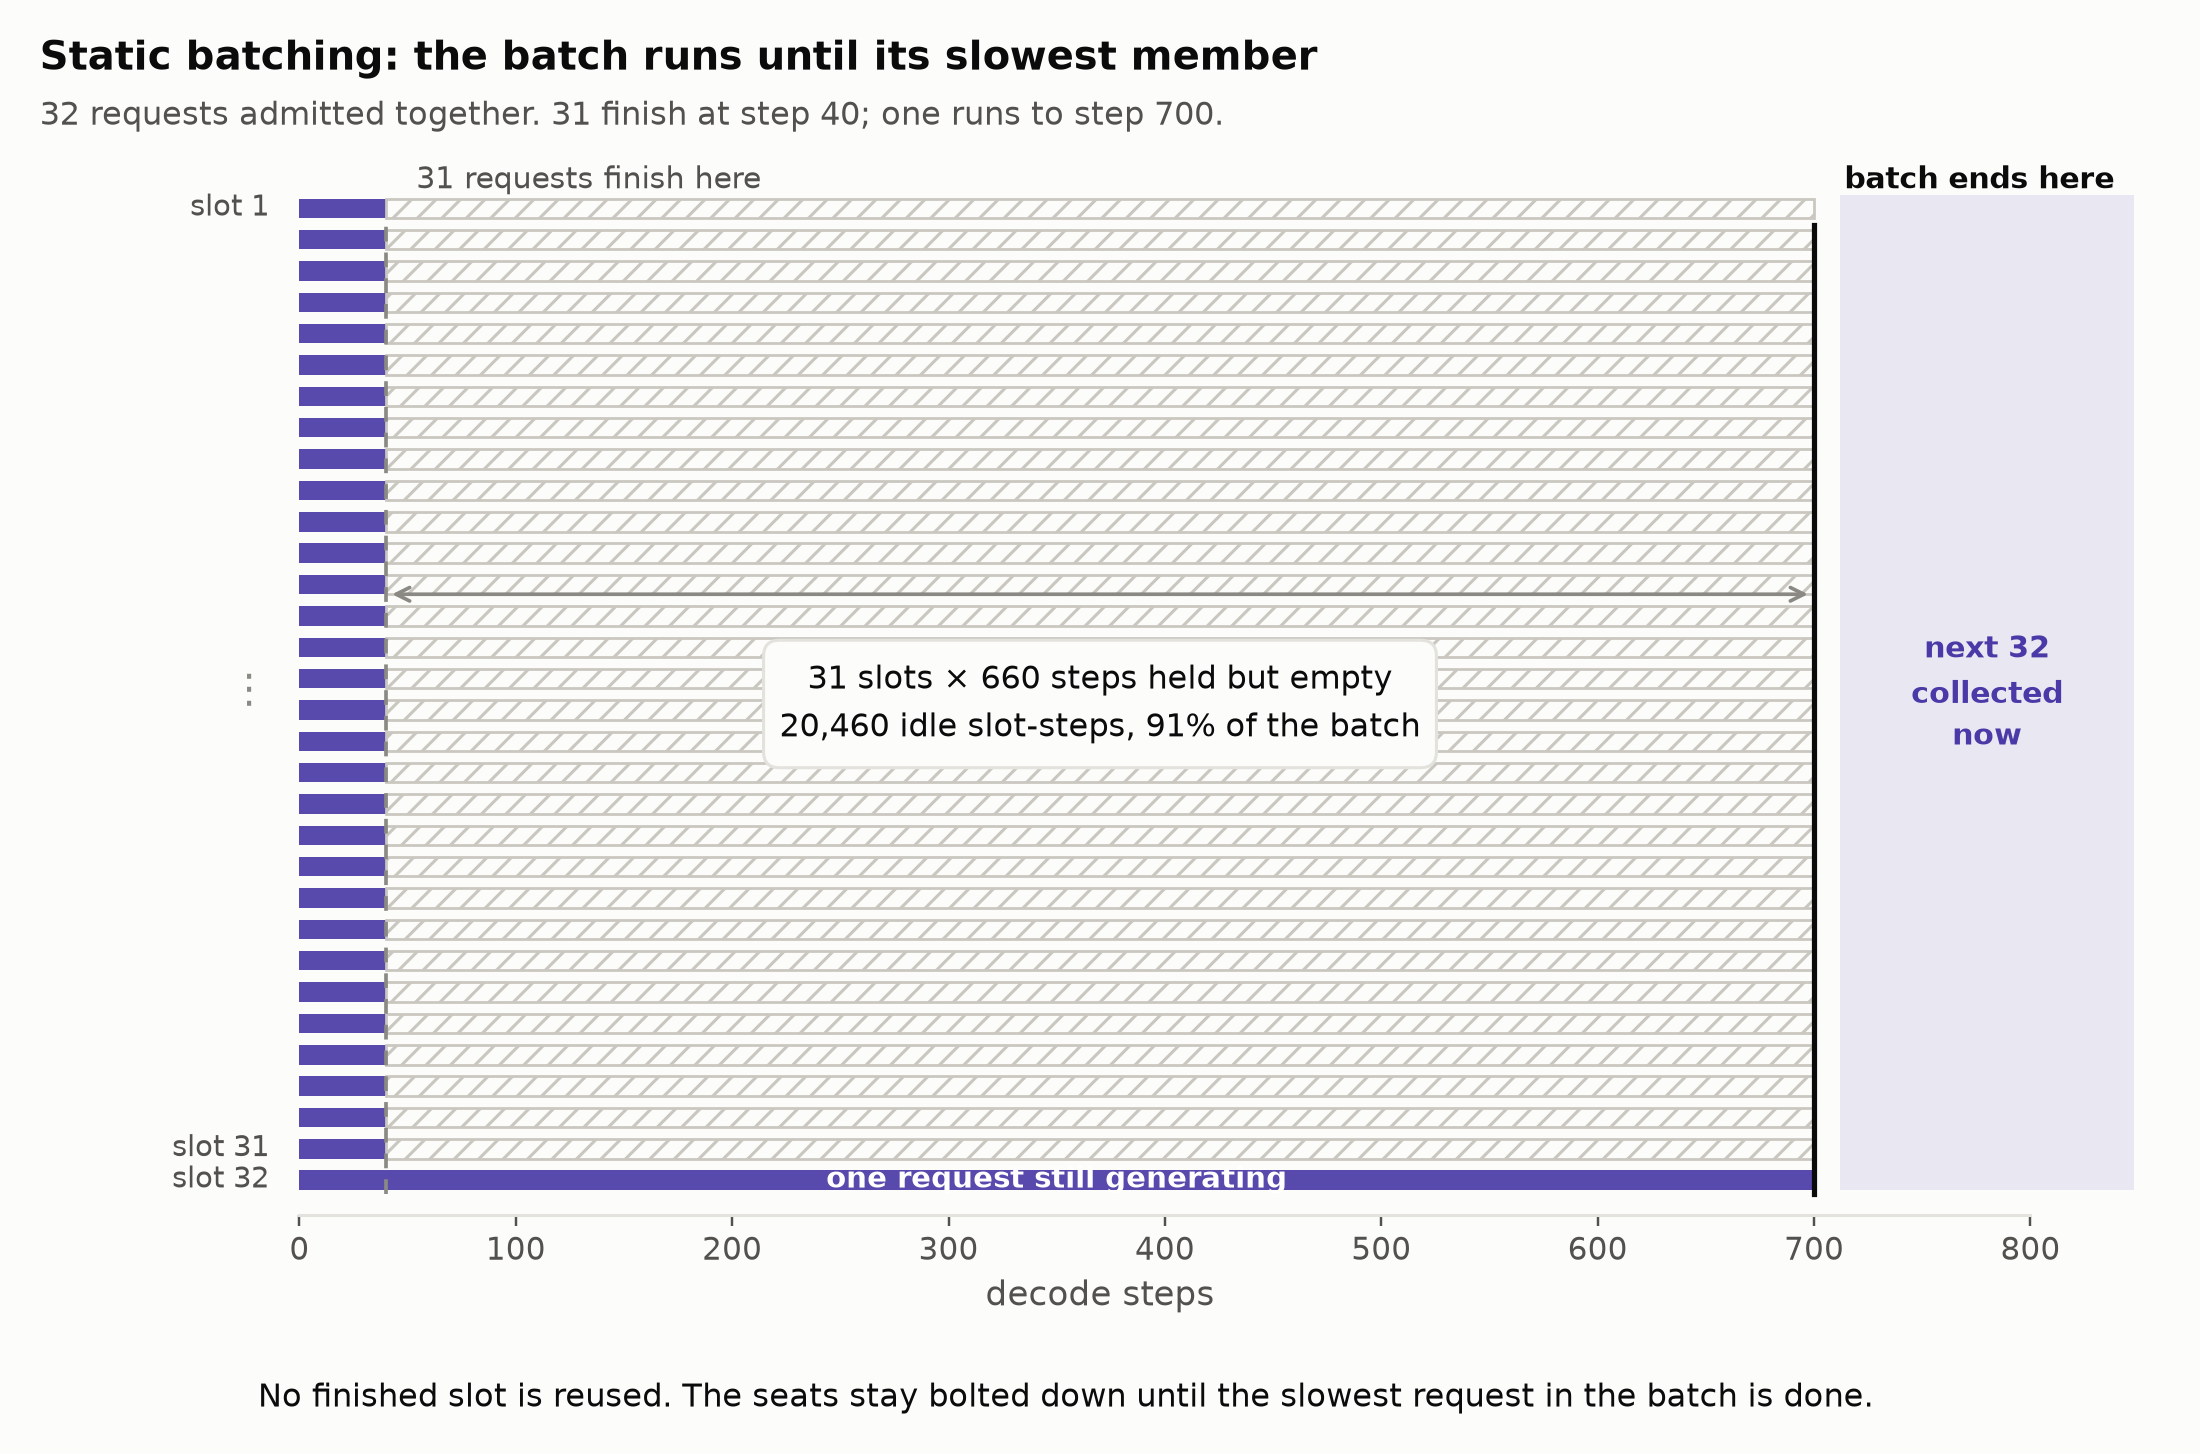
- Static batching: gom đúng B yêu cầu, chạy cùng nhau và đợi mọi yêu cầu xong mới nhận lô mới. Nếu một yêu cầu chạy tới 700 bước trong khi 31 yêu cầu khác dừng ở bước 40, thì 31 chỗ đó bị chiếm trống suốt 660 bước.
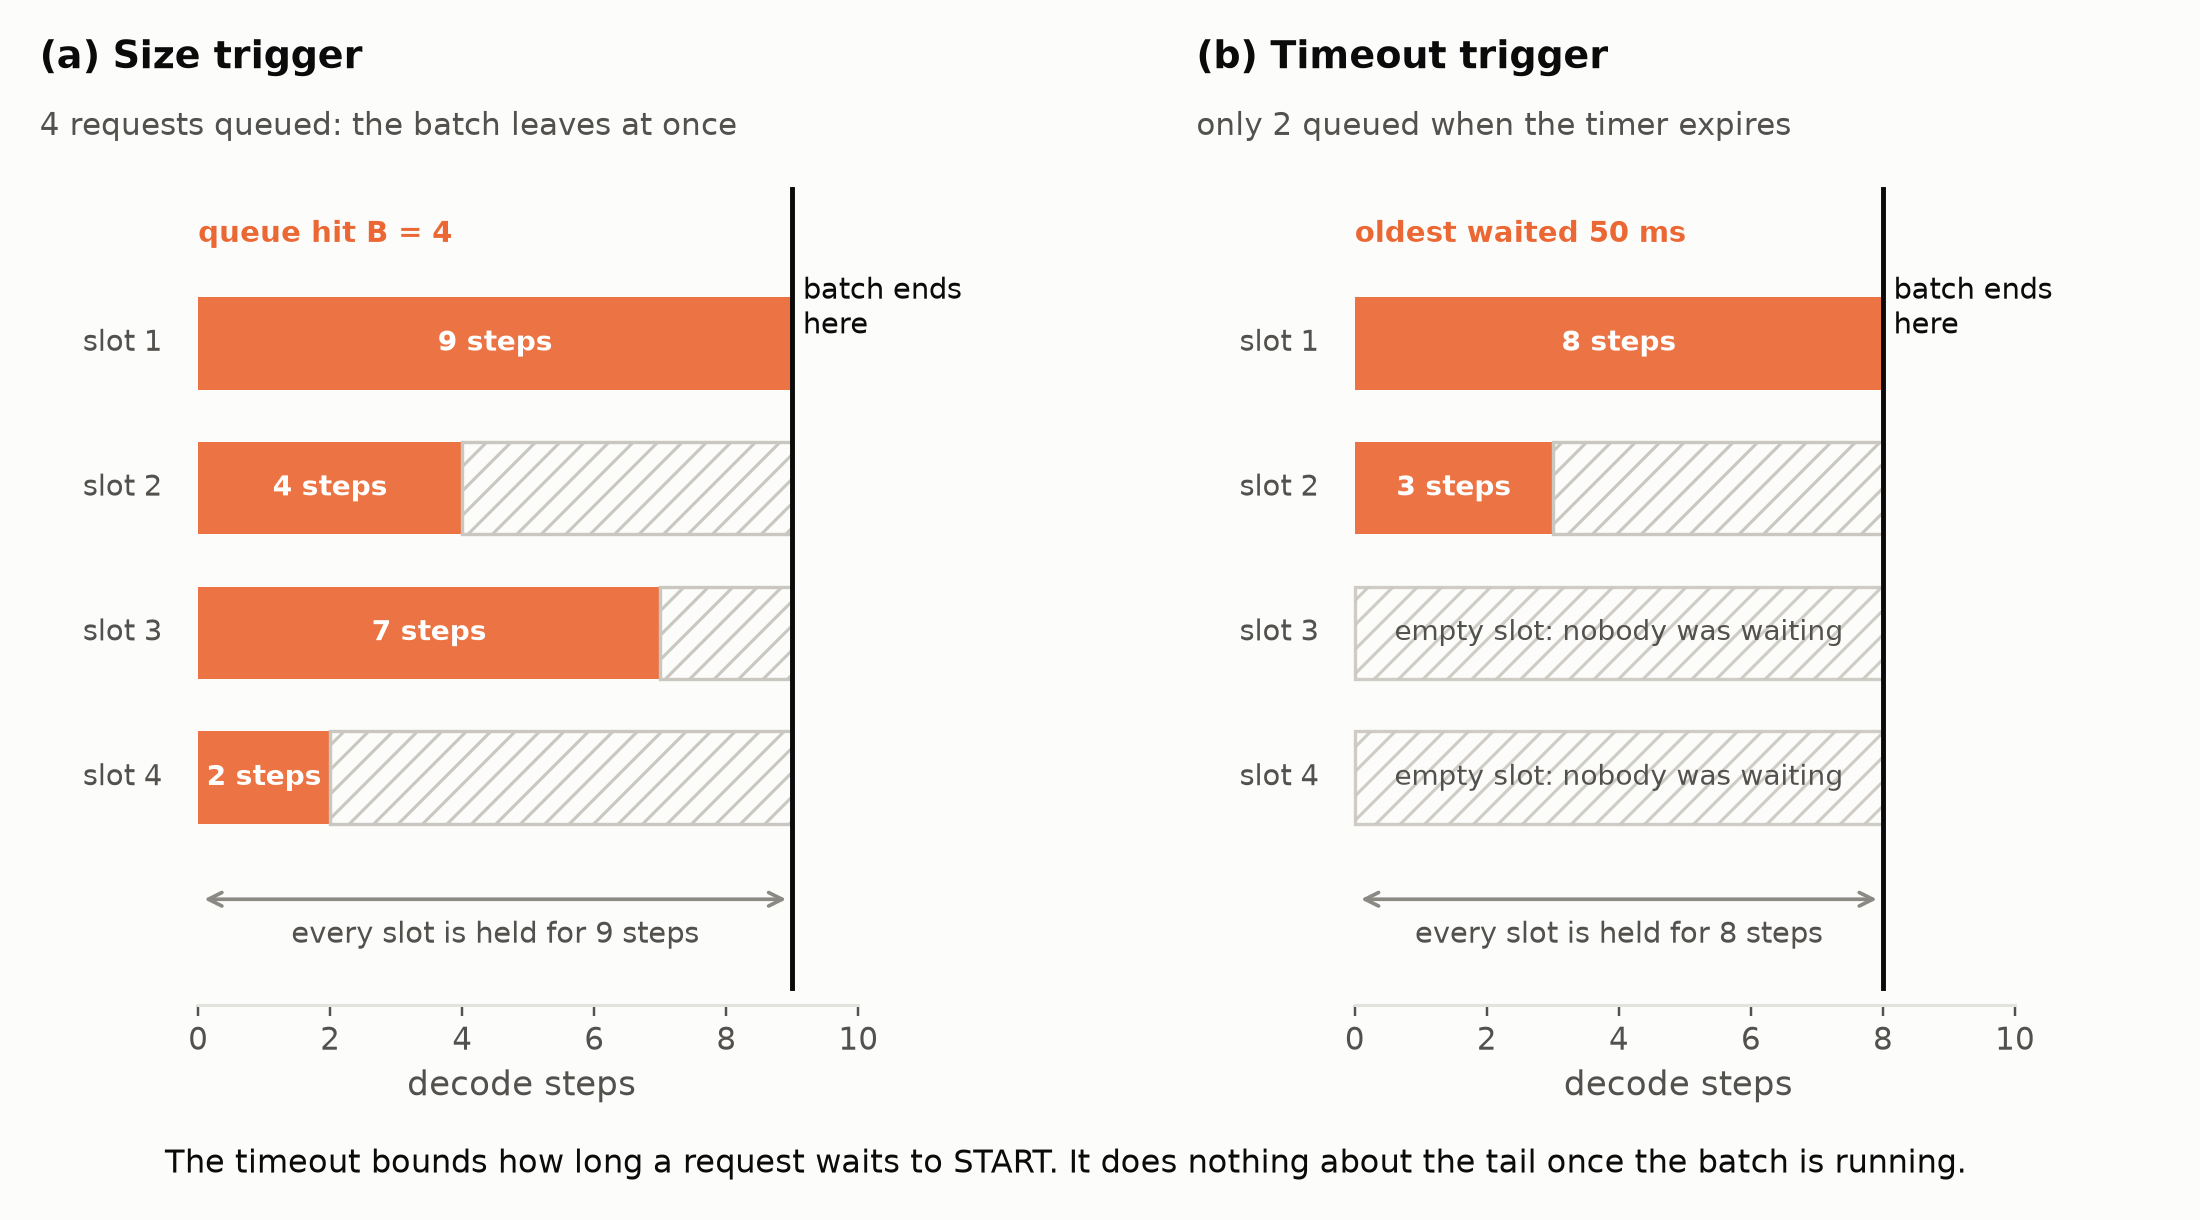
- Dynamic batching: thêm bộ hẹn giờ để lô vẫn được xuất phát khi hàng đợi chưa đầy. Cách này cải thiện độ trễ xếp hàng nhưng không thay đổi điều gì sau khi lô đã chạy.
- Continuous batching: thay đổi đơn vị lập lịch. Sau mỗi bước decode, bộ lập lịch kiểm tra chuỗi nào đã xong và giao ngay chỗ trống cho yêu cầu đang chờ.
Ý tưởng này bắt nguồn từ lập lịch theo từng vòng lặp (iteration-level scheduling) trong Orca (Yu và cộng sự, OSDI 2022): batch đang hoạt động trở thành một tập chuỗi cuốn chiếu thay vì một nhóm cố định.
Cần phân biệt rõ: continuous batching không làm GPU nhanh hơn, nó chỉ chấm dứt tình trạng các chuỗi đã xong vẫn chiếm chỗ.
Quản lý bộ nhớ cũng góp phần
Mỗi chuỗi đang hoạt động sở hữu một KV cache với độ dài cuối cùng chưa biết trước. Nếu cấp phát thành một khối liền mạch, các yêu cầu đã xong sẽ để lại lỗ hổng khó tái sử dụng. PagedAttention (Kwon và cộng sự, SOSP 2023) giải quyết bằng cách quản lý bộ nhớ KV cache theo các khối nhỏ hơn.
Đây là kỹ thuật quản lý bộ nhớ, không phải chính sách lập lịch, nhưng hai thứ bổ trợ nhau. Điều này quan trọng khi đọc các tuyên bố thông lượng: con số 23 lần mà Anyscale báo cáo bao gồm cả PagedAttention lẫn continuous batching, chưa kể bản thân động cơ.
Cùng tên gọi, khác bản chất
Các hệ thống trên thị trường dùng tên gọi khác nhau cho những thứ khác nhau:
| Động cơ | Tên gọi | Ghi chú |
|---|---|---|
| vLLM | continuous batching | Điều khiển bằng --max-num-seqs, --max-num-batched-tokens |
| TGI | continuous batching | --max-concurrent-requests mặc định 128 |
| TensorRT-LLM | in-flight batching | Ba chính sách: GUARANTEED_NO_EVICT, MAX_UTILIZATION, STATIC_BATCH |
| SGLang | continuous batching + RadixAttention | --max-running-requests, --max-total-tokens |
| Triton | dynamic batcher | Không phải continuous batching |
Đáng chú ý là "dynamic batching" của Triton là batching theo mức yêu cầu, không phải continuous batching. Nó quyết định thời điểm bắt đầu lô bằng max_queue_delay_microseconds rồi chạy lô đó từ đầu đến cuối — đặt nó trước một LLM chỉ cho ra chính sách dynamic batching thông thường.
Thiết lập thử nghiệm và đối chứng
Bài đo chạy trên một DGX Spark với GB10 và 128 GB bộ nhớ hợp nhất LPDDR5X, mô hình Qwen2.5-7B-Instruct bfloat16, một image vLLM cố định, tắt prefix caching. Cả ba chính sách đều gọi vào cùng một máy chủ qua một client asyncio duy nhất.
Để so sánh công bằng, tác giả áp dụng bốn biện pháp:
- Đồng mức tương tranh: giới hạn 32 yêu cầu đang xử lý cho cả static và continuous.
- Cùng khối lượng: mỗi lần chạy lại đúng một workload có hạt giống, 512 yêu cầu, prompt 512 token, dùng
ignore_eosbuộc mọi yêu cầu sinh đủ số token quy định. - Đối chứng không biến thiên: bộ
const128với mọi yêu cầu đều sinh đúng 128 token. - Chạy lặp: ba lần cho mỗi ô static và continuous.
Năm trace dữ liệu khác nhau ở độ dài trả lời, được lấy mẫu từ phân phối mũ với trung bình 128 token và cắt ở các ngưỡng 32, 128, 512, 1536. Độ biến thiên được đo bằng hệ số biến thiên (CV) — độ lệch chuẩn chia cho giá trị trung bình.
Kết quả: lợi ích tỷ lệ với độ biến thiên
Trên bộ đối chứng const128, static đạt 341,23 token/giây và continuous đạt 340,78 token/giây — tỷ lệ 0,999. Cả hai đều nằm trong ngưỡng 5% đặt trước. Continuous batching không thắng gì ở đây, đúng như lý thuyết.
 Đồ thị thông lượng theo từng mức độ biến thiên
| Trace | CV | Static | Dynamic | Continuous | Continuous / static |
|---|---|---|---|---|---|
| const128 | 0,00 | 341,2 | 340,6 | 340,8 | 1,00× |
| cap32 | 0,28 | 179,7 | 180,2 | 206,5 | 1,15× |
| cap128 | 0,58 | 222,9 | 222,7 | 311,9 | 1,40× |
| cap512 | 0,94 | 120,6 | 120,6 | 313,4 | 2,60× |
| cap1536 | 0,99 | 108,3 | 108,3 | 314,5 | 2,91× |
Điểm đáng chú ý là mức tăng không đều. Bước nhảy lớn nhất nằm giữa CV 0,58 và 0,94, khi tốc độ tăng từ 1,40 lần lên 2,60 lần. Với chỉ năm khối lượng công việc, chưa thể xác định chính xác hàm biến thiên trong khoảng đó, nhưng xu hướng cho thấy continuous batching phát huy tác dụng khi thời điểm hoàn thành các yêu cầu khác nhau rõ rệt.
Dynamic batching gần như trùng khớp static khi yêu cầu đến theo cụm: chênh lệch tối đa chỉ 0,26%. Vì cả 512 yêu cầu đến cùng lúc, lô đã đầy trước khi bộ hẹn giờ kịp phát huy tác dụng.
Nút vặn timeout
Trên trace "lởm chởm" nhất, tác giả thử đổi timeout của dynamic batching từ 50 ms lên 500 ms với lưu lượng đến theo phân phối Poisson 2,0 yêu cầu/giây. Kết quả gần như không đổi: thông lượng khoảng 104 token/giây, thời gian tới token đầu tiên (TTFT) trung vị tăng nhẹ từ 155,83 lên 156,10 giây.
Nguyên nhân là tốc độ đến gấp khoảng 2,4 lần năng lực phục vụ (0,85 yêu cầu/giây), nên hàng đợi không bao giờ vơi và timeout không có đất dụng võ. Continuous batching thì đạt 220,0 token/giây và kéo TTFT trung vị xuống 0,26 giây — thấp hơn khoảng 600 lần.
Ở lưu lượng nhẹ hơn (0,25 yêu cầu/giây), timeout mới thể hiện đúng vai trò: tăng từ 50 lên 500 ms giảm số lô từ 33 xuống 32 nhưng tăng TTFT trung vị thêm 0,276 giây và hầu như không cải thiện thông lượng. Bài học: tinh chỉnh timeout chủ yếu có ý nghĩa khi hàng đợi thỉnh thoảng cạn.
Tách riêng động cơ và bộ lập lịch
Trên trace cap1536, tác giả chạy ba cấu hình, thay đổi từng thành phần một:
- HuggingFace
generateở B=32, trung bình ba lần chạy. - vLLM với static batching ở giới hạn 32.
- vLLM với continuous batching ở giới hạn 32.
Kết quả: chuyển từ HuggingFace sang vLLM nhưng giữ static batching cho 1,33 lần; bật continuous batching trên cùng động cơ đó cộng thêm 2,91 lần; tổng cộng 3,86 lần. Đáng ngạc nhiên là bộ lập lịch đóng góp nhiều hơn bản thân động cơ.
 Phân rã mức tăng tốc theo từng thành phần
Baseline HuggingFace cũng lộ ra lượng tính toán lãng phí lớn: nó sinh ra 260.864 vị trí token để tạo ra 64.908 token hữu ích, tức 75,1% là padding dư thừa. vLLM với static batching loại bỏ padding này nhưng các yêu cầu đã xong vẫn giữ chỗ trong lô, còn continuous batching xóa nốt phần lãng phí đó.
Kết quả này không mâu thuẫn với con số 23 lần của Anyscale, vốn đo OPT-13B trên A100 chứ không phải Qwen2.5-7B trên GB10. Cấu hình cũng quan trọng: nâng giới hạn tương tranh của continuous batching từ 32 lên 64 đưa thông lượng lên 415,0 token/giây, tức 5,10 lần so với baseline.
Tác giả cũng thử continuous batching gốc của HuggingFace trong transformers 5.6.0, nhưng cấu hình này không sinh được kết quả nào trong 900 giây và treo khi tắt.
Góc nhìn
Với các kỹ sư và doanh nghiệp đang tự vận hành máy chủ suy luận, kết quả này gợi ý một cách đánh giá thực dụng hơn: đừng chọn engine chỉ dựa trên con số benchmark quảng cáo, mà hãy đo hai chỉ số từ log thật của mình — độ biến thiên số token đầu ra và tần suất hàng đợi bị cạn. Nếu lưu lượng của bạn có câu trả lời dài ngắn rất khác nhau, giống chatbot tư vấn hay trợ lý hỏi đáp, thì việc bật continuous batching có thể là khoản đầu tư cấu hình rẻ nhất mang lại nhiều lợi ích nhất. Ngược lại, với các tác vụ sinh đầu ra có độ dài cố định như trích xuất thông tin hay phân loại, bộ lập lịch gần như không mang lại gì.
Cũng cần lưu ý rằng những con số trên chỉ đo trên một mô hình, một GPU GB10, với prompt cố định 512 token và độ dài đầu ra tổng hợp. Việc lợi ích có giữ nguyên trên phần cứng khác vẫn chưa được kiểm chứng, nên các nhóm kỹ thuật vẫn nên tái hiện phép đo trên chính cấu hình của mình trước khi đưa ra quyết định hạ tầng.
Bài học cốt lõi: continuous batching cải thiện hiệu suất sử dụng, không phải tốc độ tính toán thô của GPU. Khi mọi yêu cầu xong cùng lúc, nó không có gì để giành lại.
Nguồn: towardsdatascience.com (bài gốc ngày 09 tháng 11, 2026) · Quy trình biên tập