
Cục diện quyền lực của các mô hình AI mở: Trung Quốc đang dẫn đầu ra sao?
Các mô hình AI trọng số mở (open-weight) của Trung Quốc như Qwen, GLM và Kimi đang thống trị cả về năng lực lẫn mức độ sử dụng, bỏ xa các đối thủ Mỹ trên nhiều chỉ số. Bài viết phân tích bức tranh cạnh tranh Mỹ - Trung trong lĩnh vực mô hình mở, cùng những rủi ro và cơ hội đi kèm.
Cục diện quyền lực của các mô hình AI mở: Trung Quốc đang dẫn đầu ra sao?
Trong lĩnh vực mô hình AI mở (open models), cục diện đang nghiêng rõ rệt về phía Trung Quốc. Các phòng thí nghiệm AI của nước này liên tục tung ra những mô hình trọng số mở mạnh mẽ hơn đối thủ Mỹ, từ cả góc độ năng lực kỹ thuật đến mức độ được cộng đồng và doanh nghiệp sử dụng.
Bài viết này là bản mở rộng từ phần điều trần mà tác giả Nathan Lambert — một nhà nghiên cứu AI nổi tiếng — chuẩn bị cho Quốc hội Mỹ, nhằm đưa ra một bức tranh tổng thể, dễ tiếp cận hơn về tình hình mô hình mở hiện nay.
Phân biệt rõ: mô hình nguồn mở, trọng số mở và đóng
Cần làm rõ ba khái niệm thường bị nhầm lẫn:
- Mô hình đóng (closed): Chỉ truy cập được qua API hoặc sản phẩm, ví dụ như GPT-4, Claude Opus hay ChatGPT.
- Mô hình trọng số mở (open-weight): Công khai trọng số để kiểm tra và sử dụng, kèm giấy phép và mã suy luận. Đây là dạng phổ biến nhất, tiêu biểu như Llama của Meta, Qwen của Alibaba, Gemma của Google hay các mô hình DeepSeek.
- Mô hình nguồn mở thực sự (open-source): Không chỉ công khai trọng số mà còn cung cấp đầy đủ mã huấn luyện và dữ liệu huấn luyện để có thể tái tạo mô hình. Các mô hình dạng này chủ yếu đến từ các tổ chức phi lợi nhuận Mỹ như Olmo của Allen Institute for AI, Marin của OpenAthena hay Pythia của EleutherAI.
Điểm mấu chốt: mọi nhãn dán cho một mô hình — kể cả mô hình đóng hay mở — đều nằm trên một dải phổ liên tục, chứ không phải hai thái cực tách biệt.
Trung Quốc vượt Mỹ ở cả năng lực lẫn mức độ sử dụng
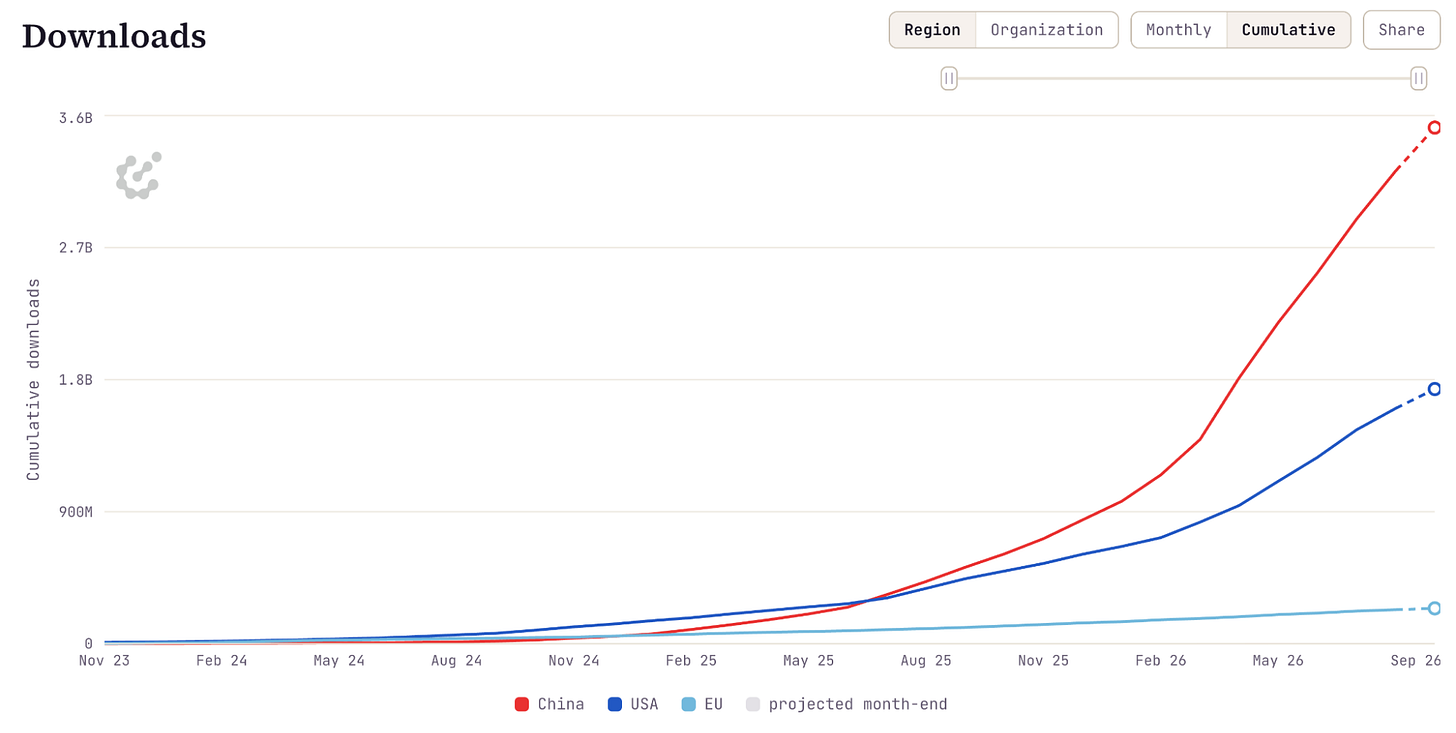
Khoảng 18 tháng trước, các mô hình trọng số mở của Trung Quốc đã vượt qua đối thủ Mỹ ở hai phương diện then chốt. Minh chứng đơn giản nhất nằm ở số lượt tải xuống trên Hugging Face: Trung Quốc chiếm ngôi đầu từ tháng 7/2025, chủ yếu nhờ sự thành công của dòng Qwen thuộc Alibaba. Khoảng cách hiện đã nới rộng lên khoảng 1,6 tỷ lượt tải, khi tổng của Trung Quốc đạt 3,2 tỷ — gấp đôi con số của Mỹ.
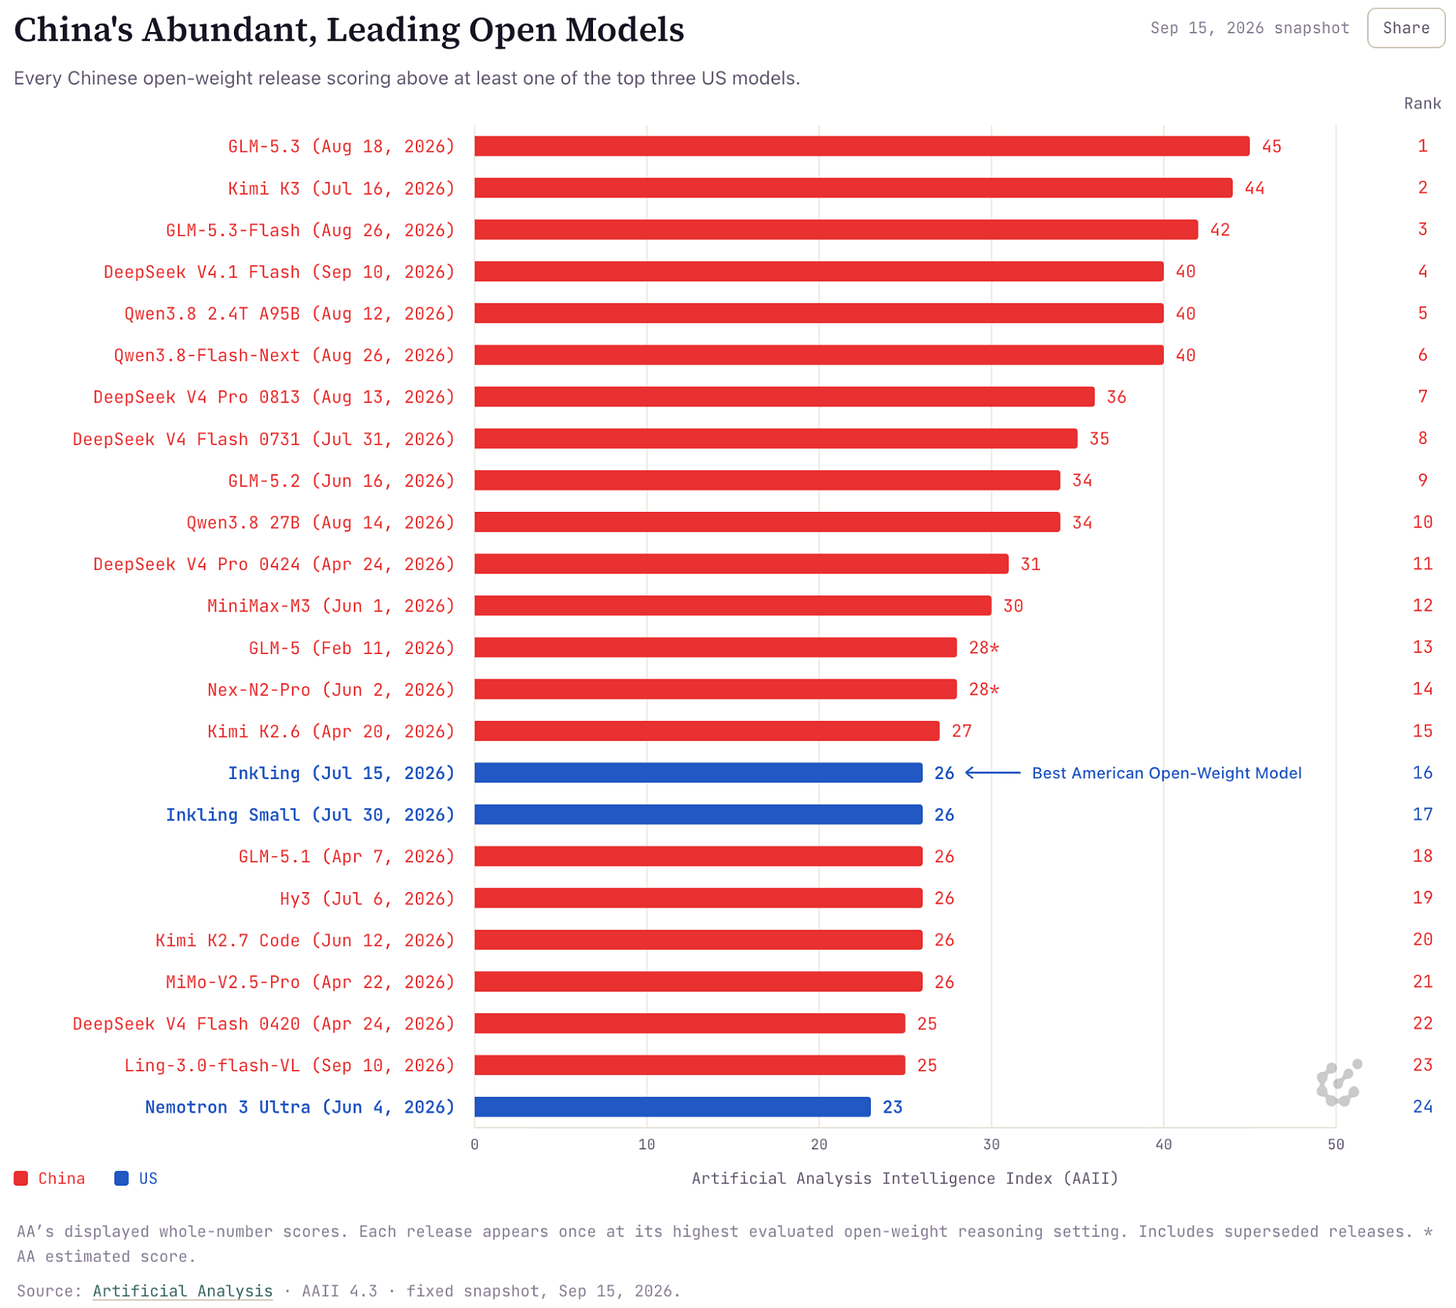
Trên các bảng xếp hạng năng lực phổ biến như Artificial Analysis Intelligence Index (AAII), khoảng cách còn rõ rệt hơn. Ba mô hình Trung Quốc dẫn đầu là GLM-5.3 và GLM-5.3-Flash của Z.ai cùng Kimi K3 của Moonshot AI, lần lượt đạt 45, 42 và 44 điểm. Trong khi đó, mô hình Mỹ mạnh nhất là Inkling và Inkling Small của Thinking Machines chỉ đạt 26 điểm, còn Nemotron 3 Ultra của Nvidia đạt 23 điểm.
Đáng chú ý, các mô hình Mỹ hàng đầu ra mắt vào tháng 6 và 7/2026 nhưng được cập nhật ít thường xuyên hơn nhiều so với đối thủ Trung Quốc. Các phòng thí nghiệm Trung Quốc thường tung ra mô hình đạt mức điểm tương đương trước Mỹ từ 2 đến 6 tháng.
 So sánh năng lực các mô hình AI mở giữa Mỹ và Trung Quốc
Tổng thể, các mô hình trọng số mở của Trung Quốc chỉ còn cách biên giới (frontier) của các mô hình đóng Mỹ khoảng 2-5 tháng, trong khi mô hình trọng số mở của Mỹ lại kém xa OpenAI và Anthropic tới 6-9 tháng. Các phòng thí nghiệm Trung Quốc bám sát nhất ở những tác vụ có nhu cầu người dùng rõ ràng như lập trình agentic, và tụt lại nhiều hơn ở các tác vụ khoa học mở như vật lý hay sinh học.
Vì sao Trung Quốc làm được điều này?
Lý do các phòng thí nghiệm Trung Quốc có thể tạo ra những mô hình mạnh mẽ dù nguồn lực ít hơn vẫn là chủ đề tranh luận mở. Có vài yếu tố kỹ thuật quan trọng:
- Tốc độ ra mắt nhanh hơn: Vì mọi phòng thí nghiệm đều tiến bộ đều đặn, nên mô hình được "chốt" và phát hành muộn hơn sẽ có điểm cao hơn trên bảng xếp hạng.
- Tập trung vào phân phối tác vụ hẹp hơn, giúp đạt điểm benchmark công khai cao hơn.
- Chưng cất (distillation): Đây là kỹ thuật huấn luyện mô hình dựa trên đầu ra của một mô hình mạnh hơn. Dù phổ biến trong ngành AI Trung Quốc, các ước tính cho thấy chưng cất chỉ giúp thu hẹp khoảng cách khoảng 1-2 tháng.
Một điểm đáng lưu ý: sang năm 2026, các phòng thí nghiệm Trung Quốc đã thay đổi thái độ với việc mua dữ liệu huấn luyện. Đầu năm, họ ưu tiên xây dựng quy trình dữ liệu nội bộ, nhưng đến mùa hè đã bắt đầu mua dữ liệu tiên tiến — các môi trường học tăng cường cho tác vụ agentic — từ cả công ty Mỹ lẫn startup Trung Quốc mới nổi.
Mô hình mở đang được dùng ở đâu?
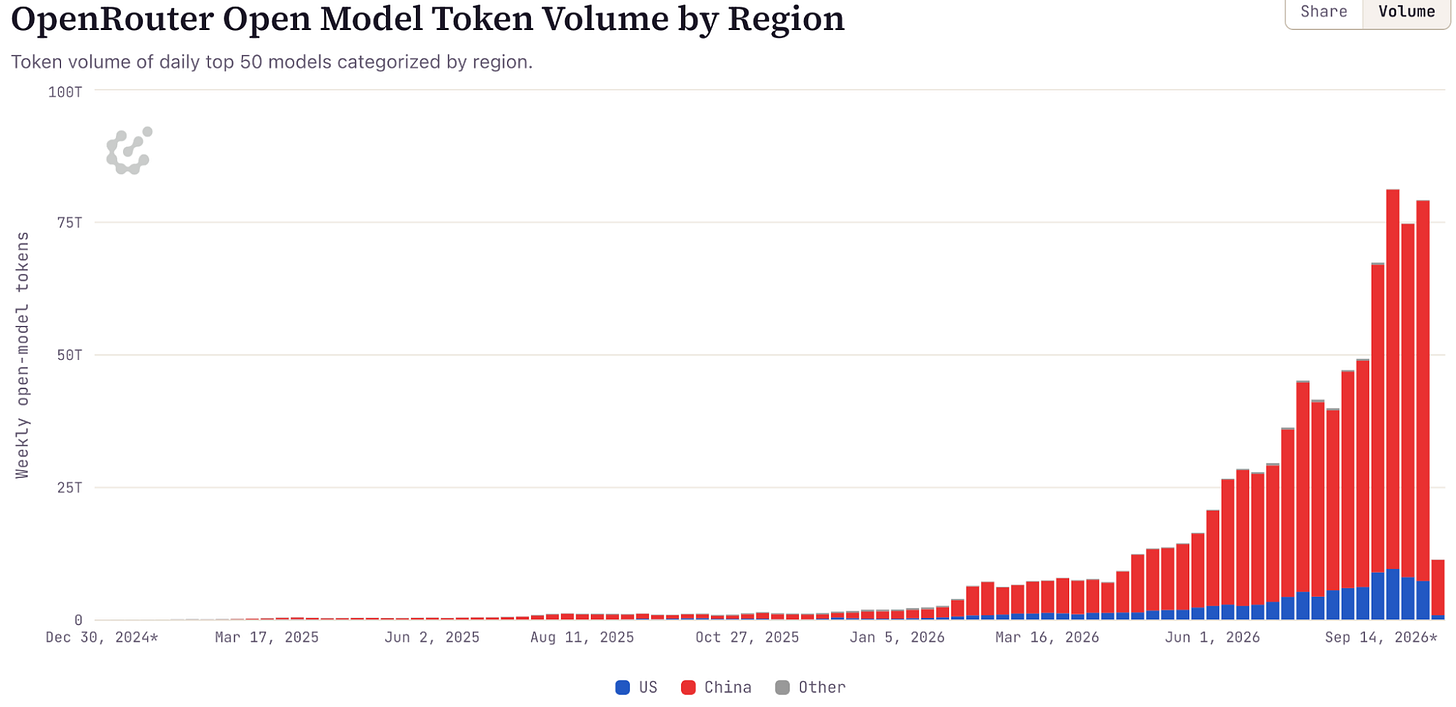
Sự quan tâm và tính khả thi kinh tế của mô hình trọng số mở đã tăng vọt trong năm 2026. Một thước đo đáng tin cậy là OpenRouter — nền tảng suy luận LLM cho phép chuyển đổi giữa các mô hình mở và đóng. Lượng tiêu thụ trên nền tảng này đã tăng từ khoảng 1.000 tỷ token/tuần (tháng 9/2025) lên khoảng 80.000 tỷ token/tuần hiện nay.
Trong khoảng thời gian đó, thị phần của các mô hình Trung Quốc tăng từ khoảng 70% lên hơn 80%. Các nền tảng khác như OpenCode cũng cho thấy tỷ lệ sử dụng mô hình Trung Quốc lên tới 95% hoặc cao hơn.
 Mức độ sử dụng mô hình mở theo quốc gia
Nhiều công ty công nghệ lớn đang xây dựng tính năng AI của mình dựa trên mô hình trọng số mở Trung Quốc, như Harvey (agent pháp lý), Cursor (agent lập trình), DoorDash dùng Kimi, Airbnb dùng Qwen hay Perplexity dùng DeepSeek. Xu hướng này còn lan rộng trong giới startup Silicon Valley, khi nhiều công ty trẻ chọn mô hình Trung Quốc để có lựa chọn linh hoạt, chi phí thấp.
Nghiên cứu học thuật cũng nghiêng về Qwen
Phần lớn nghiên cứu học thuật hiện nay được thực hiện trên dòng mô hình Qwen của Alibaba. Khảo sát toàn bộ bài báo trong 5 hạng mục ML phổ biến nhất của arXiv (cs.AI, cs.CL, cs.CV, cs.LG, stat.ML) cho thấy:
- Tháng 1/2023: chỉ 2% bài báo nhắc đến bất kỳ mô hình mở nào.
- Tháng 9/2026: con số này đã lên tới 50%.
- Mùa thu 2024, thời kỳ đỉnh cao của Llama: khoảng 23% bài báo nhắc Llama, 7,5% nhắc Qwen.
- Hiện nay: Llama được nhắc trong khoảng 21% bài báo, nhưng Qwen đã vươn lên 30%. Tổng cộng, mô hình trọng số mở Trung Quốc được nhắc trong hơn 40% bài báo, so với 30% của Mỹ.
Điều này cho thấy Mỹ còn nhiều việc phải làm để lấy lại vị thế trung tâm nghiên cứu AI trong kỷ nguyên mô hình trọng số mở. Tuy vậy vẫn có tín hiệu lạc quan: các mô hình Mỹ có năng lực tương đương lại được chấp nhận với tốc độ cao hơn. Gpt-oss của OpenAI trở thành một trong những mô hình trọng số mở được dùng nhiều nhất mọi thời đại, còn Gemma 4 của Google cũng đạt mức độ chấp nhận tương tự các mô hình nhỏ phổ biến nhất của Qwen.
 Tỷ lệ đề cập mô hình mở trong các bài báo nghiên cứu AI
Rủi ro và bất định về quy định
Một thách thức mang tính cấu trúc của mô hình trọng số mở là rất khó ngăn các phần mềm mở tiếp cận kẻ xấu. Nếu ai đó tìm cách hạn chế quyền truy cập vào những mô hình mạnh nhất của Trung Quốc vì lo ngại rủi ro, bên bị ảnh hưởng nặng nhất lại chính là doanh nghiệp Mỹ.
Một ví dụ điển hình: Hugging Face từng dùng một mô hình trọng số mở Trung Quốc để điều tra một cuộc tấn công mạng, bởi các mô hình đóng từ chối trả lời yêu cầu của họ. Do đó, quản lý rủi ro từ mô hình trọng số mở thường xoay quanh việc chuẩn bị ở cấp hệ sinh thái, chứ không đơn thuần là cấm đoán.
Mô hình mở đang trở thành công cụ thiết yếu để phổ biến AI. Con đường tốt nhất để ứng phó với cả rủi ro lẫn sự phụ thuộc vào mô hình do Trung Quốc xây dựng là tiếp tục thúc đẩy đầu tư vào mô hình mở ở Mỹ.
Kết luận
Năm 2026 chứng kiến các phòng thí nghiệm Trung Quốc duy trì vị thế dẫn đầu hệ sinh thái AI trọng số mở, đúng thời điểm các mô hình mở đã vượt qua một điểm uốn về khả thi kinh tế. Mô hình mở đang trở thành nền tảng cho toàn bộ phần còn lại của thế giới bên ngoài một vài phòng thí nghiệm AI tiên phong thực sự.
Với tương lai đó đến gần, chúng ta cần khiêm tốn về con đường chính xác mà mô hình mở sẽ đi. Khi chuyên môn huấn luyện ML đã trải rộng khắp hàng chục tổ chức và hàng nghìn người chỉ cách biên giới năng lực chưa đầy một năm, việc mô hình mở vượt qua các ngưỡng hiệu năng mở ra quy trình làm việc mới chỉ còn là vấn đề thời gian — chứ không phải có hay không.
Đối với Việt Nam, xu hướng này mở ra cả cơ hội lẫn thách thức. Việc chủ động nghiên cứu, ứng dụng và phát triển dựa trên các mô hình trọng số mở — đặc biệt là dòng Qwen và các mô hình nhỏ gọn, chi phí thấp — có thể giúp doanh nghiệp và nhà phát triển trong nước tiếp cận năng lực AI tiên tiến với chi phí hợp lý, thay vì phụ thuộc hoàn toàn vào các API mô hình đóng đắt đỏ.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Robot thay lốp ô tô đầu tiên của PitPro chính thức đi vào hoạt động tại Canada
23 tháng 9, 2026