Cuộc cách mạng phần cứng suy luận AI năm 2026: Khi suy luận lên ngôi
Năm 2026 đánh dấu bước ngoặt khi suy luận AI (inference) thay thế huấn luyện mô hình trở thành tâm điểm của ngành. Nhu cầu suy luận bùng nổ đang thúc đẩy các ông lớn công nghệ như Nvidia, Amazon và OpenAI tìm đến những kiến trúc phần cứng hoàn toàn mới, tập trung vào băng thông bộ nhớ thay vì sức mạnh tính toán thuần túy.
Cuộc cách mạng phần cứng suy luận AI năm 2026: Khi suy luận lên ngôi
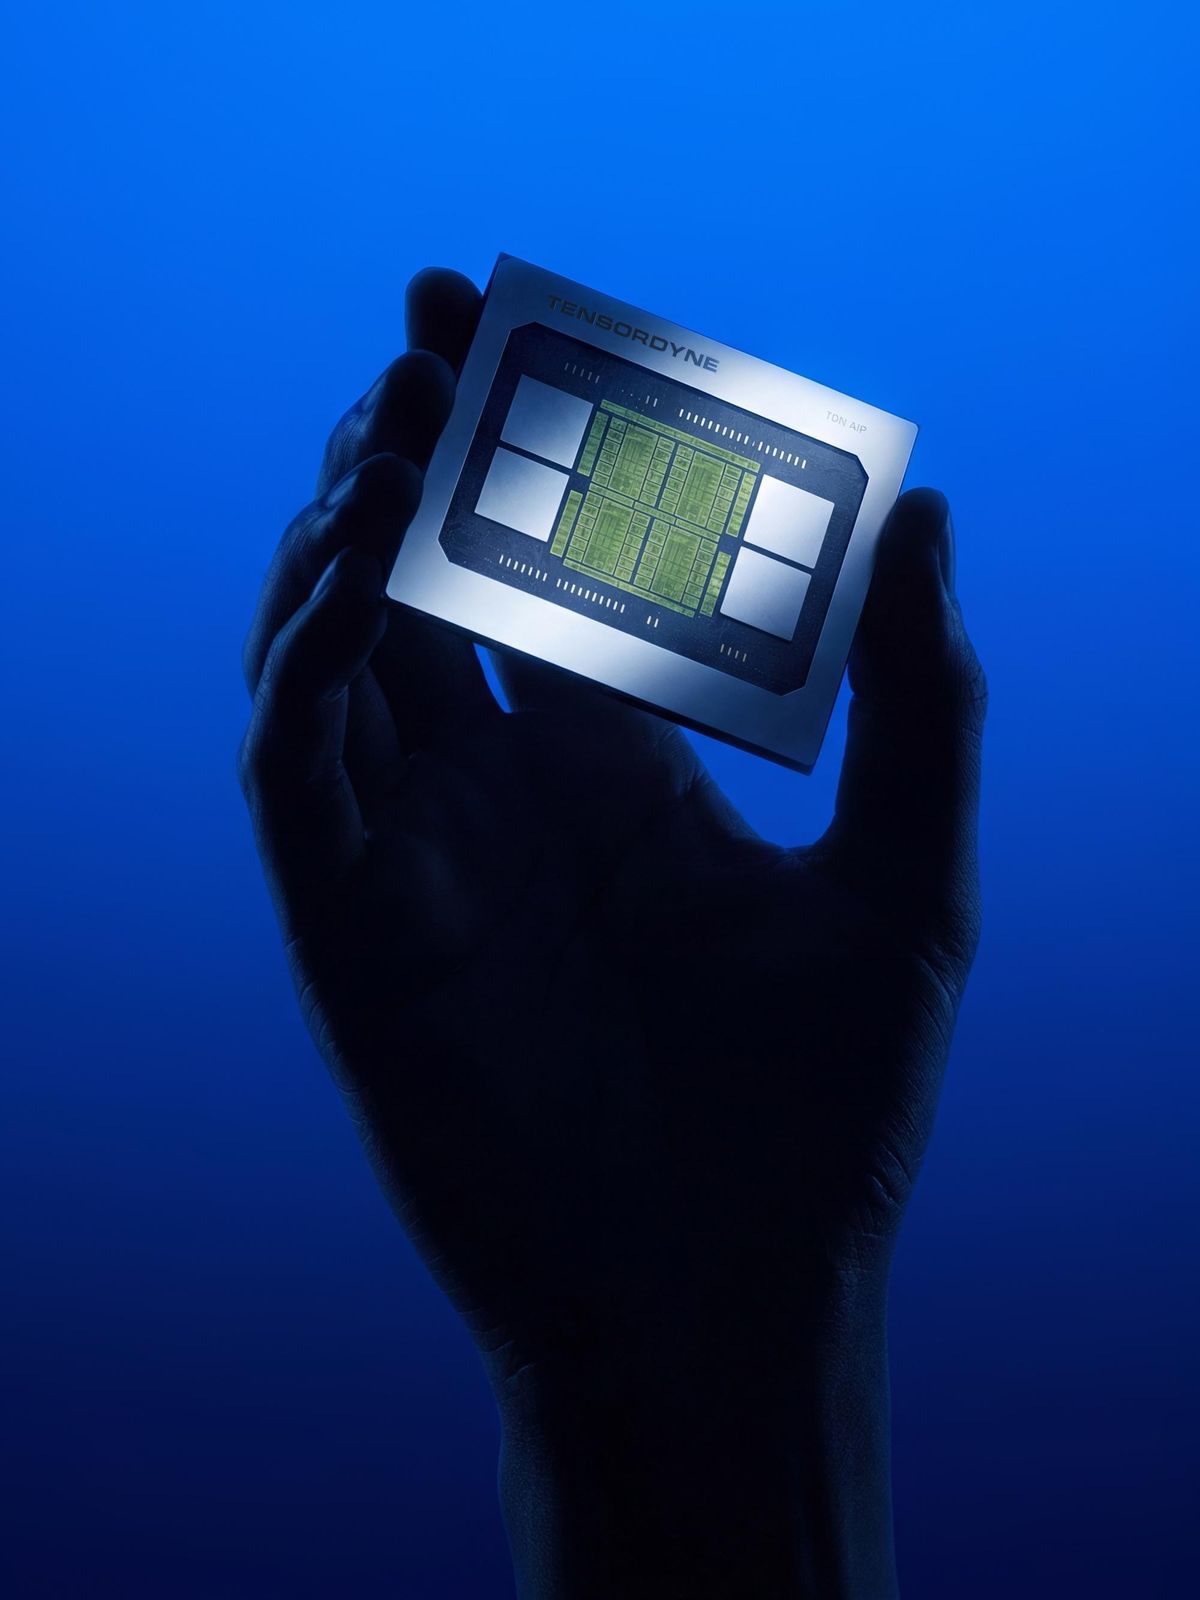 Chip máy tính phát sáng trên nền xanh
Trong nhiều năm, câu chuyện về AI chủ yếu xoay quanh việc huấn luyện những mô hình ngày càng lớn. Nhưng đến năm 2026, suy luận (inference) — quá trình sử dụng mô hình đã huấn luyện để tạo mã, viết văn hay tạo hình ảnh — đã trở thành tâm điểm. Sự thay đổi này đang buộc các nhà sản xuất phần cứng phải xoay trục sang một thế hệ kiến trúc chip hoàn toàn khác, nơi băng thông bộ nhớ quan trọng hơn cả sức mạnh tính toán.
Suy luận AI khác gì so với huấn luyện AI?
Một mô hình ngôn ngữ lớn (LLM) chưa huấn luyện giống như một mớ thẻ Scrabble xáo trộn trên bàn — có đủ mọi nguyên liệu nhưng chẳng thành hình gì cả. Huấn luyện mô hình là quá trình sắp xếp mớ hỗn độn đó thông qua một trò chơi dự đoán từ tiếp theo diễn ra ở quy mô hàng tỷ đoạn văn bản.
Quá trình này đòi hỏi sức mạnh tính toán cực lớn, với lan truyền ngược (backpropagation) liên tục tính toán cách điều chỉnh hàng tỷ đến hàng nghìn tỷ tham số. Đây chính là lý do các ông lớn công nghệ đang xây dựng những trung tâm dữ liệu lớn chưa từng thấy.
Suy luận lại đối mặt với một thách thức hoàn toàn khác. Theo Sudeep Bhoja, nhà sáng lập kiêm CTO của công ty phần cứng suy luận d-Matrix, các mô hình có bản chất tự hồi quy (autoregressive) — đầu ra tiếp theo phụ thuộc vào đầu ra trước đó. "Để tạo token tiếp theo, bạn phải đọc toàn bộ trọng số và toàn bộ ngữ cảnh từ token trước," Bhoja giải thích.
Quá trình suy luận chia làm hai giai đoạn:
- Prefill (tiền xử lý): mô hình đọc toàn bộ prompt, xử lý song song tất cả token. Đây là lý do GPU trở thành bộ tăng tốc AI thống trị, vì kiến trúc GPU vốn dĩ song song hóa cao.
- Decode (giải mã): mô hình tạo phản hồi từng token một. Mỗi bước đòi hỏi đọc toàn bộ mô hình từ bộ nhớ, có thể lên tới hàng trăm gigabyte tham số.
Chính giai đoạn decode này bộc lộ điểm yếu chí mạng: băng thông bộ nhớ. Các nhà nghiên cứu phát hiện GPU Nvidia H100 khi chạy các mô hình mã nguồn mở thường ngồi không từ 50 đến 80% thời gian, chỉ để chờ dữ liệu.
"Với cách tiếp cận dựa trên GPU, bạn cấp thừa năng lực tính toán nhưng lại đói bộ nhớ. Đó là động lực cho việc mở rộng bộ nhớ quy mô lớn," Shahriar Rabii, cựu lãnh đạo kỹ thuật silicon tại Meta, nhận định.
Những lý do đằng sau sự bùng nổ nhu cầu suy luận
Sự dịch chuyển này có nguyên nhân rất đơn giản: LLM đang trở nên hữu dụng, nên người ta sử dụng chúng nhiều hơn. Thêm vào đó, nhiều mô hình hiện nay là mô hình suy luận (reasoning models), chạy suy luận không chỉ một lần mà nhiều lần thông qua quá trình tự nhắc lại gọi là chuỗi tư duy (chain of thought).
Các mô hình có mức độ suy luận cao có thể tạo ra lượng văn bản gấp 20 lần so với mô hình suy luận thấp hoặc không suy luận. Sự trỗi dậy của AI dạng tác tử (agentic AI) còn khiến suy luận chạy không chỉ theo thời gian thực mà còn hoạt động tự chủ suốt ngày đêm.
"Giống như huấn luyện đã là chuyện cũ rồi vậy," Matt Kimball, chuyên gia phân tích trung tâm dữ liệu tại Moor Insights & Strategy, nói. "Tất cả những gì các giám đốc thông tin muốn bàn đều là về suy luận."
Những liên minh bất ngờ giữa các ông lớn công nghệ
Nhu cầu suy luận bùng nổ đã dẫn đến những liên minh không ngờ tới:
- OpenAI và Amazon triển khai chip Cerebras cỡ cái đĩa ăn tối, dù Amazon có chip Trainium của riêng mình
- Nvidia mua lại nhân tài và tài sản trí tuệ từ startup Groq trong thương vụ gây tranh cãi trị giá 20 tỷ USD
- Anthropic trả cho SpaceXAI hơn một tỷ USD mỗi tháng để thuê năng lực tính toán dự phòng
Kiến trúc chip xếp tầng của d-Matrix
Hai hướng tiếp cận bộ nhớ đối lập
Để giải quyết nút thắt bộ nhớ, các startup theo đuổi hai chiến lược trái ngược nhau:
d-Matrix chọn cách xếp tầng bộ nhớ và tính toán. Thay vì xếp chồng bộ nhớ như HBM truyền thống, họ đặt trực tiếp khuôn logic tính toán lên trên khuôn DRAM. Bhoja cho biết cách này rút ngắn quãng đường dữ liệu phải di chuyển xuống "micromet thay vì milimet".
Majestic Labs lại đi theo hướng ngược lại: không cố rút ngắn quãng đường, mà cải thiện giao diện bộ nhớ để hỗ trợ dây dẫn dài hơn trong khi vẫn giữ băng thông cao. Công ty tuyên bố giao diện bộ nhớ của họ có thể truyền bit xa tới khoảng một mét, cho phép một rack server hỗ trợ tới 128 terabyte DRAM — vượt trội so với rack GB300 NVL72 của Nvidia với khoảng 20 TB HBM3E.
Điểm chung của cả hai: họ đều dùng DRAM phổ thông thay vì HBM. Theo chuyên gia phân tích bộ nhớ Jim Handy, HBM đắt gấp hai đến ba lần DRAM.
Chip kết hợp để suy luận nhanh hơn
Các ông lớn Nvidia và Amazon đang theo đuổi chiến lược "tất cả chip cùng tham chiến":
- Nvidia dùng GPU Vera Rubin cho giai đoạn prefill và chip Groq 3 LPU cho giai đoạn decode. LPU có ít sức mạnh tính toán thô hơn GPU nhưng sở hữu 500 megabyte SRAM trên khuôn, mang lại "băng thông bộ nhớ gấp bảy lần GPU", theo Ian Buck, phó chủ tịch Nvidia.
- AWS kết hợp chip Trainium với Wafer-Scale Engine 3 (WSE-3) của Cerebras. WSE-3 biến cả một tấm wafer silicon thành một chip duy nhất với hơn 4 nghìn tỷ transistor, khắc trực tiếp 44 gigabyte SRAM vào mỗi wafer.
Học cách làm nhiều hơn với ít bit hơn
Song song với cải tiến phần cứng, các nhà nghiên cứu đang tối ưu phần mềm LLM để tận dụng tốt nhất bộ nhớ và năng lực tính toán. Kỹ thuật then chốt là lượng tử hóa (quantization) — chuyển đổi mô hình từ định dạng số chính xác cao sang thấp hơn.
"Bạn thích một mô hình cỡ x chạy ở 8-bit, hay một mô hình cỡ gấp đôi chạy ở 4-bit? Cách tiếp cận 4-bit cho bạn số synapse gấp đôi," Gilles Backhus, đồng sáng lập Tensordyne, chia sẻ.
Nvidia gần đây tạo định dạng số 4-bit mới NVFP4. Khi lượng tử hóa DeepSeek-R1 từ FP8 xuống NVFP4, điểm số trên bảy benchmark lớn giảm chưa đến một phần trăm trong khi hiệu năng tăng gấp ba lần.
Những ý tưởng phi truyền thống
Một số startup đang theo đuổi những hướng đi táo bạo hơn:
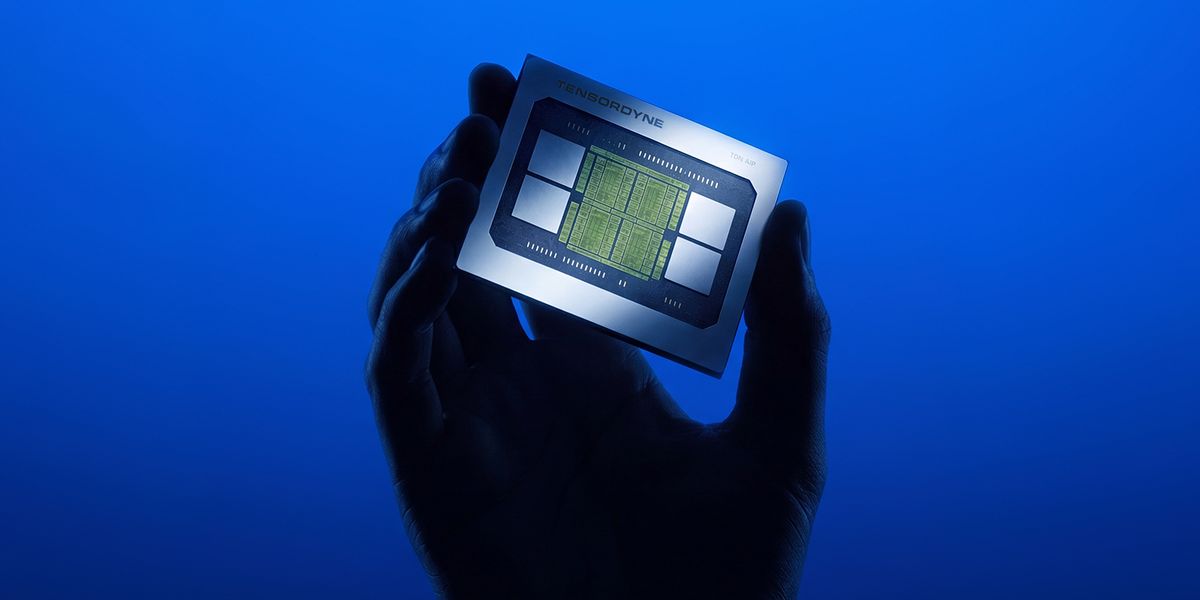
- Tensordyne dùng hệ thống số logarit, khai thác tính chất log(A×B) = log(A) + log(B), cho phép chip cộng thay vì nhân — tiết kiệm năng lượng và diện tích. Chip Napier của họ được cho là đạt 1.300 token/giây/người dùng với mức tiêu thụ điện dưới một phần mười so với phần cứng Nvidia tương đương.
- Etched thiết kế bộ tăng tốc AI dịch trực tiếp kiến trúc transformer vào silicon. Chip Sohu của họ có thể chạy mô hình Llama 70B của Meta ở tốc độ 500.000 token/giây, dù kém linh hoạt hơn.
Tương lai của suy luận AI
Sự đa dạng của các hướng tiếp cận đặt ra câu hỏi: cái nào sẽ thắng? Nhưng theo các chuyên gia, đó có lẽ không phải câu hỏi đúng. Nhu cầu AI hiện đang vô độ, và Kimball tin rằng suy luận có thể thúc đẩy nhu cầu phần cứng AI trong dài hạn.
"Bạn có thể thêm một triệu tác tử vào tổ chức của mình. Những thứ này làm việc 24 giờ mỗi ngày; chúng không về nhà lúc năm giờ chiều như chúng ta," ông nói.
Nếu suy luận AI vẫn hấp dẫn như Kimball dự đoán, quá trình tiến hóa có thể sẽ theo quỹ đạo tương tự CPU — không cải thiện theo một trục duy nhất mà trên nhiều mặt trận cùng lúc. Vài thập kỷ nữa, lịch sử đổi mới suy luận AI có thể sẽ cho thấy chiều sâu tương tự như lịch sử của máy tính cá nhân ngày nay.
Đối với người dùng Việt Nam, làn sóng này có ý nghĩa thiết thực: khi chi phí suy luận giảm nhờ những đổi mới phần cứng, các dịch vụ AI sẽ trở nên rẻ hơn, nhanh hơn và dễ tiếp cận hơn — từ trợ lý ảo, công cụ lập trình đến các ứng dụng doanh nghiệp trong nước.