
DoubleML chưa đủ: cách ước lượng đường cong liều – đáp ứng
Bài viết mô phỏng giới hạn của DoubleML khi can thiệp là biến liên tục, rồi so sánh với ước lượng doubly robust của Kennedy, kèm gộp một phần theo 200 cửa hàng và cách xử lý bằng difference-in-differences khi có yếu tố gây nhiễu ẩn.
Không phải can thiệp nào cũng chỉ có hai trạng thái. Chi phí marketing, giá bán, mức giảm giá, số thông báo ứng dụng hay thời gian phản hồi chăm sóc khách hàng đều là biến liên tục. Câu hỏi đặt ra không còn là "can thiệp này có hiệu quả không" mà là "liều bao nhiêu thì đúng".
Khi liều do chính đơn vị được quan sát tự chọn thay vì được phân ngẫu nhiên, lựa chọn quen thuộc là double machine learning (Chernozhukov và cộng sự, 2018), thường dùng mô hình bán tuyến tính trong thư viện DoubleML (Bach và cộng sự, 2022). Ryan O'Sullivan, chuyên gia dữ liệu tại Towards Data Science, đã chạy mô phỏng để chỉ ra ba điểm yếu của cách làm này và một ước lượng thay thế.
 Sơ đồ so sánh mô hình tuyến tính và đường cong liều – đáp ứng
Ba giới hạn của mô hình bán tuyến tính
Thứ nhất, nó chỉ trả về một con số. Hiệu ứng bị giả định là tuyến tính, nên một đường cong tăng rồi giảm hay một đường cong bão hòa vẫn quy về một độ dốc duy nhất.
Thứ hai, điểm ước lượng mặc định không doubly robust. Nếu mô hình dự đoán liều bị sai, kết quả lệch, dù mô hình dự đoán kết quả tốt đến đâu.
Thứ ba, nó chỉ cho một đáp án cho toàn bộ quần thể. Cần đường cong riêng cho 200 nhóm thì phải lặp lại từng nhóm, và các nhóm nhỏ sẽ cho độ dốc rất nhiễu.
Ước lượng doubly robust cho cả đường cong
Cách thay thế là ước lượng liều – đáp ứng doubly robust của Kennedy và cộng sự (2017), gồm ba bước.
- Bước 1: Huấn luyện chéo hai mô hình phụ trợ: mô hình kết quả μ(x, a) = E[Y | X, A], lần này nhận cả liều làm đầu vào, và điểm xu hướng tổng quát (GPS, Hirano và Imbens 2004) là mật độ của liều khi biết X.
- Bước 2: Tạo pseudo-outcome, một con số cho mỗi dòng dữ liệu, sao cho trung bình của nó tại mỗi liều chính là đường cong nhân quả.
- Bước 3: Làm mịn bằng spline có phạt (Eilers và Marx 1996), chia sẻ thông tin giữa các nhóm trong một hệ thống phân cấp.
Bước 2 là nơi tạo ra tính bền vững. Công thức bắt đầu từ dự đoán của mô hình kết quả tại liều a, lấy trung bình trên toàn bộ đơn vị, rồi cộng thêm phần hiệu chỉnh từ phần dư của những đơn vị thực sự nhận liều gần a, có trọng số theo mức độ bất thường của liều đó. Nếu mô hình kết quả đúng, phần hiệu chỉnh chỉ là nhiễu. Nếu nó sai, phần hiệu chỉnh bù lại sai số, miễn là mô hình dự đoán liều đúng. Chỉ cần một trong hai mô hình đúng, đó chính là doubly robust.
Cụ thể, ξ = (Y − μ(X, A)) · ϖ(A)/π(A | X) + m(A). Với can thiệp nhị phân, đây chính là ước lượng AIPW đứng sau DoubleMLIRM của DoubleML.
Mô phỏng 1: một độ dốc không thể tả nổi đường cong
Dữ liệu mô phỏng gồm 4.000 đơn vị và 5 biến hiệp biến. Ba biến vừa tác động lên liều vừa tác động lên kết quả, nên gây nhiễu. Biến thứ tư làm mức độ biến thiên của liều khác nhau giữa các đơn vị. Biến thứ năm không có tác dụng gì.
Hiệu ứng thật là đường cong ngược chữ U ở một bộ dữ liệu và đường cong bão hòa ở bộ còn lại. Hai phương pháp dùng chung một mô hình học cho mọi mô hình phụ trợ: một tổ hợp gồm gradient boosting và hồi quy spline.
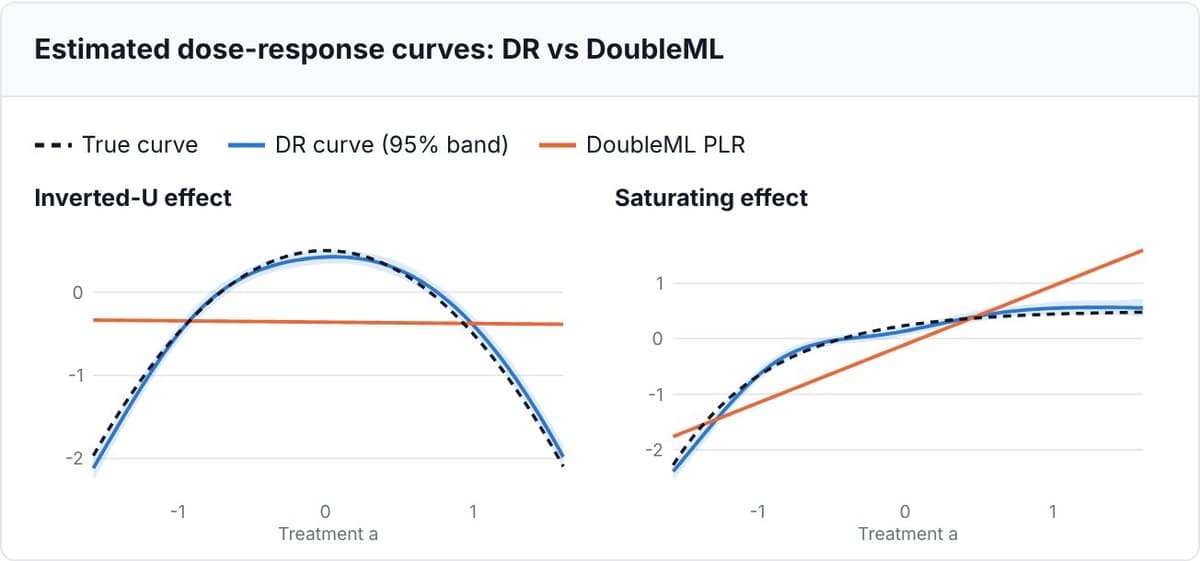
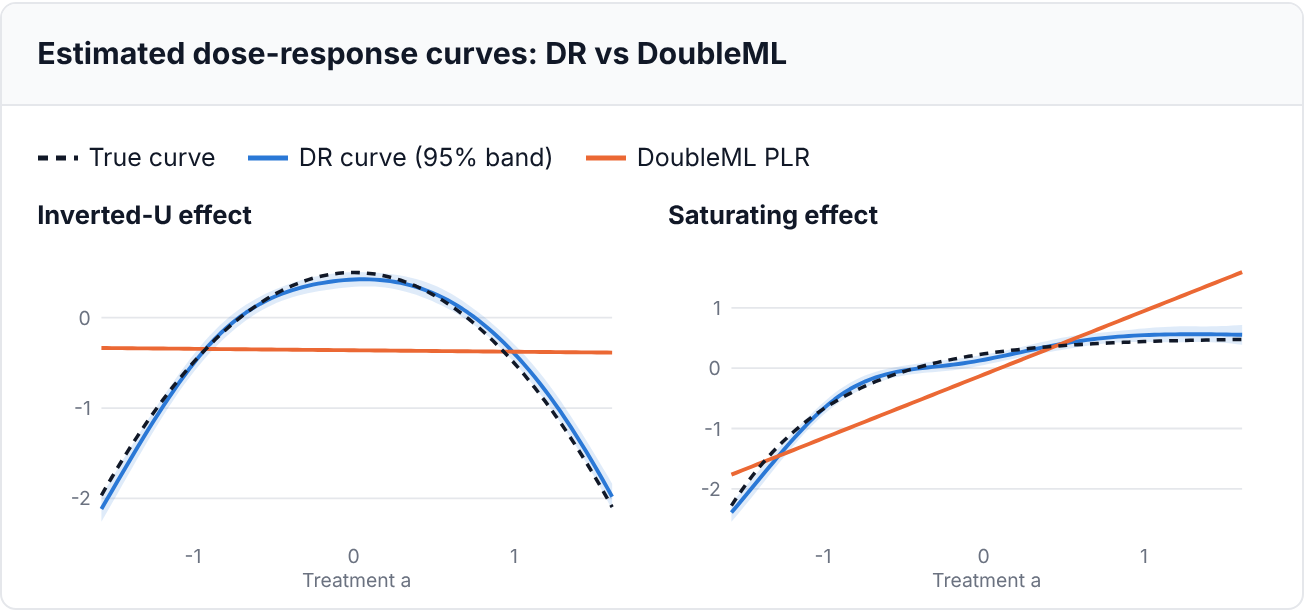
Đường cong doubly robust bám theo cả hai hình dạng. Đường thẳng của DoubleML chỉ biết nghiêng. Trên đường ngược chữ U, độ dốc của nó gần bằng 0, đọc riêng sẽ tưởng liều không quan trọng. Trên đường bão hòa, nó gán cùng một mức lợi nhuận cho mọi đơn vị, đánh giá thấp ở liều nhỏ và cao ở liều lớn.
Mô phỏng 2: khi mô hình phụ trợ bị sai
Cả hai mô hình phụ trợ đều chỉ là xấp xỉ. Mô hình dự đoán liều đặc biệt dễ sai, vì nó phải mô tả toàn bộ phạm vi liều mà mỗi đơn vị có thể nhận. Liều thường do các quy tắc kinh doanh không thành văn quyết định: bậc giá, ngân sách chia theo doanh thu năm trước, mức trần thông báo.
Mô phỏng dùng 3.000 đơn vị và 50 biến hiệp biến: 4 biến có tác động phi tuyến mạnh lên cả liều lẫn kết quả, 46 biến yếu. Mỗi bộ dữ liệu có một phiên bản mô hình kết quả đúng và một phiên bản sai, tương tự với mô hình liều.
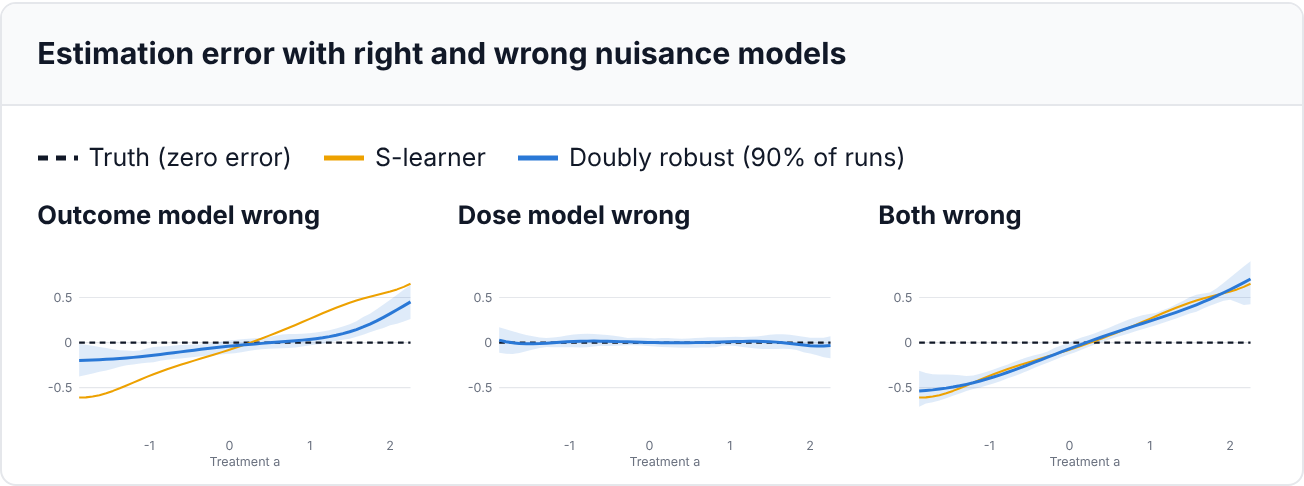
Kết quả: khi mô hình kết quả sai, S-learner lệch khỏi đường cong thật trong khi doubly robust vẫn sát. Khi mô hình liều sai, doubly robust vẫn sát. Khi cả hai cùng sai, nó cũng lệch. Phần sai số còn lại tập trung ở hai đầu dải liều, nơi mô hình sai nhiều nhất và ít đơn vị nhất để hiệu chỉnh.
Mô phỏng 3: chọn mô hình học nào
Dữ liệu thực tế hiếm khi chỉ có vài biến hiệp biến. Bảng khách hàng có hàng chục đặc trưng: thâm niên, lịch sử chi tiêu, sản phẩm đang dùng, các lần liên hệ trước. Không biết biến nào quan trọng và quan trọng ra sao, nên cả hai mô hình phụ trợ đều trở thành mô hình học linh hoạt có điều chuẩn.
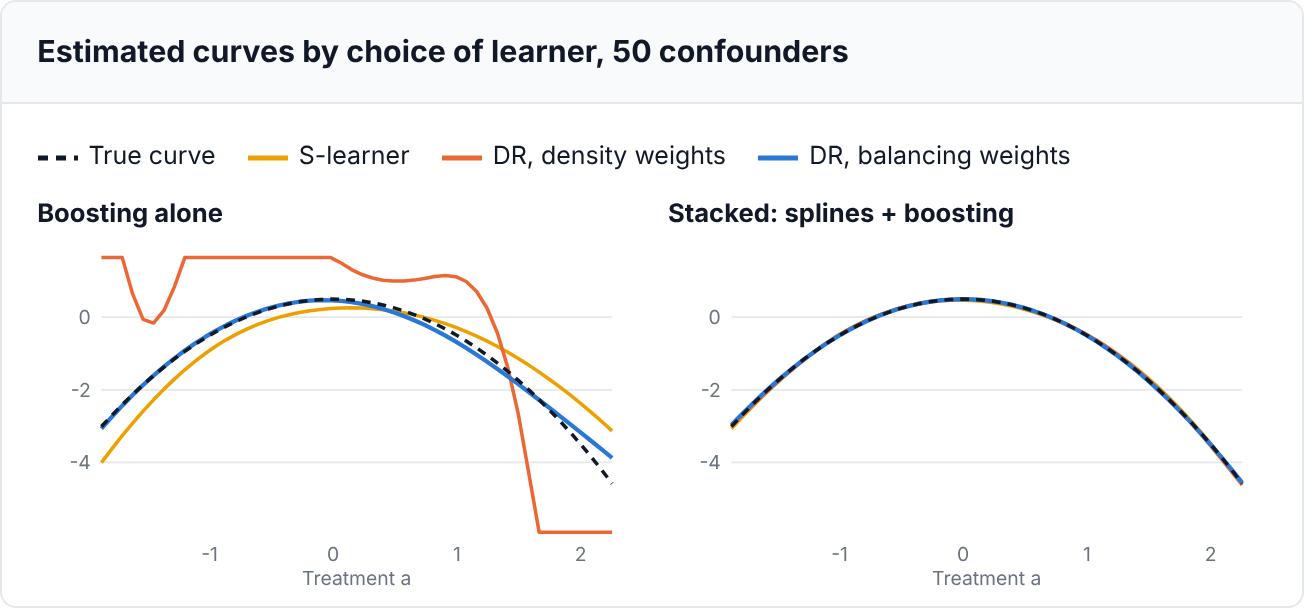
Lựa chọn mô hình học làm thay đổi kết quả rất nhiều. Chỉ dùng boosting thì đường cong của S-learner quá phẳng, vì cây tăng cường co nhỏ hiệu ứng của liều. Trọng số mật độ sai lệch nặng vì mô hình liều cho một số liều xác suất gần bằng 0.
Dùng trọng số cân bằng (balancing weights, Tübbicke 2022), vốn không cần mật độ, cho kết quả tốt nhất trong trường hợp này. Khi dùng tổ hợp boosting và spline, cả ba ước lượng đều khôi phục được đường cong, vì hồi quy spline nắm được quan hệ trơn mà cây chỉ xấp xỉ bằng bậc thang.
 So sánh sai số giữa các ước lượng
Mô phỏng 4: nhiều đường cong và gộp một phần
Quyết định hiếm khi chỉ cần một đường cong cho toàn doanh nghiệp. Nhóm định giá đặt chiết khấu theo danh mục, nhóm marketing đặt ngân sách theo quốc gia và kênh, nhóm CRM đặt tần suất theo phân khúc. Các nhóm lồng nhau và có đuôi dài: vài nhóm lớn nhiều dữ liệu, nhiều nhóm nhỏ rất ít dữ liệu.
Có ba cách xử lý: gộp hoàn toàn (một đường cong chung, ổn định nhưng bỏ qua khác biệt thật), không gộp (mỗi nhóm một đường cong, cửa hàng có 12 khách bị đối xử như có 500 khách), và gộp một phần (Gelman và Hill 2007).
Gộp một phần nằm ở giữa: đường cong của mỗi cửa hàng bằng đường cong toàn cục cộng độ lệch của khu vực, cộng độ lệch của cửa hàng. Độ lệch của cửa hàng nhỏ bị kéo về khu vực, độ lệch của khu vực bị kéo về đường toàn cục. Cửa hàng lớn đủ dữ liệu để vượt qua lực kéo đó. Mức kéo mạnh hay yếu được chọn từ chính dữ liệu.
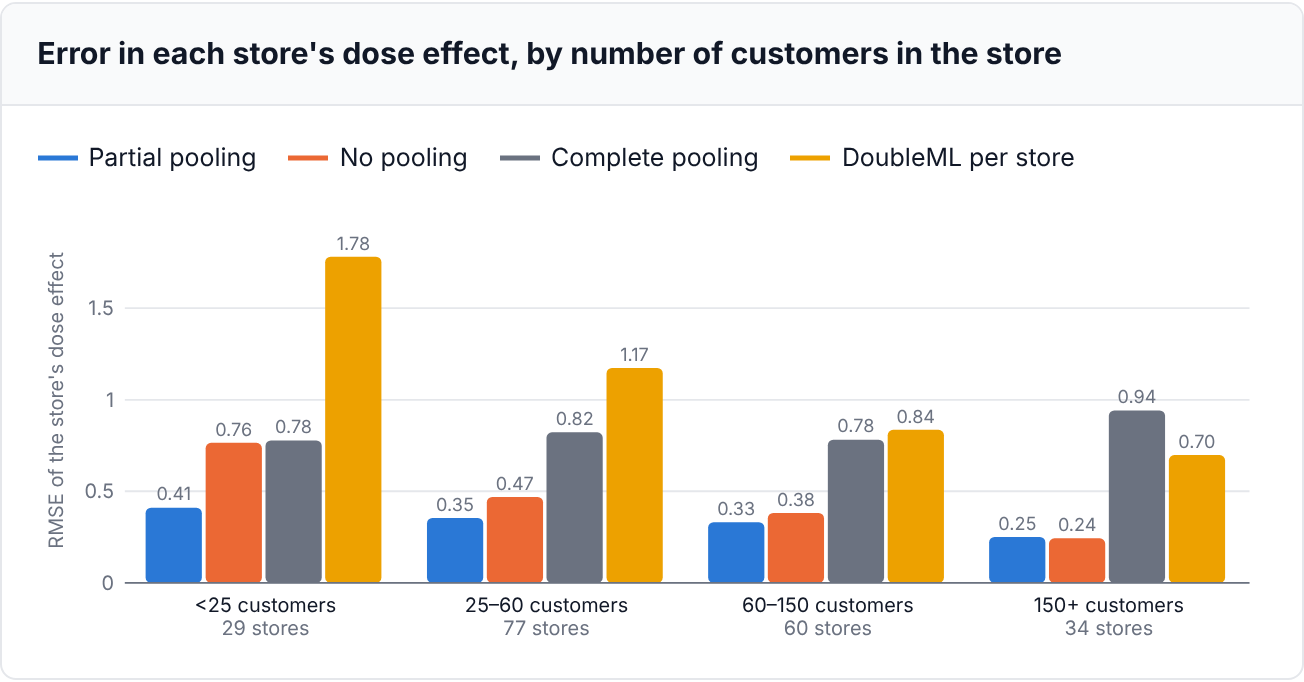
Mô phỏng dùng 200 cửa hàng trong 8 khu vực, mỗi dòng là một khách hàng nhận chiết khấu cá nhân hóa. Số khách mỗi cửa hàng từ 8 đến vài trăm. Mỗi cửa hàng có một mức nền riêng, vừa đẩy liều vừa đẩy kết quả, tạo nhiễu ở cấp cửa hàng.
Không gộp thì sai số tăng khi cửa hàng nhỏ đi. DoubleML chạy riêng từng cửa hàng sai số cao nhất ở gần hết các nhóm, kể cả nhóm lớn vẫn quanh mức 0,7 vì đường thẳng không bám được đường cong. Gộp hoàn toàn vẫn sai cao ngay cả ở cửa hàng lớn. Gộp một phần sai số thấp nhất ở cửa hàng nhỏ và ngang bằng không gộp ở cửa hàng lớn.
So sánh với các gói có sẵn
Hai gói đã ước lượng được một đường cong doubly robust duy nhất từ pseudo-outcome ở trên: npcausal (R), do chính Kennedy viết, dùng SuperLearner và tự chọn mức làm mịn; và causal-curve (Python), dùng gradient boosting với mức làm mịn cố định.
Cả hai đều không huấn luyện chéo mô hình phụ trợ và không xử lý nhóm. Gói drcurves viết cho bài này làm được cả hai.
Trên dữ liệu 5 và 50 biến hiệp biến, drcurves chính xác nhất và khoảng cách nới rộng khi số biến tăng. Trên dữ liệu khó hơn, drcurves vẫn nhỉnh hơn npcausal. Với riêng drcurves, boosting đơn thuần kèm trọng số cân bằng còn chính xác hơn (0,17 so với 0,24), nhưng boosting đơn thuần kèm trọng số mật độ thì hỏng nặng (2,2). Không có mô hình học nào thắng ở mọi nơi.
causal-curve thấp nhất ở mọi cấu hình, và khoảng tin cậy của nó rộng gấp 10 đến 60 lần các gói khác, nên luôn chứa giá trị thật nhưng cho rất ít thông tin.
Khi không đo được yếu tố gây nhiễu
Mọi phân tích trên đều giả định đã đo được các yếu tố gây nhiễu. Thực tế thường không: mức độ phức tạp của một khách hàng, văn hóa của một nhóm, tay nghề của một quản lý cửa hàng. Đây là những đặc điểm ổn định, vừa đẩy liều vừa đẩy kết quả, và không bao giờ xuất hiện trong dữ liệu.
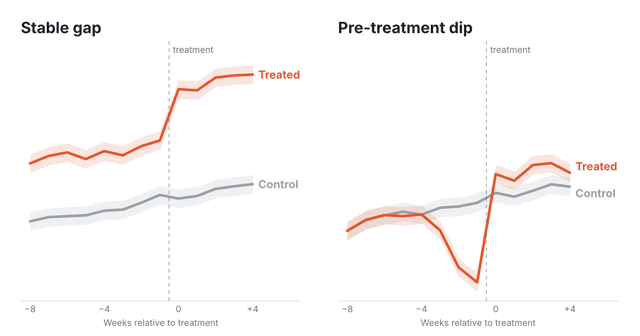
Nếu có dữ liệu kết quả trước khi liều thay đổi và đặc điểm ẩn đó ổn định theo thời gian, difference-in-differences (DiD) loại bỏ được nó: chạy cùng phương pháp trên mức thay đổi của kết quả thay vì mức tuyệt đối. Để so sánh giữa các liều khác nhau, cần một dạng xu hướng song song mạnh hơn: các đơn vị ở liều khác nhau sẽ đi cùng một đường nếu liều của chúng bằng nhau (Callaway, Goodman-Bacon và Sant'Anna 2024).
Mô phỏng dùng 3.000 đơn vị, 5 biến hiệp biến quan sát được và một đặc điểm ẩn ổn định. Chỉ hiệu chỉnh theo X thì đường cong vẫn bị nhiễu. Thêm kết quả giai đoạn trước thì đỡ hơn nhưng vẫn lệch. Chạy trên mức thay đổi thì khôi phục được đường cong, vì đặc điểm ẩn bị triệt tiêu.
Thứ tự này đảo lại nếu liều phản ứng với kết quả trong quá khứ thay vì với một đặc điểm ổn định. Khi đó hiệu chỉnh theo kết quả giai đoạn trước mới đúng, còn DiD bị lệch. Chỉ nhìn dữ liệu thì không phân biệt được hai tình huống.
Một phép thử placebo giúp ích: chạy đường cong trên mức thay đổi giữa hai giai đoạn trước, khi liều chưa thể có tác động. Đường cong rõ ràng không phẳng là dấu hiệu xu hướng song song không đúng. Trong mô phỏng, ngay cả khi xu hướng song song đúng, khoảng 30% đường cong placebo vẫn nằm ngoài dải tin cậy 95%.
 Minh họa đường cong ước lượng và dải tin cậy
Những câu hỏi thường gặp
Có tin được khoảng tin cậy không? Hãy coi chúng là lạc quan. Với cấu hình mặc định dùng tổ hợp, dải 95% chứa đường cong thật trong 75 đến 93% số lần mô phỏng. Cách kiểm tra là giữ nguyên biến hiệp biến và liều thật, mô phỏng kết quả theo một đường cong đã biết, chạy lại toàn bộ quy trình 20 đến 30 lần rồi đếm tỉ lệ dải chứa giá trị thật. Đây gọi là mô phỏng plasmode (Franklin và cộng sự 2014).
Khi nào không nên dùng? Khi có nhiễu không đo được, vì doubly robust chỉ chống mô hình sai chứ không chống biến bị thiếu. Khi vùng chồng lấp kém, tức một số đơn vị chỉ nhận liều thấp thì dữ liệu không nói được liều cao sẽ ra sao. Khi liều được đặt ở cấp nhóm, phải tổng hợp lên cấp nhóm trước. Khi có điểm dồn ở 0, vì "có hay không" và "bao nhiêu" là hai câu hỏi khác nhau. Khi các nhóm giao nhau chứ không lồng nhau.
Sao không chia liều thành khoảng rồi dùng ước lượng rời rạc? DoubleMLAPOS làm được việc đó, nhưng nó bỏ thứ tự của các liều, mỗi khoảng cần một mô hình xu hướng riêng và đủ dữ liệu, và kết quả phụ thuộc vào chỗ đặt điểm cắt.
Còn đa thức theo liều như trong EconML? EconML nhận bộ tạo đặc trưng cho can thiệp, nên có thể khớp θ₁D + θ₂D². Cách này xử lý được đường cong đơn giản nhưng phải chọn hình dạng trước, vẫn là mô hình bán tuyến tính với cùng điểm ước lượng, và không gộp được giữa các nhóm.
Có phiên bản kernel cho bài toán này không? Có. Colangelo và Lee (2020) ước lượng đường cong theo từng liều với điểm doubly robust cục bộ hóa bằng kernel, Klosin (2021) làm tương tự mà không cần ước lượng mật độ. Đây là lựa chọn tốt cho một đường cong quần thể duy nhất với suy luận cẩn thận.
Có thể gộp bằng mô hình Bayes không? Có. Phạt ridge tương đương tiên nghiệm Gaussian trên các độ lệch, được điều chỉnh bằng huấn luyện chéo. Chạy cùng cấu trúc spline trong PyMC hoặc brms trên pseudo-outcome sẽ cho phân phối hậu nghiệm đầy đủ cho từng cửa hàng, đổi lại chi phí tính toán cao hơn.
 Mô hình phân cấp với gộp một phần
Góc nhìn
Với đội ngũ phân tích dữ liệu ở Việt Nam, bài học thực dụng nhất nằm ở chỗ chọn câu hỏi trước khi chọn mô hình. Nếu bài toán là "tăng ngân sách quảng cáo lên bao nhiêu" hay "giảm giá sâu đến đâu", một độ dốc duy nhất gần như vô dụng. Cần cả hình dạng của đường cong, và hình dạng đó quyết định điểm dừng có lãi.
Điểm thứ hai là chuyện mô hình phụ trợ. Trong dữ liệu doanh nghiệp, mô hình dự đoán liều thường bị bỏ qua, dù nó là mắt xích dễ sai nhất vì liều do quy tắc nội bộ quyết định chứ không ngẫu nhiên. Dùng trọng số cân bằng thay cho trọng số mật độ là cách giảm rủi ro mà không cần thay đổi nhiều quy trình.
Cuối cùng, khi triển khai theo từng cửa hàng hay từng phân khúc, gộp một phần cho phép nhóm nhỏ vẫn có đường cong riêng mà không bị nhiễu. Cách này phù hợp với cấu trúc dữ liệu bán lẻ phân tán, nơi số bản ghi mỗi điểm bán chênh lệch rất lớn.
Nguồn: towardsdatascience.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Difference-in-Differences và hồi quy kết quả trễ: chọn đúng thiết kế nào cho phân tích sản phẩm?
29 tháng 10, 2026
Phần mềm
Tối ưu hóa hệ thống gợi ý bằng LLM và Python: Cách cân bằng giữa tốc độ và độ chính xác
09 tháng 6, 2026
Phần mềm
PostHog: dùng mô hình ra quyết định thay LLM cho việc đơn giản
18 tháng 11, 2026