
Gemini 4 Carbon của Google vươn lên dẫn đầu bảng xếp hạng trí tuệ nhân tạo của Artificial Analysis
Mô hình Gemini 4 Carbon của Google đạt 59 điểm trên Chỉ số Trí tuệ v5 của Artificial Analysis, chính thức soán ngôi vị số 1 nhờ khả năng suy luận phức tạp và kiến thức vượt trội. Tuy nhiên, mô hình vẫn xếp sau Claude Opus 5.5 ở mảng tác nhân lập trình và chưa thể dẫn đầu toàn diện về công việc tri thức.
Google vừa giành lại vị trí dẫn đầu trong cuộc đua mô hình ngôn ngữ lớn khi Gemini 4 Carbon đạt điểm số cao nhất trên Chỉ số Trí tuệ v5 (Intelligence Index v5) của Artificial Analysis. Đây được xem là cú lội ngược dòng đáng chú ý của Google trong bối cảnh các đối thủ như Anthropic và OpenAI liên tục tung ra những mô hình mạnh mẽ.
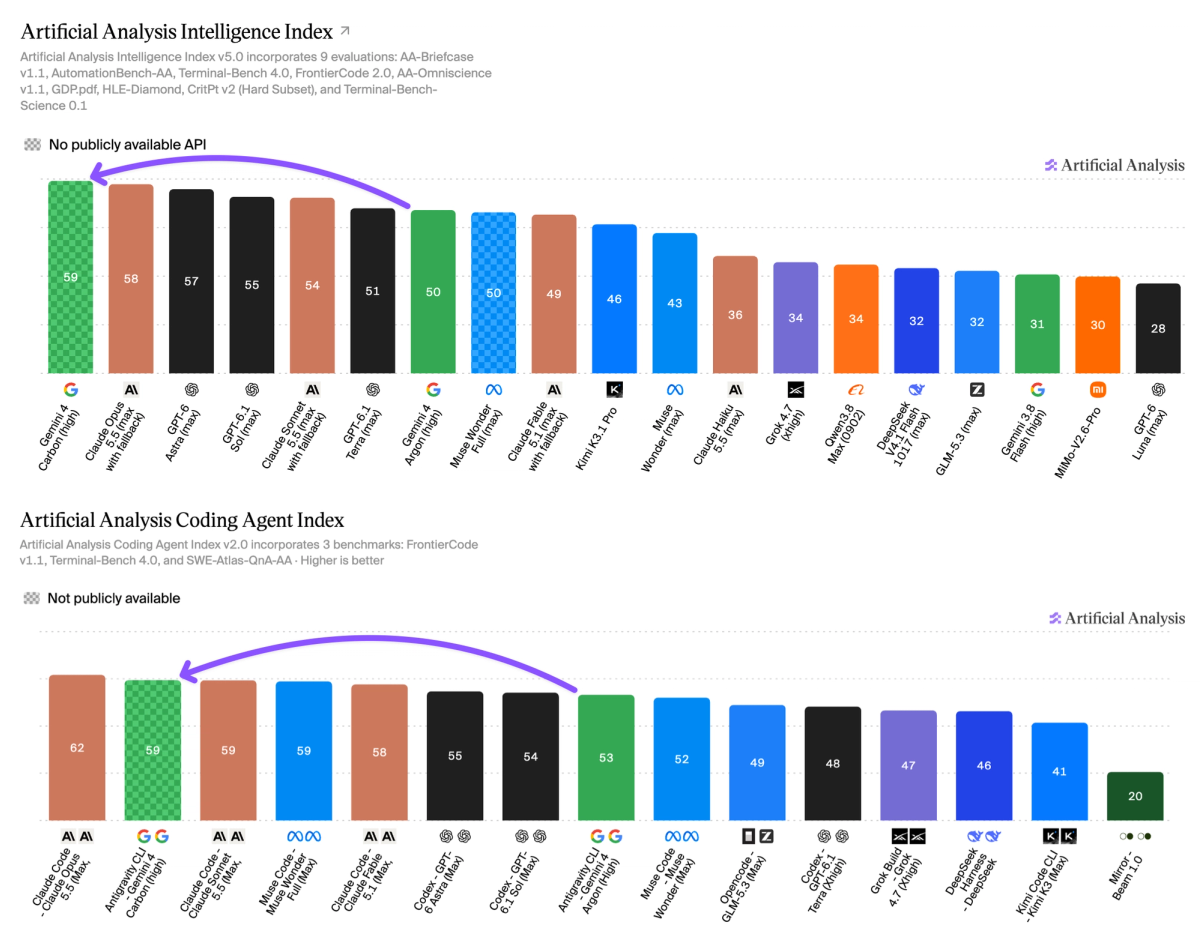 Bảng xếp hạng Chỉ số Trí tuệ v5 của Artificial Analysis
Điểm số ấn tượng nhưng chưa toàn diện
Gemini 4 Carbon đạt 59 điểm trên Chỉ số Trí tuệ v5, con số được thúc đẩy bởi hiệu suất vượt trội ở các tác vụ suy luận phức tạp, kiến thức chuyên sâu và khoa học. Đáng chú ý, mô hình này dẫn đầu ở 4 trong tổng số 9 bài đánh giá của chỉ số, bao gồm HLE-Diamond, Terminal-Bench-Science, AA-Omniscience và AutomationBench-AA.
Dù vậy, Gemini 4 Carbon không thống trị ở mọi hạng mục. Theo Artificial Analysis, mô hình có tiến bộ lớn về lập trình và công việc tri thức nhưng chưa đạt vị trí dẫn đầu ở những lĩnh vực này. Đây là điểm cần lưu ý với các doanh nghiệp Việt Nam đang cân nhắc lựa chọn mô hình cho các dự án phát triển phần mềm.
Hiện tại, Gemini 4 Carbon vẫn đang trong giai đoạn triển khai giới hạn cho một nhóm người dùng được chọn và chưa mở công khai. Google áp dụng mức giảm giá 50% khi ra mắt nhưng chưa công bố ngày kết thúc cụ thể.
Cuộc đua tác nhân lập trình vẫn nghiêng về Anthropic
Ở hạng mục Chỉ số Tác nhân Lập trình (Coding Agent Index), Gemini 4 Carbon đạt 59 điểm khi chạy với Antigravity CLI, chỉ kém 3 điểm so với Claude Opus 5.5 (62 điểm) chạy trên Claude Code. Với lịch sử yếu thế của Google ở mảng lập trình, đây được đánh giá là bước tiến đáng kể.
Mô hình xếp thứ hai trên cả Terminal-Bench 4.0 (đạt 64%) và FrontierCode v1.1 (đạt 51%), đều sau Claude Opus 5.5 phiên bản max (56% ở FrontierCode).
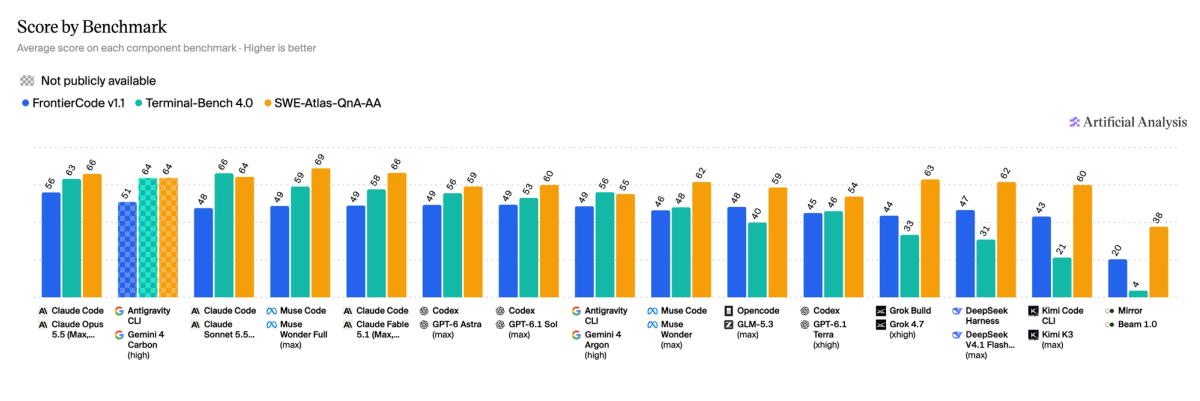 So sánh hiệu suất các mô hình AI trên các chỉ số đánh giá
Cải thiện công việc tri thức nhưng còn khoảng cách
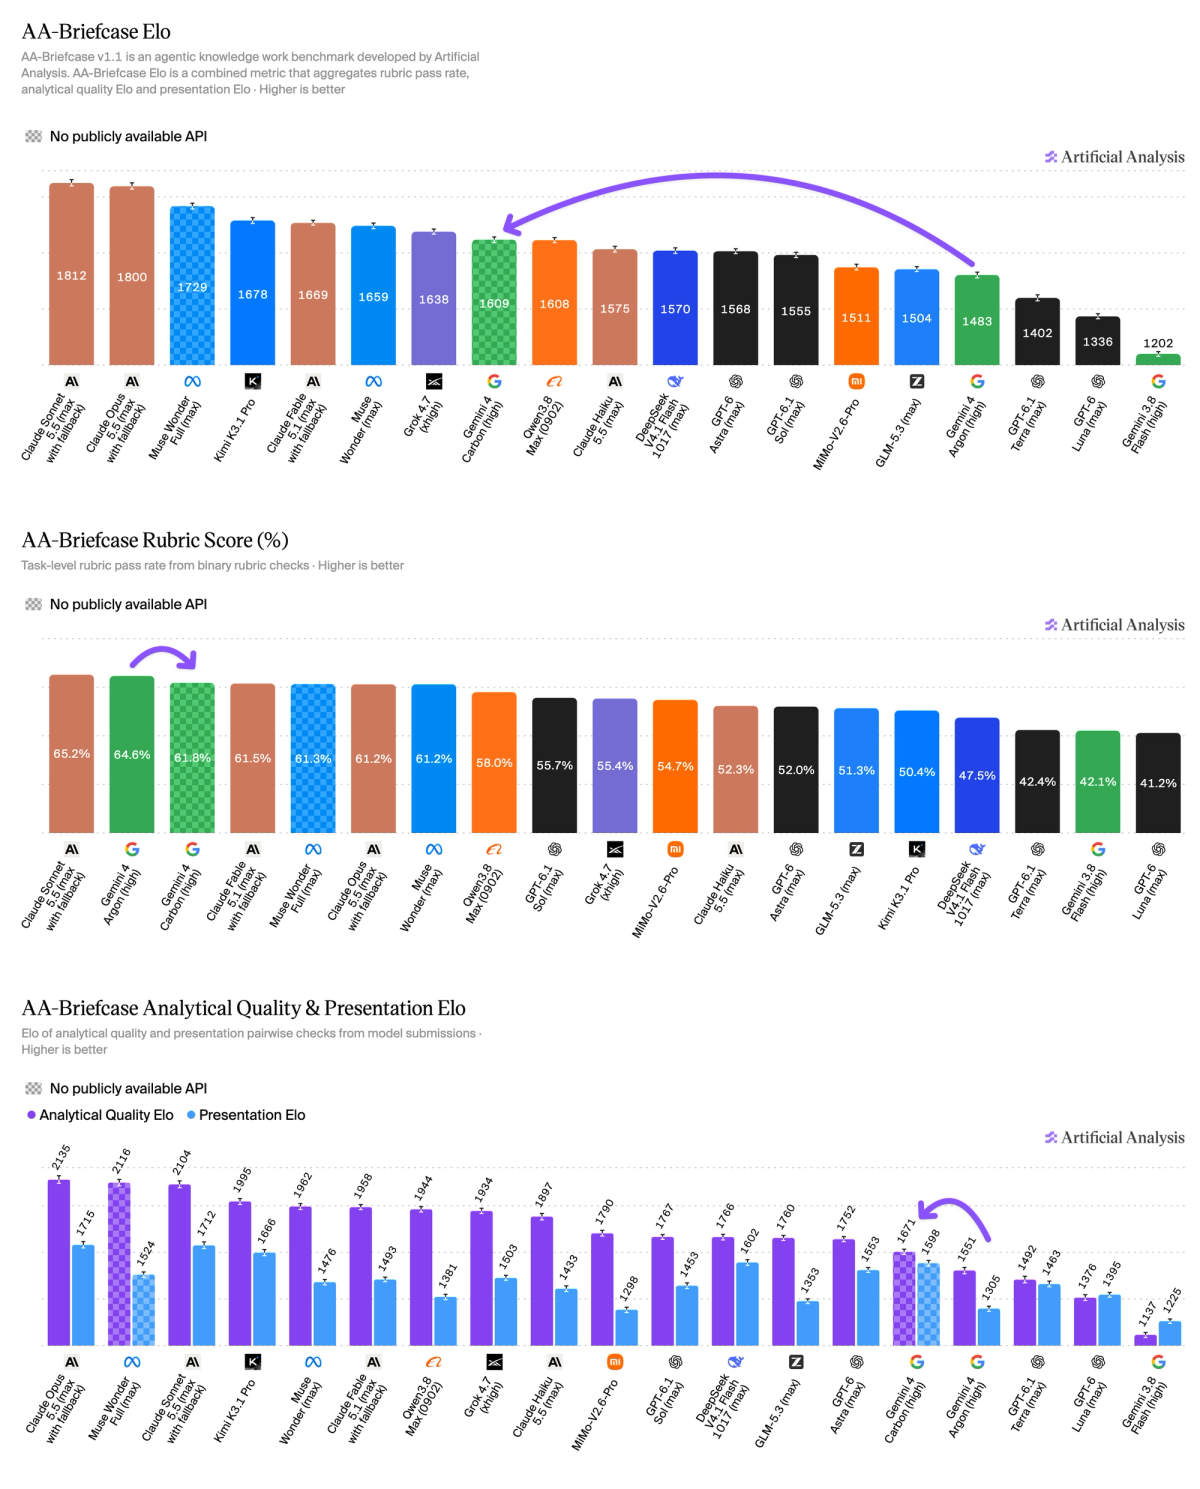
Trên bài đánh giá AA-Briefcase, Gemini 4 Carbon đạt 1609 Elo, tăng 126 điểm so với phiên bản tiền nhiệm Gemini 4 Argon (1483 điểm). Tuy nhiên, mô hình vẫn xếp sau nhiều đối thủ như Grok 4.7 (1638), Muse Wonder (1659) và Kimi K3.1 Pro (1678).
Điểm sáng lớn nhất là khả năng tạo bài thuyết trình, khi điểm số tăng vọt 293 Elo lên 1598, cùng mức cải thiện 120 điểm ở hạng mục Chất lượng Phân tích (Analytical Quality), đạt 1671.
Chi phí cạnh tranh, tỷ lệ ảo giác thấp
Về mặt kinh tế, Gemini 4 Carbon có lợi thế rõ rệt. Với mức giá tiêu chuẩn, chi phí cho mỗi tác vụ trên Chỉ số Trí tuệ là 7,76 USD, thấp hơn khoảng 23% so với Claude Opus 5.5 (10,04 USD) nhưng cao hơn khoảng 1,2 lần so với GPT-6 Astra (6,25 USD).
Mô hình sử dụng 123.000 token đầu ra mỗi tác vụ, ít hơn 29% so với Claude Opus 5.5 (173.000 token). Đáng chú ý, dù giá $4/$20 trên mỗi triệu token đầu vào/đầu ra giống hệt Gemini 4 Argon, Carbon lại đạt điểm cao hơn 9 điểm trên Chỉ số Trí tuệ.
"Gemini 4 Carbon đạt điểm 54 trên AA-Omniscience v1.1, cao hơn Claude Opus 5.5 (48) 6 điểm và cao hơn Gemini 4 Argon (46) 8 điểm."
Tỷ lệ chính xác của mô hình tăng 10 điểm so với Argon lên 58%, trong khi tỷ lệ ảo giác tăng từ 4% lên 11%. Dù vậy, đây vẫn là mức ảo giác thấp thứ hai trong số các mô hình được đánh giá, chỉ sau Argon, và thấp hơn rất nhiều so với con số 50% của cả Claude Opus 5.5 và GPT-6 Astra.
Thông số kỹ thuật chi tiết
 Cửa sổ ngữ cảnh và khả năng đa phương thức của Gemini 4 Carbon
Các thông số chính của Gemini 4 Carbon bao gồm:
- Cửa sổ ngữ cảnh: 1 triệu token
- Đa phương thức: Nhận đầu vào dạng văn bản, hình ảnh, video và giọng nói; đầu ra dạng văn bản
- Giá: 4 USD/20 USD trên mỗi triệu token đầu vào/đầu ra, áp dụng mức giảm 50% khi ra mắt
- Token đầu vào được lưu đệm: Giảm giá 95%, còn 0,20 USD trên mỗi triệu token ở mức giá tiêu chuẩn
Ý nghĩa với thị trường AI và người dùng Việt Nam
Việc Gemini 4 Carbon vươn lên dẫn đầu cho thấy Google đang thu hẹp khoảng cách với các đối thủ trong lĩnh vực lập luận và kiến thức — hai yếu tố quan trọng với các ứng dụng doanh nghiệp. Với mức giá cạnh tranh và chi phí mỗi tác vụ thấp hơn Anthropic, mô hình này có thể là lựa chọn hấp dẫn cho các startup và đội phát triển tại Việt Nam đang tìm kiếm giải pháp AI tối ưu chi phí.
Tuy nhiên, cần lưu ý rằng mô hình chưa được phát hành chính thức và vẫn đang trong quá trình thử nghiệm giới hạn. Người dùng Việt Nam theo dõi sát sao thị trường AI có thể kỳ vọng một làn sóng cập nhật mới từ Google trong thời gian tới.
Bên cạnh đó, Artificial Analysis mới đây cũng giới thiệu GitHub Copilot Fusion, công cụ điều phối giữa các mô hình Anthropic và OpenAI để cân bằng giữa hiệu suất và chi phí. Động thái này cho thấy xu hướng các nền tảng ngày càng chú trọng tối ưu hóa chi phí song song với việc nâng cao năng lực của mô hình — một hướng đi phù hợp với nhu cầu thực tế của nhiều doanh nghiệp.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Difference-in-Differences và hồi quy kết quả trễ: chọn đúng thiết kế nào cho phân tích sản phẩm?
29 tháng 10, 2026