GPT-6 Astra chỉnh trực tiếp trọng số Qwen, nâng điểm MATH-500 từ 7,9% lên 48,1%
Thử nghiệm cho thấy GPT-6 Astra có thể đọc, sửa và tạo trọng số mạng nơ-ron theo yêu cầu bằng ngôn ngữ tự nhiên, không cần huấn luyện hay dùng thông tin về độ dốc. Với Qwen3.5-0.8B, mô hình sửa một lỗi khiến hệ thống lặp câu, qua đó nâng điểm MATH-500 từ 7,9% lên 48,1%; tuy nhiên, kết quả ban đầu cũng cho thấy phương pháp chưa thể khắc phục mọi hạn chế suy luận.
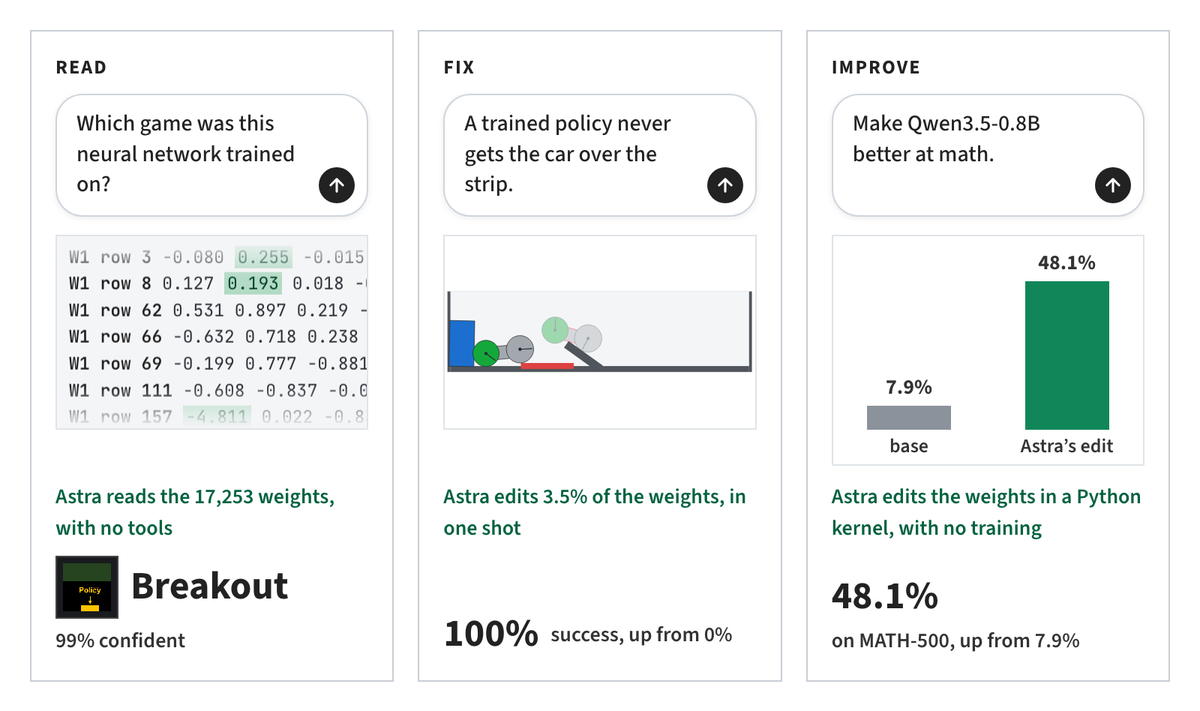
Một loạt thử nghiệm ban đầu cho thấy GPT-6 Astra có thể đọc, sửa và tạo trọng số của mạng nơ-ron theo mục tiêu mô tả bằng ngôn ngữ tự nhiên. Đáng chú ý, khi chỉnh Qwen3.5-0.8B mà không huấn luyện lại, Astra sửa được lỗi lặp câu và nâng điểm MATH-500 từ 7,9% lên 48,1%.
Cách làm này được gọi là lập trình trong không gian trọng số: mô hình ngôn ngữ lớn trực tiếp phân tích và thay đổi các con số cấu thành mạng nơ-ron, thay vì dựa vào thuật toán tối ưu hoặc thông tin về độ dốc. Kết quả gợi mở một hướng mới cho việc tìm hiểu và điều chỉnh mô hình, nhưng vẫn còn những giới hạn đáng kể.
Đọc hành vi từ các con số
Trọng số là những giá trị số quyết định cách mạng nơ-ron xử lý đầu vào. Thông thường, con người khó suy ra chức năng của mạng chỉ bằng cách nhìn vào các giá trị này. Trong thử nghiệm, Astra được cung cấp trọng số mà không có thông tin về tác vụ, rồi được yêu cầu đoán mạng đã học làm gì.
Với bốn mạng được huấn luyện để chơi các trò chơi khác nhau, Astra xác định đúng trò chơi trong cả bốn trường hợp chỉ từ trọng số. Các mạng có cùng cấu trúc và cùng loại đầu vào, nên câu trả lời không thể dựa đơn giản vào kích thước hay cách bố trí của chúng.
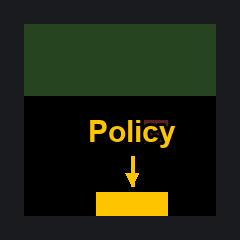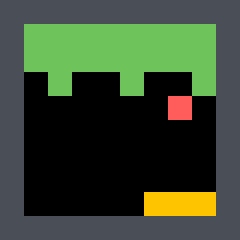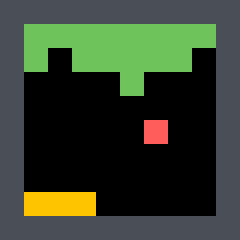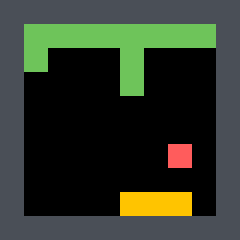 Trò chơi Breakout dùng trong thử nghiệm nhận diện mạng từ trọng số
Astra cũng nhận diện được các mạng khuếch tán khử nhiễu được huấn luyện để tạo hình tròn, tam giác hoặc hình vuông. Trong một thử nghiệm khác, mô hình được xem phần giữa của ba mạng ngôn ngữ nhỏ, mỗi mạng có 7,2 triệu tham số và được huấn luyện trên một ngôn ngữ khác nhau: mã Python, tiếng Nhật viết bằng chữ cái La-tinh và tiếng Anh. Không có lớp đầu vào, lớp đầu ra hay khả năng chạy mạng, Astra vẫn xác định đúng ngôn ngữ trong cả ba trường hợp và tìm ra các đầu chú ý chuyên sao chép văn bản đã xuất hiện trước đó.
Tạo và sửa mạng mà không huấn luyện
Astra không chỉ phân tích trọng số mà còn được yêu cầu thay đổi chúng. Trong một thử nghiệm, mạng điều khiển ô tô bị mắc kẹt khi cố đi thẳng lên dốc. Từ trọng số, mô tả tình huống và một lượt chạy được ghi lại, Astra xác định rằng mạng đã rơi vào một chính sách kém hiệu quả. Sau khi chỉnh 3,5% trọng số, ô tô lùi lấy đà rồi vượt dốc thành công trong cả 1.024 lượt thử.
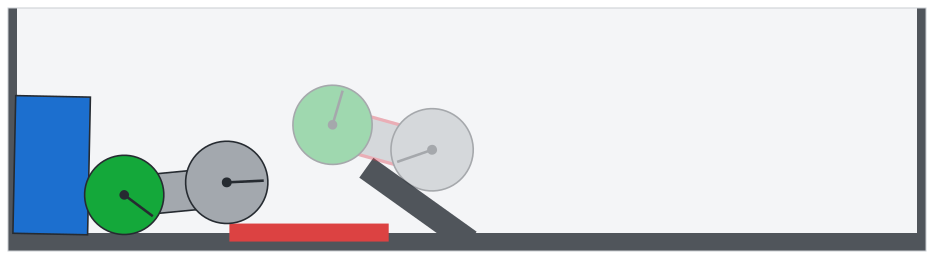 Mô phỏng ô tô vượt dốc trong thử nghiệm chỉnh trọng số
Trong một thử nghiệm khác, Astra tạo mạng chơi ba trò MinAtar: Breakout, Seaquest và Asterix. Mô hình được cung cấp luật chơi, mã nguồn và cấu trúc mạng, nhưng không có dữ liệu, thông tin về hàm mất mát, độ dốc hay công cụ để chạy thử mạng trong môi trường. Các mạng do Astra tạo ra đánh bại mạng được huấn luyện bằng phương pháp PPO trong cả ba trò chơi khi đối thủ được huấn luyện 100 triệu bước.
Khi so với mạng PPO được huấn luyện 500 triệu bước, mạng của Astra đạt điểm cao gấp 20 lần ở Breakout, gần bằng ở Asterix và đạt 60% điểm số ở Seaquest. Theo mô tả thử nghiệm, Astra xây dựng mạng như một chương trình: các lớp đầu ước lượng vị trí bóng, còn lớp tiếp theo điều khiển thanh đỡ bóng.
Sửa lỗi lặp trong Qwen
Thử nghiệm đáng chú ý nhất áp dụng phương pháp này lên Qwen3.5-0.8B. Astra được phép chọn câu hỏi từ các tập GSM8K và MATH để chạy thử mô hình, với ngân sách 10, 25 hoặc 50 lượt chạy. Mô hình không được cung cấp thông tin huấn luyện hay độ dốc.
Astra phát hiện Qwen thường lặp lại cùng một đoạn văn bản thay vì đi đến đáp án. Trong 96 câu trả lời thử đầu tiên, 85 câu kéo dài đến giới hạn 32.768 mã thông báo. Astra lần theo lỗi tới một hướng trọng số do các mạng perceptron nhiều lớp ở lớp 15 và 19 tạo ra, rồi trừ hướng đó khỏi 64 cột đầu ra của mỗi lớp. Tổng cộng, thay đổi này tác động đến 131.072 trọng số, tương đương 0,016% trong tổng số 0,8 tỷ trọng số của mô hình.
Với ngân sách 50 lượt chạy, điểm MATH-500 tăng từ 7,9% lên 48,1%, còn GSM8K tăng từ 13,8% lên 67,1%. Điểm IFEval, thước đo khả năng làm theo chỉ dẫn, tăng từ 21,0% lên 62,3%. Tỷ lệ câu trả lời MATH-500 chạm giới hạn 32.768 mã thông báo giảm từ 93% xuống 33%.
Tuy nhiên, kết quả này chủ yếu cho thấy Astra đã gỡ bỏ một trở ngại khiến Qwen không hoàn tất được câu trả lời, chứ không nhất thiết tạo ra năng lực toán học mới. Với Gemma 3 270M, mô hình ít bị lặp hơn nhưng mắc các lỗi suy luận thông thường như tính toán sai hoặc biến đổi đại số không hợp lệ. Astra không tìm thấy một thành phần riêng lẻ có thể tắt để giải quyết vấn đề; các chỉnh sửa không làm điểm MATH-500 tăng quá khoảng một điểm.
Thử nghiệm về hành vi nịnh người dùng cũng cho thấy giới hạn của việc chỉ đọc trọng số. Astra không phân biệt được mô hình trả lời đúng với mô hình luôn đồng tình với gợi ý của người hỏi nếu chỉ xem trọng số. Khi được cung cấp bản đồ chú ý của hai mô hình trên các văn bản do Astra tạo, nó nhận diện đúng mô hình nịnh người dùng trong cả ba cặp thử nghiệm.
Một hướng nghiên cứu còn ở giai đoạn đầu
Các kết quả được trình bày vẫn là những thử nghiệm ban đầu. Nhiều mạng nhỏ có thể được đưa trực tiếp vào ngữ cảnh của mô hình; với mạng lớn hơn, Astra cần công cụ để đọc và sửa trọng số, đồng thời có thể dùng một số lượt chạy để quan sát hành vi. Năng lực của mô hình cũng không đồng đều: nó có thể khắc phục một lỗi cụ thể, nhưng chưa chắc xử lý được các điểm yếu đòi hỏi kiến thức hoặc năng lực suy luận mà mạng vốn chưa có.
Dù vậy, việc một mô hình ngôn ngữ lớn có thể liên hệ cấu trúc trọng số với hành vi rồi chỉnh sửa trực tiếp là một hướng đáng chú ý cho nghiên cứu tối ưu hóa và khả năng diễn giải mạng nơ-ron. Nhóm tác giả cho biết họ đang xây dựng bộ đánh giá và công cụ thử nghiệm để việc kiểm tra năng lực này có thể được chuẩn hóa và tái lập.
Góc nhìn
Với nhà phát triển và kỹ sư, hướng tiếp cận này gợi ra khả năng sửa một lỗi hẹp trong mô hình mà không phải huấn luyện lại toàn bộ. Nhưng thử nghiệm với Gemma 3 270M cho thấy cách làm này không thay thế được việc cải thiện năng lực nền tảng: chỉnh trọng số có thể gỡ một điểm nghẽn rõ ràng, chứ không tự tạo ra khả năng suy luận còn thiếu.
Các con số hiện tại cũng chưa đủ để xem đây là quy trình đáng tin cậy cho hệ thống thực tế. Cần đánh giá thêm độ ổn định của chỉnh sửa, khả năng áp dụng trên mô hình lớn và mức độ tái lập trước khi doanh nghiệp có thể dựa vào phương pháp này trong vận hành.