
Học tăng cường qua hình ảnh: cách tia sáng học tìm ánh sáng
Một bài viết trực quan giải thích học tăng cường (reinforcement learning) bằng cách để người đọc tự nối dây "não" của một sinh vật số chỉ với bốn neuron và ba tham số, rồi xem nó học cách tìm ánh sáng qua hàng nghìn lần thử. Bài viết cho thấy thuật toán REINFORCE năm 1992 của Ronald Williams vẫn là nền tảng cho nhiều phương pháp học tăng cường hiện đại.
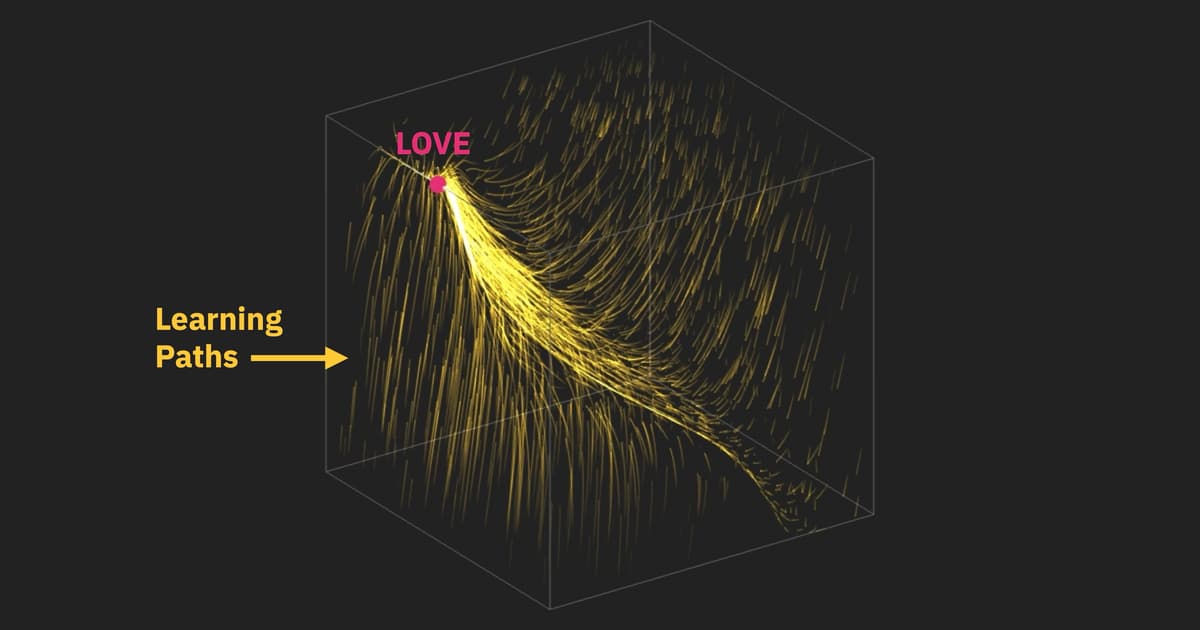
Bài viết là chương hai của loạt nội dung trực quan Myriad, do nhà thần kinh học Arkarup Banerjee và nhà báo khoa học Aatish Bhatia thực hiện, nhằm lý giải cách tâm trí hình thành từ vật chất. Thay vì trình bày lý thuyết trừu tượng, tác giả dựng một sinh vật số có bộ não tối giản và để người đọc tự điều chỉnh, quan sát nó học qua thử và sai.
Bộ não chỉ gồm bốn neuron và ba tham số
Sinh vật trong bài có tên spark (tia sáng), sở hữu bộ não với đúng bốn neuron: hai neuron làm nhiệm vụ "mắt" và hai neuron điều khiển hai chiếc vây. Cách nối dây thần kinh được quy về ba con số:
- Kết nối thẳng (straight connection): liên kết giữa neuron mắt và vây cùng phía cơ thể.
- Kết nối chéo (crossed connection): liên kết giữa mắt và vây ở hai phía đối diện.
- Lực đẩy (drive): quy định tốc độ của spark khi không có ánh sáng.
Trong chương trước, các kết nối này được nối thủ công. Ở chương này, spark phải tự học lại hành vi đó — giống như con người không sinh ra đã biết đi, biết nói hay biết đọc, mà phải trải qua quá trình thử và sai gian khổ. Một số khả năng như thở hay nuốt có sẵn nhờ tiến hóa, nhưng phần lớn kỹ năng khác đều đến từ luyện tập.
Người đọc được trao quyền điều khiển ba thanh trượt tương ứng với ba tham số trên, với mục tiêu đưa điểm số vượt 0,5 để spark "yêu ánh sáng". Quá trình mò mẫm này được mô tả như một đường đi trong khối lập phương ba chiều, với mỗi trục là một tham số.
Thuật toán học: thưởng và phạt
Từ thao tác thủ công đó, bài viết đúc kết thành một thuật toán học từng bước. Trước mỗi lần thử, cách nối dây của spark thay đổi ngẫu nhiên một chút — giống như việc gạt thanh trượt qua lại. Nếu lần thử tốt hơn các lần trước, spark nhận phần thưởng (reward) và các kết nối dịch theo hướng thay đổi ngẫu nhiên đó. Nếu tệ hơn, nó nhận hình phạt (punishment) và các kết nối dịch theo hướng ngược lại.
Cơ chế này không khác mấy cách con người học đi xe đạp: ngã là hình phạt, còn cảm giác giữ được thăng bằng là phần thưởng.
Diễn biến qua các mốc số lần thử:
- Khởi đầu: não nối ngẫu nhiên, spark chỉ xoay tại chỗ mà chưa di chuyển được.
- Sau 50 lần: spark sơ sinh bước những bước đầu tiên, tuy chưa nhanh.
- Sau 250 lần: spark thiếu niên tăng tốc nhưng lệch khỏi ánh sáng ở phút cuối.
- Sau 500 lần: spark vị thành niên lao thẳng về phía ánh sáng nhưng chưa biết giảm tốc hay dừng lại.
- Sau 2.000 lần: spark trưởng thành thành chuyên gia tìm và bám theo ánh sáng, có thể xoay chuyển tức thì và bám theo khi nguồn sáng di chuyển.
Hàng trăm spark khởi đầu với bộ não nối khác nhau tạo ra một mạng lưới đường học chằng chịt, nhưng tất cả đều hội tụ về cùng một điểm đánh dấu ♥︎. Các đường đi không thẳng — có lùi bước, rẽ sai và sai lầm, có trường hợp cần tới hàng nghìn lần thử. Đường đi cũng rung lắc vì mỗi bước đều có yếu tố ngẫu nhiên; lấy trung bình trên nhiều quỹ đạo sẽ làm mượt chúng và phác ra bản đồ dòng chảy của quá trình học.
Điều đáng chú ý: trong vô số cách sắp xếp bộ não khả dĩ, chỉ một phần rất nhỏ tạo ra hành vi mong muốn — số cách thất bại nhiều hơn hẳn cách thành công. Vậy mà chỉ nhờ thưởng và phạt, spark vẫn tìm được lối ra.
Học không dừng lại khi đã trưởng thành
Bài viết còn cho thấy spark thích nghi khi môi trường thay đổi. Nếu ánh sáng tượng trưng cho hóa chất độc hại hoặc kẻ săn mồi thay vì thức ăn, phần thưởng được đảo lại và spark học các hành vi mới:
- Nếu ánh sáng có hại, chiến lược LOVE (bám theo ánh sáng) trở thành tệ nhất; spark học cách FLEE (chạy trốn nhanh nhất có thể) hoặc FREEZE (giả chết).
- Nếu được thưởng khi tiếp cận ánh sáng với tốc độ cao, spark học cách lao tới, tức FIGHT (chiến đấu).
Như vậy, tùy cách định nghĩa phần thưởng, cùng một sinh vật có thể học những hành vi rất khác nhau: trốn chạy, giả chết, chiến đấu hay bám theo ánh sáng.
Liên hệ với não sinh học và chi tiết kỹ thuật
Chim non học hót theo cách tương tự: chúng thử những biến thể ngẫu nhiên của bài hót, nếu biến thể tiến gần ký ức về bài hót của chim trưởng thành thì được "thưởng" một đợt dopamine, còn nếu xa hơn thì dopamine giảm. Nhờ vậy chúng có thể tái tạo bài hót từ ký ức dù không có "thầy" bên cạnh.
Tác giả cũng thẳng thắn thừa nhận giới hạn: bộ não của spark chỉ có bốn neuron và ba tham số, nên mới quan sát được quá trình học trong không gian ba chiều. Não người có khoảng 86 tỷ neuron và hơn một trăm nghìn tỷ kết nối, không gian cấu hình rộng lớn không tưởng. Nhưng nguyên lý cốt lõi vẫn vậy: học là cách ta di chuyển trong không gian nội tại khổng lồ đó, còn phản hồi là chiếc la bàn chỉ hướng.
Về mặt kỹ thuật, spark lấy cảm hứng từ công trình của nhà thần kinh học Valentino Braitenberg. Mạch thần kinh được mô tả bằng công thức:
vL = σ(ws·bL + wc·bR + d)
vR = σ(wc·bL + ws·bR + d)
Trong đó vL và vR là tốc độ hai vây trái phải, bL và bR là độ sáng đo được ở hai mắt, ws và wc là độ mạnh kết nối thẳng và chéo, d là lực đẩy khi không có ánh sáng, còn σ(x) là hàm ReLU. Tốc độ tiến của spark là trung bình hai tốc độ vây, tốc độ xoay tỉ lệ với hiệu của chúng.
Spark học ba tham số ws, wc và d bằng một phiên bản thuật toán REINFORCE do Ronald Williams công bố năm 1992. Mỗi lần thử, các tham số bị xê dịch ngẫu nhiên một lượng nhỏ và spark di chuyển 500 bước thời gian từ một điểm ngẫu nhiên ở rìa đấu trường; phần thưởng là độ sáng trung bình trên đường đi. Phần thưởng này được so với trung bình trượt của các lần gần nhất để quyết định hướng và mức dịch chuyển:
ΔW = α · ε · (R − R̄)
Ở đây ΔW là thay đổi của ba tham số, α là tốc độ học, ε là độ xê dịch ngẫu nhiên, còn R − R̄ là mức tốt hơn hay kém hơn mức thông thường. Quá trình này được lặp lại hàng nghìn lần.
Cách tiếp cận gốc của Williams thêm nhiễu vào đầu ra của từng neuron; nhóm tác giả thêm nhiễu vào trọng số và độ lệch thay vào đó — phương pháp gọi là weight perturbation (nhiễu loạn trọng số). Ý tưởng tương tự mang tên evolution strategies (chiến lược tiến hóa) từng được OpenAI dùng năm 2017 để dạy các mô hình AI chơi game Atari.
Góc nhìn
Bài viết là một cách nhập môn học tăng cường hiệu quả vì nó tách bạch đúng phần cốt lõi: một hàm mục tiêu, một cơ chế thăm dò ngẫu nhiên và một tín hiệu phản hồi. Với kỹ sư và lập trình viên Việt Nam đang thử sức với AI, đây là lời nhắc rằng các thư viện hiện đại che giấu đi những chi tiết mà việc hiểu chúng lại rất đáng giá — đặc biệt khi phải chẩn đoán vì sao một tác nhân học không hội tụ.
Một điểm đáng suy ngẫm cho các doanh nghiệp là vai trò quyết định của cách định nghĩa phần thưởng. Cùng một hệ thống, chỉ cần đổi tín hiệu phản hồi là hành vi đầu ra đảo ngược hoàn toàn, từ bám theo đến trốn tránh. Khi triển khai bất kỳ hệ thống học nào vào vận hành thực tế, việc thiết kế hàm thưởng cần được xem trọng ngang với bản thân mô hình, vì nó định hình trực tiếp hành vi mà hệ thống sẽ học được.
Nguồn: aatishb.com · Quy trình biên tập
Bài viết liên quan
Phần mềm
Học tăng cường (Reinforcement Learning) với Unity: Hướng dẫn xây dựng tác nhân thông minh
11 tháng 4, 2026
Công nghệ
Tôi huấn luyện một mạng nơ-ron tí hon để nén dữ liệu. Nó vẽ ra một hình ngũ giác.
23 tháng 9, 2026
Công nghệ
Mạng nơ-ron học đọc chữ số chỉ từ nhiễu ngẫu nhiên: khi học sinh học lén từ giáo viên
01 tháng 11, 2026