Huấn luyện mô hình chuyển văn bản thành hình ảnh nhanh gấp 3,6 lần nhờ kiến trúc JiT-DDT
Nhóm nghiên cứu tại Linum vừa công bố phương pháp huấn luyện mô hình chuyển văn bản thành hình ảnh nhanh gấp 3,6 lần so với thiết kế latent diffusion truyền thống, dù tạo ra ảnh có độ phân giải pixel gấp 4 lần. Bí quyết nằm ở việc loại bỏ bộ mã hóa VAE, áp dụng dự đoán x-prediction và kiến trúc encoder-decoder mới mang tên JiT-DDT.
Huấn luyện mô hình chuyển văn bản thành hình ảnh nhanh gấp 3,6 lần nhờ kiến trúc JiT-DDT
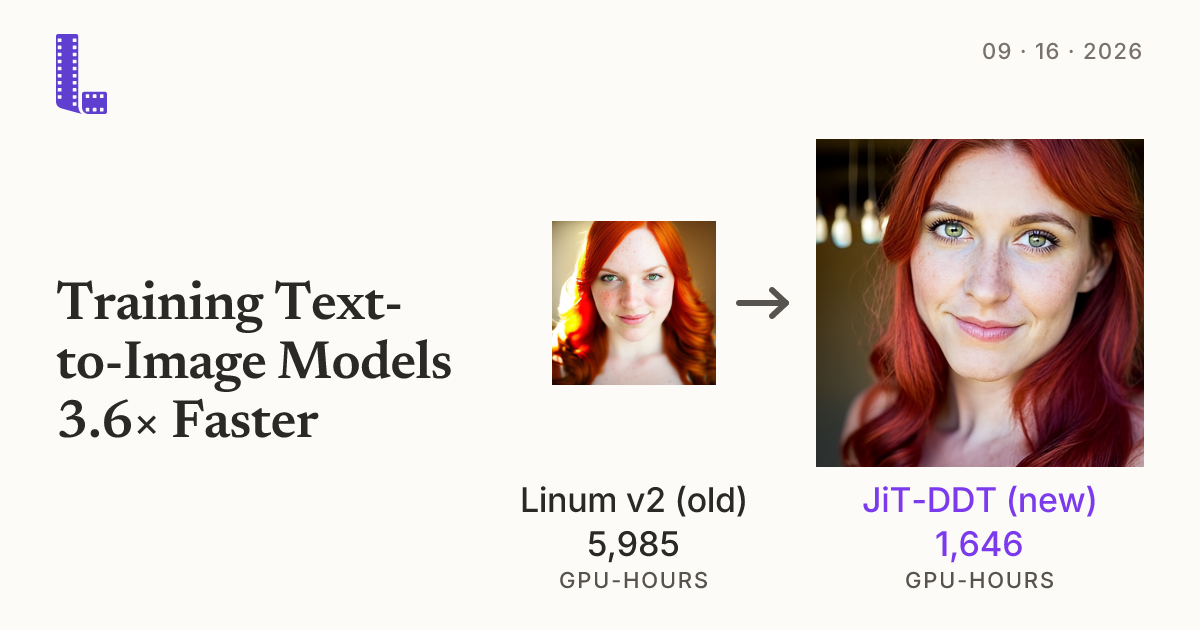
Phần lớn các mô hình tạo ảnh và video hiện nay đều dựa trên kiến trúc Latent Diffusion Model (LDM), vốn bị giới hạn bởi chi phí tính toán khổng lồ của cơ chế attention. Nhóm nghiên cứu tại Linum mới đây đã công bố một kiến trúc mới có tên JiT-DDT, cho phép huấn luyện mô hình chuyển văn bản thành hình ảnh với số giờ GPU ít hơn 3,6 lần so với phiên bản tiền nhiệm Linum v2, trong khi vẫn tạo ra ảnh có số lượng pixel gấp 4 lần.
Đây có thể coi là một bước tiến đáng chú ý đối với cộng đồng nghiên cứu AI tạo sinh, bởi chi phí huấn luyện vẫn là rào cản lớn nhất khiến các mô hình tạo ảnh chất lượng cao khó tiếp cận với các nhóm nghiên cứu nhỏ hơn, trong đó có không ít đội ngũ tại Việt Nam.
 Kiến trúc JiT-DDT với bộ mã hóa và giải mã tách biệt
Bức tường nén của VAE
Gần như toàn bộ các mô hình tạo ảnh và video hiện đại đều là Latent Diffusion Model, gồm hai thành phần chính: Variational Autoencoder (VAE) dùng để nén dữ liệu và Diffusion Transformer (DiT) dùng để sinh ảnh.
Việc xử lý trực tiếp trên pixel thô là quá tốn kém, đặc biệt với video, nên VAE được huấn luyện riêng để nén các mẫu pixel thành các token có số chiều thấp hơn, rồi giải mã ngược lại về không gian pixel. Sau khi huấn luyện xong, VAE bị đóng băng (frozen) và DiT học cách di chuyển trong không gian latent mà VAE đã dựng sẵn.
Vấn đề nằm ở chỗ: nếu khảo sát các mô hình mã nguồn mở phổ biến như FLUX, Ideogram hay Z-Image, tất cả đều dừng ở mức nén 16×16 token. Đây dường như là giới hạn thực nghiệm của kiến trúc VAE dạng CNN: nén mạnh hơn nữa sẽ làm suy giảm chất lượng tái tạo ảnh.
Phá vỡ giới hạn nhờ mô hình hợp nhất
Cuối năm ngoái, Tianhong Li và Kaiming He công bố bài báo về JiT (Just-in-Time), đạt mức nén 32×32 token bằng cách loại bỏ hoàn toàn VAE và đẩy nhiệm vụ nén vào chính DiT.
Ý tưởng cốt lõi khá đơn giản: chia ảnh thành các mảnh (patch) kích thước lớn, biến mỗi mảnh thành một token duy nhất, rồi để DiT tự học cách nén và sinh dữ liệu trong cùng một không gian biểu diễn. Cách tiếp cận này không mới về mặt kỹ thuật — nó đã xuất hiện trong các Vision Transformer (ViT) từ nửa thập kỷ trước — nhưng chưa ai áp dụng triệt để cho mô hình diffusion vì lý do quan trọng: DiT gặp khó khăn khi học từ đầu vào có số chiều cao.
 Sự sụp đổ của dự đoán vận tốc khi số chiều tăng
Lời nguyền số chiều và vai trò của x-prediction
Các mô hình flow matching hiện đại thường huấn luyện mạng neural dự đoán vận tốc (velocity) dọc theo đường thẳng nối giữa mẫu dữ liệu và nhiễu Gaussian. Vấn đề là vận tốc được cấu thành từ hai thành phần: tín hiệu (ảnh gốc) và nhiễu. Nhiễu Gaussian ngẫu nhiên trải khắp toàn bộ không gian D chiều, và khi D tăng lên, việc khớp nhiễu trở nên khó khăn theo cấp số nhân.
Li và He đã kiểm chứng điều này bằng một thí nghiệm đơn giản: chiếu các điểm trên một đường xoắn ốc 2D vào không gian nhiều chiều hơn, rồi huấn luyện các mô hình flow matching với ba cách dự đoán khác nhau. Kết quả cho thấy chỉ có x-prediction (dự đoán ảnh gốc thay vì vận tốc) mới khôi phục được đường xoắn ốc khi số chiều tăng cao.
Nói cách khác, ảnh và video tự nhiên nằm trên một đa tạp có số chiều nội tại thấp, trong khi nhiễu thì lấp đầy toàn bộ không gian. Bằng cách chuyển sang dự đoán ảnh gốc, mô hình có thể dồn toàn bộ năng lực vào việc học tín hiệu có cấu trúc, thay vì lãng phí vào việc khớp nhiễu ngẫu nhiên.
JiT-DDT: khôi phục chi tiết trong không gian pixel
Dù JiT đạt được mức nén ấn tượng, nó vẫn bộc lộ hạn chế lớn: khó tạo ra các chi tiết tinh xảo như tàn nhang, sợi tóc hay kết cấu bề mặt. Đây là vấn đề mà nhóm Linum buộc phải giải quyết nếu muốn đưa mô hình pixel-space vào ứng dụng thực tế.
Lấy cảm hứng từ DDT (Decoupled Diffusion Transformer) của Shuai Wang, nhóm đã tách DiT thành hai phần: một encoder chuyên học cấu trúc tần số thấp và một decoder chuyên khôi phục chi tiết tần số cao. Điểm khác biệt quan trọng là trong thế giới x-prediction, encoder có thể được huấn luyện dự đoán trực tiếp một phiên bản ảnh có độ phân giải thấp hơn — cụ thể là ảnh 64×64 từ đầu vào 512×512.
Cách làm này mang lại lợi ích kép: encoder học cấu trúc một cách tường minh, còn decoder nhận được bản phác thảo cấu trúc, ảnh nhiễu độ phân giải đầy đủ và cả prompt văn bản để tái tạo chi tiết.
Điều chỉnh lịch trình nhiễu — bước ngoặt bất ngờ
Điều thú vị là phiên bản JiT-DDT đầu tiên chỉ cải thiện chất lượng ảnh khoảng 10–20% so với JiT, dù chậm hơn 28% khi huấn luyện. Nhóm đã thử nhiều phương án khác nhau như khởi động trước encoder, loại bỏ văn bản khỏi decoder, nhưng đều không hiệu quả.
Bước đột phá đến từ một điều chỉnh tưởng như hiển nhiên: mở rộng lịch trình nhiễu. Sau khi mô hình đã học được cấu trúc ổn định, nhóm điều chỉnh phân phối lấy mẫu timestep để tập trung nhiều hơn vào vùng ít nhiễu (ảnh gần sạch). Kết quả là các chi tiết như tàn nhang và kết cấu tóc được khôi phục rõ rệt.
 Lịch trình nhiễu mở rộng giúp khôi phục chi tiết tinh xảo
Kết quả và ý nghĩa
Tổng hợp lại, JiT-DDT đạt được những con số đáng chú ý:
- Nhanh hơn 3,6 lần về số giờ GPU so với Linum v2
- Ít hơn 4,2 lần số mẫu cần xem qua trong quá trình huấn luyện
- Tạo ảnh 512×512 pixel so với 256×256 pixel của phiên bản cũ
- Sử dụng 320 token pixel (64 token encoder + 256 token decoder) thay vì 256 token latent
Nhóm nghiên cứu nhấn mạnh: mã nguồn và trọng số mô hình JiT-DDT được phát hành theo giấy phép Apache 2.0, nhưng nên được xem như một sản phẩm nghiên cứu chứ không phải bản phát hành mô hình hoàn chỉnh.
Đối với cộng đồng AI tại Việt Nam, những kết quả này có ý nghĩa thực tiễn rõ rệt: khi chi phí huấn luyện mô hình tạo ảnh giảm xuống đáng kể, các nhóm nghiên cứu và startup trong nước sẽ có nhiều cơ hội hơn để thử nghiệm và tinh chỉnh mô hình tạo sinh cho các ứng dụng chuyên biệt — từ thiết kế đồ họa, thương mại điện tử cho đến sáng tạo nội dung số.
Cuộc đua tối ưu hóa huấn luyện mô hình diffusion đang ngày càng nóng, với các hướng tiếp cận đối lập nhau từ Linum, Black Forest Labs (Self-Flow) và nhóm RAE v2. Dù chưa có người thắng cuộc rõ ràng, người dùng cuối cùng chắc chắn sẽ là bên được lợi khi chi phí tạo ảnh và video AI tiếp tục giảm.