Khi các giám khảo LLM đồng thuận, liệu có nên tin?
Nghiên cứu của Amazon Science tại ICML đề xuất phương pháp tổng hợp nhãn dựa trên mô hình Ising để xử lý vấn đề tương quan giữa các giám khảo LLM. Phương pháp này giúp phân biệt bằng chứng độc lập với sai lầm chung, cải thiện độ chính xác 9-14% so với baseline bỏ phiếu theo trọng số.
Khi các giám khảo LLM đồng thuận, liệu có nên tin?
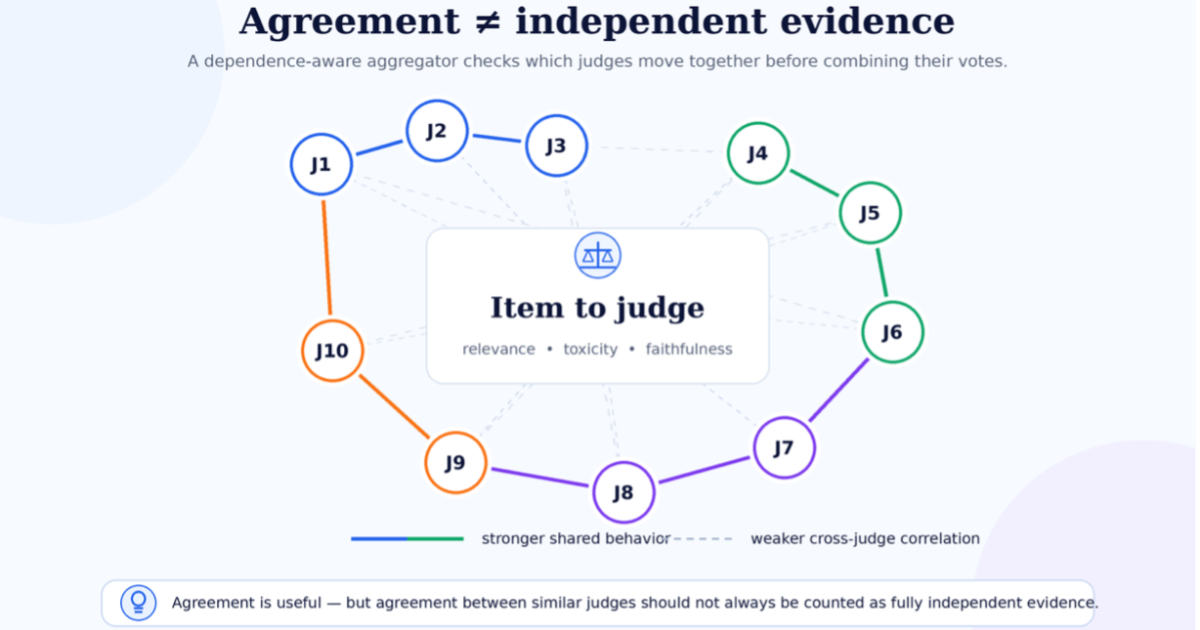
Trong các hệ thống đánh giá bằng LLM, việc nhiều mô hình cùng đưa ra một kết quả thường được xem là tín hiệu mạnh mẽ. Nhưng nghiên cứu mới từ Amazon Science chỉ ra rằng sự đồng thuận chỉ đáng tin khi các giám khảo đưa ra phán đoán một cách độc lập. Khi chúng chia sẻ nguồn gốc huấn luyện, prompt hay điểm mù chung, số phiếu đồng thuận có thể phóng đại độ tin cậy thực sự.
Vấn đề của sự đồng thuận giả tạo
Hãy hình dung một hệ thống RAG (truy xuất tăng cường sinh). Người dùng đặt câu hỏi, hệ thống truy xuất một đoạn văn bản, và một giám khảo LLM quyết định xem đoạn đó có liên quan hay không. Để giảm nhiễu, bạn cho nhiều mô hình giám khảo đánh giá cùng một đoạn. Tám mô hình nói "liên quan", hai mô hình nói "không liên quan".
Tám trên mười nghe có vẻ thuyết phục. Nhưng câu hỏi quan trọng không chỉ là bao nhiêu giám khảo đồng ý, mà là chúng đi đến sự đồng ý đó một cách độc lập đến mức nào.
Nếu tám giám khảo đồng ý thực sự là tám nguồn bằng chứng khác biệt, đồng thuận là tín hiệu mạnh. Nhưng nếu chúng chia sẻ mẫu prompt, dòng dõi huấn luyện, họ mô hình hoặc cùng một điểm mù, chúng có thể đang lặp lại cùng một sai lầm.
Bài toán này đặc biệt quan trọng với các nhóm kỹ thuật đang triển khai LLM-as-a-judge ở quy mô lớn, khi hàng nghìn mẫu đánh giá được xử lý tự động mỗi ngày.
Panel giám khảo là một mạng lưới, không phải tập hợp độc lập
Cách tiếp cận phổ biến hiện nay là bỏ phiếu đa số hoặc bỏ phiếu theo trọng số (giám khảo chính xác hơn có ảnh hưởng lớn hơn). Cả hai đều hữu ích, nhưng cùng dựa trên một giả định đơn giản hóa: các giám khảo mắc lỗi một cách độc lập.
Giả định đó thường quá lạc quan. Hai giám khảo có thể cùng sai vì diễn giải rubric giống nhau. Nhiều giám khảo có thể được prompt bằng cùng ví dụ và do đó thừa hưởng cùng định kiến đánh giá. Một nhóm mô hình họ hàng có thể nhạy cảm với cùng cách diễn đạt.
Nhóm nghiên cứu đề xuất mô hình hóa panel như một mạng lưới, trong đó mỗi giám khảo có hồ sơ độ tin cậy riêng, đồng thời các cặp giám khảo có mối quan hệ với nhau. Một số cặp đồng ý thường xuyên hơn mức độ tin cậy cá nhân dự đoán — kể cả khi cùng sai. Những cặp khác lại bổ sung góc nhìn cho nhau.
Công cụ được sử dụng là mô hình Ising, một mô hình thống kê có thể biểu diễn phụ thuộc cặp giữa các biến nhị phân. Trong bối cảnh này, bộ tổng hợp học cả kỹ năng của giám khảo lẫn mức độ tương đồng giữa các giám khảo.
Học không cần nhãn tham chiếu
Điểm đáng chú ý là phương pháp được thiết kế cho bối cảnh không giám sát: nó học từ đầu ra của giám khảo mà không cần nhãn tham chiếu từ con người. Nhãn thật của mỗi mục được coi là biến ẩn, được suy luận đồng thời với các tham số mô tả độ tin cậy và phụ thuộc.
Có hai mức độ mô hình hóa phụ thuộc:
- Mô hình không phụ thuộc lớp: mẫu quan hệ giữa các giám khảo được coi là giống nhau cho nhãn dương và âm. Quyết định cuối cùng vẫn giống bỏ phiếu có trọng số, nhưng trọng số được điều chỉnh theo tương quan.
- Mô hình phụ thuộc lớp: mẫu quan hệ thay đổi theo nhãn. Hữu ích khi cấu trúc đồng thuận mang thông tin về lớp — ví dụ giám khảo đồng thuận rộng rãi ở các mục rõ ràng nhưng tách thành cụm riêng ở các mục mơ hồ.
Thuật toán bắt đầu từ tham số khởi tạo, kết hợp phiếu của từng mục để ước lượng xác suất nhãn dương, rồi luân phiên cập nhật xác suất và ước lượng lại độ tin cậy, phụ thuộc. Nhãn tham chiếu chỉ được dùng sau đó để đo độ chính xác thực nghiệm.
Kết quả thực nghiệm
Nhóm nghiên cứu đánh giá trên ba tác vụ nhị phân: phân loại liên quan cho thông tin truy xuất, phát hiện nội dung độc hại, và đánh giá tóm tắt. Panel gồm 10 mô hình giám khảo, tất cả chạy ở temperature bằng không.
Kết quả với đầy đủ 10 giám khảo và dữ liệu huấn luyện tối đa:
- Phân loại liên quan: 0,912 độ chính xác (so với 0,820 của bỏ phiếu trọng số và 0,804 của bỏ phiếu đều)
- Phát hiện độc hại: 0,792 (so với 0,694 và 0,695)
- Đánh giá tóm tắt: 0,806 (so với 0,737 và 0,561)
Mức cải thiện 9-14% so với baseline tốt nhất cho thấy việc mô hình hóa tương quan mang lại giá trị thực chất, miễn là hệ thống có đủ mục đánh giá và đủ giám khảo để ước lượng quan hệ có ý nghĩa.
Bài học cho các nhóm triển khai LLM-as-a-judge
Với các đội ngũ đã thu thập đầu ra giám khảo LLM ở quy mô lớn, nghiên cứu gợi ý vài thói quen hữu ích:
- Đánh giá cả panel, không chỉ từng giám khảo. Một tập hợp các giám khảo mạnh riêng lẻ vẫn có thể dư thừa nếu chúng sai theo cùng một cách.
- Coi đa dạng mô hình là đa dạng thống kê. Trộn các họ mô hình chỉ hữu ích khi nó thay đổi mẫu lỗi quan trọng với tác vụ.
- Kiểm tra cấu trúc đồng thuận. Các cụm đồng thuận mạnh có thể tiết lộ rubric chung, hành vi mô hình chung hoặc sự mơ hồ đặc thù của tác vụ.
- Báo cáo độ bất định có tính đến phụ thuộc. Mười phiếu tương quan không nên luôn tạo ra cùng độ tin cậy như mười phiếu độc lập.
Dữ liệu đánh giá hiện có chứa nhiều hơn số phiếu — chúng chứa các mẫu đồng thuận và bất đồng. Phương pháp tổng hợp dựa trên phụ thuộc biến những mẫu đó thành tín hiệu sử dụng được, giúp các nhóm kỹ thuật tại Việt Nam đang xây dựng pipeline đánh giá AI có thêm công cụ để tránh tin tưởng nhầm vào sự đồng thuận giả tạo.
Khi các giám khảo LLM đồng ý, chúng ta nên hỏi tại sao. Đôi khi đồng thuận là bằng chứng độc lập. Đôi khi đó là điểm mù chung. Một phương pháp tổng hợp tốt phải phân biệt được hai điều này.