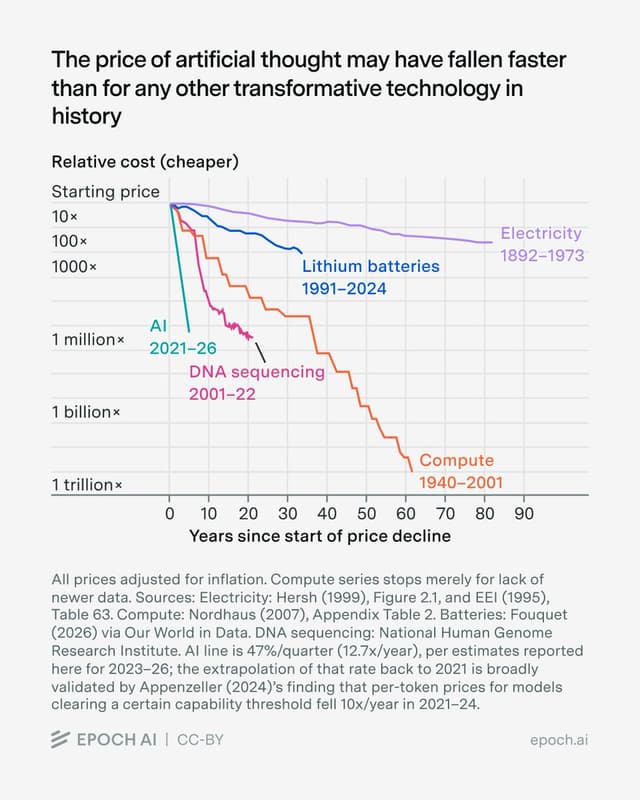
Chi phí trí tuệ nhân tạo giảm 100 lần trong một năm
Phân tích dữ liệu từ Artificial Analysis cho thấy mức năng lực AI từng có giá 1,22 USD mỗi tác vụ hồi tháng 2/2026 nay chỉ còn 0,022 USD, tức giảm 56 lần trong chưa đầy sáu tháng. Tốc độ giảm đang nhanh lên, và điều này thay đổi cách doanh nghiệp, lập trình viên triển khai AI.
Tiến bộ của mô hình ngôn ngữ lớn thường được đo bằng đỉnh cao: mô hình tốt nhất làm được gì mà trước đó chưa ai làm được. Nhưng có một hướng tiến bộ khác ít được chú ý hơn, đó là mức năng lực ấy ngày càng rẻ đi nhanh đến đâu.
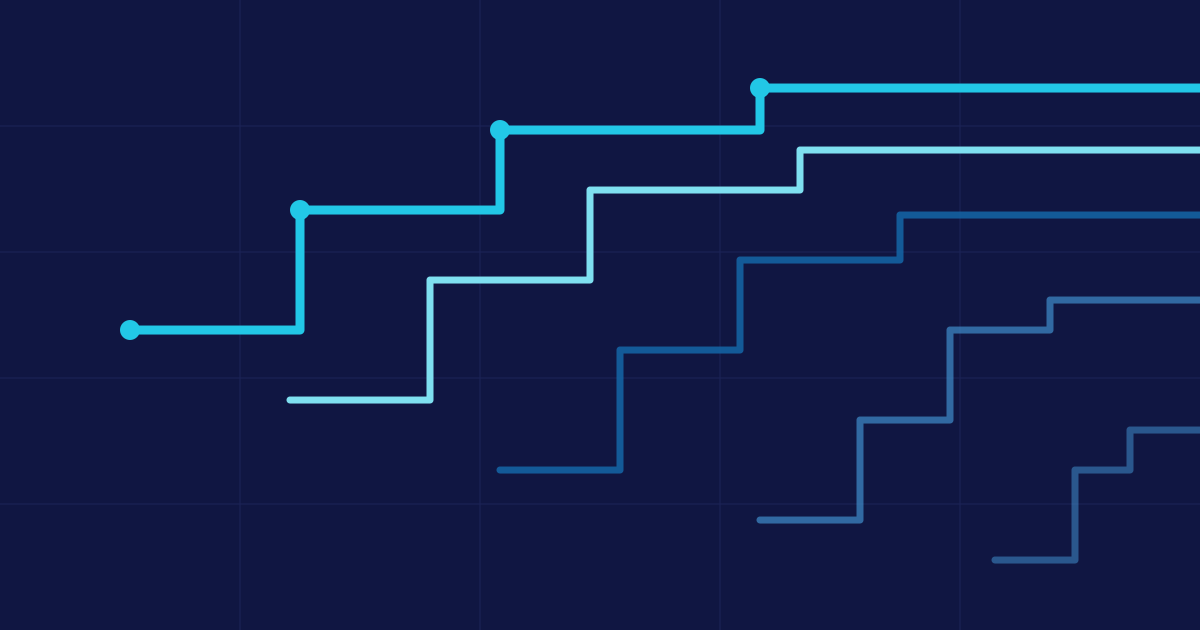 Đồ thị Pareto về chi phí và năng lực mô hình
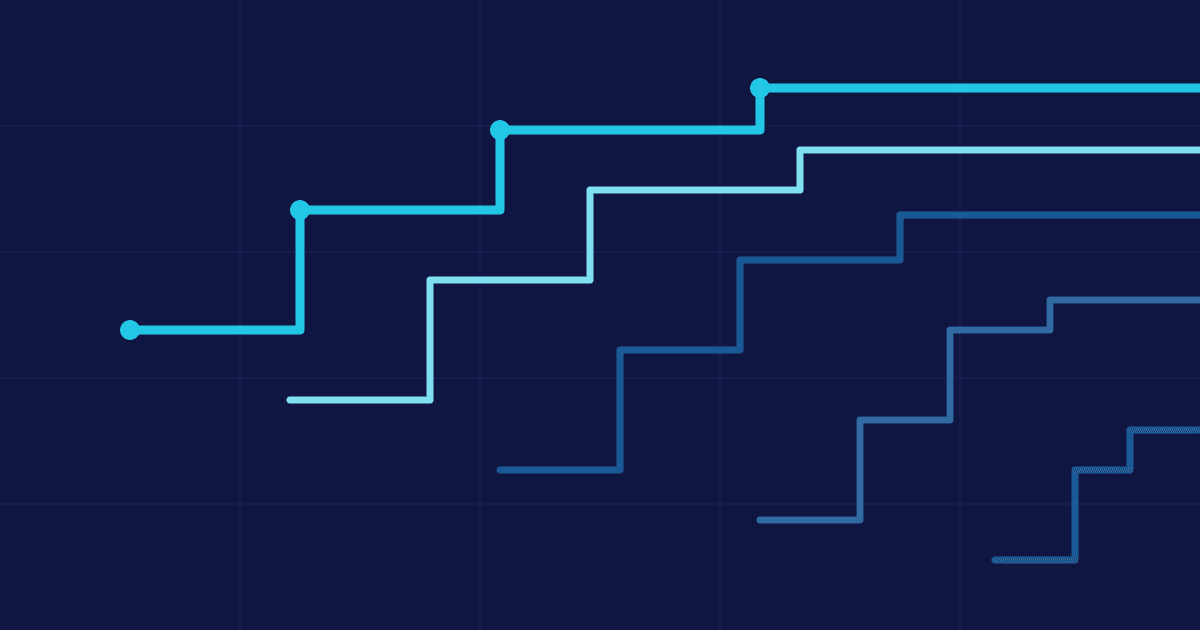
Ben Dichter, tiến sĩ ngành kỹ thuật sinh học và là người sáng lập CatalystNeuro, đã thu thập dữ liệu của Artificial Analysis để dựng lại đường biên Pareto (Pareto frontier), tức đường nối các mô hình mạnh nhất ở từng mức giá, trong hơn một năm qua.
Kết quả ngắn gọn: mức trí tuệ có giá 1,22 USD mỗi tác vụ vào tháng 2/2026 nay chỉ còn 0,022 USD. Mức giảm 56 lần trong chưa đầy sáu tháng, và tốc độ giảm vẫn đang tăng lên. Ở nhịp này, một mức năng lực cố định sẽ rẻ đi 100 lần trong khoảng một năm.
Hai hướng tiến bộ khác nhau
Đỉnh cao mở ra những loại tác vụ mới: sửa một lỗi trải khắp mã nguồn, hay giải được bài toán mà chưa ai giải. Đáy thấp mở ra khối lượng: cùng một việc tốt, nhưng chạy được hàng chục nghìn lần trong ngân sách.
Đọc toàn bộ bài báo khoa học về một chủ đề, rà từng hợp đồng trong kho lưu trữ để tìm một điều khoản, hay tóm tắt mọi luồng thảo luận trên một diễn đàn lớn, đều thuộc nhóm thứ hai. Câu hỏi không phải là có mô hình làm được việc đó hay không, mà là có làm nổi một vạn lần trong giới hạn chi phí hay không.
Tác giả lấy ví dụ từ chính công việc của mình: đo xem dữ liệu chia sẻ trên DANDI Archive được tái sử dụng bao nhiêu lần trong các công bố sau này. Việc đó cần đọc khoảng mười nghìn bài báo ứng viên. Ở giá hiện tại, một lượt quét toàn bộ tốn hơn một trăm USD với mô hình từng ở đỉnh cao hồi mùa xuân. Với giá tháng 3/2026, cùng năng lực đó tốn vài nghìn USD. Một năm trước, năng lực ấy chưa tồn tại ở bất kỳ mức giá nào.
Thước đo năng lực
Trục năng lực trong phân tích là Chỉ số Trí tuệ của Artificial Analysis, bản 4.1.1. Đây là điểm trung bình có trọng số của chín bài đánh giá, chia thành bốn nhóm: tác vụ tự chủ (agentic) 34%, lập trình 24%, suy luận khoa học 24% và năng lực chung 18%.
Một phần ba số điểm đến từ khả năng hoàn thành công việc nhiều bước, không phải từ việc trả lời câu hỏi thi. Điểm này có thể coi như chỉ số IQ cho mô hình ngôn ngữ lớn, dù hai mô hình cùng điểm vẫn có thể mạnh yếu khác nhau.
Để dễ hình dung các mức điểm, tác giả dùng bài kiểm tra chim bồ nồm đi xe đạp của Simon Willison: yêu cầu mô hình vẽ một ảnh SVG chim bồ nồm đạp xe. Hình dưới so sánh các mức năng lực khác nhau của dòng GPT-5.6.
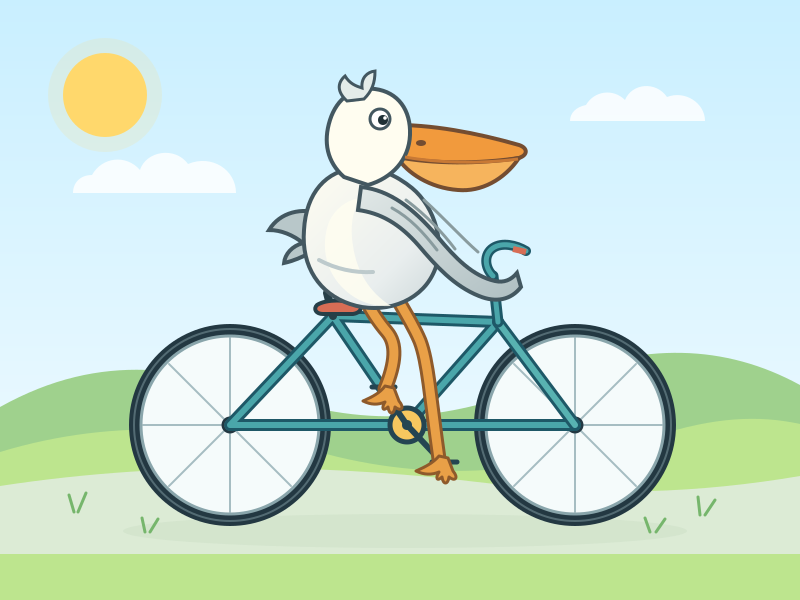 Ảnh SVG chim bồ nồm ở mức năng lực thấp
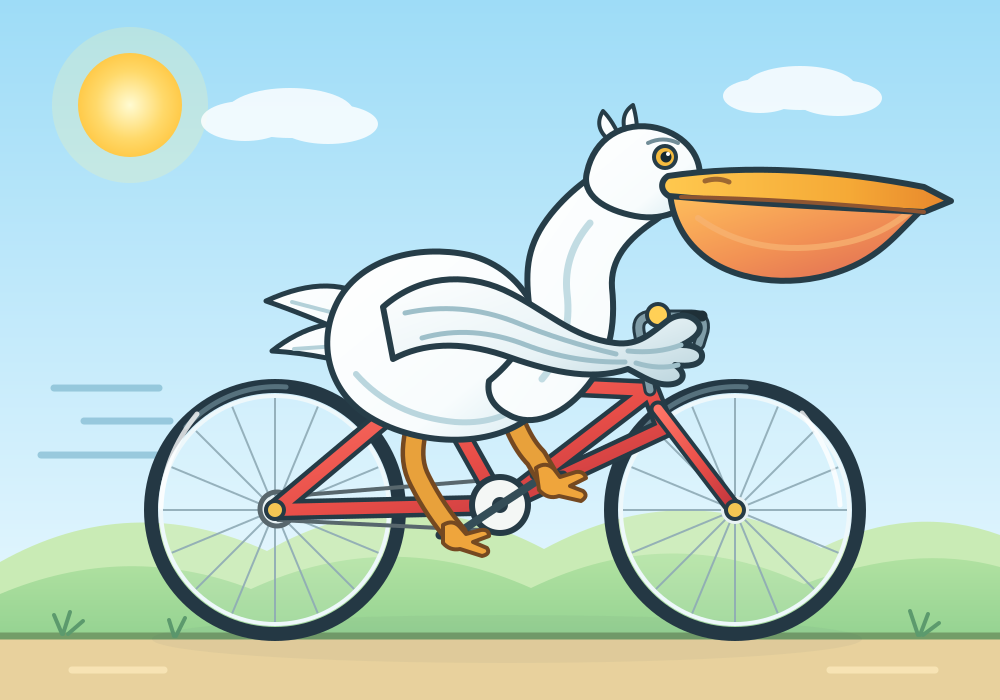 Ảnh SVG chim bồ nồm ở mức năng lực cao hơn
Sự tiến bộ hiện rõ: chi tiết hơn, tỉ lệ chuẩn hơn, và con chim thực sự ngồi trên xe chứ không lơ lửng phía trên.
Đo chi phí theo tác vụ
Giá mỗi token (token) dễ tra nhưng không phản ánh đúng chi phí. Các mô hình có thể dùng số token rất khác nhau cho cùng một việc. Vì vậy Artificial Analysis đo chi phí mỗi tác vụ: số USD trung bình để chạy một bài trong bộ đánh giá, gồm token đầu vào, token suy luận và token trả lời thực tế bị tính tiền.
Tác giả đã trích số liệu này từ trang của 137 mô hình, tính từ DeepSeek V3 hồi tháng 12/2024, mỗi mô hình gắn với ngày phát hành và điểm Chỉ số Trí tuệ theo thang hiện hành.
Đường biên Pareto dịch dần lên trên và sang trái theo từng mốc hai tháng: cùng chi phí thì thông minh hơn, hoặc cùng trí tuệ thì rẻ hơn.
Đỉnh và đáy của đường biên
Mép phải kể câu chuyện trần năng lực. Đỉnh của đường biên tăng từ chỉ số 35,3 vào tháng 8/2025 (GPT-5, 0,26 USD mỗi tác vụ) lên 37,4 vào tháng 10 (Claude 4.5 Sonnet), 48,4 vào tháng 2/2026 (Claude Sonnet 4.6), 55,0 vào tháng 4 (Claude Opus 4.7, 2,23 USD), 62,1 vào tháng 6 (Claude Fable 5, 3,14 USD) và 63,1 hiện nay (Claude Opus 5, 2,34 USD). Tổng cộng 28 điểm chỉ số trong một năm.
Nửa trái cho thấy mô hình rẻ đang thông minh lên. Tính đến 19/8/2026, dòng GPT-5.6 Luna chiếm gần như toàn bộ vùng dưới chỉ số 52. Mức từng là đỉnh cao hồi tháng 8/2025 giờ chỉ tốn 0,0088 USD mỗi tác vụ.
Đường biên tháng 6/2026 có tới sáu trong mười một mô hình là trọng số mở (open weights), gồm MiMo-V2.5, DeepSeek V4 Pro, MiniMax-M3 và GLM-5.2, giữ trọn vùng giữa từ chỉ số 38 đến 53. Sau khi GPT-5.6 Luna ra mắt, chỉ còn hai trong mười sáu mô hình trên đường biên là trọng số mở.
Mỗi mức năng lực rẻ đi bao nhanh
Bảng dưới đây theo dõi chi phí thấp nhất mà một mô hình từng đạt được ở mỗi mức chỉ số:
| Mức chỉ số | Mốc đạt lần đầu | Mức giảm | Thời gian giảm một nửa |
|---|---|---|---|
| ≥ 30 | 8/2025 (GPT-5 high) | 29 lần | khoảng 73 ngày |
| ≥ 40 | 2/2026 (Claude Sonnet 4.6) | 56 lần | khoảng 28 ngày |
| ≥ 50 | 3/2026 (GPT-5.4 xhigh) | 35 lần | khoảng 29 ngày |
| ≥ 60 | 6/2026 (Claude Fable 5 max) | 3,8 lần | khoảng 34 ngày |
Một mức năng lực thường do mô hình đỉnh cao ra mắt trước với giá cao. Sau đó vài tuần, mô hình rẻ hơn đạt cùng mức, và kỷ lục chi phí có thể giảm cả chục lần.
Ví dụ mức ≥ 40 mở màn với Claude Sonnet 4.6 vào tháng 2/2026 ở giá 1,22 USD mỗi tác vụ. Chỉ hai ngày sau, Gemini 3.1 Pro Preview phá giá xuống 0,33 USD. Tháng 4, mô hình trọng số mở MiMo-V2.5-Pro kéo xuống 0,034 USD. Hiện GPT-5.6 Luna ở mức high giữ kỷ lục 0,022 USD.
Mức ≥ 50 đi theo quỹ đạo tương tự, chậm hơn khoảng một tháng. GPT-5.4 vượt ngưỡng vào tháng 3 với 1,10 USD. Đến tháng 7, mức xhigh của GPT-5.6 Luna lập kỷ lục 0,16 USD. Ngày 30/7, OpenAI giảm giá 80%, đưa con số này về 0,032 USD, tức giảm 35 lần trong năm tháng.
Những điểm cần lưu ý
Phân tích có vài hạn chế mà tác giả nêu rõ. Chi phí dùng là giá đo mới nhất gắn theo ngày phát hành, không phải giá đo tại thời điểm ra mắt. Vì giá thường bị cắt trong vòng đời mô hình, các điểm sớm bị phản ánh thấp hơn thực tế, khiến mức giảm bị đánh giá thấp đi và thời điểm giảm bị đẩy sớm hơn.
Tác giả chỉ hiệu chỉnh cho lần giảm giá lớn nhất gần đây: OpenAI cắt 80% giá GPT-5.6 Luna ngày 30/7/2026, ba tuần sau khi phát hành ngày 9/7.
Về độ phủ, mô hình đã ngừng đánh giá chỉ được tính khi trang của chúng vẫn còn số đo, thu lại được 44 trong số 228 mô hình. Các mô hình như o3, GPT-5.3 Codex và cả thế hệ GPT-4 không xuất hiện.
Dự đoán
Ngoại suy từ dữ liệu đo được là việc có rủi ro, vì mỗi lần giảm giá là một sự kiện cạnh tranh, không phải quy luật. Nhưng các đường cong đã khá đều.
Với thời gian giảm một nửa khoảng 34 ngày ở mức ≥ 60, kỷ lục 0,84 USD của Grok 4.6 sẽ xuống dưới 10 cent vào khoảng đầu tháng 12/2026. Mức chỉ số 55, hiện có giá 0,36 USD với Grok 4.5, sẽ dưới 10 cent vào giữa tháng 10.
Trần năng lực khó đoán hơn. Nó tăng 28 điểm trong một năm nhưng chỉ thêm một điểm từ tháng 6, có thể do chỉ số hiện tại đã bão hòa chứ không phải các mô hình chững lại.
Nghịch lý Jevons và hệ quả thực tế
Nhìn vào biểu đồ, nhiều người sẽ nghĩ chi tiêu cho mô hình ngôn ngữ lớn phải giảm. Thực tế ngược lại. Năm 1865, William Stanley Jevons nhận thấy động cơ hơi nước hiệu quả hơn, tốn ít than hơn mỗi đơn vị công việc, lại khiến tổng lượng than tiêu thụ của nước Anh tăng lên, vì công việc rẻ đi tìm được nhiều ứng dụng hơn.
Hiện tượng này gọi là nghịch lý Jevons. Lượt quét tài liệu của tác giả là một ví dụ nhỏ: với giá năm ngoái, nó chỉ có thể chạy trên mẫu; với giá năm nay, họ chạy trên toàn bộ kho dữ liệu, chạy lại mỗi khi đường ống thay đổi, và dự định chạy ba lần cho mỗi kết quả dương tính. Chi phí mỗi bài giảm hơn mười lần nhưng tổng chi cho dự án lại tăng.
Nếu một năng lực đang tồn tại ở bất kỳ mức giá nào hôm nay, giả định hợp lý khi lập kế hoạch là vài tháng nữa nó sẽ có giá phổ thông. Vì vậy kiến trúc hệ thống nên xem mô hình là thành phần có thể thay thế, với cơ chế định tuyến rõ ràng giữa các mức năng lực.
Các router mô hình trên thị trường đang biến điều đó thành thực tế. OpenRouter cung cấp router nhận một mức điểm tối thiểu và gửi mỗi yêu cầu tới mô hình rẻ nhất trên đường biên đạt mức đó. Ghi cứng tên mô hình vào ứng dụng đã trở thành cách nhanh nhất để trả quá tiền.
Góc nhìn
Với lập trình viên và doanh nghiệp Việt Nam, bài học thực dụng nhất là đừng gắn chặt hệ thống vào một mô hình cụ thể. Hãy tách lớp gọi mô hình, cho phép chuyển đổi giữa các mức năng lực và chi phí theo từng bước của quy trình.
Những tác vụ chạy khối lượng lớn như phân loại văn bản, trích xuất dữ liệu, xử lý yêu cầu hỗ trợ khách hàng hay rà soát tài liệu không cần mô hình mạnh nhất. Chọn mô hình đủ tốt với giá thấp sẽ cho phép chạy nhiều lượt và kiểm tra chéo, thứ mà trước đây quá đắt để làm.
Ngân sách AI nên được hoạch định lại mỗi quý, vì giá cùng một mức năng lực có thể giảm vài lần trong vài tháng. Phần đắt nhất còn lại không phải là trí tuệ, mà là việc biết nên hỏi gì, có dữ liệu đúng để đối chiếu, và hệ thống chạy được ở quy mô lớn.
Nguồn: catalystneuro.com · Quy trình biên tập